ARTICLE · 1002418
无需标记!IN Carta图像分析软件AI检测技术详解

简介
与传统的荧光成像方法相比,无标记成像具有显著的优势,包括降低试剂成本、加快检测流程,以及实现对活细胞的持续监测。此外,无标记检测可在不改变样品的情况下实现生物分子相互作用的观察,从而获得更准确的数据、更深入的表征和动力学的实时监测。本研究利用IN Carta图像分析软件中的可定制人工智能(AI)模型,开发了基于深度学习的图像分割模型,仅通过透射光(TL)图像即可实现精准的细胞与细胞核检测。
我们首先以U2OS细胞系为对象建立无标记分析体系。为开发基于TL图像的细胞核分割模型,我们首先采用预训练AI模型对Hoechst染色图像的细胞核进行分割,将所得分割掩膜与对应TL图像配对训练,最终获得仅需TL图像即可实现细胞核分割的新模型。经与Hoechst染色核计数结果对比验证,该模型的无标记细胞核检测准确率超过97%,并能可靠定量活细胞与损伤细胞表型。
此外,我们还基于Calcein AM染色图像训练了全细胞分割模型。该模型同样表现出优异性能,与细胞核计数结果相比达到97%的准确率。
优势
无需荧光或化学标记,保持细胞活性,实现对细胞动力学的实时、非侵入式监测
通过IN Carta图像分析软件训练的AI模型,在细胞核数量检测中实现高精度
通过定制化功能和用户自定义目标的多样化测量模式,确保AI模型的可扩展性与适用性
我们进一步使用包括HeLa、HCT116、U2OS、MCF7和HEK在内的多种细胞系图像对模型进行训练。该模型在大多数细胞类型中实现了超过90%的检测准确率。为评估其在化合物筛选中的实用性,我们采用7浓度梯度对五种细胞系进行10种抗癌化合物处理,并通过基于透射光的细胞核分割技术获取细胞计数,与传统核染色方法的结果进行比较。数据显示两者具有高度相关性,且IC50值基本一致,证实了这种无标记方法的准确性与可靠性。
总体而言,这种无标记技术在处理速度和工作流程简化方面具备显著优势,能够实现化合物效应的实时分析,使其成为高通量与表型筛选应用中的高效工具。

方法
细胞培养和处理
在本实验中,将U2OS、HCT-116、HeLa、HEK及MCF-7细胞以每孔1000个细胞的密度接种。24小时后添加化合物(星形孢菌素、阿糖胞苷、依托泊苷、多柔比星、鱼藤酮、卡铂、紫杉醇、SB202190、雷帕霉素和5-氟尿嘧啶)。药物处理72小时后,以四复孔形式加入经五倍梯度稀释的化合物溶液,起始浓度为1μM。
对于细胞染色,在每个板成像前20-30分钟加入荧光染料。最终染料浓度约为:Calcein AM 0.75μM、EthD-11.5μM、DAPI 7μM(如图1所示)。
图像采集和分析
所有培养板均使用ImageXpress HCS.ai高内涵筛选系统进行图像采集,采用10倍物镜放大。通过四个通道采集图像:透射光(TL)、DAPI、FITC和TexasRed。采集了覆盖50μm范围的Z轴层扫图像(步进间隔5μm),并保存各通道的2D最佳聚焦投影图像。
为在IN Carta图像分析软件中开发基于透射光的细胞核分割模型,我们首先采用预训练AI模型对Hoechst染色图像的细胞核进行分割。将获得的分割掩膜与对应的TL图像配对,训练出一个能直接从TL图像中分割细胞核的新模型(称为TL细胞核模型,如图2所示)。
同样地,针对基于透射光的细胞分割模型,我们采用预训练AI模型对Calcein AM染色图像的细胞进行分割。将获得的分割掩膜与对应TL图像配对,训练出能直接从TL图像中分割细胞的模型(称为TL细胞模型)。
训练完成后,TL细胞核模型被用于分割细胞核(标记为Nuclei),TL细胞模型则用于分割细胞(标记为Cells)。同时,使用基于DAPI的细胞核模型分割结果作为基准真值(标记为Nuclei_GT)。通过创建用户自定义检测目标,识别Nuclei与Nuclei_GT之间的重叠区域(标记为Overlapping)。利用这些标签计算性能指标:以Nuclei与Nuclei_GT计算检出率,以Nuclei与Overlapping计算假阳性率。最终基于细胞核计数数据生成剂量反应曲线。
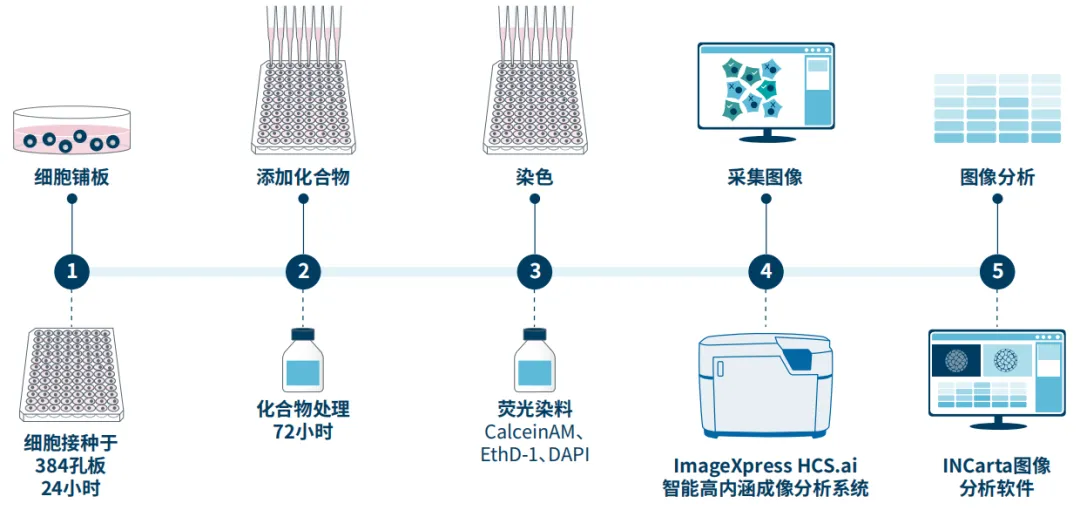
图1. 细胞培养和处理后进行成像采集,所得数据集使用IN Carta AI图像分析软件进行分析。

结果
SINAP支持跨通道监督和可定制的AI模型
透射光(TL)显微图像在分割过程中面临显著挑战——即对细胞或细胞核等目标区域进行轮廓勾画。这些困难主要源于该方法仅捕捉穿过样本的光线,导致图像天然具有低对比度与复杂特征。为克服这些挑战,深度学习方法(尤其是卷积神经网络)已成为主流解决方案。然而,即使是深度学习方法也需要经过精细优化才能在透射光图像上表现优异,且必须依赖精心准备的训练数据才能发挥效果。
由于透射光图像存在上述固有特性,人工标注其分割真值不仅困难且难以保持一致性。为突破此瓶颈,我们利用IN Carta图像分析软件中的SINAP模块,通过跨通道监督技术实现AI模型定制——这是一种计算机视觉领域的常用方法,即从一个通道构建训练掩膜,同时在另一个通道上训练模型(如图2所示)。
我们以U2OS细胞系为起点展开研究。为训练能够分割TL图像中细胞核的AI模型,首先使用预训练模型在DAPI通道生成掩膜,随后将这些掩膜与对应TL图像配对构建训练数据集(图2、图3A)。共创建40组掩膜-图像对用于基础模型的再训练。接着采用类似方法,借助Calcein AM通道训练能直接在TL图像上分割细胞的AI模型(图2、图3B)。
图4展示了训练后模型的结果:透射光细胞核分割掩膜与DAPI染色在空间上高度吻合(图4B),同时透射光细胞分割掩膜与Calcein AM染色也呈现精确对应(图4C),这证实了细胞核与细胞分割的双重准确性。图4E展示了单个培养孔中细胞核与细胞计数的对比情况。通过将透射光细胞核计数结果与DAPI染色核计数(作为基准真值)进行比对,实现了总体计数准确率97%±0.9%(标准差)的优异表现。
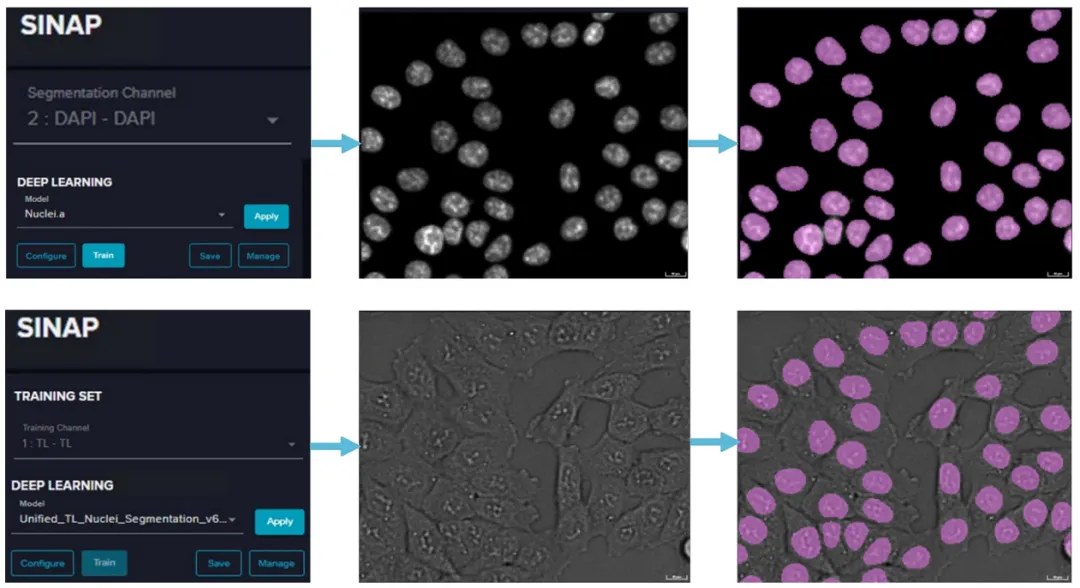
图2. 跨通道监督工作流程:在分割通道中采用DAPI通道,并运用预训练的Nuclei.a模型生成细胞核掩膜;随后在训练通道中使用TL通道,将细胞核掩膜与对应的TL图像配对以构建训练集;最终利用该训练集对基础模型进行再训练。
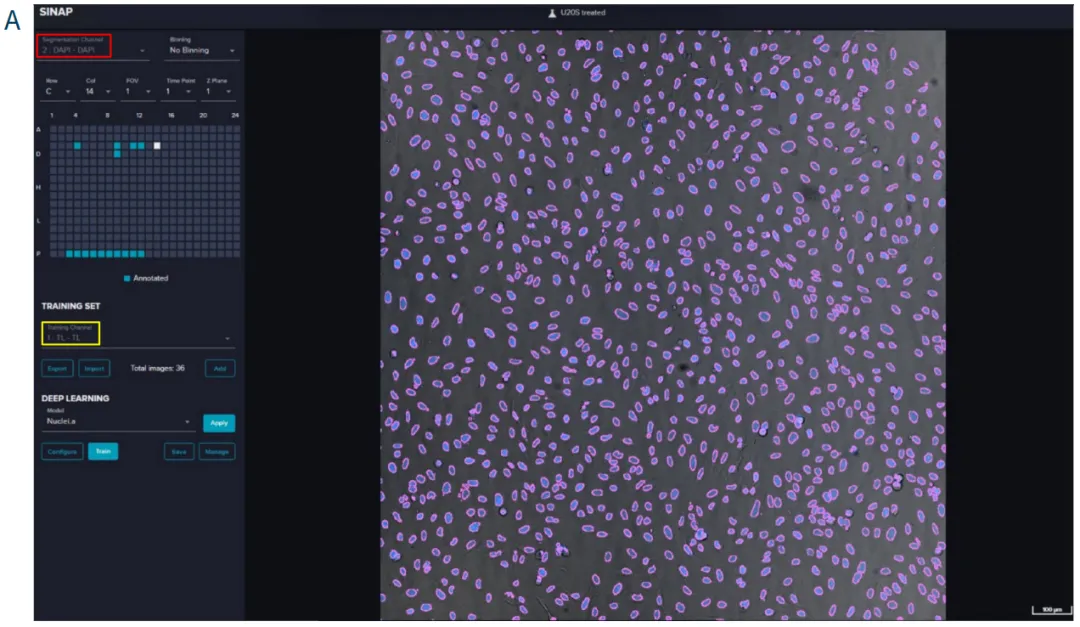
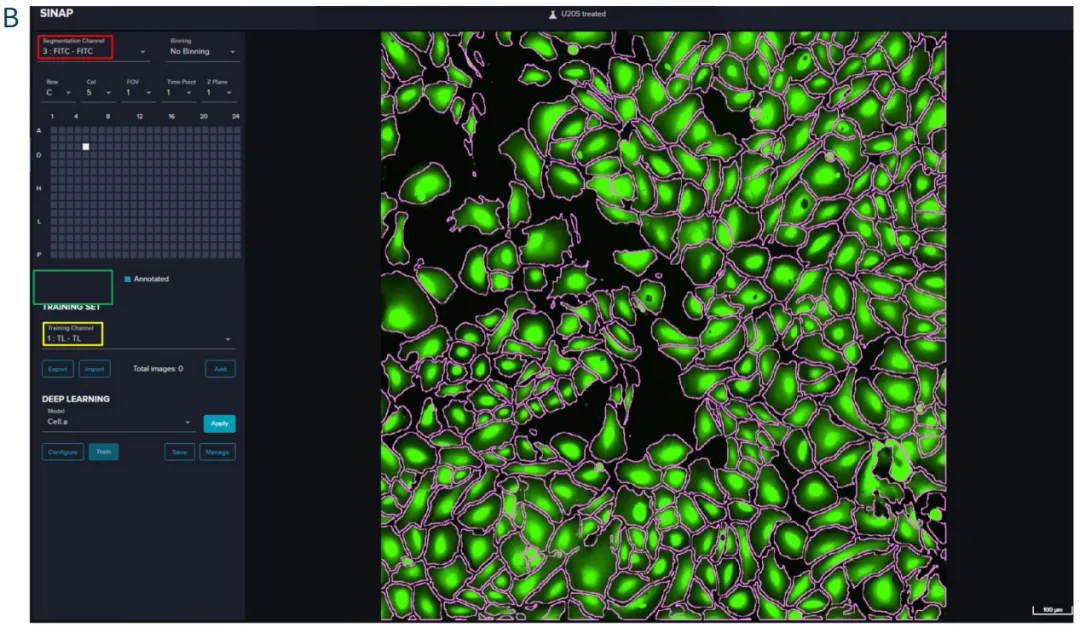
图3. 训练界面展示通道选择与预训练模型分割效果。A.SINAP训练界面以DAPI作为分割通道(红框标注),TL作为训练通道(黄框标注)。洋红色轮廓线代表预训练Nuclei.a模型生成的细胞核掩膜。B.SINAP训练界面以FITC(Calcein AM)作为分割通道(红框标注),TL作为训练通道(黄框标注)。洋红色轮廓线代表预训练Cell.a模型生成的细胞掩膜。本案例采用U2OS细胞系进行演示。
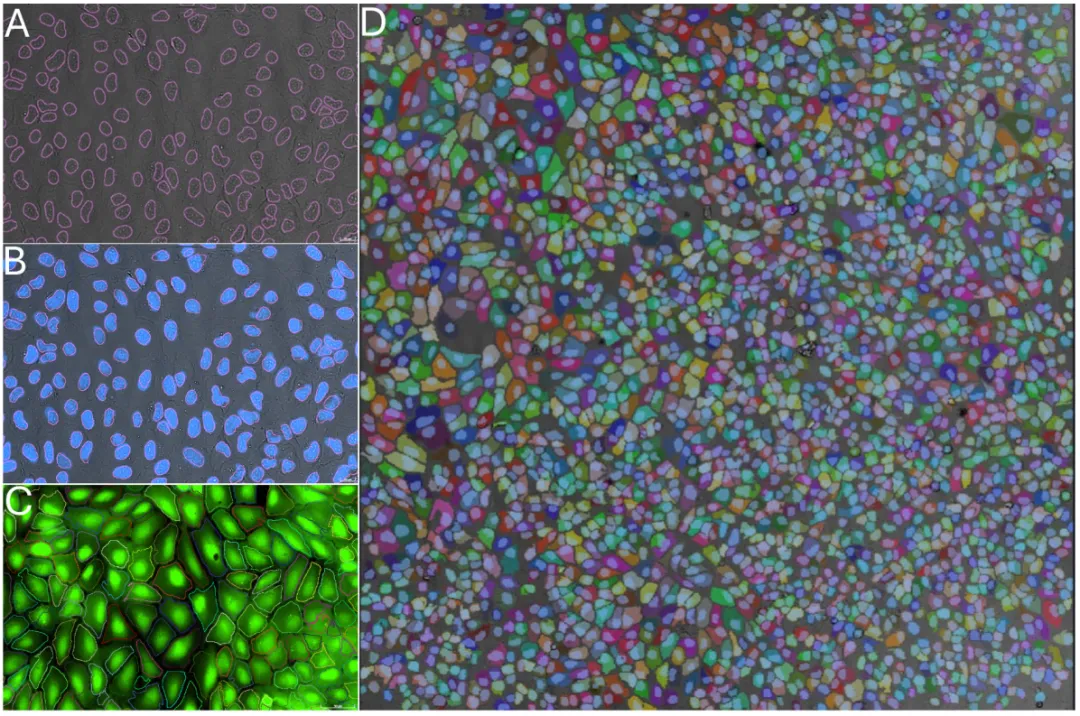
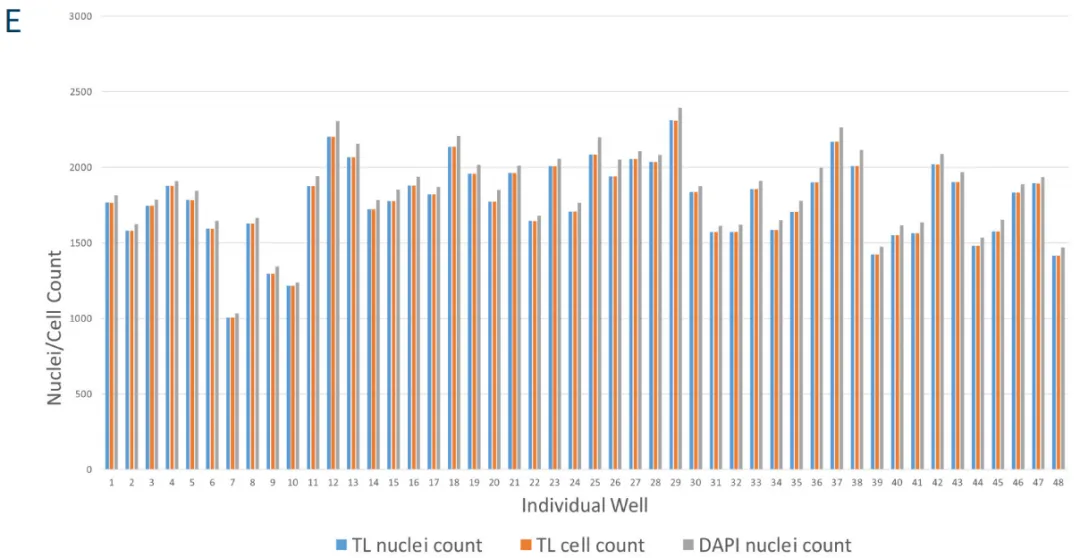
图4. 训练后TL细胞核模型与TL细胞模型的分割结果及细胞核/细胞计数对比。A.TL细胞核分割掩膜(粉红轮廓线)叠加于TL图像。B.TL细胞核分割掩膜(粉红轮廓线)叠加于DAPI图像。C.TL细胞分割掩膜(随机色彩轮廓线)叠加于CalceinAM图像。D.TL细胞分割掩膜(随机色彩)与TL细胞核掩膜(蓝色区域)共同叠加于TL图像。E.各培养孔的细胞计数对比(本案例采用U2OS细胞系)。
SINAP中的导出/导入功能可实现多细胞系模型训练
由于细胞异质性显著、数据可用性有限以及模型跨场景泛化难度大,多细胞系模型训练面临挑战。有效整合来自不同数据集的训练数据对于提升模型在各类细胞系间的适用性至关重要。本研究利用SINAP的导出与导入功能,高效整合了五种细胞系的训练数据集(图5)。
构建完整数据集存在两种方法:并行式与序列式。并行式方法中,各细胞系的训练数据集分别导出后集中导入,形成涵盖全部五种细胞系的最终数据集(图5A)。序列式方法则将所有现有细胞系数据集导出后,逐次导入后续细胞系,逐步构建完整数据集(图5B)。虽然并行式能降低大规模训练数据集的存储需求,但序列式有助于在处理许多细胞系时加载多个数据集。
SINAP的用户自定义目标功能可测量假阳性率
假阳性率是衡量模型性能的重要指标,指模型将实际阴性样本错误判定为阳性的比例。为实现该指标计算,我们首先对TL通道进行细胞核分割并标记为“Nuclei”,随后基于DAPI通道生成基准真值掩膜并标记为“Nuclei_GT”(图6A)。借助SINAP支持AND、OR、NOT、XOR等自定义二元运算的用户自定义目标功能,对Nuclei与Nuclei_GT执行逻辑与(AND)运算生成新掩膜,标记为“Overlapping”(图6B)。最后通过建立目标关联——将Nuclei设为主目标、Overlapping设为子目标,统计所有子目标计数为零的Nuclei作为假阳性。图6C–6F展示了Overlapping掩膜的生成示例。
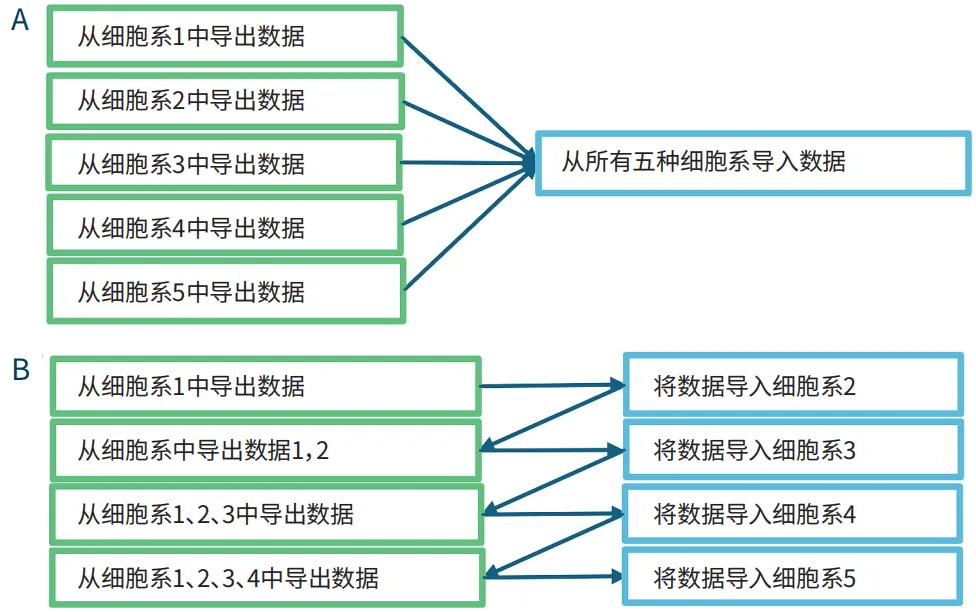
图5. A.并行导出数据集的工作流程。B.序列导出数据集的工作流程。
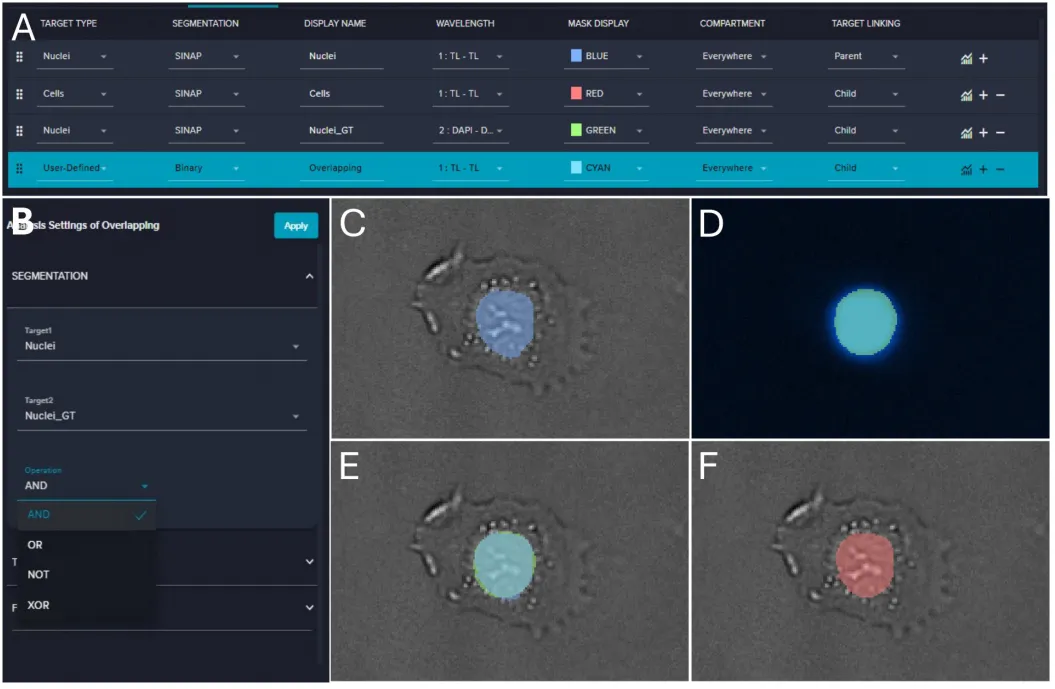
图6. A.IN Carta分析工作流界面截图。B.用户自定义目标设置界面截图。C.细胞核(蓝色)掩膜与TL图像的重叠展示。D.基准真值细胞核(绿色)。与DAPI图像的重叠展示。E.细胞核(蓝色)、基准真值细胞核(绿色)与TL图像的三重叠加。F.重叠区域(红色)与TL图像的叠加效果。
统一的TL模型可检测与DAPI信号同步的细胞核
为评估统一模型的性能,我们计算了各细胞系的检出率与假阳性率。除HEK细胞检出率约86%外,多数细胞系检出率均超过90%。值得注意的是,统一模型在U2OS数据集上显示出约96%的准确率,略低于U2OS专用模型的97%,这可能是受其他细胞系数据影响所致(图7A)。
多数细胞系的假阳性率低于2%,但MCF-7细胞系例外,其假阳性率约为7%。进一步研究发现,MCF-7细胞易形成团簇结构,导致团簇中心的DAPI染色效果不佳。这种DAPI染色缺陷影响了基于DAPI的细胞核检测,从而造成MCF-7细胞系假阳性率偏高(图7B、7C、7D)。
我们将该方法应用于评估抗癌化合物对细胞数量的影响。化合物处理通过抑制增殖和诱导细胞死亡导致细胞数量下降。我们通过TL与DAPI两种方法获得细胞计数生成的剂量反应曲线,两者呈现一致趋势(图7E、7F)。数据显示两种方法具有强相关性且IC50值高度可比,证实了这种无标记方法的准确性与可靠性。此处IC50指半抑制浓度,即抑制特定生物过程或活性达50%所需的抑制剂浓度。该方法能够检测具有完整细胞核的活细胞与死细胞。
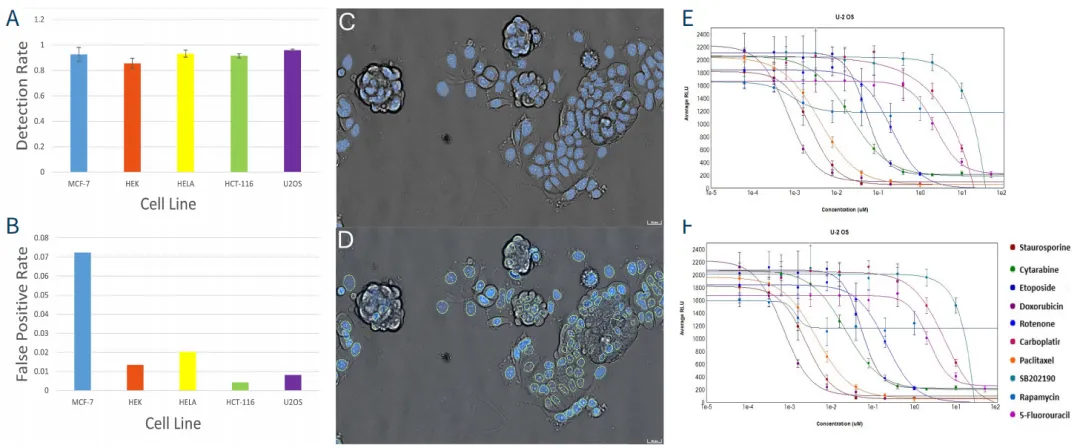
图7. A.各细胞系检出率统计。B.各细胞系假阳性率统计。C.MCF-7细胞TL细胞核掩膜(蓝色)与TL图像叠加效果。D.MCF-7细胞DAPI细胞核掩膜(绿色轮廓)、DAPI图像及TL图像三重叠加。E.基于TL细胞核计数的U2OS细胞剂量反应曲线。F.基于DAPI细胞核计数的U2OS细胞剂量反应曲线(其他细胞系呈现相似趋势,未展示)。

结论
无标记成像技术与可定制的多细胞系AI模型相结合,为细胞分析领域带来了突破性进展。无标记成像技术无需荧光或化学标记,能够保持细胞活性,实现对细胞动力学的实时、非侵入式监测。当该技术与基于IN Carta图像分析软件跨细胞系训练的AI模型结合时,这种方法可实现高精度的细胞核数量检测。AI模型的可定制特性确保了可扩展性与适用性,而用户自定义目标功能则支持多样化测量模式的整合。总体而言,该平台为更高效、更具洞察力的细胞研究开辟了新路径。
参考文献
1.Gupta,Saurabh,and Jitendra Malik.Cross Modal Distillation for Supervision Transfer (CVPR 2016).
关于美谷分子仪器
Molecular Devices 始创于上世纪 80 年代美国硅谷,并在全球设有多个代表处和子公司。2005 年,Molecular Devices 在上海设立了中国代表处,2010 年加入全球科学与技术的创新者丹纳赫集团,2011 年正式成立商务公司:美谷分子仪器 (上海) 有限公司。Molecular Devices 以持续创新、快速高效、高性能的产品及完善的售后服务著称业内,我们一直致力于为客户提供在生命科学研究、制药及生物治疗开发等领域蛋白和细胞生物学的创新性生物分析解决方案。