ARTICLE · 1002947
OpenClaw 2.0之后,真正值得警惕的不是它会操作电脑
很多人第一次注意到 OpenClaw,是因为它能打开浏览器、填写表单,甚至替人完成一连串电脑操作。
这确实很新鲜。但如果只把它理解成一双“AI鼠标”,恐怕低估了这轮变化。
OpenClaw 2.0之后,真正值得关注的,是三个原本分散的东西正在被拼到一起:随时可调用的计算资源、能够保留工作经验的技能系统,以及越来越像公司管理制度的权限体系。
说得直白一点:它正在从工具,长成一个组织。
它先把一台电脑,变成了一群电脑
过去我们使用AI,默认它待在聊天框里。你发出问题,它生成答案;页面关掉,这轮工作也就结束了。
Cloud Sessions改变的是这个前提。
一项任务可以在你的电脑上发起,真正的执行却被放到另一台设备,或者临时创建的云端 Worker 上。远程机器负责运行命令、修改文件;Gateway保存会话和任务状态。临时机器即使被销毁,工作记录仍然留着,模型密钥也不必交给远程机器。
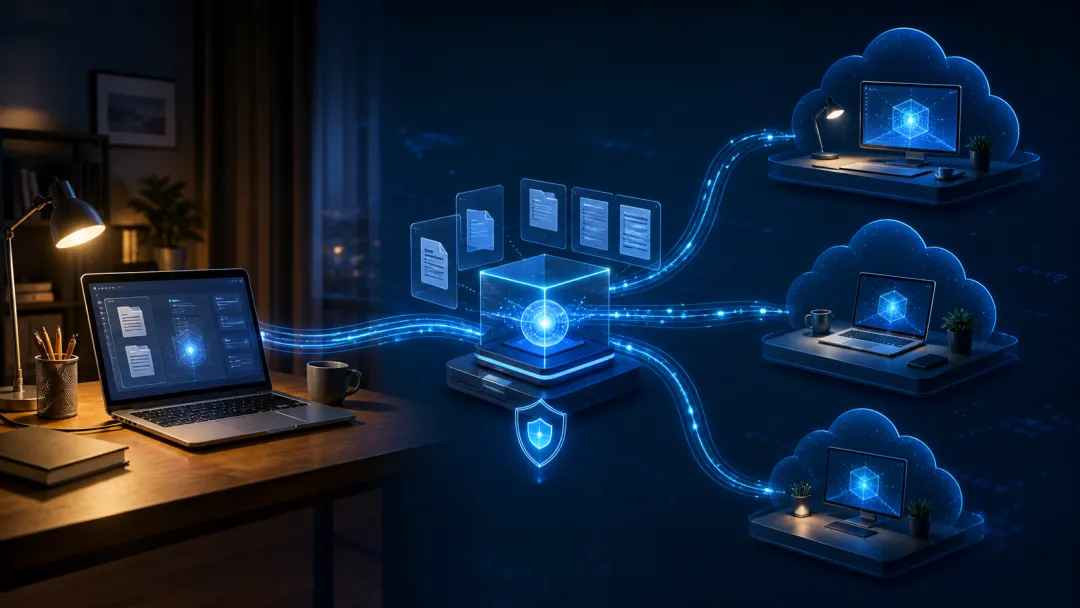
以后你交给AI的,可能不再是“帮我改一下这段代码”,而是“把这个项目处理完,结束后告诉我”。至于它调用哪台电脑、任务跑多久,你不必全程盯着。
我们一直以为,AI能力的天花板由模型决定。现在看,模型只是脑子。它有没有可调度的电脑和不会中断的工作环境,同样决定了它能干多少活。
会做还不够,它开始留下“手艺”
更容易被忽略的,是Skill Workshop。
按照官方目前公布的设计,OpenClaw可以从一次对话、一个完成过的任务,或者用户指定的材料中,提炼出可重复使用的Skill。
今天你手把手教它整理某种报表,明天遇到相似任务,它不必重新猜测你的要求。一次工作,可能变成以后反复调用的方法。
不过,这也是最容易被说过头的部分。Skill Workshop目前仍被官方标记为proposal,即提案阶段。它的设计也不是让Agent悄悄改写自己:新技能先形成提案,再经过扫描、校验和人工确认,出了问题还要能够回滚。
所谓“自我学习”,真正困难的从来不是学会,而是回答三个问题:它学了什么,谁批准的,出了问题怎么撤回。
越像员工,越不能只靠信任
OpenClaw最近大量更新权限、密钥和审计能力,乍看没有“控制电脑”那么吸睛,却可能决定它能否真正进入公司。
密码可以通过遮罩窗口输入,不进入聊天记录;定时任务只能获得指定操作的授权;不同会话可以拥有不同的文件访问范围;插件安装要显示来源和风险。
为什么突然需要这么多规矩?
一个只会回答问题的AI,答错了通常只是浪费几分钟。一个能够登录账号、修改文件、调用云主机并长期工作的Agent,一旦权限含糊,造成的就可能是真实损失。
能力越强,信任越不能靠一句“请放心”。它需要日志、授权、隔离和撤销,需要像管理真实员工一样,知道它能去哪儿、能碰什么、做过什么。
这正是OpenClaw 2.0之后最有意思的反差:表面上,它在努力让AI更自由;底层却在拼命给这种自由安装刹车。
分水岭已经不在聊天框里
过去两年,AI竞争很容易被简化成模型排行榜:谁回答得更快,谁写代码更好,谁的参数更多。
但Agent进入真实工作以后,问题变了:它能否连续工作?中断后能否接着做?会不会沉淀经验?用户能否看清它在做什么?越界时能否立刻拦住?
这些能力单独看都不性感,组合起来却很像一家公司真正的运转方式:有人思考,有资源可以调度,有流程可以复用,也有制度约束权限。
所以,OpenClaw真正值得关注的,并不是“AI终于会用电脑了”。
更大的变化是,AI正在获得过去只有组织才拥有的东西:持续工作的环境、可以积累的方法,以及一套约束行为的制度。
当一个Agent既能干活,又能记住怎么干,还能调用更多机器继续干时,我们面对的就不再是一个更聪明的聊天机器人。
而是一种刚刚开始成形的新型劳动力。