ARTICLE · 1006362
【AI短剧深度拆解】:《后西游记》的 5 个创作套路,普通人也能直接抄 !
AI漫剧工业化系列 · 深度拆解
别再抽卡了!上卫视的这部AI剧,是这么「拍」出来的
拆解《后西游记》的 5 个创作套路,普通人也能直接抄
先说一个扎心的数字
2026 年上半年,全网新上线 AI 短剧超过 22 万部,播放量破亿的只有 1055 部,破亿率 0.47%。
99.5% 的 AI 剧石沉大海。为什么?因为大多数人做 AI 视频的方式,本质上是「抽卡」:写一句提示词,抽一次,不满意再抽一次。抽到第 38 次,人物脸变了;抽到第 52 次,胳膊穿模了。你手里握的不是摄影机,是盲盒机。
而最近开播的《后西游记》——国内首部登陆卫视黄金档的 AI 长剧(30 集、每集 40 分钟),背后是芒果 TV 旗下的 AIGC 平台「芒果灵创」。他们干的事情,一句话概括:
把 AI 视频生成从「随机抽卡」变成「可控拍摄」。
导演不再站在摄影机后面,而是站在一整套工业流后面。
这篇文章拆解他们的 5 个核心手法,并且告诉你:就算你用的是即梦、可灵、Midjourney 这些通用工具,也能把这 5 个思路「降维」搬到自己的漫剧里。每一条后面都配了普通人可落地的抄作业方案。
一、先看懂:抽卡式 vs 拍摄式
❶ 一句提示词直接生成整段
❷ 角色靠「文字描述」记住,换个场景就变脸
❸ 镜头语言靠「猜」,模型给什么用什么
❹ 一处瑕疵 = 整段重抽
❺ 废片率高,算力烧钱,心态烧穿
✓ 角色是「资产」,有档案、有骨骼、可复用
✓ 场景是「资产」,美术风格有统一底座
✓ 镜头是「参数」,焦段机位运镜逐项设定
✓ 瑕疵是「局部」,框选区域精准修改
✓ 每次生成可追踪,废片是资产不是垃圾
看出区别了吗?抽卡赌的是运气,拍摄靠的是体系。下面逐个拆这 5 个体系。
40+ 模型协同调度:别迷信「一个模型打天下」
很多人以为 AI 剧组就是「一个文生视频模型从头干到尾」。芒果灵创不是。他们为《后西游记》调度了 40 多个模型分工协作:角色生成、场景生成、动作驱动、口型同步各归各的模型,甚至因为通用模型都是围绕「真人脸部」训练的,对动物角色的嘴部结构适配不足,团队单独训练了动物类角色的垂类模型,专门解决「猴子开口说话口型对不上」这种问题。
这个思路翻译成剧组语言就是:没有一个演员既能演武打、又能配音、又能搭布景。专业的事交给专业的模型。
💡 普通人怎么抄作业
▸ 角色立绘用 Midjourney / 即梦(美术质量高)
▸ 首尾帧图生视频用 可灵 / Vidu(动作连贯)
▸ 口型配音用 对口型专用工具(声音驱动嘴型)
▸ 剪辑合成用 剪映 / CapCut(节奏与音乐)
核心不是用哪家,而是建立「分工意识」:每个环节固定用同一个工具,不要让一个模型包圆全流程。
109 角色 + 143 场景:资产管理才是防「风格漂移」的根
《后西游记》在芒果灵创平台上沉淀了 109 个角色数字资产、143 个场景数字资产,全部收纳进「中华历史服化道素材库」——服饰、兵器、器物、建筑构件,衣冠器物皆有出处,建筑构件不凭空杜撰。更关键的是:剧中新诞生的角色和场景会回流到资产库,第二季开发时反复调用,成本越摊越薄。
为什么这招最重要?因为「风格漂移」的根源不是模型不行,而是你每次都在重新描述角色。文字描述是有损压缩——你今天写「红色铠甲的少年」,明天模型给你的可能是另一副铠甲。资产库的本质,是把「描述」升级成「调用」。
💡 普通人怎么抄作业
▸ 为每个角色建一张「角色设定卡」:固定一段永不改动的核心描述词 + 一组定妆参考图(正/侧/背三视图最佳)
▸ 建本地场景素材库文件夹:每个场景一张基准图,命名规则统一(如「花果山_黄昏_01」)
▸ 生成时永远用图生图 / 参考图模式调用资产,而不是靠记忆重新打字
▸ 每个新角色出场后,把最满意的 3 张图沉淀回素材库——一次创作,终身复用
虚拟相机:让 AI 画面「会说话」的镜头语言
这是我最推荐普通人学的一招。芒果灵创上线了「虚拟相机」系统:创作者可以自主设定焦段、机位、景深、运镜、快门速度,再配一整套 3D 打光——主光、辅光、轮廓光、光比、色温、光线方向全维度可调。
为什么这能让画面「会说话」?因为镜头语言本身就是情绪语言:
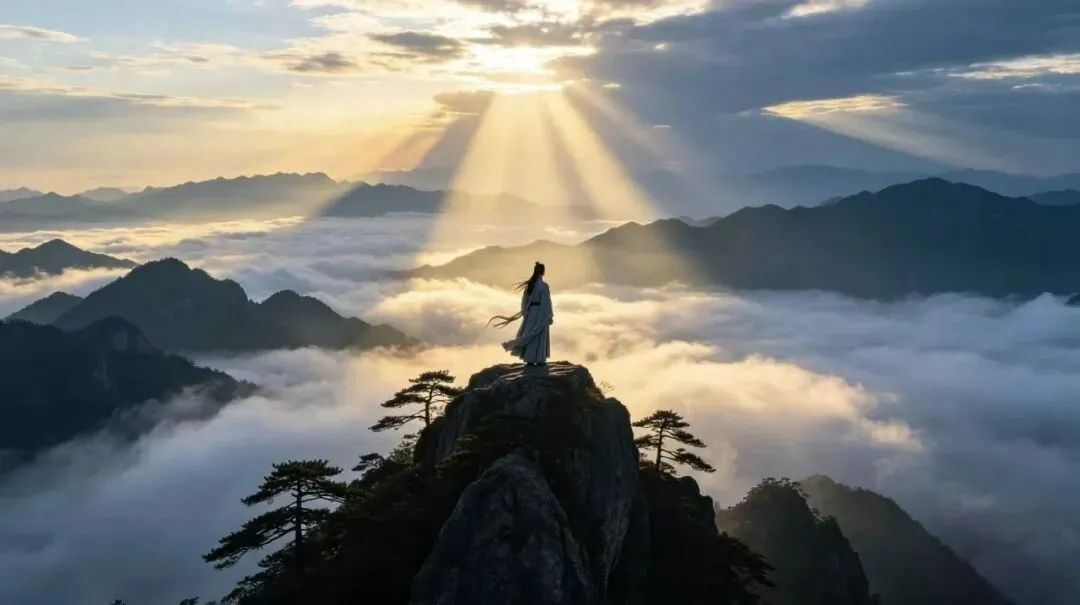
🎬 广角铺开——奇幻空间有了辽阔的呼吸感
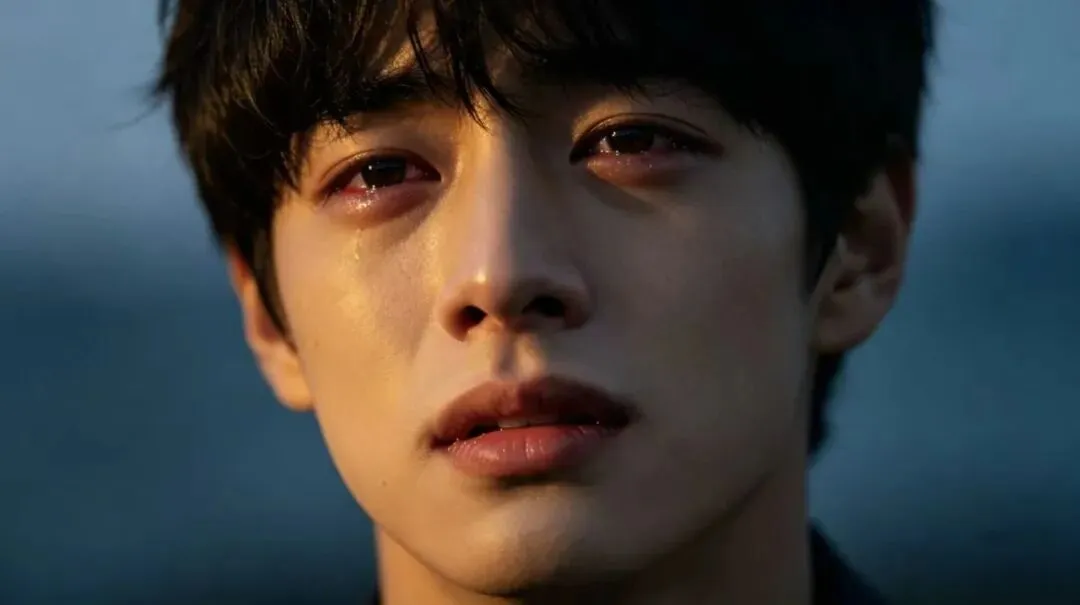
🎬 长焦压近——角色对话只剩情绪
🎬 低机位仰拍——力量感从脚底升起
🎬 一束轮廓光——人物从背景里被托出来
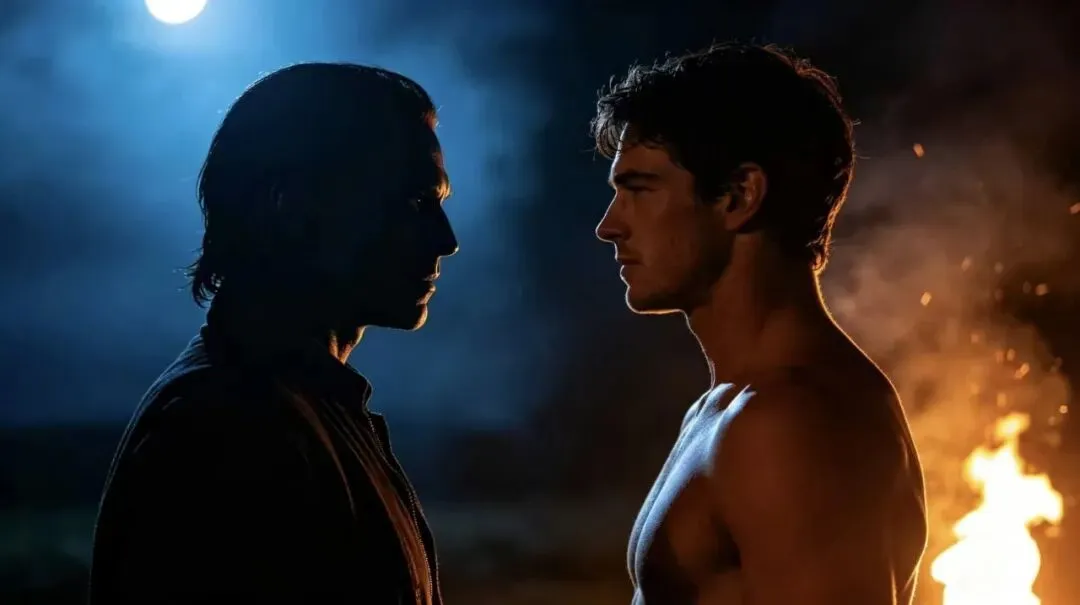
🎬 冷暖光对撞——戏剧冲突就在一明一暗之间
通用模型生成镜头的逻辑是「猜」,不是「拍」。而你可以把摄影机语言直接翻译进提示词——这是普通人不用任何特殊平台就能做到的事。
💡 普通人怎么抄作业
▸ 每个分镜的提示词里必须包含四要素:焦段 + 机位 + 运镜 + 灯光(具体模板见下文)
▸ 写分镜脚本时先画「镜头意图」:这个镜头是交代空间、还是放大情绪?先定功能再填参数
▸ 用剪辑思维排布镜头节奏:全景交代 → 中景推进 → 特写爆发,别让每个镜头都是差不多的中景
人形骨骼控制:把「人物跳变」挡在生成之前
AI 长剧最大的噩梦是「人物崩坏、肢体穿模」:上一帧还是七头身,下一帧手长过膝。芒果灵创的解法不是「崩了再修」,而是自研人形骨骼控制系统,在生成之前就预先固定人物比例、姿态与场景尺寸,从源头杜绝身形跳变。
这个思路的核心是一句话:与其事后补救,不如事前约束。生成前多花 1 分钟锁定骨骼结构,胜过生成后重抽 20 次。
💡 普通人怎么抄作业
▸ 提示词中显式锁定身体比例与结构(如 "consistent character proportions, correct anatomy"),不要只写外观不写结构
▸ 复杂动作先在通用工具里用骨骼参考 / 姿态图(pose 图生图),再驱动视频生成
▸ 大幅度动作拆成短镜头(2-3 秒/镜),别让模型一口气完成转身+打斗+表情变化
▸ 同一角色的所有镜头共用同一组定妆参考图,比例一致性会显著提升
局部编辑:一处瑕疵 ≠ 整段重来
生成视频最怕好画面里藏着一处瑕疵:一个口型没对上、一帧手糊了。从前这意味着整段重来。芒果灵创做了两层解法:精准定点编辑——框选区域、输入修改需求,只调整局部;以及涂鸦式修图——画一线改动作、画一圈增删元素。最大限度保住整段优质画面。
这一点对产能核算至关重要:废片率降下来,AI 剧的账才算得平。他们还有一套团队协作系统,按项目、成员、场次、分镜四个维度追踪每一次生成记录与成本——连「废片」都被保存下来,可回看、可筛选、可复用。今天的一次废片,可能就是明天的一条捷径。
💡 普通人怎么抄作业
▸ 善用通用工具的局部重绘(inpaint)功能修单帧,再用图生视频延续
▸ 建一个「废片银行」文件夹:抽卡时偶遇的好画面单独存档,以后可能直接复用
▸ 给每个项目做生成日志(哪个镜头、用了什么提示词、第几次成片),一个月后你会拥有一本自己的「量产手册」
镜头级提示词字段模板
把上面 5 个手法压缩成一张可直接套用的模板。每次生成分镜前,按这 7 个字段填空:
【角色资产】固定核心描述词 + 参考图编号【场景资产】场景基准图 + 时段 + 天气【焦段】广角 24mm / 标准 50mm / 长焦 85mm+【机位】平视 / 低角度仰拍 / 高角度俯拍 / 过肩【运镜】固定 / 推 / 拉 / 摇 / 跟随【灯光】光源方向 + 光比 + 色温(冷/暖)【动作与情绪】单镜头只做一件事
前两个字段管「资产一致性」,中间四个字段管「镜头语言」,最后一个字段管「表演」。这就是一套微缩版的芒果灵创工作流。
中英双语提示词示例
示例 ① 情绪特写(长焦 + 轮廓光)
示例 ② 史诗全景(广角 + 运动镜头)
示例 ③ 对峙镜头(过肩 + 冷暖对撞)
📌 一张图记住本文
模型协同 → 分工,不包圆资产管理 → 调用,不重述虚拟相机 → 拍摄,不抽卡骨骼控制 → 事前锁,不事后修局部编辑 → 改局部,不推倒重来
《后西游记》验证的这条路,本质上是把百年影视工业积累的「剧组分工 + 制片管理」搬进了 AI 时代。你不需要 40 个模型和百人团队,但你可以拥有同样的思维:从今天起,别再做抽卡的人,做那个站在虚拟摄影机后面的导演。
你在 AI 漫剧创作中踩过最深的坑是什么?评论区聊聊,下一篇专题拆解 👇
—关注我,每周一套 AI 漫剧技巧方法—