ARTICLE · 1006381
AI Native 的核心不是让 AI 做更多事,是让做和验彻底分家
AI Native 不是工具升级,是把「生产」和「评价」拆开——以及一份不该被当成定律的清单
先纠正一个用词。
AI Powered的意思是:我们给员工配了 AI 工具。
AI Native的意思是:我们的工作流、决策路径、责任归属、激励结构,全部围绕「AI 是默认执行者」这个假设重新设计过。
这两个词在过去两年里被混着用,结果是大量公司以为自己完成了转型,其实只完成了采购。
一家传统结构的咨询公司,让员工用上 AI 写代码,它还是一家传统咨询公司。工具变了,谁做什么、谁说了算、出事谁负责——一个字没改。
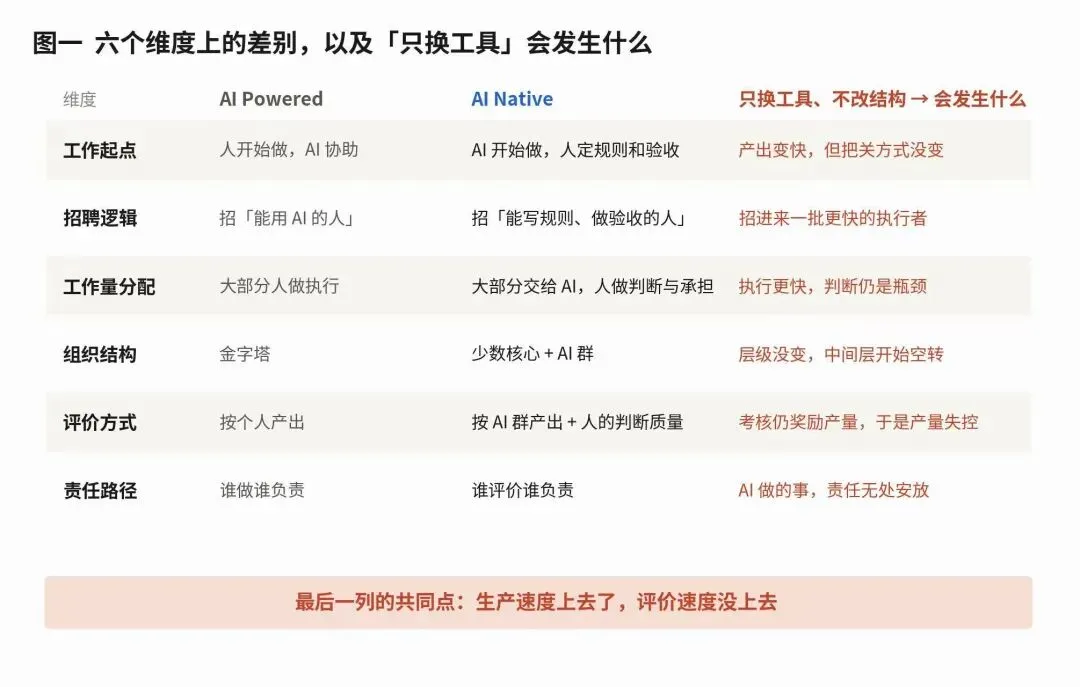
图一:六个维度上的差别,以及「只换工具」会发生什么
这张图最后一列是我加的:如果只换工具、不改这六件事,会具体发生什么。
因为大部分讨论停在「两种公司不一样」,但没说清楚不一样在哪里会出事。而答案高度集中在一个地方:
生产速度上去了,评价速度没上去。
这就是这篇文章唯一想说清楚的事。
一、三个判断捷径,其中两个有问题
流传的自测方法有三个。我逐个审计。
捷径一:你们开会时,还讨论「这件事该让 AI 做还是人做」吗?
这条是好的。AI Native 公司不讨论这个,它默认 AI 做;它讨论的是「做完了谁来验收、按什么标准验收」。讨论对象的差别,确实反映了组织假设的差别。
捷径二:你们的中层焦虑吗?据说 AI Native 公司的中层不焦虑,因为他们的工作本来就不在射程内。
这条我认为不成立。
第一,焦虑是个人处境的指标,不是组织结构的指标。同一家公司里,有人焦虑有人不焦虑,取决于房贷、年龄、家庭、性格,跟公司是不是 Native 关系不大。
第二,也更重要:「我们的中层不焦虑」是一个组织最容易自我欺骗的判断。你听到的「不焦虑」,可能只是没人愿意在老板面前说。焦虑的人要么已经走了,要么学会了闭嘴。
第三,就算真的不焦虑,这也不必然是好消息。写规则、做验收、扛责任——这些工作同样在被侵蚀,只是慢一点。把「我现在不焦虑」当成「我的位置安全」,是这轮变化里最常见的误判。
捷径三:看你们每个员工每月消耗多少 token。据说 AI Native 公司会高一个数量级。
这条最危险。它在事实层面大致对,但作为指标它是错的,原因有两个:
第一,它是投入指标,不是产出指标。用消耗衡量成熟度,等于用油耗衡量司机水平。一家把简单任务反复重跑十遍的公司,token 消耗会非常好看。
第二,它一旦变成 KPI,就会立刻被刷。这是古德哈特定律最标准的形态:一项指标一旦成为目标,它就不再是好指标。你会看到人们为了「显得 Native」而故意让模型多跑几轮——这不是转型,这是烧钱表演。
那什么指标是有意义的?我的答案是:返工率。
具体说:AI 产出中,被独立验收打回的比例,以及被打回的原因分布。
这个指标有三个好处:它同时衡量生产端和评价端;它没法靠增加消耗来刷好看;而且如果它是零,那说明你根本没有真正的验收环节——因为不可能有一个生产者的输出永远全对。
返工率为零,不是质量好,是没人在看。
二、真正的硬约束:生产的人不能是评价的人
这是唯一一条我认为足够硬、值得当规矩的东西。
而且它不是新东西。任何写过代码的人都知道,「自己写的代码自己 review」是行业里最经典的 bug 来源之一。自己评价自己,标准会不知不觉地降低,而且当事人真诚地觉得没有降低。
值得一提的是,这一条在 AI 时代已经被写进了公开的工程实践建议里。Anthropic 面向创业者的那份 playbook 里有一句表述非常干脆:
人来批准,而写这段代码的那个 agent 不能批准。
在前 AI 时代,这是一条质量建议。在 AI 时代,它变成了安全机制。
为什么级别提升了?因为 AI 的输出有四个独特的危险,而这四个危险叠在一起,会让「自评」从「标准松一点」变成「系统性事故」。
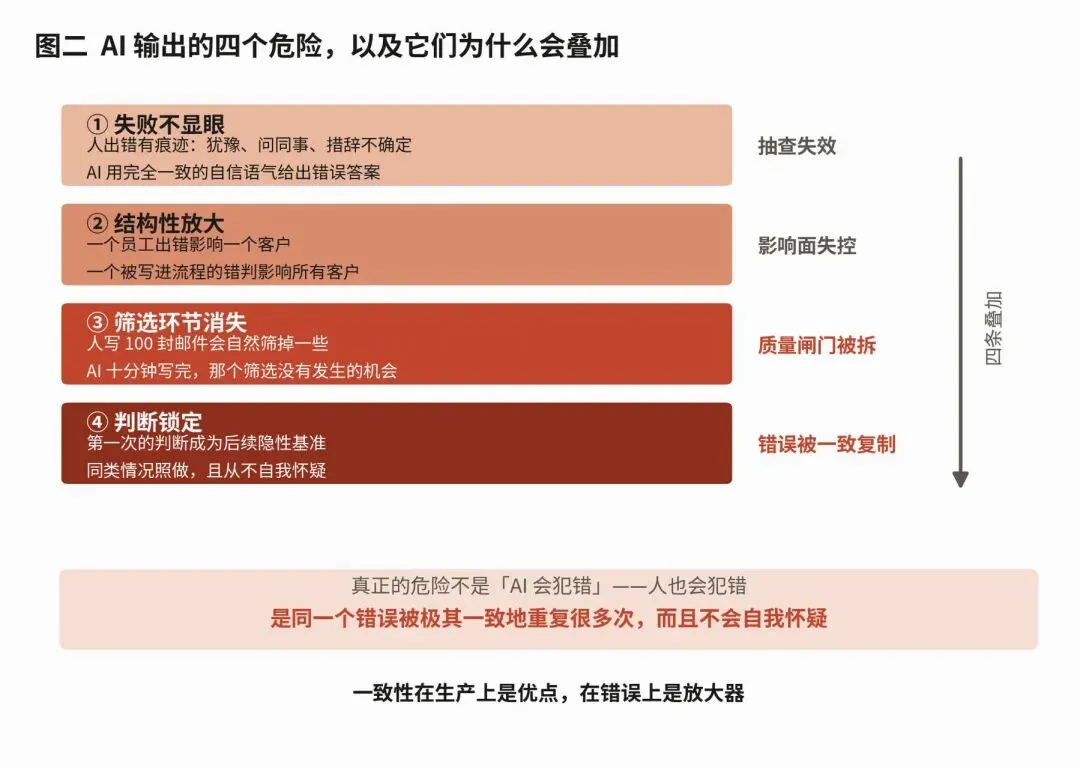
图二:AI 输出的四个危险,以及它们为什么会叠加
危险一:失败不显眼。
一个员工出错,通常有痕迹——他会犹豫、会问同事、会在措辞里露出不确定。AI 不会。它会用完全一致的自信语气,给你一个错误答案。错误和正确在表面上没有任何区别,这让抽查变得极其困难。
危险二:结构性放大。
一个员工出错影响一个客户。一个被写进工作流的错误判断,可能同时影响所有客户,而且是以完全一致的方式。
危险三:边际成本趋零,导致筛选环节消失。
一个人写一百封邮件要一周,写的过程中会自然筛掉一些——「这封算了吧」。AI 十分钟写完一百封,那个筛选环节根本没有发生的机会。
过去「产出成本高」本身就是一道质量闸门。这道闸门被拆了,而很多组织没有补上新的。
危险四:判断锁定——这一条最少被讨论,但它才是「级联」的真正机制。
当一套 AI 流程第一次对某类情况做出判断,这个判断很容易变成后续的隐性基准:同类情况来了,就按同样的方式处理。它不会像人一样偶尔想「上次那么做对吗」。
所以真正的危险不是「AI 会犯错」。人也会犯错。
真正的危险是:
同一个错误,会被极其一致地重复很多次,而且不会自我怀疑。
一致性在生产上是优点,在错误上是放大器。这就是为什么这类事故往往不是「出了一个大错」,而是「同一个小错出了一万次,直到审计时才被发现」。
这四条加起来,结论是唯一的:如果生产端和评价端是同一个人(或同一个流程),组织会被高一致性、低质量、广泛影响的产出淹没,而且淹没的过程是安静的。
三、四个角色,以及一个必须澄清的出处问题
关于 AI Native 的组织结构,流传着一个四角色模型:
Skill Owner设计能力边界(能做什么、不能做什么、依赖什么数据);Reviewer不做生产,只对关键输出做最终决策;Steward负责跨流程的编排、触发、上下文传递和回滚;Accountable是出事时显式签字的人。
关键设计是:没有任何一个人同时做生产和评价。链条上每个位置都是单向的。
这个模型本身很有用。但有一件事必须说清楚:
这四个角色名不是 Anthropic 官方文档里的说法。我去核了那份公开的 playbook,它确实强调了「写代码的 agent 不能自己批准」这条分离原则,但它列出的角色是 Product Owner、Policy Owner、Engineer、Tech Lead 这类常规名称,并没有 Skill Owner / Steward / Accountable 这套命名。
把一个自创模型挂到大厂官方文档名下,是这类文章里非常常见的操作。它会让模型显得更权威,也让读者失去对它提出质疑的心理许可。所以我在这里标出来:这个四角色模型可以用,但它是一个民间框架,不是官方规范。
而且更值得注意的是:那份 playbook 实际采用的做法,比固定四角色更聪明。
它不是给每个人贴一个固定角色,而是按风险给每一次变更路由不同强度的验收——依据包括改动的影响半径、涉及的系统关键程度、历史事故记录、是否触及安全与合规。日常改动走轻量审核,高风险改动指定专人审批。
这个差别很关键,因为它解决了固定四角色最大的问题:成本。
四、必须泼的三盆冷水
第一,「绕开验收分离,六个月内必出系统性事故」——这句话没有依据。
它听起来很有力,但它是一个没有基准率的预测。没有人统计过有多少家公司绕开了这条、其中多少家出了事、多少家什么事都没有。我们能看到的只有出事的那些,因为不出事的公司不会被写成案例。
这是标准的幸存者偏差的镜像版本——我们只看到了失败者,于是以为失败是必然的。
分离生产与评价,理由应该是它的机制成立(上一节那四条),而不是一个吓人的时间表。用假数据支持一个真结论,是在给这个结论埋雷。
第二,事故案例都是事后叙事,归因不可靠。
流传的那类案例——某家做 AI 法务的公司把合同审查完全交给 AI,没有独立验收,几个月后客户审计发现同一类条款问题被反复漏掉——机制上完全讲得通,我在上一节也用了同样的机制。
但作为证据,它很弱。一家出事的公司通常同时有十个问题:产品定位、销售承诺、客户预期管理、团队变动。事后从中挑出一个作为「根本原因」,是最容易犯的归因错误。案例能说明机制存在,不能说明机制是主因。
我也没能查到「AI cascade failure」是一个业内已经确立的术语。机制是真的,标签可能是转述中长出来的。
第三,四角色结构对小团队是奢侈品,硬套会瘫痪。
一个十人以下的团队,如果强行要求四个位置由四个人担任,结果不是更安全,是没人干活。而更现实的后果是:这套流程会在第一次赶工期时被整体绕过,然后再也不会被捡起来。
一个在压力下会被绕过的流程,等于没有流程。
所以正确的做法不是照搬角色表,而是照搬那条更聪明的原则——
五、可执行的版本:按「爆炸半径」决定验收强度
把唯一的硬约束(生产者不能自评)保留,把成本按风险分层。
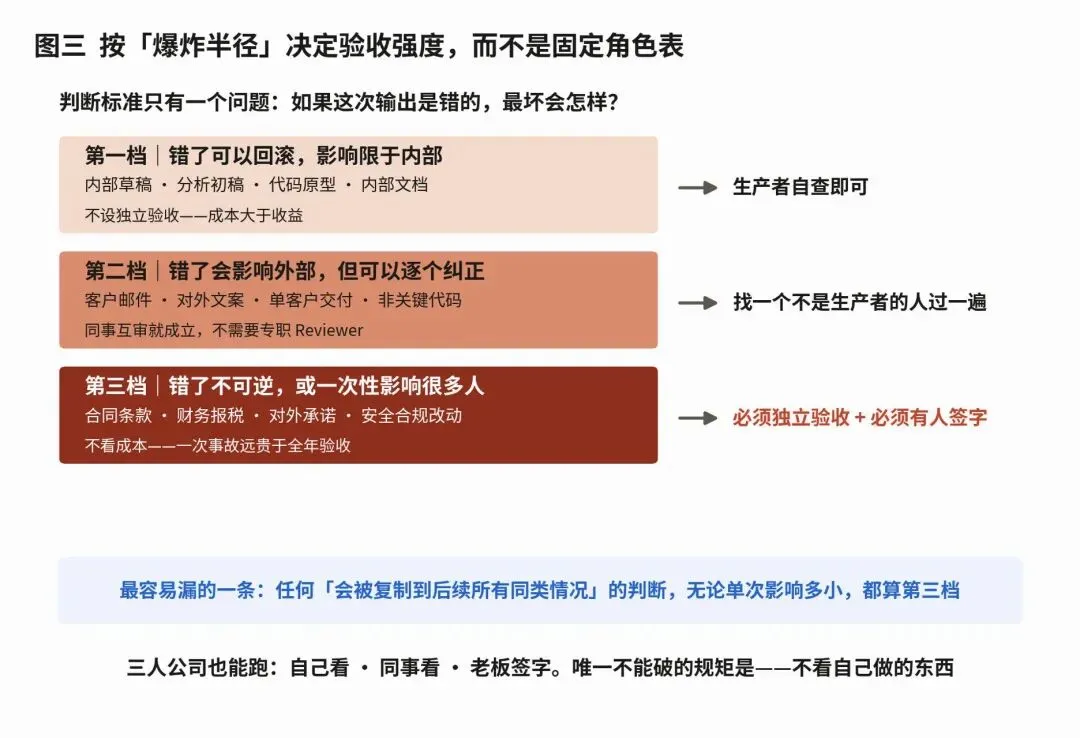
图三:按爆炸半径路由验收强度
判断标准只有一个问题:如果这次输出是错的,最坏会怎样?
第一档:错了可以回滚,影响限于内部。
内部草稿、分析初稿、代码原型、内部文档。
→ 生产者自查即可。这一档不设独立验收,因为成本大于收益。
第二档:错了会影响外部,但可以逐个纠正。
发给客户的邮件、对外文案、单个客户的交付物、非关键代码。
→ 需要一个不是生产者的人过一遍。注意,「不是生产者」是唯一的硬要求,不需要是专职 Reviewer,同事互审就成立。
第三档:错了不可逆,或会一次性影响很多人。
合同条款、财务与报税、对外承诺、涉及安全与合规的改动、任何会被写进模板然后重复执行的判断。
→ 必须有独立验收,且必须有一个签字的人。这一档不看成本,因为一次事故的代价远大于全年的验收成本。
最后一档里有一条最容易被漏掉,我单独强调:
任何「会被复制到后续所有同类情况」的判断,无论单次影响多小,都属于第三档。
因为这正是「判断锁定」发生的地方。一个只影响一个客户的判断,一旦被固化进流程,它就不再只影响一个客户了。
这套分档的好处是它可以在三人公司里跑起来:第一档自己看,第二档找同事看,第三档老板签字。不需要新增编制,只需要一条不能破的规矩——不看自己做的东西。
六、关于「性格对位」的一点保留
四角色模型还有一个延伸说法:不同角色需要不同性格的人。Skill Owner 要系统思维,Reviewer 要有品味且不怕退货,Steward 要流程感强,Accountable 要有担当。放错位置组织就跑不起来。
这个观察有道理,尤其是 Reviewer 那条。一个不愿意得罪人的人做验收,验收就是橡皮图章——这是真实且常见的失败模式。
但有两点保留。
其一,「AI Native 公司招聘成功率明显低于传统团队」这类说法,我没有找到任何数据支撑,它更像是圈内的印象转述。
其二,也更重要:按性格分配岗位,很容易从「洞察」退化成「标签」。「他不适合做 Reviewer,他性格太软」——这句话可以用来解释一切人事安排,也可以用来回避真正的问题(比如这个人没有被授予拒绝的权力,或者拒绝之后没有人给他撑腰)。
Reviewer 敢不敢退货,八成不是性格问题,是权力问题。
如果一个组织里,验收者退回了老板亲自设计的东西之后会被穿小鞋,那么招什么性格的人都没用。结构问题不要用性格来解释。
结尾
这篇文章说了很多,但如果只能留一句,是这句:
AI Native 的核心不是让 AI 做更多事,是让「做」和「验」彻底分家。
前者是采购,任何公司花钱都能办到。后者是结构,需要重新安排谁有权力否决谁——而这件事没有任何工具可以代劳。
所以最实用的自测不是数 token,也不是问中层焦不焦虑。
是问一句:
上一次有人把 AI 的产出打回去重做,是什么时候?打回去的那个人,是不是做这件事的人本人?
如果想不起来,或者答案是「就是他自己」——
那么你们买的是工具,不是结构。