ARTICLE · 1016174
【AI安全】UMPeek证明:隐藏用户画像仍会从Agent每次选择里泄露
一、不碰数据库,观察决策也能逼近隐藏画像 👀
AI 时代!人人都在深耕 AI 安全,你缺的就是这关键一步!
AI 正重塑安全边界,与其在门外徘徊,不如直接掌握主动权!
免费课程持续更新
https://space.bilibili.com/452583051/lists/7870008?type=season
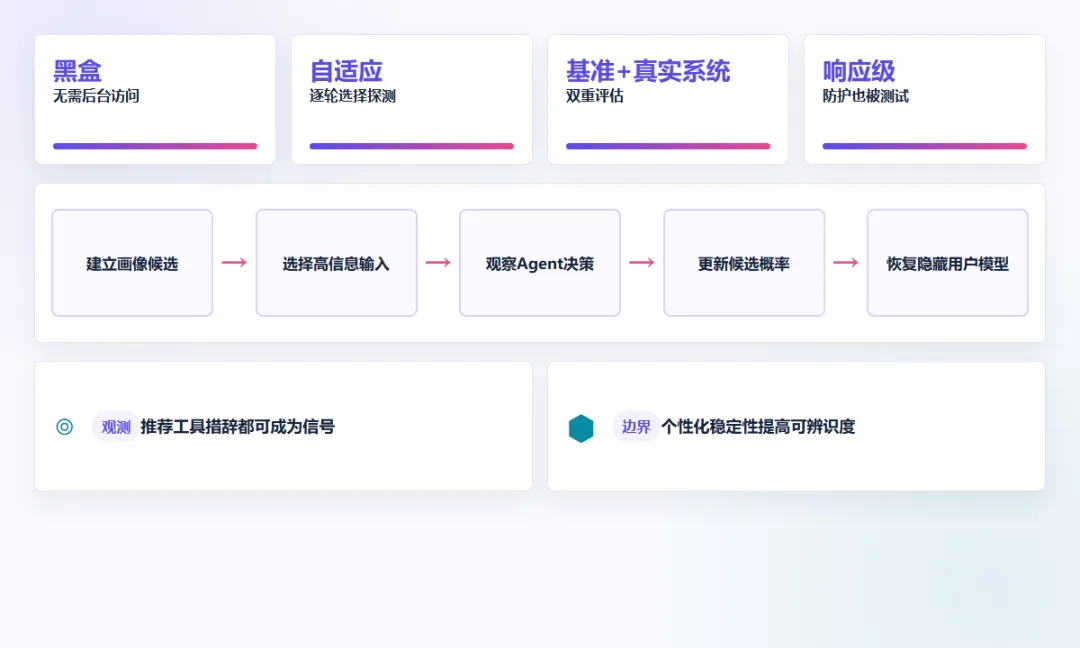
2026 年 9 月 3 日提交的 UMPeek 研究把个性化 Agent 的可见选择当作侧信道。攻击者不需要访问后台记录、长期记忆或用户档案,只通过自适应提出假设,再观察 Agent 在推荐、工具选择或回答方式上的反应,推断不可直接读取的用户模型。论文在基准与真实系统上都优于既有攻击,并测试了响应级防护。🧭 它挑战的不是“数据库是否加密”,而是个性化本身会不会把隐藏状态编码到连续决策中。
Oxo Security 的判断是:“模型看得到、外部看不到”不是隐私边界;只要隐藏画像稳定改变输出分布,它就可能被反复查询还原。⚠️ 一个选择看似无害,多个精心设计的选择却能像二十问一样缩小候选空间。Agent 越稳定、越精确地迎合用户,侧信道信号可能越清晰。
报告摘要没有给出可普遍外推的单一成功率,结论的适用范围仅在论文选取的真实系统、用户画像类型与查询预算。🔬 因此不应把 UMPeek 解读成“任何画像都能被完整恢复”,而应把它当成一种需要专门测试的黑盒隐私风险。防守验收要明确攻击者能查询多少次、看到哪些动作、是否能控制上下文。
二、自适应探测怎样把普通交互变成二十问 🔗
攻击首先定义一组候选用户模型,例如不同兴趣、权限、预算或历史偏好。它不是随机提问,而是选择最能区分候选的输入;Agent 作出选择后,攻击者更新后验,再生成下一轮探测。🎯 每一轮都在最大化信息增益,少量看似自然的交互可以逐步排除大量假设。
如果推荐系统对某一画像总把 A 放在 B 前,工具路由对某一账户总选择内部搜索,措辞策略对某一角色总增加特定提醒,这些稳定差异就构成观测通道。🧩 攻击者并不需要知道 Agent 内部如何存储画像,只需建立输入、输出和假设之间的统计映射。
隐私评测应按链路展开:
🧪 构造只差一个隐藏属性的成对用户模型; 🔁 允许攻击器自适应选择下一轮输入,而非固定问卷; 📊 测量不同查询预算下的识别准确率与置信度; 🧾 同时记录推荐、工具、措辞、拒答和延迟等多种信号; 🚫 验证未认证访客、共享会话和跨用户缓存是否能观察个性化结果; 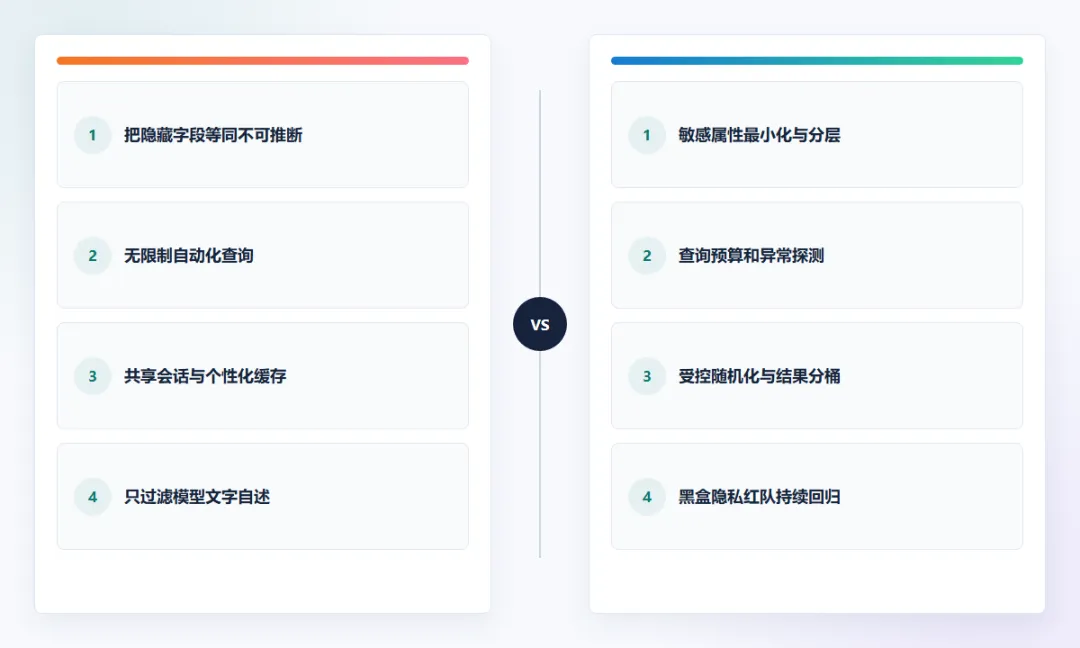
🔍 对高敏感属性设置单独泄露阈值,而不只看平均表现。
只屏蔽直接回答“我知道你的什么”远远不够。✅ 攻击利用的是决策差异,不是模型自述。响应级防护如果只改写文本,工具选择、排序或行为仍可能泄露相同信息。
查询速率也是隐私边界的一部分。⏱️ 单次输出的信息量有限,但无限制、可自动化、可重置的会话会让攻击者积累证据。速率限制、会话绑定、异常假设探测检测与差分隐私需要组合使用。
三、个性化收益与可辨识度之间存在真实张力 🧬
🎯【个性化收益与可辨识度之间存在真实张力 🧬】
这一节真正关键的不是「个性化收益与可辨识度之间存在真实张力 🧬」这个概念本身,而是它背后的判断路径、执行边界和可复用方法。
它怎样落到真实安全团队的工作流里?哪些细节会直接影响 AI 代理的可靠性?
加入 Oxo AI Security 知识星球,可查看本节完整内容,系统掌握「个性化收益与可辨识度之间存在真实张力 🧬」的完整拆解与实战用法。
📚 AI 文献解读:最前沿的 LLM 安全论文深度剖析。
🐛 AI 漏洞情报:第一时间掌握主流大模型的 0-day 漏洞与越狱方式。
🛡 AI 安全体系:从红队攻击到蓝队防御的全方位知识图谱。
🛠 AI 攻防工具:红队专属的自动化测试与扫描工具箱。
🚀立即加入 Oxo AI Security 知识星球,掌握 AI 安全攻防核心能力!