ARTICLE · 1017679
从一份公司简介 PDF,到一个能上线的官网:我实测了豆包 2.1 Pro 0915 的多模态 Coding
先说我为什么写这篇
我是亲客传媒的团队成员。我们公司做 XR 大空间沉浸式项目,做过刘慈欣《吞食者》的 VR 大空间(拿了中宣部电影局龙标,入围过金鸡百花电影节 XR 影展),也做过《一画开天·以启华夏》《营救飞虎》这类文旅文博项目。平时我们聊的是叙事、交互、空间动线,不是前端工程。
但公司一直缺一个像样的官网。投资人、场馆方、研学机构来问合作,我们只能甩一份 PDF 过去,或者翻公众号。2026 年 9 月中旬,我们终于决定:把官网做出来。
团队里没有人是专职前端。我也不算——我是做内容策划和项目统筹的,会一点 HTML,能看懂代码,但让我从零搭一个多页面的 Vue 工程,过去是想都不敢想的(外包报价高,周期长,而且我们这种"内容持续更新"的站点,外包交付后自己根本改不动)。
结果这次,我们真把官网做出来了,而且整个过程出乎意料地顺。这篇文章不是参数罗列,也不是泛泛测评,就是我真实跑通的一个完整 Case:从输入到产出,链路是什么、卡在哪、模型哪些能力真的帮我省了事、哪些地方还得靠人兜底。
任务全景:一个下午,从 PDF 到可上线的站
先交代一下任务本身,免得后面看得云里雾里:
输入材料:一份公司简介 PDF(图文混排,含公司定位、核心优势、XR 作品介绍、荣誉奖项表格、过往影综案例),还有一批作品海报图(《吞食者》科幻红金、《一画开天》国风金、《怪咖剧场》实验室青蓝、《营救飞虎》战争暖橙、《剧景游》青绿)。
目标产物:一套完整的公司官网,要能直接上线、能持续更新内容。
技术选型:Vue 3 + Vite + Vue Router 的多页面应用(这是我和豆包 2.1 Pro 0915 一起定的——我提"要能上线、要快、要能加内容",它给了这个方案,并解释了为什么比单页 HTML 更适合内容型站点)。
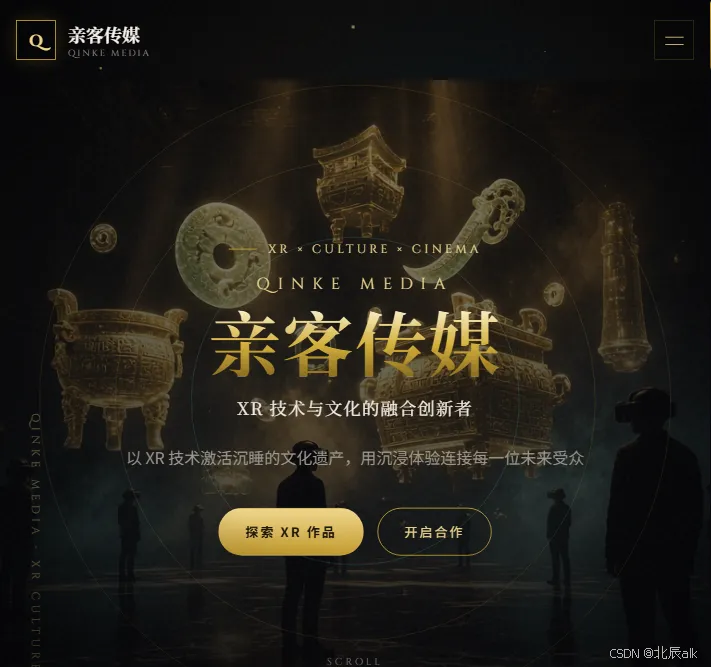
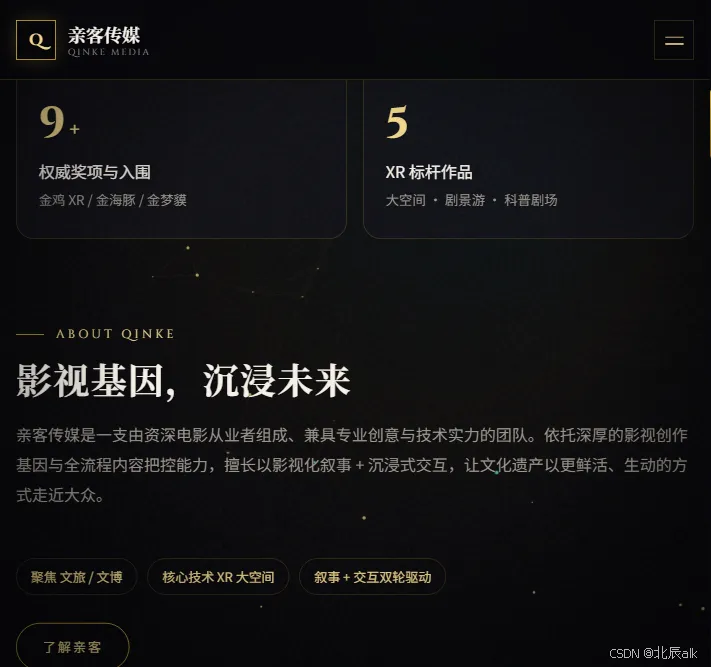
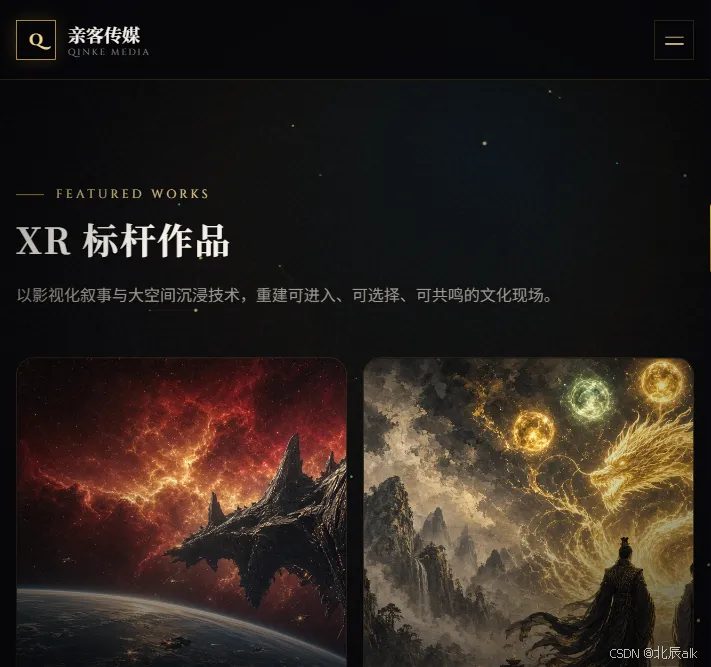
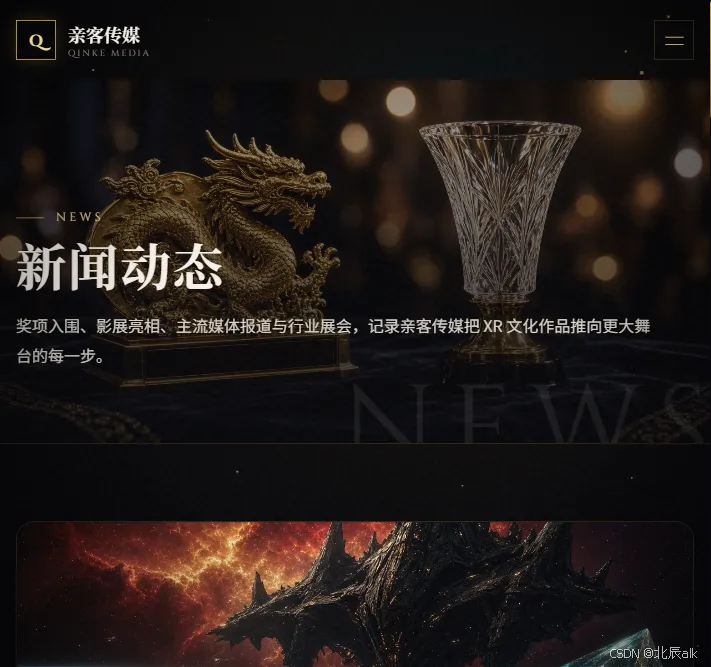
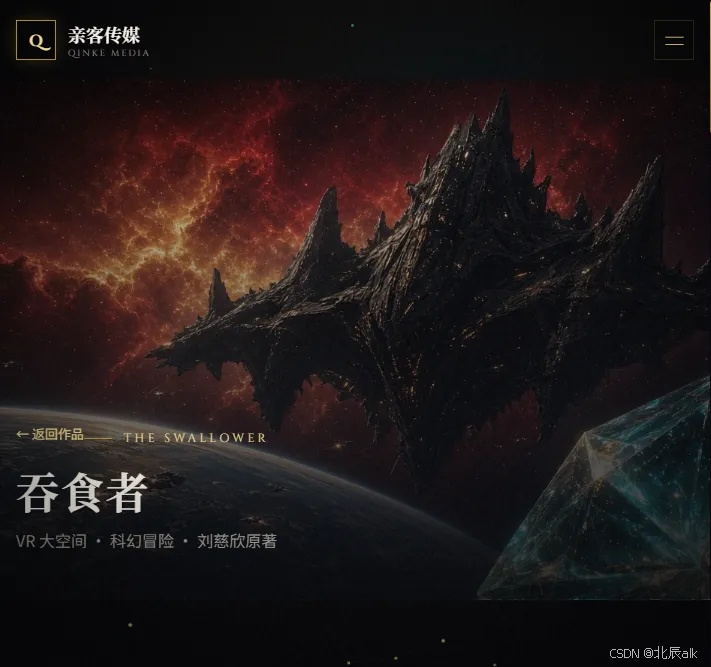
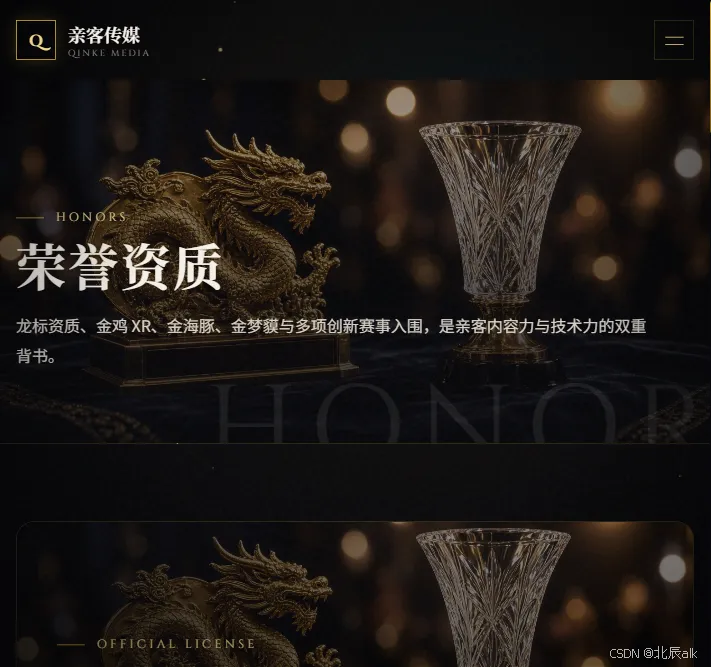
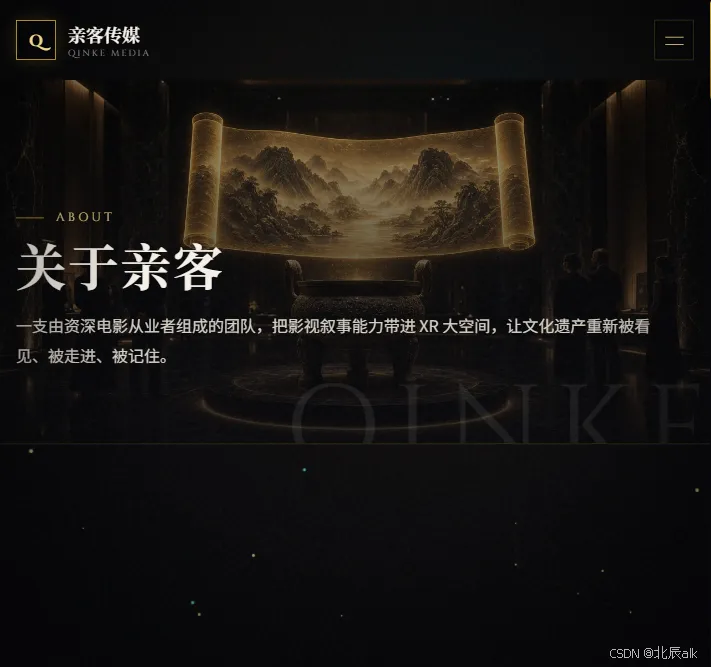
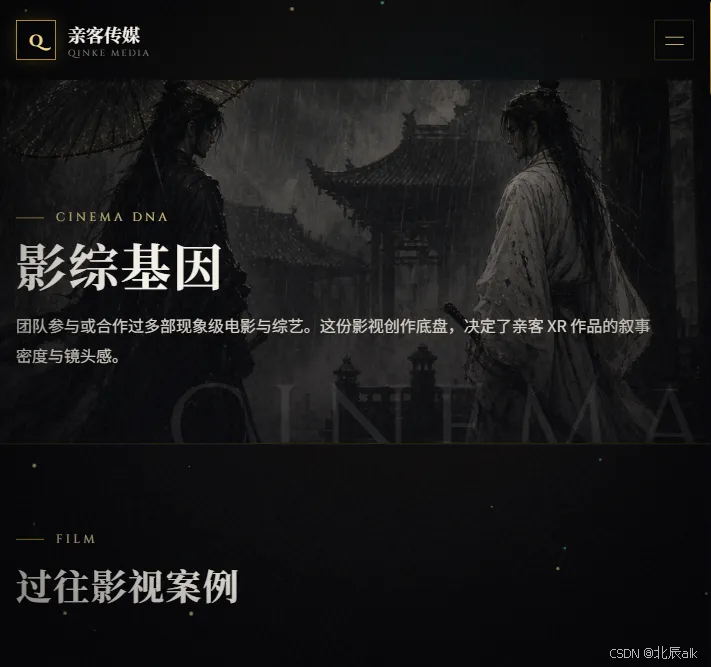
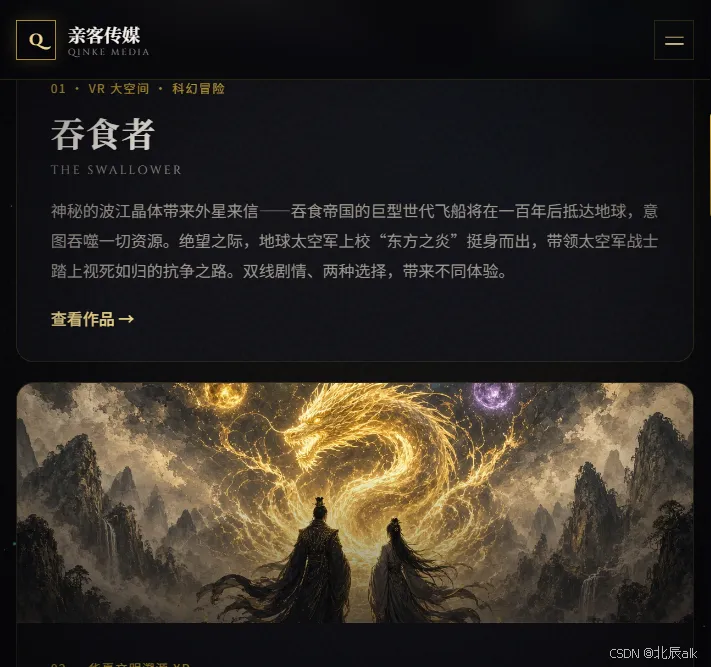
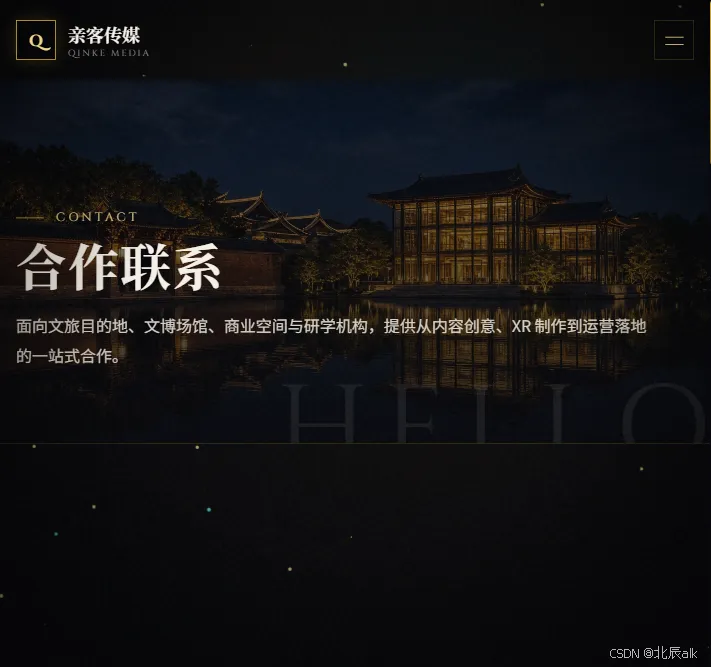
最终交付:8 个路由页面(首页、关于亲客、XR 作品、作品详情、荣誉资质、影综基因、新闻动态、合作联系),1 个数据驱动的内容层(5 部作品的详情页全部由一份数据文件自动生成),Canvas 粒子动效背景、滚动渐显动画、黑金视觉体系、移动端响应式适配。
验证结果:npm run build 一次通过,构建耗时 1.80 秒;主包 gzip 后约 47.8 KB;全站所有页面在本地预览逐页截图核验,无白屏、无报错。
第一关:让模型"读懂"一份图文混排 PDF
官网的第一步不是写代码,而是把内容从 PDF 里结构化地抠出来。这一步我以前都是人工做:复制粘贴、对表格、整理奖项时间线,半天起步。
这次我把 PDF 直接丢给豆包 2.1 Pro 0915,让它先做内容提炼。它返回的结果是一份结构化的内容摘要,层级非常清楚:
• 公司定位与口号(XR 技术与文化的融合创新者;"以 XR 技术激活沉睡的文化遗产,用沉浸体验连接每一位未来受众") • 公司简介、核心优势(接入 AI 大模型、多剧情线选择、多元交互设置、多人实时协作) • 独特价值表(活化文化遗产 / 传播多样化 / 多形态商业化 / 运营轻量化,每个维度带关键词和说明) • 5 个 XR 作品案例,每个都含故事梗概、类型、荣誉奖项、媒体报道 • 过往影综案例(张艺谋《影》《长城》等 6 部电影 + 综艺成绩) • 甚至主动给了"官网栏目建议":首页、关于亲客、XR 作品、荣誉资质、过往案例、新闻动态、合作联系
这份文件至今还在我项目目录里,叫 qinke_website_content.md。它成了后面整站内容层的"母本"——也就是说,官网上的每一段文案,源头都是这份模型从 PDF 里提炼出来的结构化内容,不是我自己重新编的。
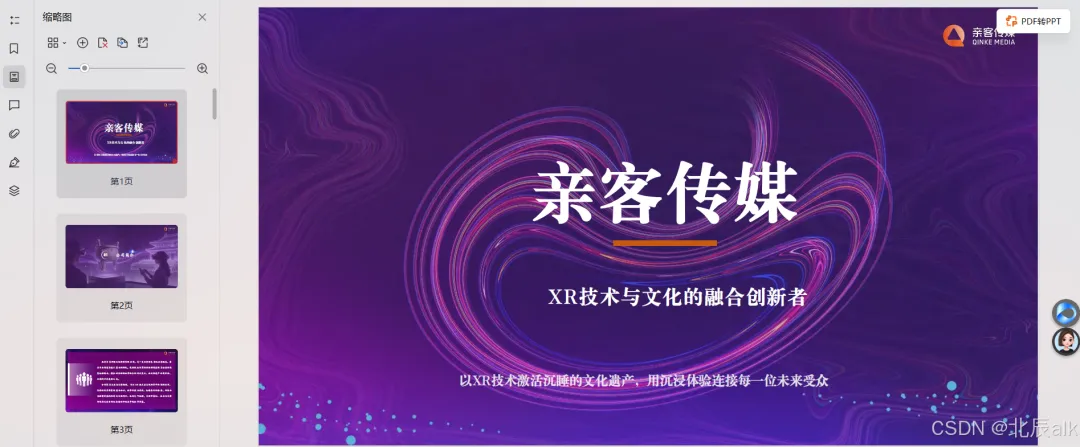
对应能力点:密集图文文档解析、表格提取、层级识读(图注/脚注/表头)。官方说这一代的 grounding 定位准确度比上一代提升 10% 以上,我体感上"该拿的信息一次拿全、不需要反复追问补漏",确实是省事的主要来源。
第二关:它先理清了整个工程,而不是急着写页面
内容有了,接下来是工程。这是我一开始心里很没底的环节:多页面站点、路由、组件、数据层,这些概念在我脑子里是散的。
结果豆包 2.1 Pro 0915 给方案的方式,是先讲结构,再写代码。它给出的工程骨架是这样的:
qkcm/
├── index.html / vite.config.js / package.json
├── src/
│   ├── main.js + App.vue          # 应用入口与整体布局
│   ├── router/index.js            # 8 个路由,懒加载 + 动态标题
│   ├── data/site.js               # 全站内容单一数据源
│   ├── composables/useReveal.js   # 滚动渐显(IntersectionObserver)
│   ├── styles/main.css            # 设计变量 + 全局基础样式
│   ├── components/                # AppHeader / AppFooter / WorkArt / SectionTitle / AmbientCanvas...
│   └── views/                     # 8 个页面视图
└── public/images/ # 作品海报与视觉素材这个结构的一个明显好处,是内容和展示分离:site.js 里存了公司信息、核心数据、优势、5 部作品的完整档案(故事梗概、原著、体验形式、龙标、配音、奖项列表、媒体报道)、6 部影综、新闻条目……而页面只负责渲染。所以后来我加一个新闻、改一条奖项,只需要改数据文件,页面自动更新——这对"内容要持续更新"的公司站来说太关键了。
它理解"复杂代码仓库"的方式也体现在细节上:路由配置里自动处理了文档标题(document.title)、滚动位置归零;作品详情页用 route.params.slug 从数据里匹配,而不是给每部作品写死一个页面。也就是说,它懂"这 5 个作品页是同一套模板 + 不同数据",而不是笨拙地复制五遍。
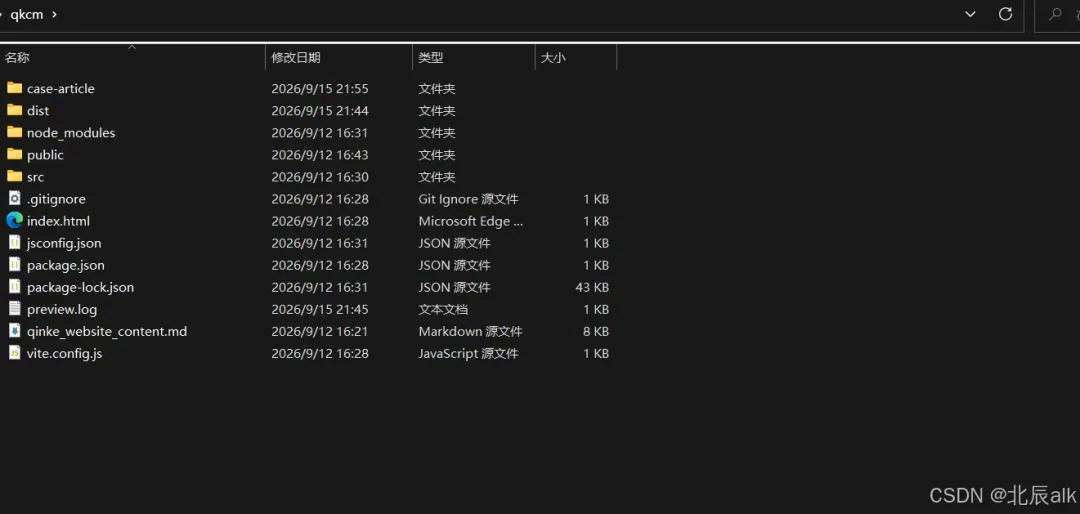
对应能力点:复杂代码仓库理解(官方说该方向评测集提升 12.4%)、端到端工程搭建。对我来说,很直观的体验是"它没有一上来就堆页面,而是先想清楚数据怎么组织"——这是老前端才有的习惯。
第三关:黑金视觉是"看"出来的
接下来是整站特别出效果的部分:视觉。
我们公司对官网只有一个要求——要有电影感。毕竟团队出身是影视行业(做过张艺谋的《影》《长城》),作品也都是大空间沉浸体验,官网如果做成普通的企业模板风,就砸招牌了。
豆包 2.1 Pro 0915 给的视觉方案,是靠"看"出来的:
1. 它先看了我们的作品海报。五部作品的海报色调差异很大:《吞食者》是红金科幻、《一画开天》是国风鎏金、《怪咖剧场》是实验室青蓝、《营救飞虎》是战争暖橙、《剧景游》是青绿自然。它从这些图里提取了色系,最后收敛成一套全站的设计语言:黑金基底( #06060a近黑 +#d4af37金 + 少量#5ce1e6青金点缀)+ 衬线字体(中文 Noto Serif SC、英文 Cinzel),衬线字体带来的"片头字幕感"正好契合影视基因。2. 每个作品有自己的主题色和符号:科幻「◈」、神话「龍」、实验室「⚡」、战争「⚔」、研学「劇」,配合不同的径向渐变背景。作品卡片在首页和详情页用的都是这套体系,视觉上既统一又有差异。 3. 细节动效:全站固定的 Canvas 粒子背景(金/青双色粒子 + 连线,粒子数量按窗口宽度自适应,最多 90 颗)、滚动渐显(IntersectionObserver 控制,区块进入视口才浮现)、按钮扫光、图片悬停微缩放、噪点 + 暗角胶片质感、自定义金色滚动条。 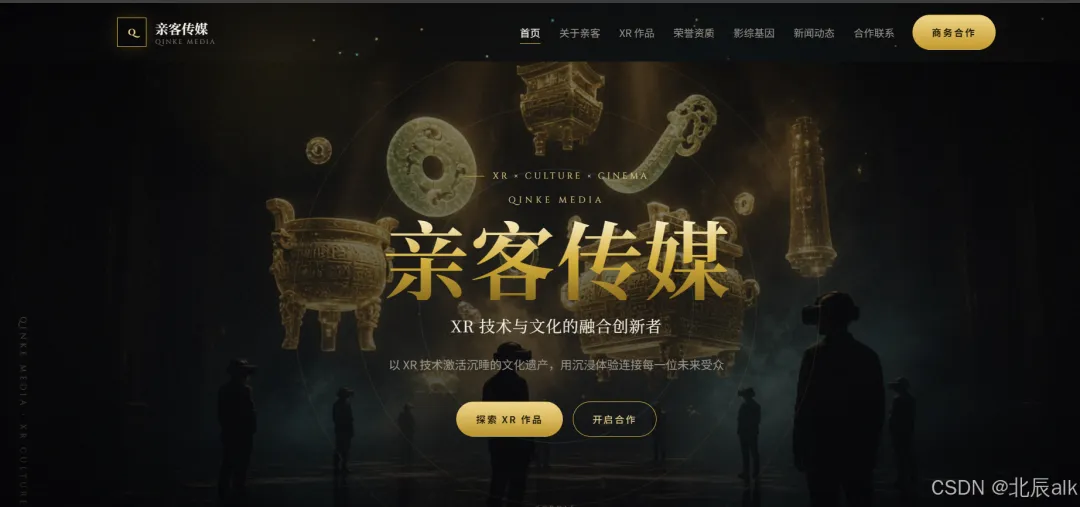
在这里插入图片描述
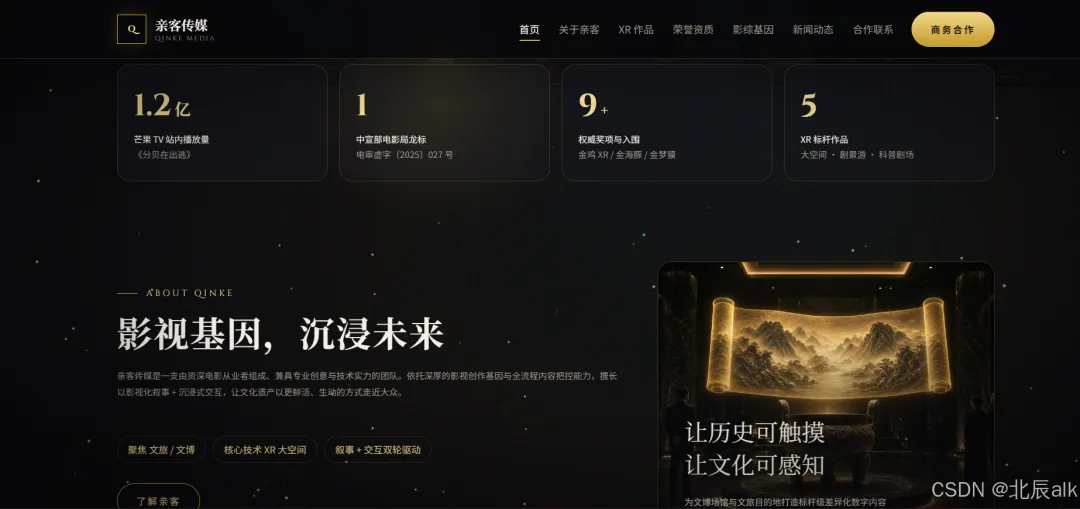
对应能力点:VLM 视觉理解 + 前端还原(design2Code)。这一关是我个人觉得升级特别明显的地方——上一代模型给图做还原,经常"形似神不似";这一代是连"神"一起做的。
第四关:一个下午跑通"写代码—跑命令—查结果"的闭环
工程和视觉定了,剩下就是特别考验"Agent"的环节:真正把站点建起来、跑起来、验证通过。
我的操作流程是这样的,全程在豆包工作里完成:
1. 初始化工程:让它按定好的结构建文件、装依赖(Vue 3.4 + Vite 4.5 + vue-router 4.4)。依赖装完后它会主动确认版本,而不是闷头往下写。 2. 分页面落地:先做数据层 site.js(把第一关提炼的内容填进去),再做公共组件(Header、Footer、SectionTitle、WorkArt、AmbientCanvas),最后逐页做 8 个视图。顺序是从依赖到被依赖,保证每一步都能跑。3. 跑构建验证: npm run build。第一次构建有一些小问题(图片路径、CSS 里一个渐变语法),它读取报错后自己定位修复,没有让我对着报错猜。最终构建通过,耗时 1.80 秒。4. 预览核验:启动预览服务,我逐页点开检查,它同步修正。最后我按页面截图存档——就是这篇文里你能看到的这些成品图。
这个环节特别打动我的,是它不抢跑。以前用工具做长任务,经常遇到模型"嘴上说完成了、实际没做"的情况。这次它每一步都会等真实结果:装依赖会等安装完成、构建会等命令返回、页面会等渲染出来再让我验收。官方说这次专门优化了"工具不可用时是否诚实说明""子任务没返回就提前总结"这类问题,工具调用幻觉从 38.4% 提升到 64.8%(内部专项口径)——我的真实体感是:这一个下午,它没有一次在结果没出来之前跟我说"搞定了"。
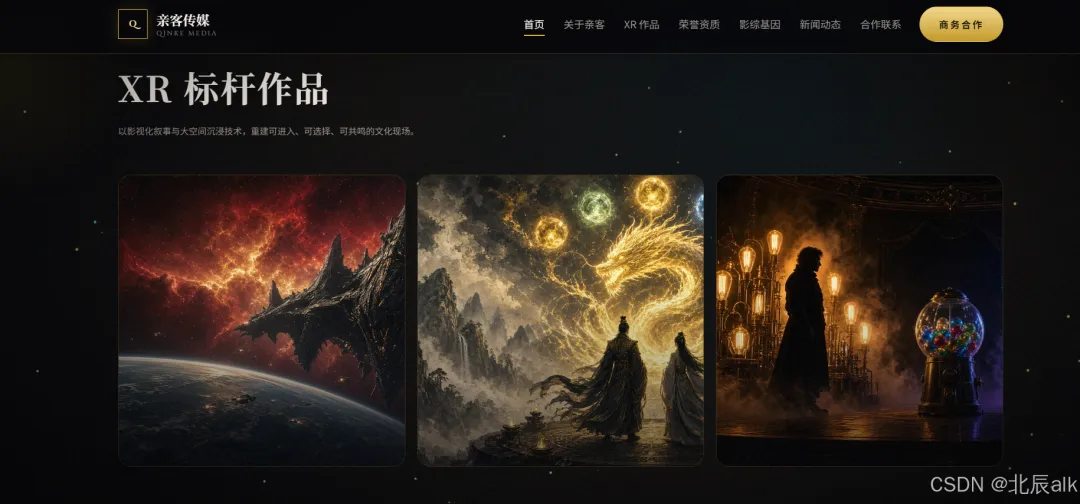
对应能力点:长流程 Agent 执行、工具调用可靠性、端到端开发(从理解需求 → 修改代码 → 跑命令 → 验证测试)。
第五关:多轮修改与"回读核验"
官网很少一版到位。我们实际改了四轮:
• 第一轮:从"一页式落地页"改成"多页面站"(最初方案是单页滚动,聊着聊着发现内容量太大,果断拆页); • 第二轮:导航从 5 个栏目扩到 7 个(加了"影综基因""新闻动态"),全站 Header、路由、页面标题同步更新; • 第三轮:给所有作品详情页统一加"荣誉奖项""媒体报道"区块(《吞食者》9 条奖项、7 个媒体报道渠道,其他作品按数据有无自动显示/隐藏); • 第四轮:移动端适配——一开始 iPhone 宽度下按钮挤成一团,断点调了一轮才正常(1000px / 860px / 640px 三档)。
这里我想专门说"回读核验"这个习惯。这代模型在 Office 办公里强调"生成—修改—核验",在代码侧它把同一套逻辑带过来了:每次全局修改后,它会回读相关文件确认一致性(比如改了导航数据,会检查路由和页面标题是否同步),而不是改完就完事。我印象很深的是改完导航那轮,它主动回读 router/index.js 和 AppHeader.vue,确认没有漏改的硬编码菜单项。
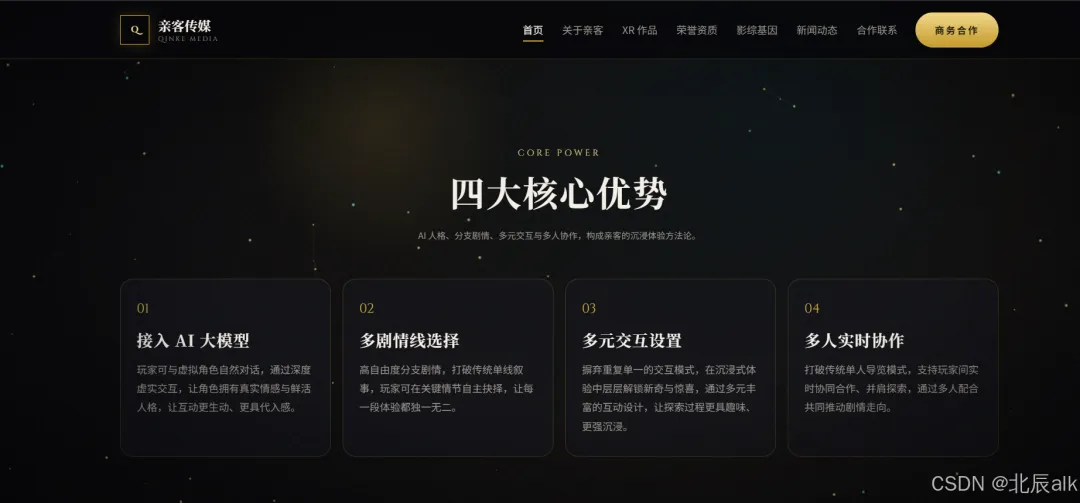
对应能力点:Office 办公能力(版式遵循、全局修改、产物核验)在代码场景的延伸;长程复杂任务中的持续推进。
我算了一笔账:时间、Token、成本
不吹数据,只说我这个项目的实际情况。
时间账:如果按传统方式,找外包做这套站(多页面、动效、响应式、内容可维护),报价和周期先不说,沟通成本就够呛;如果我自己学 Vue 从零写,一周起步,还未必写得像样。这次的实际耗时:一个下午(从内容整理到构建通过)。官方说 Coding 任务平均输出 Token 减少 5%、思考 Token 减少 11%、工具调用次数减少 43%,我体感上"返工轮次少"确实是省时间的大头——很多轮修改是模型自己发现、自己修正的,不需要我重新描述一遍问题。
成本账:官方口径提到在 Coding 任务上效果接近 DeepSeek V4 Pro、同时生成 Token 节省 30% 以上,综合峰谷价格平均成本节省 40% 以上。这个横向数字我没法逐项复测(我们主要看的是能不能把事办成),但从对话轮次和 Token 消耗体感来说,这一个下午的建站成本,远低于任何外包报价的零头,这个结论是可以下的。
说点实话:翻车与局限
上面写得顺,但真实过程没这么丝滑。有几个坑值得记下来,也算给想试的人打个预防针:
1. 素材还是要人准备。作品海报是我们自己整理放进 public/images/的。模型能做的是"理解这些图、提取色系、做视觉还原",它不会凭空变出公司的资产——所以"输入—输出"链路里,该有的原始素材一步都不能省。2. 第一版方案被我自己否了。模型最初给的是单页滚动式落地页,从"好演示"角度没问题,但内容体量摆在那里,我们聊了一轮才拆成多页面。这说明它给方案是合理的,但业务判断(这站以后要装多少内容)得自己来。 3. 移动端断点返工了一次。桌面端第一版就很稳,但小屏下按钮布局挤压,是我验收时发现的,提回去改了一轮。所以"预览核验"这步不能省——模型不会替你做审美验收。 4. 它偶尔也会"想当然"。比如给某些作品页默认填充了不存在的奖项数据,是我对照原始 PDF 校对时发现的,让它删掉并按真实数据重写。证据核验这件事,模型负责"查",最终"拍板"的还是人。 官方提到的"不确定性声明""不编造结果"改进,我确实看到了进步,但没到可以完全放手的地步。
这些不是抱怨——恰恰相反,我觉得"知道自己在哪一步该上场",才是 AI 辅助工作的正确打开方式。
结尾:我重新理解了"多模态 Coding"
这次升级之前,我对"多模态 Coding"的理解是:把一张设计图丢给模型,它生成代码。这次跑完整个 Case,我的理解变了:
它真正做的事,是把"看懂文档"和"写好代码"连成了一条流水线——先读图文混排的 PDF 结构化内容,再组织成工程的数据层,再看海报定视觉语言,最后跑构建、改多轮、回读核验。模型的能力不是体现在"某一段代码写得漂亮",而是体现在整条链路的每一环都不掉链子:该看图的环节看图,该等结果的环节等结果,该核验的环节核验。
对我们这种小团队来说,这意味着"把官网做出来"从"外包+等排期"变成了"一个下午+持续自己维护"。网站上线后,内容更新、栏目调整,我都能自己来——这种"交付物敢接手"的感觉,比任何跑分都实在。
如果你也是小团队里那个"什么都会一点"的人,建议拿一个真实任务试试这个模型。别拿它写玩具 demo,拿你手头真正要交付的东西——它能给你的,不止是代码。
附录 A:成品页面一览(均为本地构建产物实拍截图)
 | |
 | |
 | |
 | |
 | |
 | |
 | |
 | |
 | |
 | |