ARTICLE · 1018082
写了一堆 AI 插件到底有用吗?Claude Code 终于给出了“照妖镜”
写了一堆 AI 插件,到底有没有用?Claude Code 终于给出了“照妖镜”
做 AI Agent 或插件开发的工程师,多半都经历过这种尴尬:
花了两天时间,查文档、搭 MCP(Model Context Protocol)服务、调试 Prompt,终于搓出了一个看起来极其酷炫的 Custom Skill。本地挑了两个最典型的场景一测,完美命中!截图、发推、吹牛,宣称“开发效率提升 300%”。
但一旦把这套插件扔进真实的复杂开发环境,问题就来了:有时候模型明明不用插件就能秒级解决的问题,带上插件反而绕了一大圈,疯狂吞 Token 还不说,输出质量甚至不升反降。
过去我们只能靠“体感”——也就是大家戏称的 Vibe Coding 来调优插件。到底这个插件是真能打,还是纯属自我感动?
就在刚刚,Anthropic 官方开发团队(@ClaudeDevs)给 Claude Code 推送了一个狠角色:claude plugin eval。
这东西的核心逻辑非常暴力且清醒:是骡子是马,拉出来跟“裸跑的模型”对标跑一遍分。
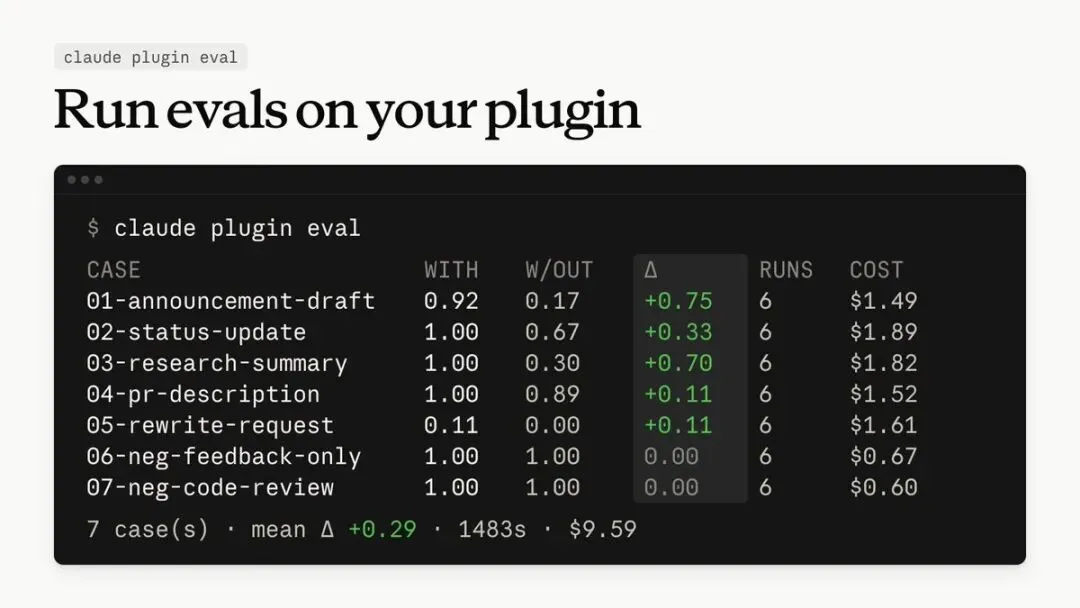
最狠的设计:强制引入“无插件对照组”
市面上做 Prompt 评估或 Agent 测试的工具并不少,但 Claude Code 这次直击要害的地方在于它的双轨对比机制(Baseline Comparison)。
当你运行评估时,它不会只测你的插件表现,而是针对同一个测试用例运行两次:
1. With Plugin:加载你的插件/Skill/MCP,看它怎么调工具、拿什么数据、输出什么结果; 2. Without Plugin:完全不带你的插件,纯靠 Claude 原生能力直接硬解。
最后,系统会同时给出两套评分,并在终端以及生成的 HTML 报表里把差异赤裸裸地拍在你脸上。
推特上有位开发者 Arthas Proudmore 的锐评一针见血:“我等这个功能好几个星期了。平时试用的一半 Skill 都是第一次看着聪明,放进实际循环里毫无卵用。拿‘带插件’和‘不带插件’做对比打分,是我见过第一个敢说真话的检验方式。”
很多时候,开发者总觉得自己写的工具不可或缺,但跑完对比可能才会发现:原生 Claude 早就具备相关常识,你的插件不仅没带来增量收益,反而因为塞了冗长的上下文,干扰了核心推理。
三分钟上手:它是怎么工作的?
整个评测流程几乎没有繁琐的配置文件门槛,直接把 LLM 本身作为评估工作流的辅助手:
1. 一键初始化测试套件在你的插件根目录下运行:
claude plugin eval init你不需要手写复杂的断言脚本。你只需要给 Claude 喂几个日常开发中的真实 Prompt,并用自然语言告诉它“什么样的输出算好、什么样的算烂”。Claude 会自动帮你起草整套测试用例与检查项,同时直接预估出跑完完整评测大概需要消耗多少 Token、烧掉多少美金。
2. 跑分与全面体检用例生成完毕后,直接执行:
claude plugin eval系统不仅会在终端实时输出每道题的得分,还会导出一份结构非常清晰的 HTML 综合报表(支持权限的账户还能直接发布为 Private Artifact)。报告里会清晰列出各项指标的胜负分布,插件到底在哪些场景拉了胯、在哪些场景立了功,一目了然。
动手之前,两个必须注意的“隐形坑”
虽然功能很爽,但官方在推文中也特意敲了黑板,有两点务必提前防范:
• 小心 Token 钱包瞬间被掏空:Eval 本质上是在大批量、重复调用大模型,而且每个用例还要跑两遍(对照组)。大模型的输出本身存在随机性,如果你一开始就拉满跑完整测试,账单可能会非常酸爽。正确姿势:正式跑之前,务必先加上 --runs 1参数进行小规模 Pilot 试跑,确认用例逻辑没问题、成本在承受范围内,再扩大样本集。• 本地权限与安全隔离:你的插件 Hooks 和本地 MCP Server 是以你本人的系统权限在宿主机上执行的。评测过程中,自动化流程会直接触发这些外部工具与脚本。如果去 GitHub 上随便克隆了一个未经审查的第三方插件就直接跑 plugin eval,无异于给陌生脚本开门。务必只评测自己写的或完全信任的代码。
从“玄学自嗨”走向“工程化卡门禁”
这绝不仅仅是一个好用的命令行小工具,它标志着大模型插件生态正在经历一次关键的范式转变。
过去两年,Agent 开发领域充斥着大量不可复现的 Demo。大家拼的是谁的 Prompt 词华丽、谁接入的 API 数量多,却几乎没有人愿意做枯燥的回归测试。
claude plugin eval 的出现,实际上是把传统软件工程里成熟的 CI/CD 思想与门禁系统(CI Gate) 正式平移到了 AI Skill 领域。通过多维度打分器(Grader)和基线量化,未来一个合格的 AI 插件,提交 PR 时必须附带 Eval 跑分对比:提升幅度低于阈值的不予合入,恶化原生表现的直接打回。
别再对着几个偶发的成功用例沾沾自喜了。升级一下本地的 Claude Code(claude update),给你的插件跑一次全面体检,看看它到底是生产力神兵,还是徒增功耗的累赘。
如果你觉得这篇内容对你有启发,欢迎在留言区聊聊你的看法。
关注我,我会持续分享高质量的技术与思考干货。👇