ARTICLE · 1018236
【统计分析软件SPSS】178、RFM分析——操作步骤
本系列文章(基于SPSS 31版本)配套数据可通过百度网盘获取:
链接:https://pan.baidu.com/s/1AGizNngKrzAVapWtNcc-VA?pwd=mnsj提取码:mnsj
https://www.mizhushare.com/docs/
在前一篇文章中,介绍了RFM的相关概念以及SPSS中可接受的数据格式,并明确了在实际分析中为何更推荐使用交易数据来开展RFM分析。
在此基础上,本文主要介绍SPSS中基于交易数据的RFM分析的菜单操作。
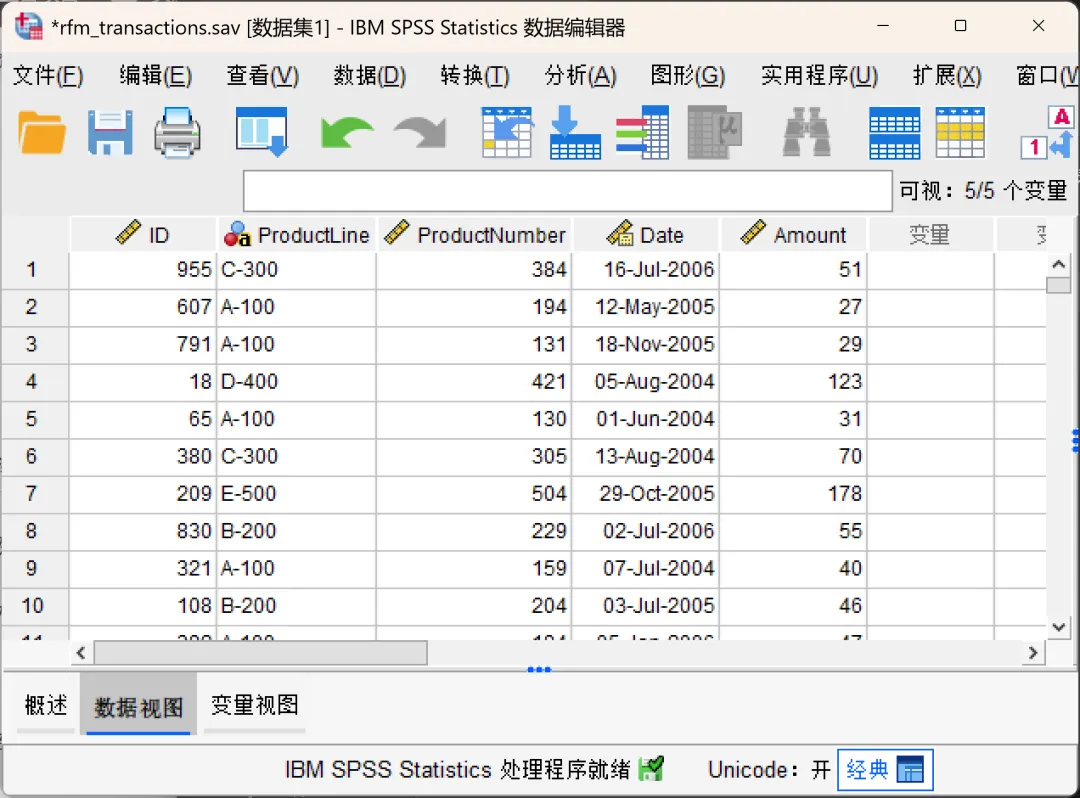
点击顶部菜单栏的【分析→直销→选择技术】,在打开的对话框进行相应设置。
第一步:
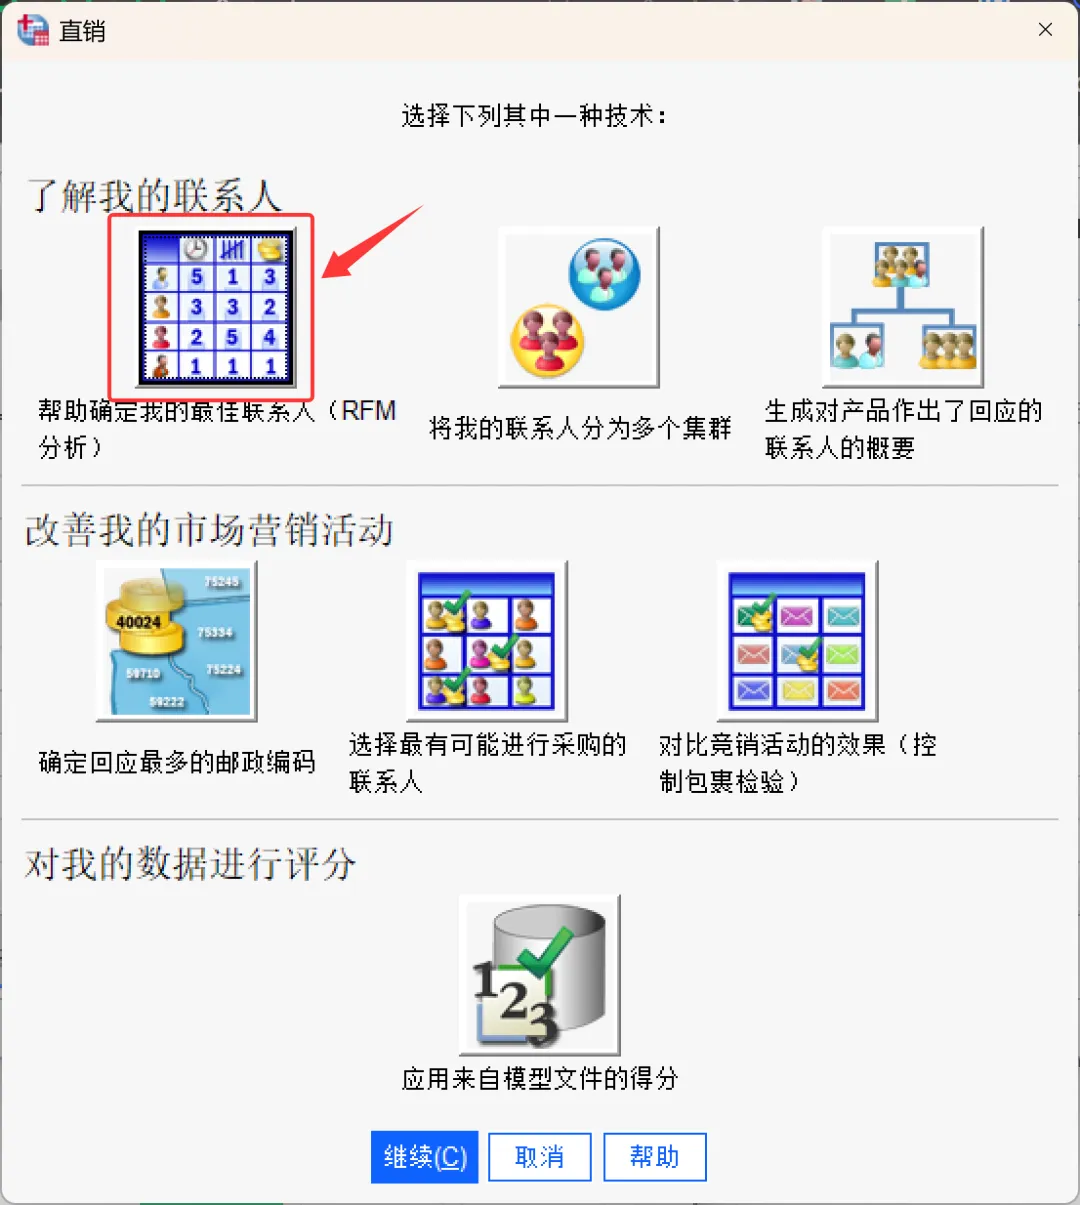
「直销」是一个专为营销分析设计的功能模块,主要用于支持直复营销中的客户细分、响应预测与活动优化,提供多种分析技术供用户选择。
帮助确定我的最佳联系人(RFM 分析) | 执行经典的 RFM 客户价值分析 |
将我的联系人分为多个集群 | 使用聚类分析方法(如K均值聚类)对客户进行自动分组 |
生成对产品作出了回应的联系人的概要 | 统计并展示哪些客户对特定产品或营销活动做出了响应(如购买、点击、注册等) |
确定回应最多的邮政编码 | 按地理区域(如邮政编码)统计客户响应情况,找出响应率最高的地区 |
选择最有可能进行采购的联系人 | 基于已有模型或规则,预测哪些客户最可能产生购买行为 |
对比竞销活动的效果(控制包裹检验) | 通过控制包实验设计(Controlled Package Test)比较不同营销方案的效果 |
应用来自模型文件的得分 | 将已训练好的预测模型(如分类树、逻辑回归模型)应用于新数据集,为每个个案打分 |
本次选择「帮助确定我的最佳联系人 (RFM Analysis)」选项,然后单击继续 。
第二步:
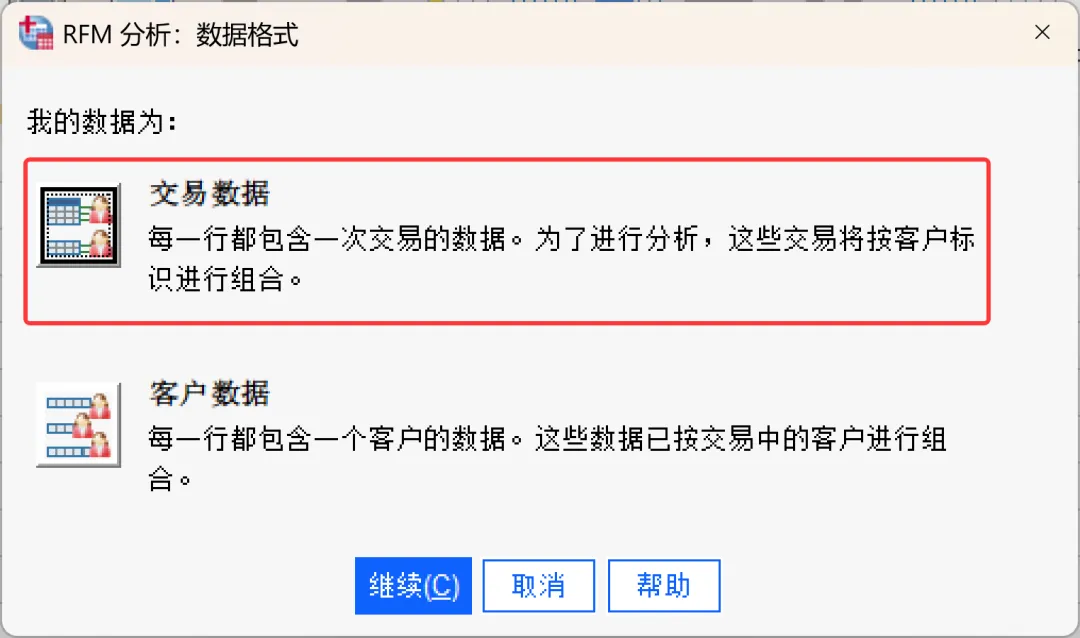
在打开的「数据格式」对话框中,选择「交易数据 (Transaction data)」,然后单击继续。
第三步:
(1)、变量选项卡:
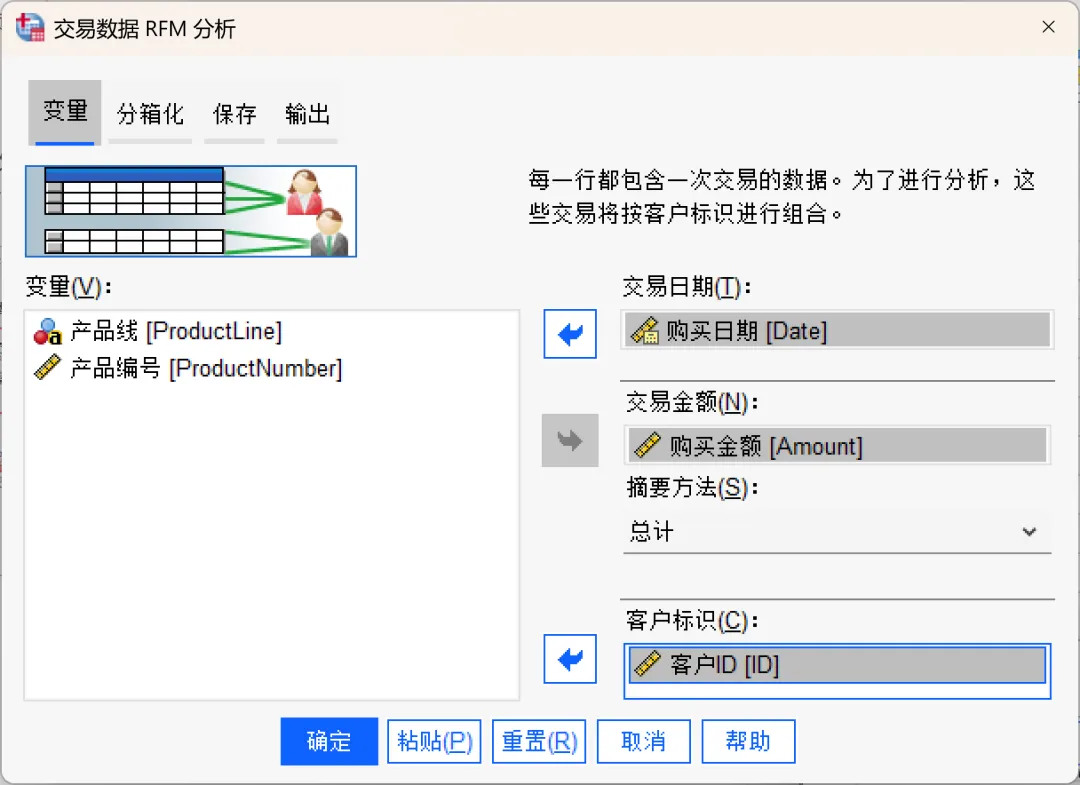
用于设置RFM分析所需的变量。
交易日期 | 包含每笔交易日期的变量。本次选择「购买日期」变量。 |
交易金额 | 包含每笔交易金额的变量。本次选择「购买金额」变量。 |
摘要方法 | 交易金额的汇总方式。本次选择「总计」。 |
客户标识 | 用于识别每个个案(客户),用于汇总数据。本次选择「客户ID」变量。 |
(2)、分箱化选项卡:
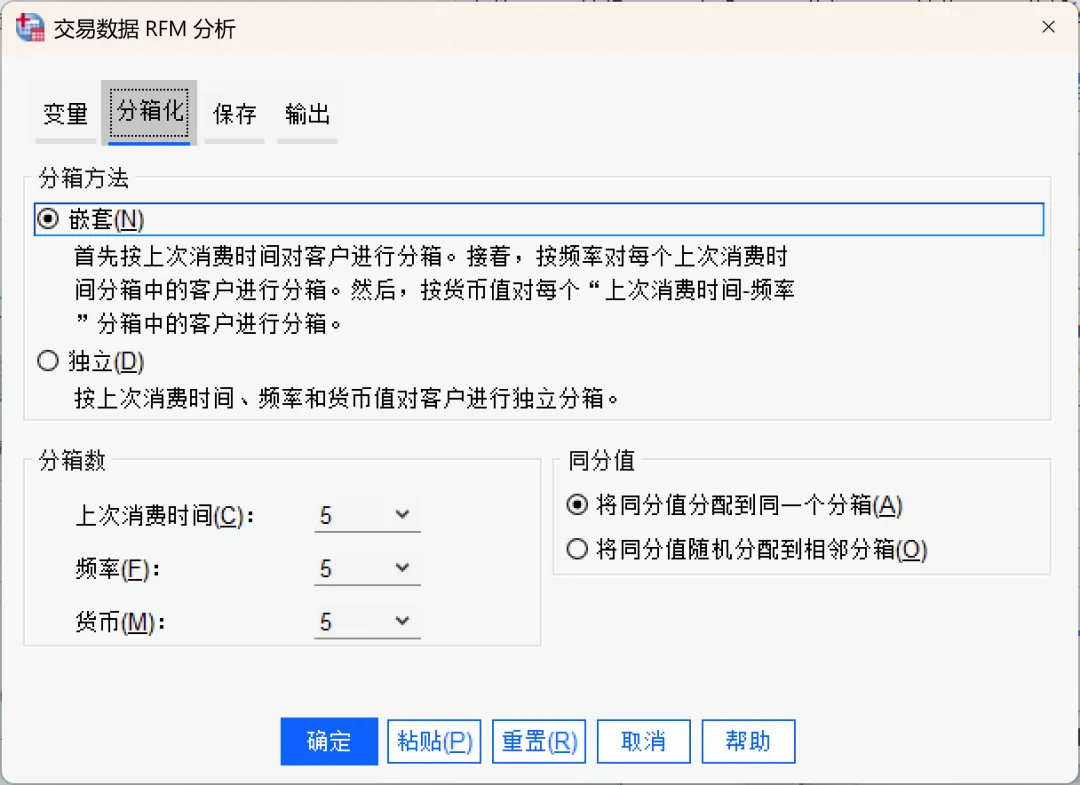
该选项卡用于设置每个客户的R、F、M 得分是如何划分等级的。
有以下两种分箱方式。 | ||
嵌套 | 在嵌套分箱中,首先为「最近一次消费」值分配一个简单的排名。然后,在每个「最近一次消费」排名内,为客户分配「消费频率」排名;接着在每个「消费频率」排名内,为客户分配「消费金额」排名。
| |
独立 | 分别为「最近一次消费、消费频率、消费金额」值分配简单的排名,这三个排名是相互独立分配的。
| |
分箱数量 | 用于创建RFM分数的每个组成部分的类别(箱)数量。可能的综合RFM分数总数是三个数值的乘积。 例如,每个组成部分的默认值是5,这将创建125个可能的综合RFM分数,范围从111到555。 每个分数组成部分允许的最大分箱数为 9。 | |
理想情况下,我们希望每个箱中的客户数量大致相同,但大量的同分值会影响箱的分布,有以下两种处理并列的方式。 | ||
将同分值分配到同一个分箱 |
| |
将同分值随机分配到同一个分箱 |
|
本次保持默认设置。
(3)、保存选项卡:
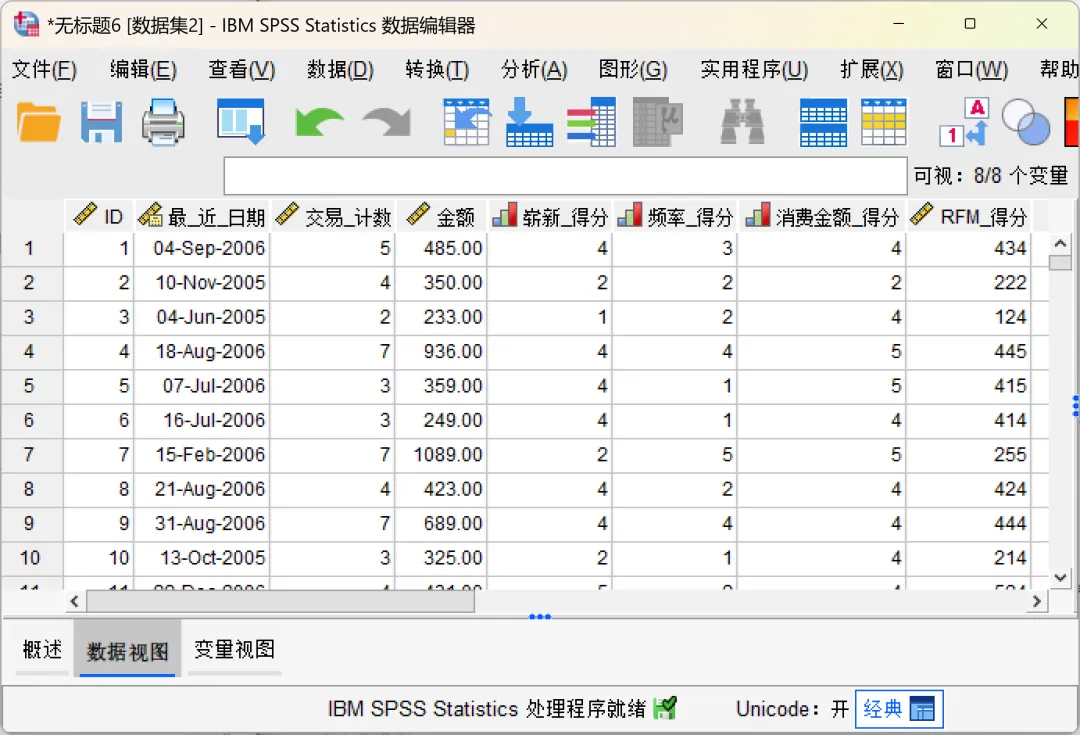
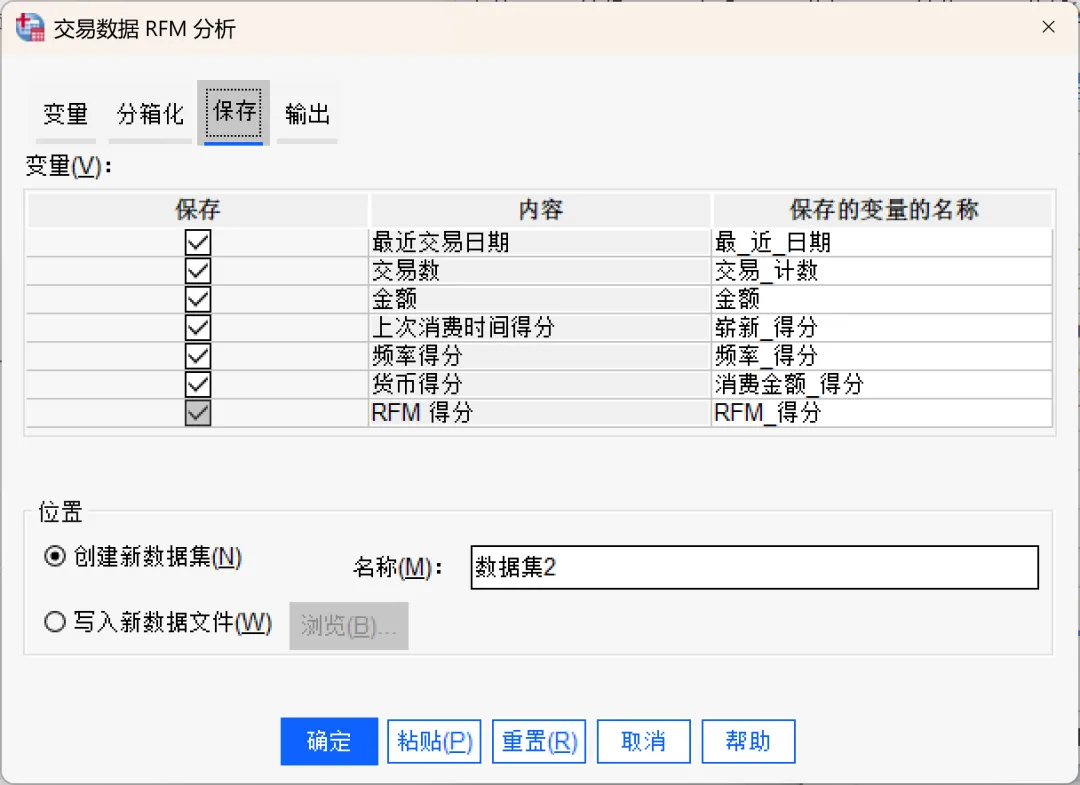
进行RFM分析时总是会创建一个新的汇总数据集,其中每位客户占一行。可以通过该选项卡来指定想要保存的分数、其他变量以及保存位置。
变量 | 用于唯一标识每位客户的变量会自动保存在新数据集中。以下附加变量默认情况下都会包含在新数据集中。可以根据需要选择要保存的变量,并指定变量名称。
|
位置 | 可以选择在当前会话中创建一个新数据集,或者将 RFM 分数数据保存到外部数据文件中。 |
本次保持默认设置。
(4)、输出选项卡:
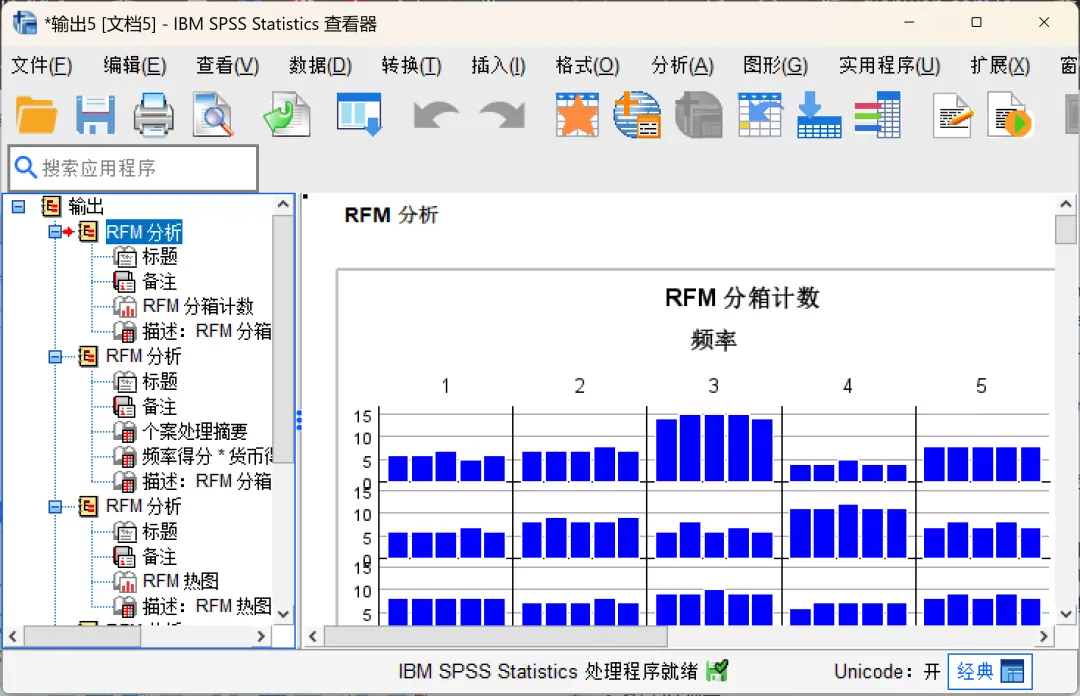
用于设置分析完成后生成的可视化图表和统计表格。这些输出内容可以帮助我们从多个维度解读 RFM 模型的结果。
按上次消费时间和频率绘制的平均货币值热图 | 基于「最近一次消费」和「消费频率」的平均消费金额热力图。 |
分箱计数图 | 显示每个 RFM 分箱中的客户数量分布。 |
分箱计数表 | 与分箱计数图包含相同的信息,只是以表格的形式呈现,每个单元格中显示箱计数。 |
直方图 | 用于计算「最近一次消费、消费频率、消费金额」分数的三个变量的值的相对分布。 |
变量对散点图 | 显示了用于计算「最近一次消费、消费频率、消费金额」分数的三个变量之间的关系。 |
本次选择全部选项。
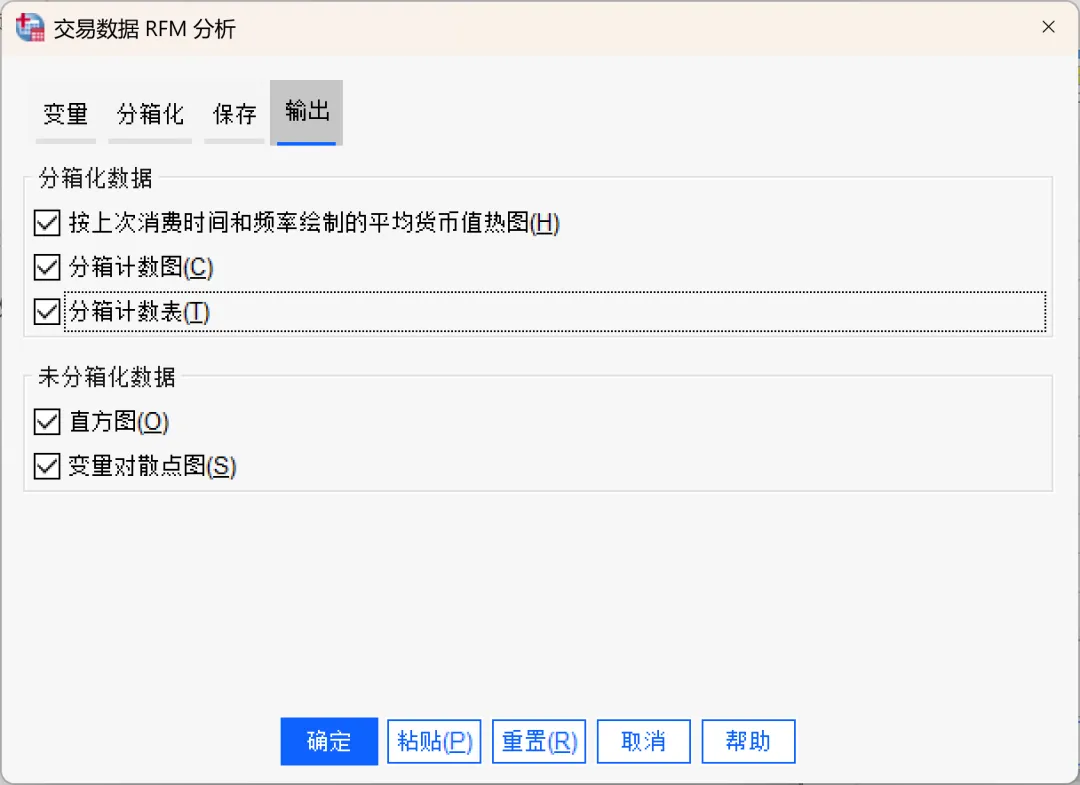
设置完成,点击确定,SPSS运行RFM分析。
RFM分析会生成一个包含RFM评分的新数据集以及分析结果图表,具体内容将在后续文章中进行介绍。