ARTICLE · 1018662
堆成山的PDF,AI 怎么一天清完
堆成山的PDF,AI 怎么一天清完
你部门的合同、发票、扫描件、审批表,是不是还靠人一份份看、一行行敲?更扎心的是:录完还可能错、调阅时又找不到、想拿去训练模型才发现根本"读不动"。本文讲清:把一堆非结构化文档,用 AI 变成结构化数据,到底怎么落地。
一、为什么"纸到数"是政企的第一道坎
政企的数字化,往往从"堆成山"的文档开始——历史合同、审批单据、证照扫描、公文红头。它们大多是 PDF、图片、扫描件,机器读不懂、系统接不上。
✅ 政企的文档债,迟早要还。
过去靠人工录入,慢、贵、错。AI 时代更尴尬:大模型再强,喂进去的是"读不懂的纸",它也答不上来。
二、IDP:让文档自己"开口说数据"
IDP(智能文档处理)= OCR/版面识别 + 大模型结构化抽取。它把非结构化文档变成结构化数据,是政企"纸到数"的关键入口。
链路四步:
1. OCR / 版面识别:扫描件、PDF、图片转成可读取文本,定位标题、表格、印章。
2. 结构化抽取:大模型理解语义,抽取合同/票据要素,多版式自动泛化。
3. 自动校验:规则+交叉比对,金额/日期/主体核对,异常自动标红。
4. 入库对接:写入合同/财务/档案系统,沉淀为数据资产。
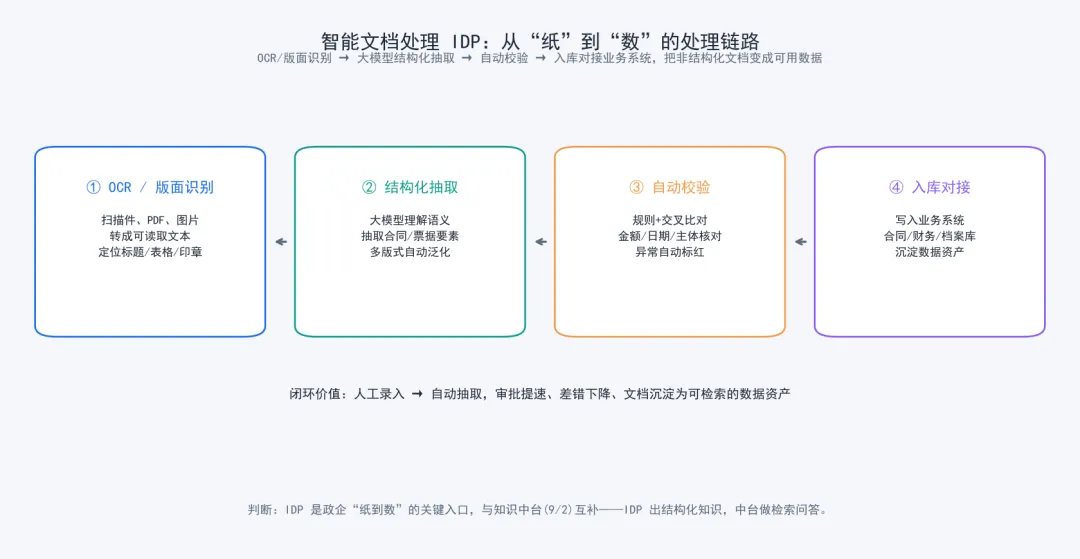
✅ 识别只是起点,抽取才是价值。
三、四大场景,先把最费人工的替掉
- 合同审核:甲乙双方、金额、期限自动抽取,历史版本差异标红,风险条款一键定位。
- 票据报销:发票 OCR 验真,抬头/税号/金额核对,对接财务自动入账。
- 档案数字化:扫描件批量结构化,目录自动生成、全文检索,电子档案合规归档。
- 表单录入:证照、申请表要素识别,免手工敲键盘,直写业务库减少错漏。
政务侧再加高频的公文要素提取(文号、密级、主送单位自动归集)。
✅ 纸到数的最后一公里,是入库。
我们每周在「政企数智汇」更新数据要素与 AI 落地一线解读,怕错过就点个关注 / 设为星标。
四、政企价值:不止"省人力"
- 减录入:把人从重复敲键盘里解放出来。
- 快审批:要素自动提取,流转不再卡在录入手。
- 降差错:机器比对,金额、日期、主体不再看漏。
- 沉淀资产:文档变结构化数据,呼应 8/27 数据资产化(具体效率倍数待发布前复核)。
五、选型四问,别被 Demo 骗了
1. 识别精度够不够?看复杂版式、手写、印章、模糊扫描的真实表现。
2. 多版式能否泛化?模板一换就崩,等于没落地。
3. 能否对接现有系统?抽出来进不了业务库,价值归零。
4. 是否支持私有化/信创部署?政企数据不出域是硬约束。
✅ 文档不结构化,AI 也无从问答。
(呼应知识中台 9/2)IDP 把文档变结构化知识,知识中台做检索问答——两者互补,构成"从纸到数、从数到智"的闭环。
我们的判断
2026 下半年,IDP 会从"OCR 工具"走向"大模型驱动的结构化入口"。对政企的现实建议:先挑合同、票据、档案里最费人工的场景试点,跑通"抽取—校验—入库"闭环,再谈全量。
3句话记住本文
- 是什么:IDP = OCR识别 + 大模型抽取,把纸变结构化数据。
- 落哪:合同审核/票据报销/档案数字化/表单录入四类优先。
- 怎么选:精度、泛化、对接、私有化/信创,四问定成败。
建议收藏 / 转发给负责信息化、财务与档案的同事。
📌 延伸阅读:本文与「数智人每日必读」同步推送,每天3分钟帮你厘清数据要素与AI落地的关键动态,建议搭配阅读,建立完整认知框架。
关注"政企数智汇"公众号,获取更多AI大模型产业前沿深度解读。政企数智汇长期致力于为政府和企业提供数智化转型规划咨询、实施交付、长效运维全链路一站式专业服务。
互动话题:你单位最想先"AI 化"的是哪类文档——合同、发票、档案,还是表单?卡在识别、抽取,还是接系统?欢迎在评论区聊聊。