ARTICLE · 1023473
AI开始替你操作电脑,先改3个工作习惯
AI开始替你操作电脑,先改3个工作习惯氪獭新知经验 · NO.011 · 2026年9月12日 这个月 AI 圈子最实在的一条新闻:GPT-6 Astra 把「替人操作电脑」当成了主课——官方给的场景是填表单、更新 CRM、整理日历、装软件、排障,一个桌面任务平均 40 分钟就能跑完,上代要 75 分钟。能力涨到这一步,最先需要调整的其实不是工具,是习惯:从「自己做」切换到「描述任务、验收结果」。 01它现在能干到什么程度 先建立一个准确的印象。OSWorld 2.0 是衡量模型操作真实电脑桌面的基准,Astra 拿到 72.6%,上代 GPT-5.6 Sol 是 65.7%;屏幕定位专项 92.7,任务执行专项从 18.1 翻到 41.4。全部为厂商自报,没有第三方复测——这个前提要记住。 放进日常坐标系里更直观:一个桌面任务是一次「打开软件—移动到操作区—处理—保存」的完整动作链,40 分钟跑完意味着它已经能独立接手「一顿饭功夫」量级的杂事。但和人类一样,任务链条越长、牵涉的软件越多,出错概率越高——自动化任务执行专项只有 41.4 分(满分 100),说明的正是这件事:短任务已经能用,长任务还要人盯着。 另一个容易被忽略的数字是幻觉率:4.2%(上代 12.2%)。它不是零。这决定了正确姿势不是「全交出去」,而是把任务分成两类:结果容易验收的,可以交;结果错了代价大的,先别交。 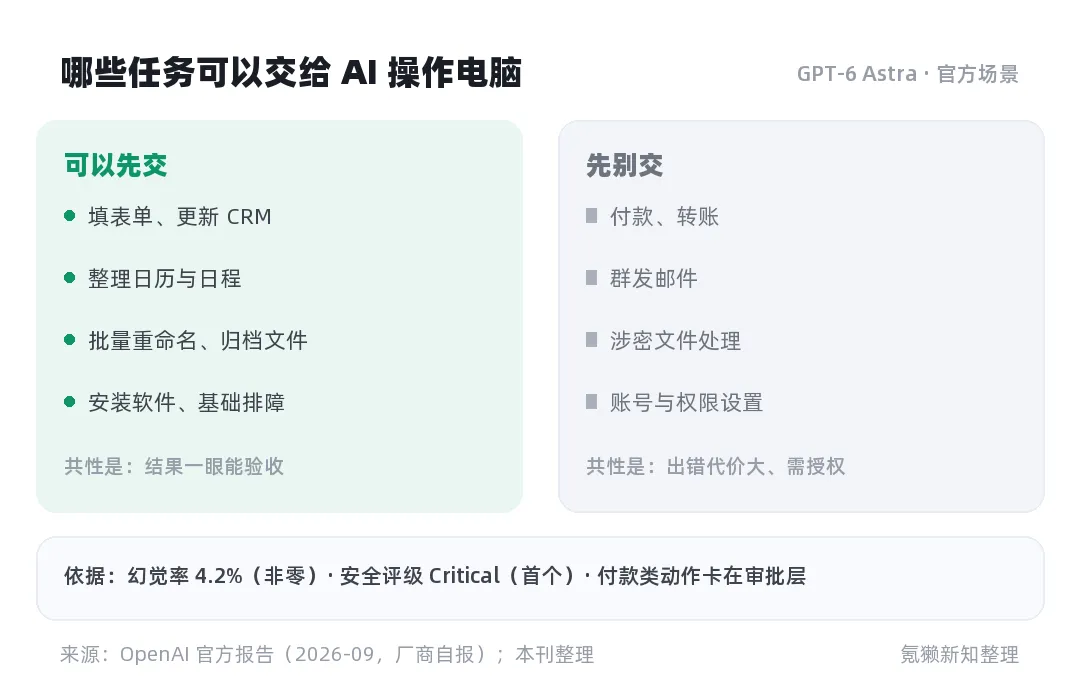
02为什么是现在改,而不是等它完善 模型操作电脑的成熟度还不均匀:简单桌面任务成功率不错,长链条任务、涉及多软件协作的任务仍会出错。但限量的开放节奏已经在动——先机构、再逐步推到 ChatGPT Plus/Pro/Business、API 和云平台。而在一段时间内,参与的企业看不到底层权限,个人用户也还没排上——但等行业完全成熟再学,等于把适应期全押后。 同类产品的进度条也都在早期位置:Anthropic 的 Mac 原生屏幕交互至今挂着 research preview 标签,只对部分订阅用户开放;Google 更早的独立产品 Project Mariner 五月已经关停,能力并回了助手和浏览器。行业的方向是确定的,节奏是不确定的——这正是「现在开始练习、但不急着把整个工作流押上去」的窗口期。 更现实的理由是「验收能力」需要练习期。同一份自动化结果,不同的人检查出来的问题数量可能差出很多——这是经验活,不是读说明学会的。现在用低风险任务练,比将来在重要文件上试错划算得多。 03三个可以现在就改的习惯 习惯一:把任务写成「验收标准」,而不只是需求。同样是「整理这周的日程」,补上一句「按项目分色、冲突项标出来」,结果的可检查性就完全不同。写清楚「做完长什么样」,既提升 AI 的成功率,也让自己知道该检查什么。Anthropic 官方的 agent 使用指南也把「先写清成功标准」列为建议之一。 习惯二:留一道人工关口,且关口要具体。付款、邮件群发、涉及隐私的文件,这几类动作都卡在「确认」那一步——这是 OpenAI Preparedness Framework 给 Astra 的 Critical 级安全定的调子(首个被评 Critical 网络安全级别的模型),思维链难监控也写进了官方承认;欧盟 AI 法案第 14 条,同样把「人类监督」设为高风险 AI 系统的硬性要求。顺着这个思路管自己的流程:让 AI 做到「待确认」,签字笔始终在自己手里。 习惯三:每周留一个「对账日」。AI 处理过的台账、表格、清单,每周花十几分钟抽查一遍:完成的是什么、错在哪、下次描述任务时补什么词。这种做法在行业里有现成的名字——human-in-the-loop(人在回路):自动化的产出,最后仍由人来核对把关。把自己的工作流当成一个持续迭代的系统来维护。 本周就能做的三件事01挑一个低风险重复任务(整理文件、填表),完整跑一次「描述→验收」流程 02给常用任务写一份「验收标准」,存成模板反复用 03在日历上固定一个每周 15 分钟的「AI 对账」时段 04一个任务的全过程:以「整理本周日程」为例 把上面三个习惯串起来,跑一遍完整流程,感受会更具体——就用一个几乎人人每周都要做的事做演示: 第一步,描述。「把本周所有会议按项目分色,冲突的标红,周三下午留出一个 2 小时空档。」注意这句话里每个要求都可以检查:颜色、冲突标记、空档位置。这就是「可验收」的描述。 第二步,执行。让它去跑,这一步不要一直盯着看——任务平均 40 分钟,盯着只会浪费时间,去处理别的事,等结果就行。这个「不在场」本身,就是自动化省下来的第一块时间。 第三步,检查。回来看三样东西:冲突项标得对不对、颜色有没有分错、空档是不是真的留出来了。检查时间应该明显短于自己动手做的时间——这是这件事划算的前提,也是练「验收能力」的日常场。 第四步,归档。这周跑得顺口的描述,存进自己的「任务模板」;踩过的坑(比如「留空档」要说清是全天还是仅下午)写成一句补充说明。下次同类任务直接调用,就是前面说的「对账」习惯的日常版。 整条流程里,你付出的核心成本是两件事:把要求说清楚,以及验收。这两件事恰恰是最难被替代的部分——这也正是本篇说「先改习惯」,而不是「先装工具」。 05三个常见误区 误区一:把它当搜索框用。「帮我看看这个文件」是搜索式用法;「把这个文件里的表格提取出来,按日期排序存成新文件」才是任务式用法。委托的是动作,不是提问——这是和聊天机器最本质的区别。 误区二:只看「做没做完」,不看「做得对不对」。幻觉率 4.2% 意味着二十多个环节里可能有一个是错的,而且它错得很自信。抽样式检查比放心式交付重要。 误区三:一次性委派整条工作流。先从单个任务跑起,跑顺了再串联。任务链越长,验收成本越高——这是自动化基准里长程任务得分普遍偏低的结构性原因,不是哪一家模型的问题。把期待值放对,「翻车」就不容易变成对这件事的误判。 06边界:哪些先别交出去 「重试次数减少、按任务计费更便宜——官方这套账的前提是幻觉率数据可信,而它同样出自官方报告。」—— 据本文对 Astra 官方技术报告的整理 三条边界线,都是从上面的事实里直接推出来的:幻觉率非零,所以「错了无所谓」的任务先来;安全评级刚起步,涉及权限的动作往后放;任务时长仍是分钟级,别指望它替你盯着实时流程。把这三条当成默认设置,比重读十篇评测都管用。 07编辑观察 模型替人操作电脑这件事,短期看是效率工具,中期看更像一次「工作习惯的体检」:哪些任务你描述得清楚、哪些结果你会验收、哪些动作你敢不敢放手——这些问题以前没有机会暴露,现在被一个 40 分钟能跑完任务的新物种摆到了台面上。 顺带说一句可能不受欢迎的判断:最先感到压力的,不会是不会用 AI 的人,而是「会用 AI 但从不检查结果」的人——工具越能干,验收能力越值钱。 如果 AI 现在就能替你跑一个桌面任务,你会先交出哪一个? 评论区聊聊。你的答案,其实就是你对自己工作流最真实的理解。 出品 · 氪獭新知 · 经验 NO.011