ARTICLE · 1024405
每周AI工具|给AI装上5000个科研技能:BAAI开源DisCo,MLE-bench奖牌率从31%飙到73%
AI工具 AI科研专家 — 用AI做科研的效率工具
技能蒸馏 · 实验复现 · 代码调试 · 开源可复现
点击文末「阅读原文」直接使用
关注「AI-For-Precision-Health」 — 每天一篇AI科研实操干货
食品 · 医药 · 器械 · AI工具 · 科研Skill — 让AI真正帮你做科研。
AI能一分钟写出训练脚本,却总在四件事上翻车:数据怎么切、参数怎么设、报错怎么解、结果怎么验。
这不是模型不够聪明。2026年9月2日,北京智源人工智能研究院(BAAI)联合中国科学技术大学、中国人民大学、香港理工大学发布论文《Repo-To-Skill》,把一个长期被忽视的层级正式命名——操作性知识(operational knowledge):区分"知道某个方法"和"让这个方法真正跑起来"的实践诀窍。他们做的工具叫DisCo,把1000个GitHub仓库蒸馏成5000多个可验证技能,塞给同一个AI。结果:MLE-bench(机器学习工程基准)奖牌率从31.11%拉到72.89%。今天我把这套逻辑拆开,再给你一份照着能做的上手流程——以及一处必须说清的诚实边界。
5000+ 从1000个ML仓库蒸馏出的可验证技能(20领域·178能力族) | +134.3% MLE-bench奖牌率31.11% → 72.89%(作者自报口径) | 0 模型权重一行没改纯粹靠外部技能层注入操作知识 |
本文要点
① 传统科研智能体 = 模型 + 运行框架(harness),缺的是中间那层"操作性知识"——让方法真正跑起来的经验;② AREX-Skill Library 把1000个仓库压成5000+技能,按20领域178能力族组织,采用开放的 Agent Skills 格式(SKILL.md + references/ + scripts/);③ 四个基准的提升(+134.3% / +34.4% / +9.2% / +14.0%)全部是论文作者自报,尚无第三方复现,官方称完整技术报告待发布;④ 上手只要 Node.js 22.19.0+ 和一条 npm 命令;技能还能导出到 Claude Code / Codex,不锁定在 DisCo 里。
创作来源说明:本文信息基于 arXiv 论文《Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills》(arXiv:2609.02749,提交日 2026-09-02)、AREX-Skill 开源仓库说明文档、Agent Skills 开放标准规范(agentskills.io)及第三方技术媒体评测,检索时间 2026-09-15。四个基准数字均为论文作者自报口径,官方明确"完整技术报告即将发布",目前无第三方独立复现,文中已逐处标注。
一、AI会写代码,为什么还是跑不通实验?
本节结论:模型能力和流程编排这两年都在飞涨,但"怎么让一个方法在真实环境里跑起来"的实践知识始终悬在系统外面——论文把它命名为操作性知识(operational knowledge),而它恰恰是决定实验成败的那一层。
先把一个现代科研智能体的解剖结构说清。它由两块组成:一块是模型(model),负责理解、推理、规划和执行;另一块是运行框架(harness),负责编排、记忆、验证和迭代修正[1]。模型靠一代代前沿版本变强,harness 靠工程实践变好——听上去该补的都补上了。
可论文问了一个我很有共鸣的问题:这两块都不携带"领域专长"。模型的先验知识很广但是固定的,harness 管流程但不提供领域内容。那"该用哪个方法、什么时候用、怎么用才对"这部分经验,存在哪里?答案是:它广泛存在于仓库和论文里,但是写给人类读的,而且体量大到无法在一次任务中整包载入[1]。
我第一次看到"操作性知识"这个提法时愣了一下,因为这就是我每天在干的事。让AI帮你跑一篇论文的复现,卡住你的从来不是它不会写 for 循环,而是:这个数据集要不要去重?这个超参为什么论文写0.1而代码里是0.01?报这个 warning 该忽略还是该改?评估指标的口径和榜单一样吗?这些答案都不在模型权重里。没有这层知识,智能体只能在任务内靠试错烧掉预算,且任务之间不保留任何发现——每次都在重新发明轮子[1]。
我的判断是:过去一年大家都在卷"模型多强""框架多顺",而这篇论文指出了第三个战场——把散落在代码仓库里的隐性工程经验,变成机器可以直接调用的结构化工件。这比再训一个更大的模型,对多数课题组都更现实。
二、DisCo 怎么蒸馏:四阶段流程、双模式与技能图路由
本节结论:DisCo 做的事不是"把说明文档整包塞进上下文",而是把仓库里的操作知识压缩成带适用条件、操作步骤、验证检查和失败恢复路径的紧凑单元;再靠技能图加路由器,只加载任务真正需要的那一支,把上下文开销压到最小[1][2]。
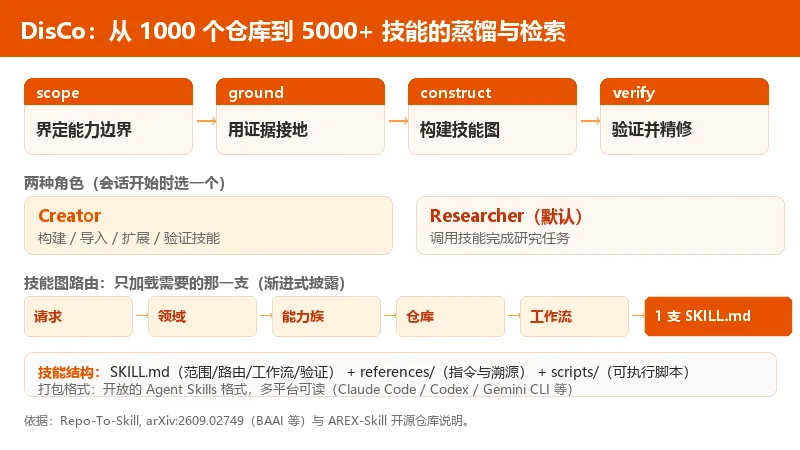
先看"技能"到底长什么样。一个技能不是仓库摘要,而是一个自包含单元,要回答四件事:这个能力什么时候适用、该运行什么、怎么验证结果、实验失败时怎么恢复[2]。它打包用的格式是开放的 Agent Skills 格式——一个 SKILL.md(技能定义文件,负责范围界定、路由、工作流与验证)加上可选的 references/(聚焦指令与来源溯源)和 scripts/(可执行辅助脚本、诊断与检查)目录[2][3]。
这个格式本身值得单独说一句。Agent Skills 是由 Anthropic 发起并维护的开放标准,官网是 agentskills.io,目前已被 Claude Code、OpenAI Codex CLI、Gemini CLI、Cursor、VS Code、GitHub Copilot 等多个平台采用[3]。也就是说,AREX-Skill 蒸出来的技能不是绑在某一家的私有格式上——它是一批可以被多种智能体直接读的 Markdown 文件。
再说蒸馏的两种走法。论文区分得很清楚:一种是任务无关蒸馏(task-agnostic),面向整个机器学习领域广泛使用的仓库,把它们凝练成跨任务可复用的通用技能;另一种是任务导向蒸馏(task-oriented),针对你手上这个具体任务,现场生成它需要的技能[1]。前者的产物就是 AREX-Skill Library——从1000个广泛使用的机器学习仓库中提炼出5000多项技能,覆盖20个研究领域、178个能力族[1][2]。
关键在"技能图"和"路由器"。当一个仓库暴露多种能力时,它的技能会被组合成一张仓库技能图;请求进来后,路由器先把范围收窄到某个领域、某个能力族、某个仓库、某条工作流,智能体才加载匹配的那一支 SKILL.md[2][4]。我把这个设计读了三遍,因为它解决的正是"知识越多、上下文越爆"的死结——仓库技能根节点默认对模型隐藏,只有被路由到才加载,这就是它敢堆到上百个仓库而不撑爆系统提示的原因[4]。
四阶段构建流程也是公开的:scope(从锚点界定能力边界)→ ground(用可采信的证据接地)→ construct(构建候选技能图)→ verify & refine(验证并精修后才发布)[2]。我个人最看重的是最后一步——"可验证"写进了技能的定义里,而不是发布后再补。
| 知识形态 | ||
| 加载方式 | ||
| 失败恢复 | ||
| 可移植性 | ||
| 许可证 |
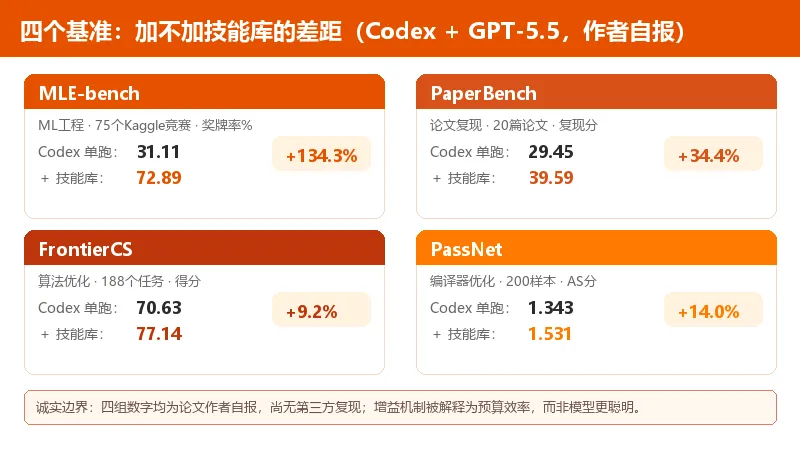
我必须在这里停一下,把这组数字的成色说透。四基准的提升(MLE-bench +134.3%、PaperBench +34.4%、FrontierCS +9.2%、PassNet +14.0%)全部来自论文作者自己的仓库与论文摘要,目前没有任何第三方独立复现公开;官方仓库也明确写着"完整技术报告即将发布"[1][2][5]。评测设定是"固定 Codex + GPT-5.5 主干、固定 harness、固定执行预算,唯一变量是是否加载技能库"[5]——设计是干净的,但结论仍需等复现。另一个细节:作者把增益机制解释为预算效率而非"更聪明"——相关技能图让智能体更早到达解空间的可用区域,把固定预算更多花在真正的实验和验证上,而不是无导航的试错[5]。任务越难,增益越大;Codex 本来就有70.63分的 FrontierCS,只涨了9.2%。
三、完整实操:10步把"科研技能库"装进你的AI
本节结论:从零到跑通只要三步——装命令行工具、配模型提供商、装技能库;剩下七步教你把技能导出到自己的智能体、用它做真实任务、再把你自己实验室的仓库蒸馏成技能。全过程只需要一台电脑和网络,不需要任何实验室设备。
三阶段全景
阶段一(Step 1-3)装上:环境自检 → 配置模型提供商 → 安装技能库并进入 Researcher 模式;阶段二(Step 4-7)用起来:跑受控对比任务 → 读懂一个技能的四段结构 → 把技能导出到你自己的智能体 → 用它做一次真实复现;阶段三(Step 8-10)造技能:把自家仓库蒸馏成技能 → 独立复现验证 → 版本维护与合规留痕。
先交个底:我本机的 Node 版本不满足要求、也没接境外模型提供商,所以下面这10步是我按官方仓库说明文档与论文逐条核对整理的,不是我的实机运行日志。所有命令都可在官方仓库复查,你照着跑能对上。
Step 1|环境自检并安装 DisCo 命令行工具
📥 输入:一台装了 Node.js 的电脑;🤖 AI动作:让AI先核对 Node 版本是否 ≥22.19.0,不符则给托管安装器方案,命令行安装为 npm install -g --ignore-scripts @arex-skill/disco;📤 输出:可执行的 disco 命令;🔍 人审:跑 disco --help 能看到完整命令列表;⚠️ 失败处理:Node 版本过低别硬扛,用官方托管安装脚本自动准备用户级运行时。
Step 2|配置模型提供商
📥 输入:至少一个模型提供商的密钥;🤖 AI动作:会话内执行 /login,或设置 OPENAI_API_KEY / ANTHROPIC_API_KEY / GEMINI_API_KEY 环境变量;📤 输出:可对话的 DisCo 会话;🔍 人审:发一个最小任务看是否正常返回;⚠️ 失败处理:报鉴权错误先查额度与区域限制——境外模型接口在国内需自备网络条件,这一步也是本项目对国内团队最大的实操门槛。
Step 3|安装技能库并进入 Researcher 模式
📥 输入:Git 环境(安装技能库需要);🤖 AI动作:执行 disco repo-skills install 拉取 AREX-Skill 库,再输入 disco 进入默认的 Researcher 模式;📤 输出:本地技能库 + 路由器就绪;🔍 人审:用 disco repo-skills status 核对技能覆盖率(离线检查记录的提交版本与已安装技能ID覆盖情况);⚠️ 失败处理:更新时若与本地改动冲突会默认停止,加 --force 前必须先确认它已生成备份。
Step 4|先跑一个"受控对比"任务
📥 输入:一个边界清晰的任务,官方给的入门示例是"在相同模型、负载与硬件约束下对比 vLLM 与 SGLang 的吞吐";🤖 AI动作:Researcher 模式自动把请求路由到相关技能图,只加载匹配的 SKILL.md 分支;📤 输出:带命令与实测数据的可复现对比报告;🔍 人审:重点看"是否保留了复现所需的全部命令与硬件约束"——这是技能自带的验证要求;⚠️ 失败处理:结果不可复现时回到技能里的 validation 检查项逐条核对,别急着换模型。
Step 5|读懂一个技能的 SKILL.md 四段结构
📥 输入:挑一个贴近你方向的技能(例如 AlphaFold2 结构建模);🤖 AI动作:让AI解释它的四个部分——scope(何时适用)、routing(怎么被路由到)、workflow(该运行什么)、validation(如何验证结果);📤 输出:一张"这个技能能干什么、不能干什么"的对照卡;🔍 人审:确认它写明了适用条件与失败恢复路径;⚠️ 失败处理:⚠️ 使用、复制、修改或再分发前,必须查该技能自己的 license 字段——库中每个技能都有独立许可证,不随仓库的 Apache-2.0 走[2]。
Step 6|把选定的技能导出到你自己的智能体
📥 输入:目标智能体(Claude Code 用 ~/.claude,Codex 用 ~/.agents);🤖 AI动作:进入 Creator 模式执行导出,例如 disco --creator -p "/skill:import-repo-skills-to-agent import vllm and sglang to ~/.claude";📤 输出:目标目录下出现纯 SKILL.md + references/ + scripts/,不带任何 DisCo 运行时依赖;🔍 人审:重启目标智能体,确认新技能被重新加载;⚠️ 失败处理:同名技能会被覆盖,导出前先备份目标技能目录。
Step 7|用技能做一次真实论文复现
📥 输入:你自己的任务与数据(比如复现一篇公开论文的主结果);🤖 AI动作:智能体按技能里的 workflow 执行、按 validation 自检;📤 输出:复现结果 + 检查报告;🔍 人审:把关键数字与论文/公开榜单逐一对照(PaperBench 这类基准考的就是这个能力);⚠️ 失败处理:卡住时先按技能内置的恢复指引走,而不是推倒重来——这正是"操作性知识"区别于临场试错的地方。
Step 8|把你自己的仓库蒸馏成技能(Creator 模式)
📥 输入:你自己实验室积累的代码仓库路径;🤖 AI动作:disco --creator -p "Inspect /path/to/repo and draft a skill creation plan",走完 scope→ground→construct→verify 四阶段;📤 输出:候选技能 + 构建记录(证据、验证检查、未解缺口都会留档);🔍 人审:检查证据是否可采信、验证检查是不是真能跑起来;⚠️ 失败处理:证据不足就回 ground 阶段补,千万不要跳过验证直接发布——没验证的技能比没有技能更危险。
Step 9|独立复现验证:换一个智能体再跑一遍
📥 输入:刚蒸馏出的技能;🤖 AI动作:让另一个没有创建时上下文的智能体,仅凭技能文件独立执行一遍;📤 输出:独立复现报告;🔍 人审:能否复现出同一结果——不能则不予发布;⚠️ 失败处理:若只在原环境下能跑,说明技能里缺环境约束,回 Step 8 补 compatibility 字段(平台、依赖、网络要求)。
Step 10|版本维护与合规留痕
📥 输入:上游仓库更新;🤖 AI动作:执行 disco repo-skills update(会保留你本地创建或导入的技能);📤 输出:更新后的技能库 + 变更记录;🔍 人审:记录来源提交版本与验证步骤,便于日后回溯;⚠️ 失败处理:官方托管技能ID发生冲突时,更新默认中止——强行覆盖前先看备份,并确认改动是否影响了你的复现基线。
四、执行清单:按周推进
本节结论:不必一次做完。第1周装上并跑通一个任务,第2周读懂并导出技能,第3周做一次真实复现,第4周试着蒸馏自家仓库——每一周都有明确产出物。
| 第1周 | |||
| 第2周 | |||
| 第3周 | |||
| 第4周 |
💻 没有实验室怎么办?
这篇稿子从头到尾不需要任何实验室设备——一台上网的电脑就够。所有环节都发生在软件层:装命令行、路由技能、跑复现、蒸馏仓库。对做干实验、计算生物学、组学分析、AI4Science 的同学,这是一条零硬件门槛的切入路径;对湿实验方向的读者,也正好可以用它把"数据分析与复现"这一段单独练熟,再回到实验台上。
五、验收:怎么判断你真的用对了
本节结论:合格的标志不是"我装上了",而是四个硬条件同时满足:任务可复现、技能可解释、失败可恢复、来源与许可可追溯。
| 任务可复现 | |
| 技能可解释 | |
| 失败可恢复 | |
| 来源与许可可追溯 |
合规边界(三条硬线):① 未发表数据不上云——技能库本身是公开内容,但你喂给智能体的实验数据是否出境,取决于你选的模型提供商,涉密课题请走本地/信创部署;② 许可证逐个查——仓库级材料是 Apache-2.0,但每个技能有独立 license,商用或再分发前必须看 SKILL.md 的 license 字段;③ 自报数字要复核——本文所有基准提升均为作者自报,你的课题若引用这些数字,请标注口径并等待第三方复现。
核心结论
▸ 结论1:科研智能体的短板不在模型有多强,而在中间的"操作性知识"层——区分"知道一个方法"与"让这个方法真正跑起来"的工程经验,它长期散落在仓库里、写给人类读、无法整包载入[1]。
▸ 结论2:DisCo 把这层经验压成可执行、可验证的技能单元(SKILL.md + references/ + scripts/),再靠技能图加路由器只加载需要的分支——用开放的 Agent Skills 格式打包,因此不锁死在单一平台上[2][3][4]。
▸ 结论3:四个基准的提升(MLE-bench +134.3%、PaperBench +34.4%、FrontierCS +9.2%、PassNet +14.0%)均为作者自报、无第三方复现,且增益机制被解释为"预算效率"而非"更聪明"——引用前请保留这个标注[1][5]。
▸ 结论4:真正的价值不只是那5000个现成技能,而是"把方法蒸馏成技能"这件事本身可以被复制——你实验室里那些"只有师兄会跑"的流程,第一次有了标准化的封装格式[2]。
▸ 行动:本周先核对 Node 版本、装好 DisCo 跑通 Step 1-4 的受控对比;第2周挑一个贴近你方向的技能读懂它、导出到你自己常用的智能体。把这四周当成一次"科研技能工程"的完整预演。
「模型决定AI能想多远,技能决定AI能不能真的把实验跑完——而后者,恰恰是你这些年攒下的、最没被数字化的资产。」
综合评分(捞仔主观打分,10分制)
概念价值:9("操作性知识"这层被正式命名,直击科研AI的真痛点)| 方法可复现性:8(命令行与仓库全公开,门槛在境外接口)| 证据完备度:5.5(四基准均为作者自报,无第三方复现,技术报告待发布)| 对科研人实用度:8.5(把"只有师兄会跑"的流程变成可移植资产)| 综合:7.8
💬 你实验室里最想"蒸馏成技能"的是哪套流程?是某台仪器的数据处理,还是某篇论文的复现管线?评论区聊聊,我都会看。觉得有用请点个「在看」,转发给被"跑不通"折磨过的同学。
参考资料
[1] Chen J, Hu Y, Qian H, et al. Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills. arXiv:2609.02749, 2026-09-02.(作者单位:北京智源人工智能研究院、中国科学技术大学、中国人民大学、香港理工大学)DOI: 10.48550/arXiv.2609.02749
[2] AREX-Skill 开源仓库(VectorSpaceLab/AREX-Skill). 技能库说明、四阶段蒸馏流程、许可证与安装指南. URL: github.com/VectorSpaceLab/AREX-Skill
[3] Agent Skills 开放标准规范(Anthropic 发起维护). URL: agentskills.io/specification
[4] DisCo 命令行工具说明(npm 包 @arex-skill/disco). 双模式(Creator/Researcher)、路由与技能发现规则. URL: npmjs.com/package/@arex-skill/disco
[5] Praison M. AREX-Skill Distills 1,000 GitHub Repos Into Skills for Coding Agents. 2026-09.(含四基准数据表与"厂商自报、无第三方复现"的核查说明)
[6] Chan JSP, et al. MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering. OpenAI, 2024. arXiv:2410.07095
[7] OpenAI. PaperBench: Evaluating AI's Ability to Replicate AI Research. 2025. arXiv:2504.01848
[8] 智源社区论文页:Repo-To-Skill 中文摘要与作者单位信息. URL: hub.baai.ac.cn/paper/40948ef7-da46-4073-9352-bd25aac03a15