ARTICLE · 1024637
接口包成工具,AI 助手为什么更笨?
前端自习室(frontend-lab) 分享大厂工程师实战心法 · 提升AI时代的技术判断力 · 构建工程师的成长复利 |  |
你把后端十来个接口,原样包成十来个工具,丢给会自己挑下一步的 AI 助手(下面叫它代理,不是网络代理)。它开始满屏乱调:先拉用户列表,再拉日程,再去创建会议。记事本很快写满,会还没约上。
不是模型突然变笨。是你把「给人用的接口」当成了「给会猜的代理用的工具」。
工具是一种新软件:一边是每次结果都固定的系统,一边是同一个问题也可能走出不同路的代理。契约要对着后者写——少、贴任务、返回能读懂,改完要用没做过的题证明。
一、先把「工具」想成契约,不是函数
去掉名字看事实:普通函数像 getWeather("NYC"),相同输入、相同走法、相同结果。代理碰到「今天带伞吗?」却可能调天气、凭常识答、或先追问城市——偶尔还会胡编、或根本没学会这个工具怎么用。
所以工具反映的是:结果每次都固定的系统,和同一句话也可能走出不同路的代理之间的契约。你不能按给同事写函数、写接口的习惯来写。同事会读文档、会问你;代理主要靠说明和返回字段猜下一步。
目标不是工具越多越好,而是让代理有更多走得通的策略。经验上,对代理顺手的工具,人往往也一眼能懂。
二、每个接口都包成工具,往往帮倒忙
Anthropic 观察到的常见错误:工具只是把现成功能,或某个接口,包了一层——不管这套动作适不适合代理。
工具更多,结果不一定更好。
原因很具体:代理的「上下文」有限(一次塞得进脑子的信息有上限),计算机内存却便宜。通讯录里找人,传统程序可以一条条扫;代理若拿到「全部联系人」再逐字读,等于把预算烧在无关行上——像翻通讯录从第一页硬翻到最后一页。
更合适的是先跳到那一页:实现 search_contacts 或 message_contact,而不是 list_contacts。
把常连在一起的步骤收进一次调用,中间结果不必往返占上下文。文里举了三条可以直接照着改的例子:
约会议 — 不要 list_users + list_events + create_event;做一个 schedule_event,内部自己查空档再落会。
查日志 — 不要整文件 read_logs;做 search_logs,只返回相关行和一点前后文。
看客户 — 不要 get_customer_by_id + list_transactions + list_notes;做 get_customer_context,一次拼出近期、相关的信息。
每个工具要有清楚、互不打架的用途。重叠太多,代理会选错门、参数传错、或调太少。可以在名字前加前缀,标明它属于哪套服务、哪类资源(这叫命名空间,比如 asana_search、asana_projects_search)。前缀还是后缀,不同模型效果不一样,用你自己的考题来选,别凭感觉。
多一个含糊工具,你付出的不是多写几行代码,是代理多一次选错门,还多占一段上下文。这就是机会成本。
三、返回里的乱码越少,瞎编就越少
同一条原则落到字段上:返回有用的,别堆底层标识。乱码 id、带像素尺寸的图片地址、文件类型代码,不如名字、能打开的图片地址、一眼能懂的类型更能指导下一步。
文里有一句可以直接拿走:
把一长串乱码 ID 换成能看懂的说法,哪怕只改成从 0 开始的序号,Claude(文里测试的那款模型)在查找任务里就准很多——因为没那么容易瞎编。
模型更擅长人名和术语,不擅长一长串乱码。查找时,乱码越像「可以瞎编的号码」,它就越容易编错,再拿着错的号继续往下做。
有时下一步仍要技术 ID(先按名字搜人,再按 id 发消息)。可以加一个 response_format 开关:detailed 带上 ID,concise 只留内容。官方示例里,详细那份 206 个 token(模型计长度用的小块),精简那份 72 个,大约只占三分之一。
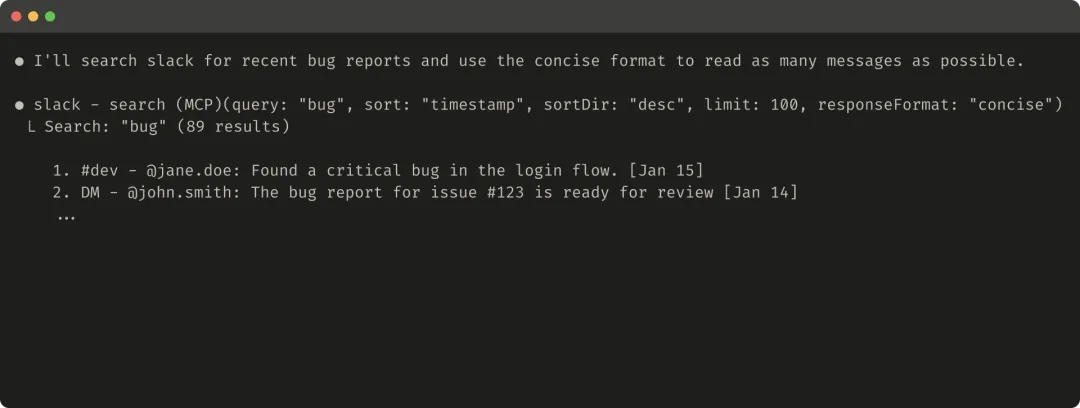
精简返回示例:搜索结果只留频道、作者和句子,不堆内部 ID
报错也是契约的一部分。与其丢一串错误码,不如写清「错在哪、正确格式长什么样、下一步调哪个工具」。
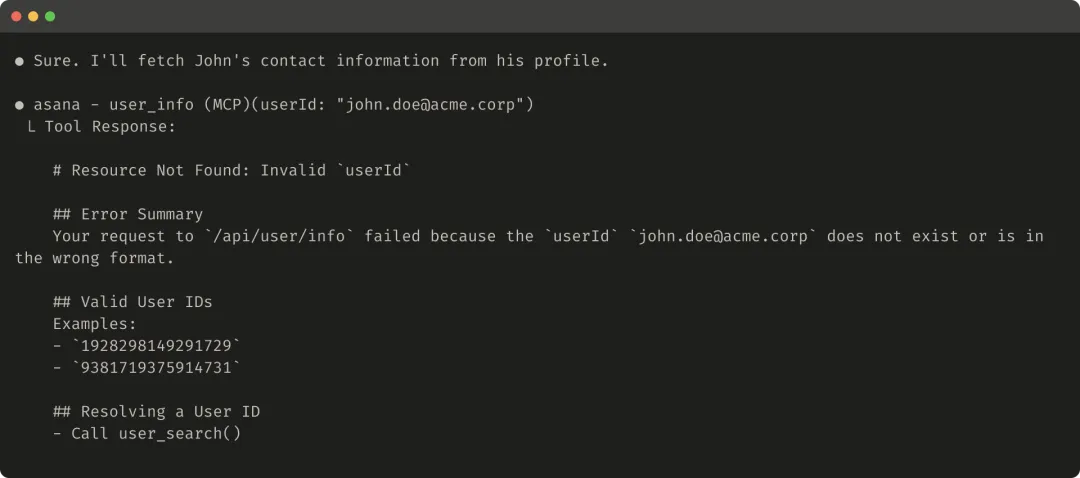
有用的报错:指出 userId 格式不对,并给出合法例子和下一步该调的搜索
另外:可能很长的返回,要有分页、区间、过滤或截断,并给一个说得通的默认值。Claude Code 默认把单次工具返回卡在 25,000 个 token,已经很长,别一次塞满。截断时要用说明把代理推向「多次小搜索」,而不是一次漫无目标的大搜。
四、改完别靠感觉,用没见过的题来验
先做能在自己电脑上试的原型。把接口文档、库的用法说明一并给上;很多官网会放一份铺平的纯文本说明书(常叫 llms.txt),模型读起来更顺。自己点一遍,再听真实用户怎么问。
然后上评测:拿一批像真业务的题,看它做得对不对。别用「给 jane@acme.corp 约个会」这种太浅的题。像样的题往往要连续多次调用工具,例如:约 Jane 下周讨论 Acme 项目,附上上次纪要,并订会议室。
每条提示要有可核对的结果。核对别苛刻到标点不同就判错。可以记录「期望调哪些工具」,但别把路径写死——同一题常有多条正路。
跑法建议:直接调模型接口,用 while 循环包住「问模型 → 执行工具」。除了对错,还记:单次耗时、工具调用次数、字块用量(token)、工具报错。调用次数里藏着该合并的重复流程。
分析时看卡在哪:说明互相打架、实现绕、参数格式难懂。模型没说出口的,往往比说出口的更重要。他们做过一个具体例子:网页搜索工具上,Claude 会多余地给查询词拼上 2025,结果被带偏;改工具说明后才拨正。
改工具时,可以让模型一起看评测记录再改一版。但必须留 held-out 测试集(没拿来改工具的题),防止把评测「背」熟了。他们内部的 Slack 工具,在这组留出题上比的是准确率:人手写的那版 67.4%,Claude 优化后的那版 80.1%。也就是说,即使用手写版当起点,按评测再改,仍有空间。
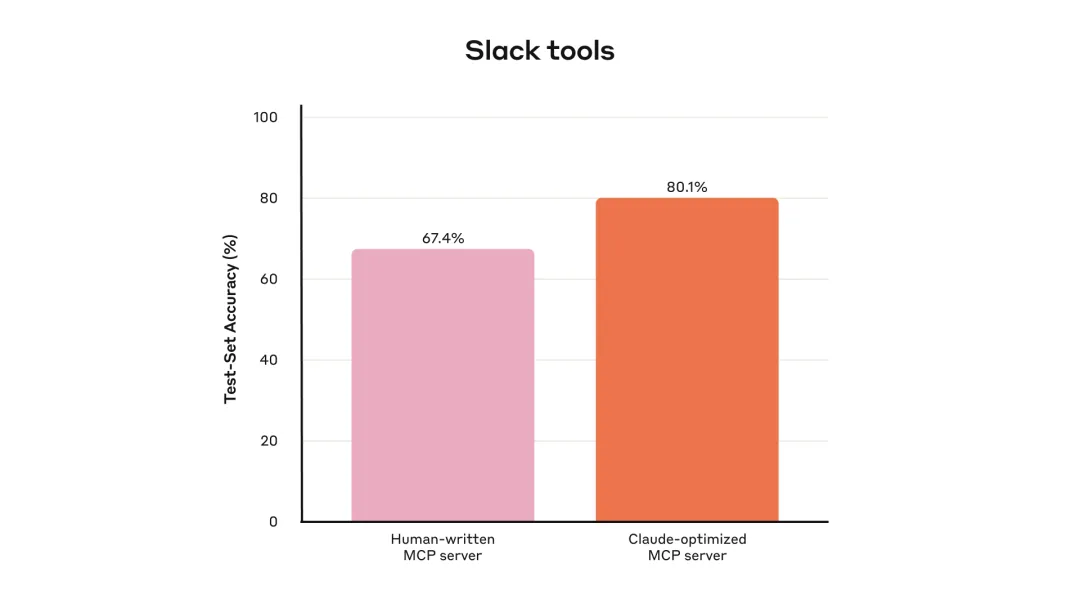
内部 Slack 工具留出集准确率:人手写 67.4%,Claude 优化后 80.1%
说明本身也是杠杆。把它写成给新人的说明书:特殊查询格式、内部黑话、资源之间的关系,都写明。参数名别叫含糊的 user,叫 user_id。他们还提到:把工具说明改精确之后,文里点名的 Claude Sonnet 3.5 在一套编程代理考题(SWE-bench Verified)上,文中称达到过领先水平。这是博客里的陈述,不是一张别人能核对的公开分数表。
五、下次评审工具,先过这三条
是不是只包了现成接口? 常连在一起的步骤,能不能收成一个贴近任务的工具(约会议、搜日志、一次拉齐客户上下文)?
返回里有没有代理读不懂的乱码 ID? 能换成名字、短语,或从 0 开始的序号吗?下一步真要技术 ID,再用精简/详细两档,别默认把乱码塞满。
改完有没有留出集? 至少记对错、调用次数、字块用量、报错;别只在「训练题」上看着变好。
如果你只想带走一句话:
工具不是接口的薄包装;它是给会猜的代理签的契约——少、贴任务、返回能读懂,并用没见过的题证明你改对了。
参考原文:
• Ken Aizawa / Anthropic Engineering — [Writing effective tools for agents — with agents](https://www.anthropic.com/engineering/writing-tools-for-agents)(2025-09-11)
关注公众号 前端自习室(frontend-lab),订阅成长复利。