ARTICLE · 1025019
永久免费的 AI 科研助手还会自我进化!PhAI Labs 发布ScienceBuddy
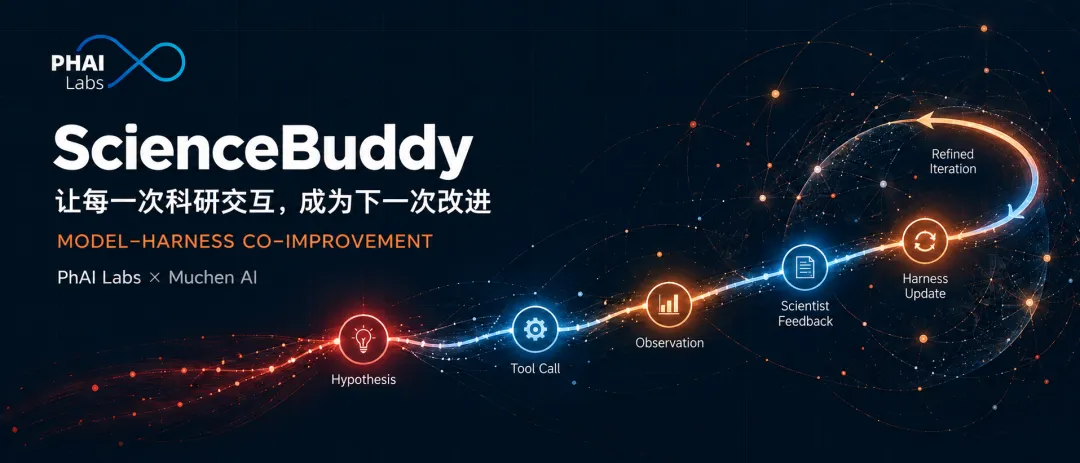
9 月 16 日,新型研究组织 PhAI Labs 发布 AI 科研搭档 ScienceBuddy,论文与代码同步公开。让它真正值得注意的,是一个有点绕的词:Recursive-in-Recursive Self-Improvement,双重递归自我改进。简单说,这个 Agent 会在与科学家的协作中,同时改进自己的"工作手册"和模型本身。 但这两层改进怎么嵌套,得先看它要解决什么问题。
项目网址👉(https://science-buddy.io/)
ScienceBuddy 官方主视觉:让每一次科研交互,成为下一次改进(图源:PhAI Labs)
科研 Agent 的死穴:经验留不下来
今天的 AI 科研助手已经能做不少事。以 ScienceBuddy 自己为例,它接入了 224 个科学工具、22 个功能模块,覆盖基因组学、分子与癌症生物学、药理学、生物成像、文献检索和数据库查询,工具与数据配置基于 Biomni 等科学基础设施集成。研究者可以把文档、图像、表格和生物序列丢进同一个工作空间连续追问,任务上下文会一直保留。 但问题恰恰出在追问之后。
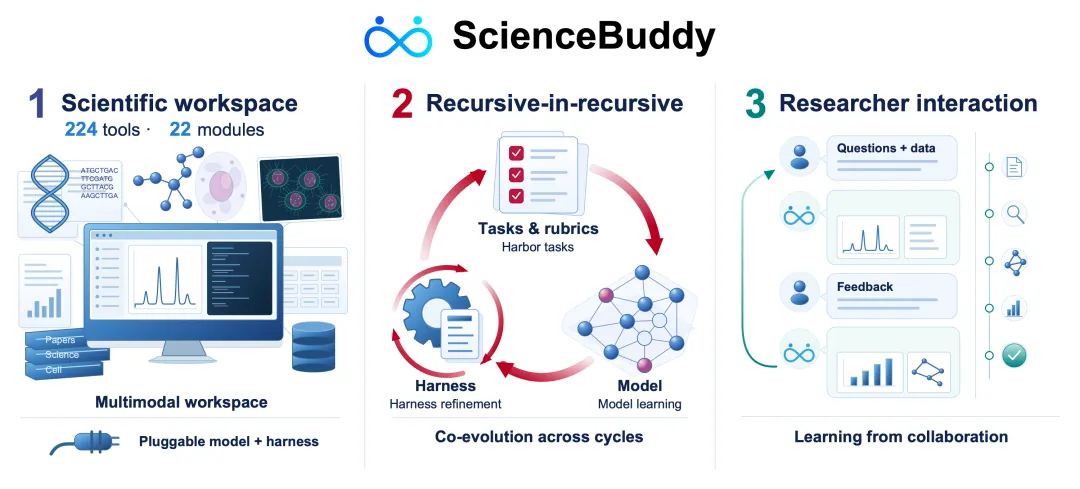
ScienceBuddy 总览:多模态工作空间、双重递归改进与研究者交互(图源:PhAI Labs)
科学家用 Agent 的过程,充满了修正。"先聚焦基因本身,再研究机制。""每个结论都要有图版支撑。"这些追问、修改和否定,是科研里最值钱的判断。但它们大多散落在聊天记录里,会话一关,经验就清零了。 AI 不知道自己哪条建议被采纳、哪条被实验证伪,所以同一个错误,下周还会再犯。
可以对比一下其他领域。写代码有单元测试,做数学题有标准答案,反馈便宜、自动、明确。但科学研究没有一个统一的"阅卷人":关键判断往往以追问、修改、重跑、换工具甚至放弃的形式出现,而且只有领域专家给得出。这就是科研 Agent 的死穴——能力可以靠堆工具堆出来,经验却留不下来。
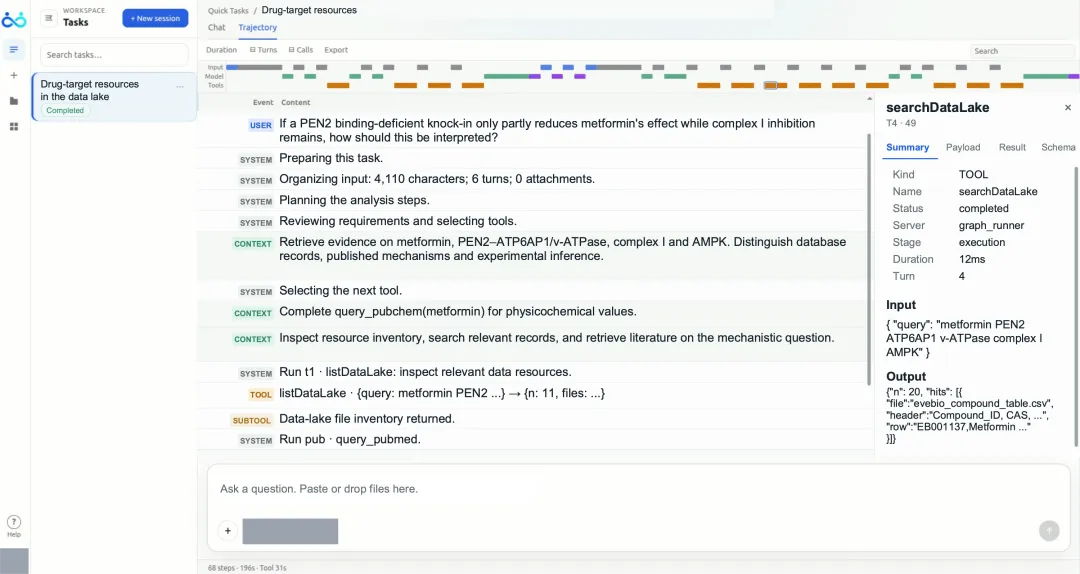
ScienceBuddy 的 Trajectory 视图:围绕二甲双胍机制的追问中,每一次工具调用的输入与返回记录都可检查(图源:PhAI Labs)
上手实测:26 秒给出答案,也会老实说"做不到"
发布当天,我们拿到了测试资格(V0.5.0-agent,教育邮箱注册,前 500 名免邀请码)。主界面是三栏布局:会话列表、对话区、执行面板,新建会话时给出 RNA-seq、ADMET、CRISPR、GWAS 等六个快速任务模板。60 多个内置数据库和 20 多个分析工具,就挂在这个对话框后面。 但模板只是门面,关键看执行。
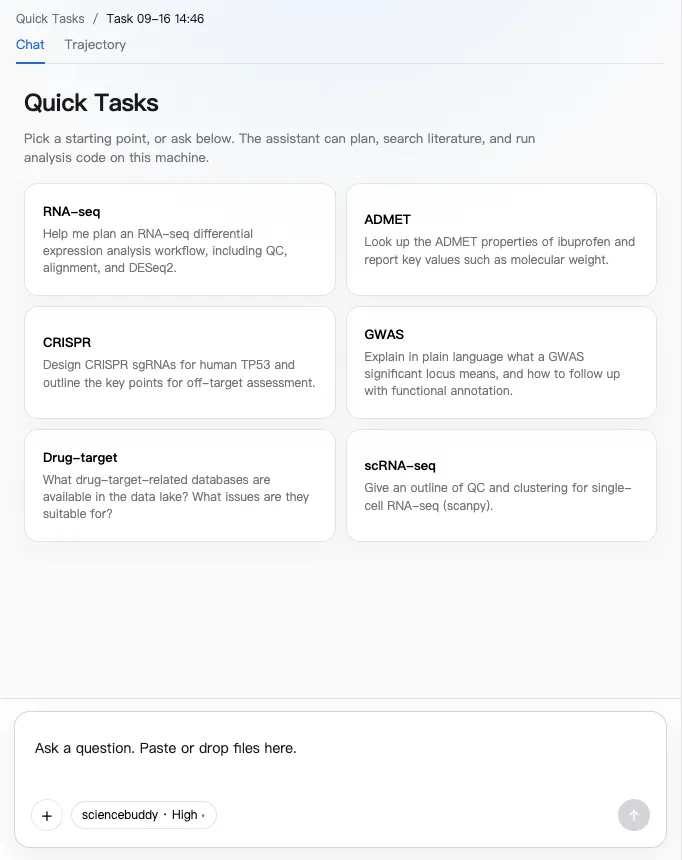
ScienceBuddy 的 Quick Tasks 模板页:六个快速任务覆盖 RNA-seq、ADMET、CRISPR、GWAS 等常见生信场景(图源:BioTender 实测)
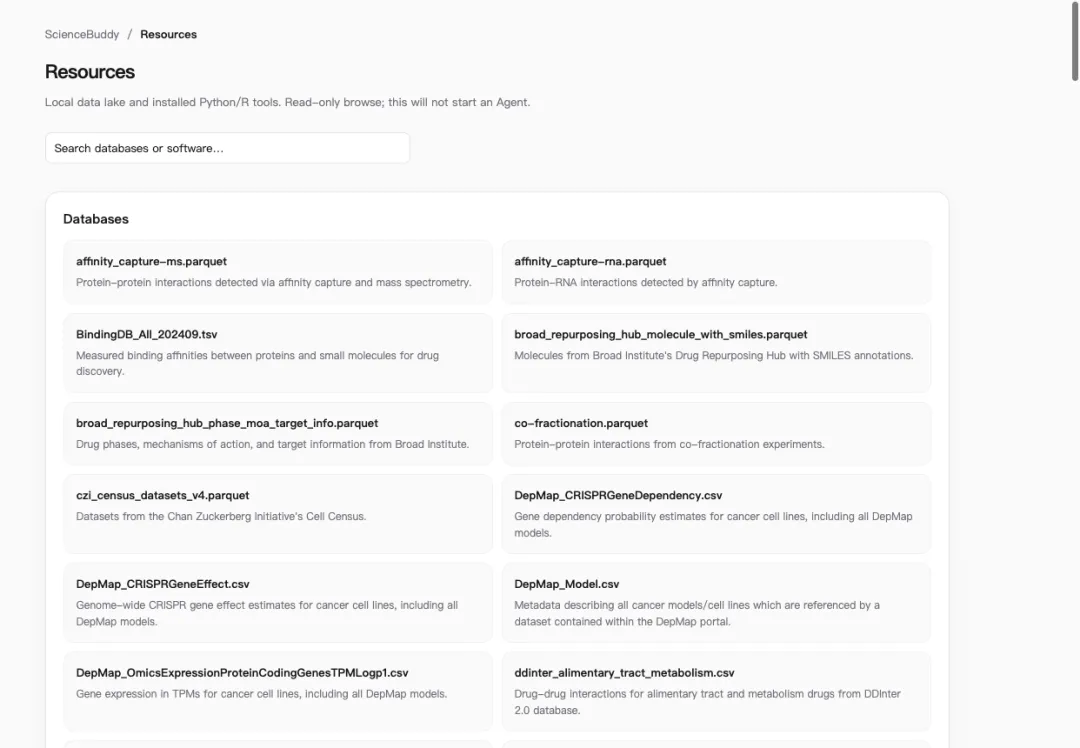
Resources 页面:数据湖内置 60 多个数据库,BindingDB、DepMap、CZI Cell Census 等均可检索(图源:BioTender 实测)
先测最简单的:查布洛芬的 ADMET 属性。26 秒、18 步,返回分子量 206.28 g/mol、XLogP 3.5、TPSA 37.3 Ų 的完整表格。再测 PubMed 检索 AlphaFold3 最新论文:62 秒、90 步,三篇论文带齐作者、摘要和 DOI。但更让人印象深刻的是它主动"自曝家丑"——预测半衰期 8.05 小时,临床值约 2 小时,4 倍差异直接写在结果里。
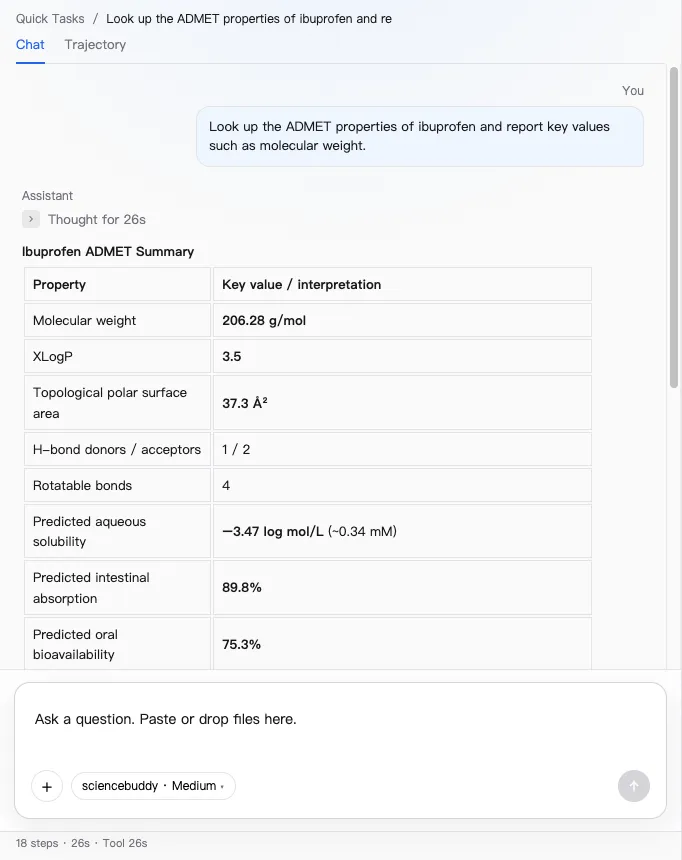
ADMET 实测:布洛芬属性表 26 秒返回,模型预测与临床数据的差异被主动标注(图源:BioTender 实测)
交互细节也花了心思。生成单细胞分析代码前,Agent 先弹出结构化表单确认数据集格式,推荐项标着 Recommended,确认后才生成约 100 行的 scanpy 流程。追问"跑一遍"时,代码环境返回 SIGTERM,Agent 直接报告执行失败,明言"I won't fabricate results"。 但诚实有代价——sandbox 不稳定,本身就是这个早期版本的短板。
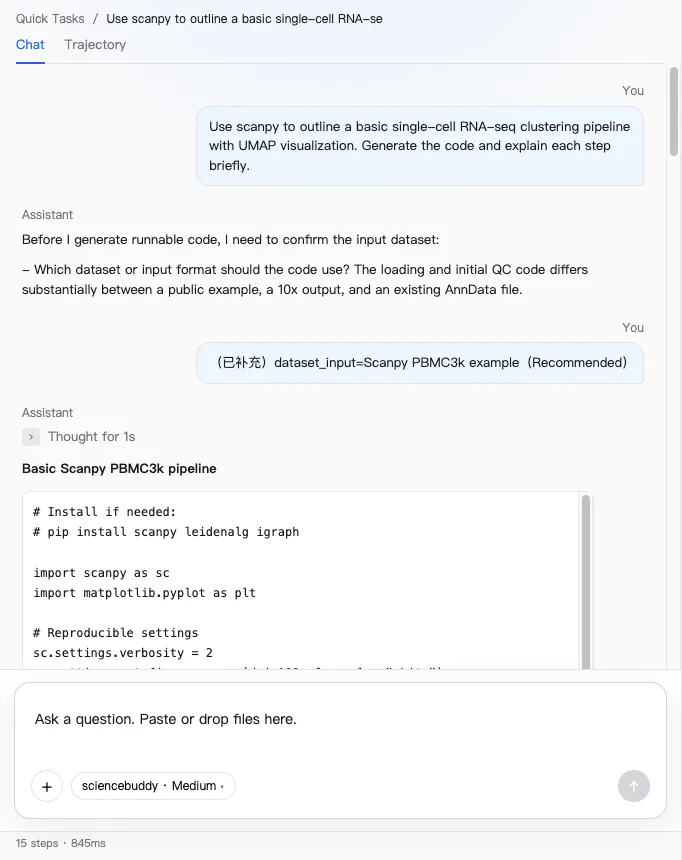
scRNA-seq 任务的交互式参数确认:Agent 先用表单确认数据集格式,再生成完整分析代码(图源:BioTender 实测)
最值得看的是 Trajectory 视图:每次工具调用的输入、返回和耗时全部可查,还能按时间、轮次、调用三种方式切换。这套"全程留痕"正是双重递归的数据来源——你今天检查的每条轨迹,就是明天 harness 改进的证据。 但 High 模式 90 步的耗时也说明,深度检索的成本还没降下来。
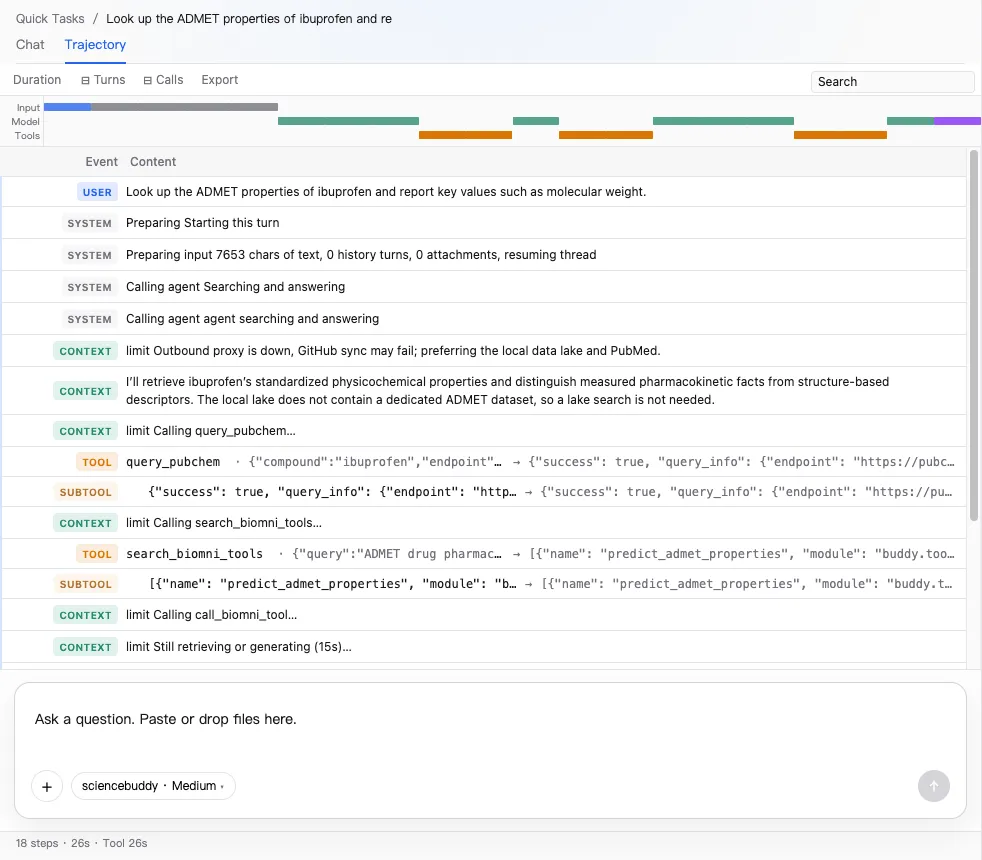
Trajectory 视图:USER/SYSTEM/CONTEXT/TOOL 事件流完整留痕,每次调用的参数与耗时均可展开(图源:BioTender 实测)
把每句"不对",变成任务和评分标准
ScienceBuddy 走的第一步,是把协作过程完整记下来。研究者的请求、上传的材料、Agent 的工具调用、执行观察、回复,以及每一次追问和修改,全部进入交互记录。这些记录拼出了任务的完整上下文:最终目标是什么,方法上有什么要求,证据要到什么标准,要交付什么产物。 但记录本身只是原材料,关键在下一步的转化。
系统把这些要求整理成自包含的任务,再从完整协作轨迹里构建评分标准(rubric),打包成 Harbor 任务包:任务说明、输入资产、运行环境、评价程序,一应俱全。新的执行按预先固定的标准打分,分数可以直接作为强化学习的奖励。 研究者的接受或否定提供诊断依据,但不直接充当"科学正确性"的标签——这个区别很关键,后面还会回来。
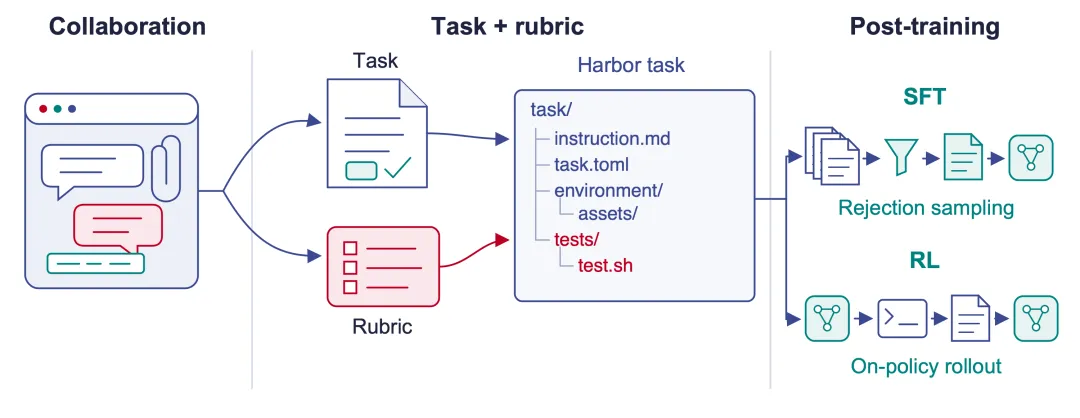
从科研协作到可训练任务:完整轨迹同时提供任务定义与评价依据,组织成 Harbor 任务包后接入 SFT 或 RL(图源:PhAI Labs)
双重递归:先改"工作手册",再改模型
把科学家的追问、修改和否定,变成可评估、可训练的信号——这是全部机制的起点。但信号有了,怎么用?答案是两层嵌套的循环。先给直觉:harness 相当于 Agent 的"工作手册",调工具、拆任务、做验证的方式,都写在里面。模型是干活的脑子,harness 是脑子的操作规程。 但大多数 Agent 系统里,这本手册由人写死,ScienceBuddy 想让它自己长。
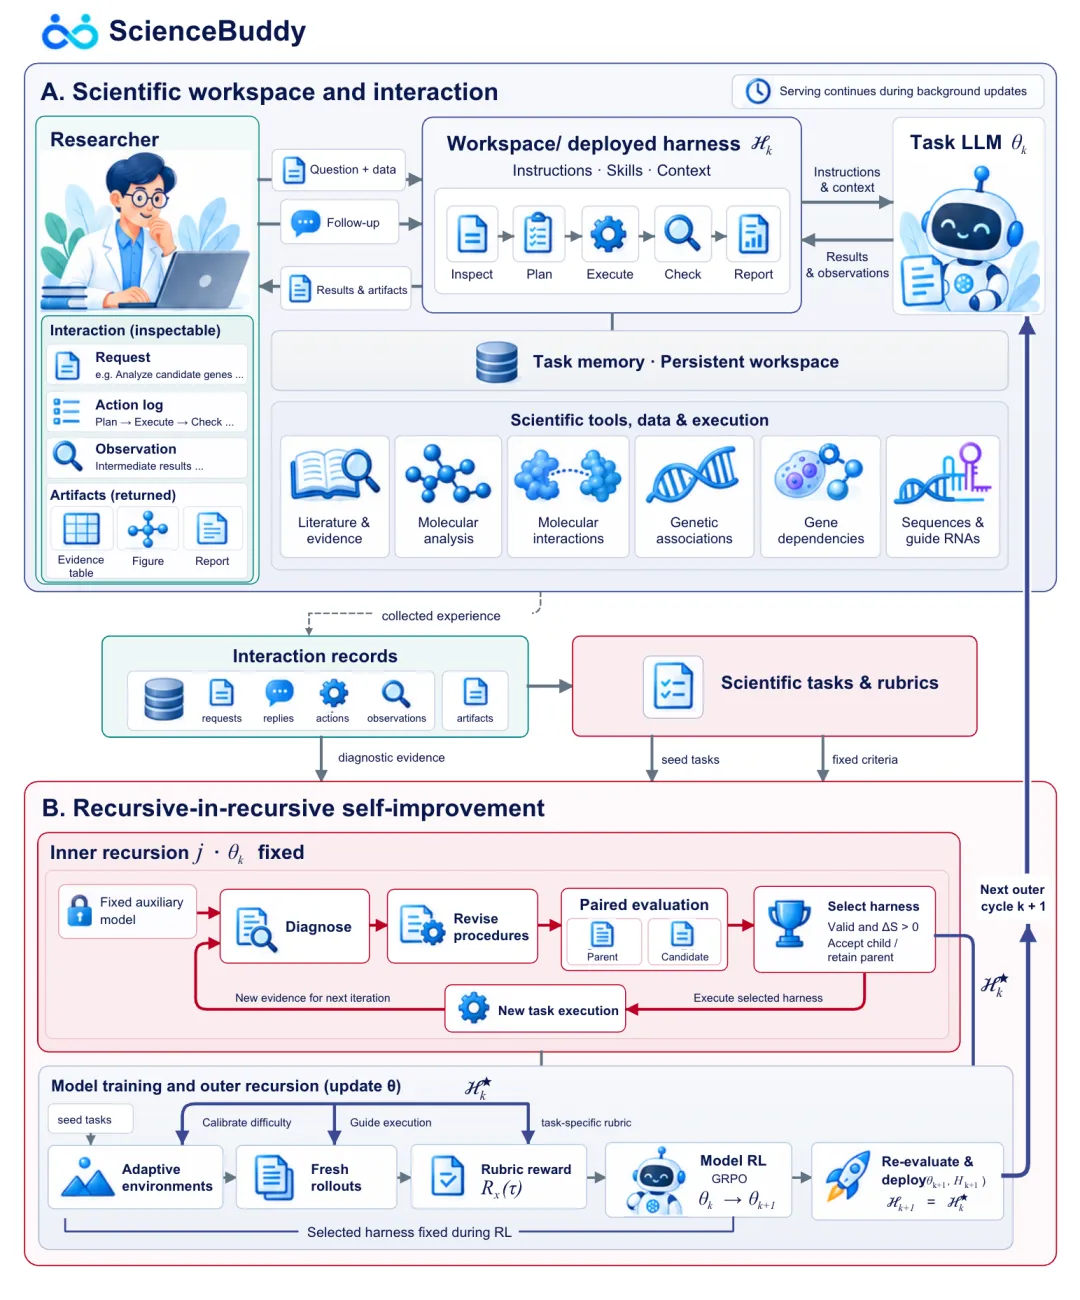
ScienceBuddy 架构总览:科研工作空间、交互记录与双重递归改进如何组织在同一个系统里(图源:PhAI Labs)
内层循环固定模型权重,由一个固定的辅助模型诊断近期任务里的问题——检索有没有覆盖正确的资源、字段有没有核验、证据够不够支撑结论。但修订不是随便改:候选版本必须通过校验和成对评估,只有在配对开发集上真正变好的才会被接受。24 个任务批次的适配之后,同一批 45 个验证任务上的首答准确率从 31.1% 升到 51.1%。模型权重不变,准确率涨了 20.0 个百分点。
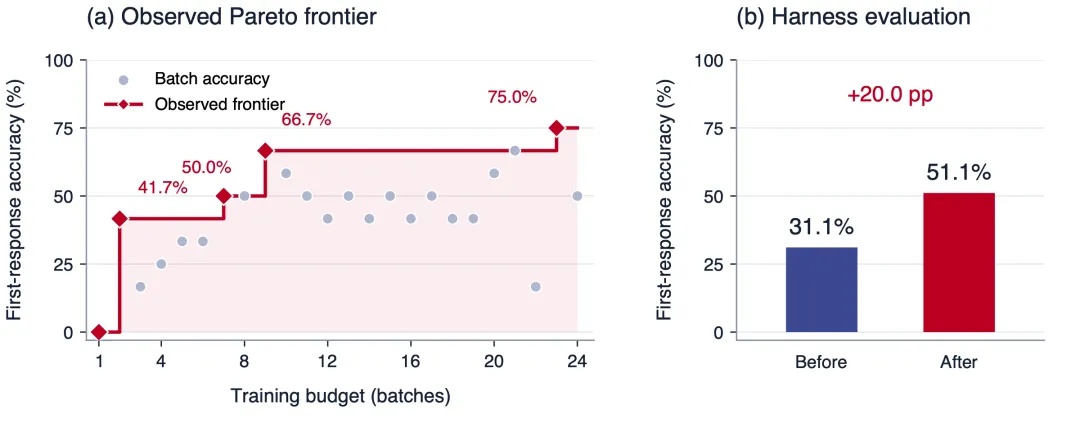
固定模型、持续改进执行程序:24 个批次的观测准确率前沿,以及初始与所选 harness 的验证集对比(图源:PhAI Labs)
外层循环反过来:固定选出的 harness,用 rubric 奖励对模型做强化学习(GRPO)。在相同 180 道题、每题最多 4 次尝试的条件下,约两小时的训练把解题覆盖率从 48.3% 推到 67.8%,已解题总数净增 35 道。 但单次训练不是终点——模型更新后,系统会重新评估继承下来的 harness,把新的"模型—手册"组合重新投入科研服务,开启下一轮。
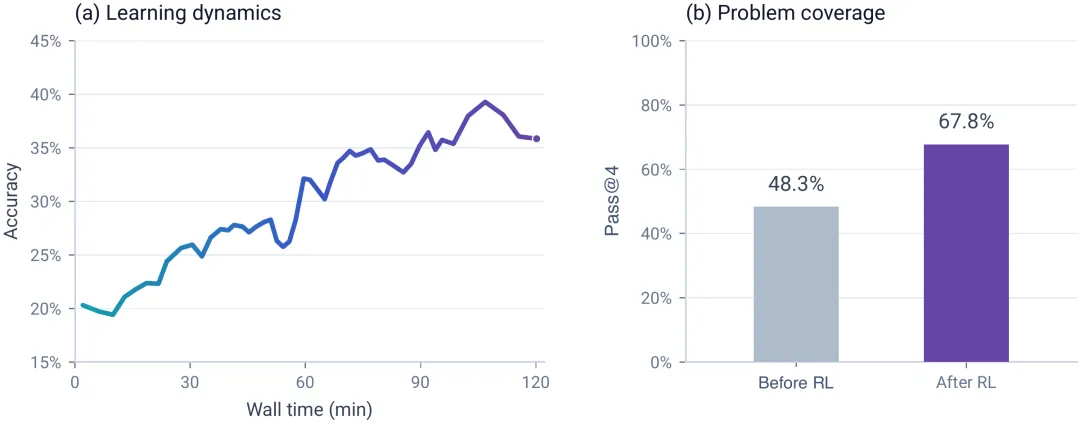
固定 harness 下的模型强化学习:训练准确率随时间上升,pass@4 覆盖率提升 19.5 个百分点(图源:PhAI Labs)
两层循环嵌套,就是"Recursive-in-Recursive"的由来。论文报告了从 Qwen3.5-4B 起步的三轮循环,每轮两者都继续推高各自指标。三轮之后,整体测试准确率从 42.2% 升到 73.3%,四个任务家族全部上涨。 但更值得看的是结构:33.3% 的题目由错转对,仅 2.2% 回退——改进主要来自"学会了新题",而非挤掉旧能力。
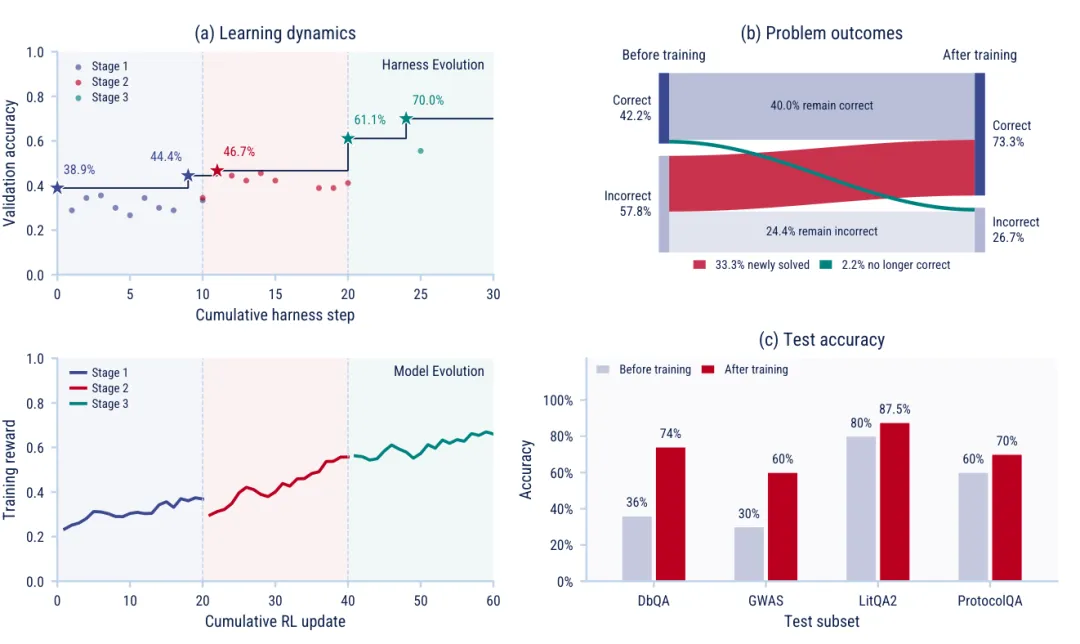
三轮双重递归循环的学习动态与任务表现:harness 验证分、训练奖励与四个科学任务家族的准确率同步上行(图源:ScienceBuddy 论文)
科学家的反馈,不等于标准答案
把交互行为当作学习信号,有一个明显的风险:科学家的每次修改,未必都代表模型错了。表达习惯、时间限制、任务阶段、个人偏好,都可能驱动一次修改;同一条反馈,对不同领域、不同研究者也可能有不同含义。但如果把所有反馈都当成标准答案,系统学到的就是一堆噪声。
ScienceBuddy 的做法,是把反馈放回任务和证据的上下文:新增要求、表达偏好与科学错误需要区分。但接受不等于正确——研究者的采纳,也要与独立评价标准分开。一句"先聚焦 JAK1 本身,再研究机制",会落成"先做关联分析、再安排机制研究"的顺序要求;一句"汇报要讲清楚",会变成"每项结论对应支持图版、明确比较对象、附讲稿"的交付标准。 反馈由此超越了评价回答,开始定义任务该怎样完成。
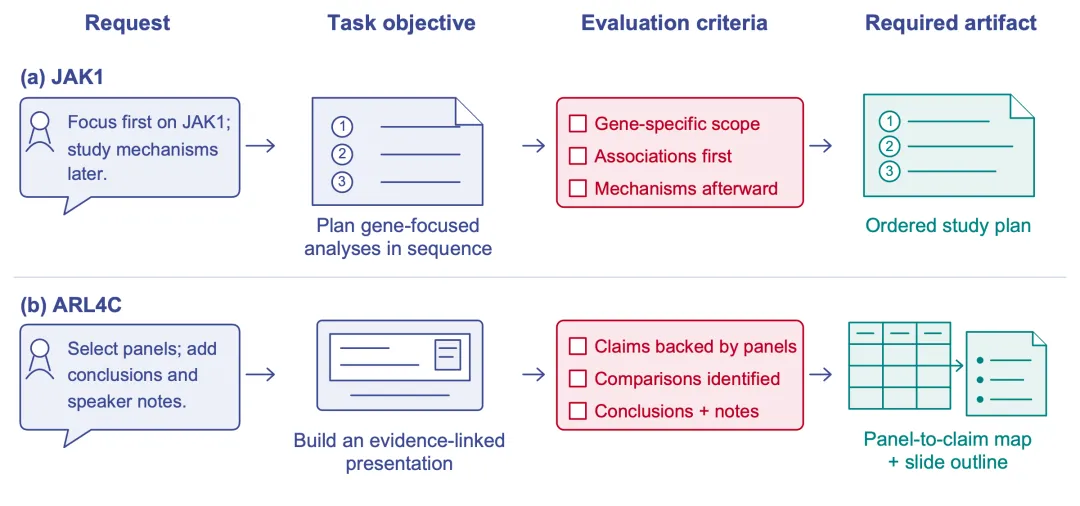
把研究者要求转化为任务规格:JAK1 研究的范围细化与 ARL4C 研究的展示需求,分别落成有顺序的研究计划与图版—结论映射(图源:PhAI Labs)
拿完 Cell 一作,他转身去"蒸馏地球"
ScienceBuddy 的通讯作者之一吴英成,另一个身份是 PhAI Labs 联创、斯坦福 AI4S 博士后。他的起点离 AI 很远:复旦临床医学出身,中山医院直博,师从高强教授研究肝癌。博士阶段就以一作或共一在 Cell、Science、Nature 发文,2024 年那篇 Cell 发现中性粒细胞能抗原提呈,拿下国际免疫学会 Pestka 青年研究奖。 但 2023 年,他转身了。
转做 AI for Science 后,产出密度反而更高:MedOS、MedGenesis、LabClaw等一串项目。MedOS 用 6 万多分钟第一视角手术视频训练,已进斯坦福医院、亮相今年 GTC;连 DFM 报告里五轮湿实验的 GALILEO,也在他的发表列表里。 但这条跳跃路径有一条暗线:从肿瘤免疫到手术再到科研 Agent,他始终在答同一个问题——专家经验怎么传给机器。
他的判断带着跨界痕迹。7 月他提出:"上一代 AI 蒸馏的是互联网,下一代 AI for Science 要'蒸馏地球'"——互联网是存量世界,自然规律没完整写在上面,AI 必须进真实实验室拿增量数据。他尤其看重失败数据:论文只记录成功,但对强化学习,走不通的轨迹恰是模型认识物理边界的负反馈。 "大家再领先也就领先那么一两年",他对 BioTender 说,所谓经验"都是上一个时代的"。
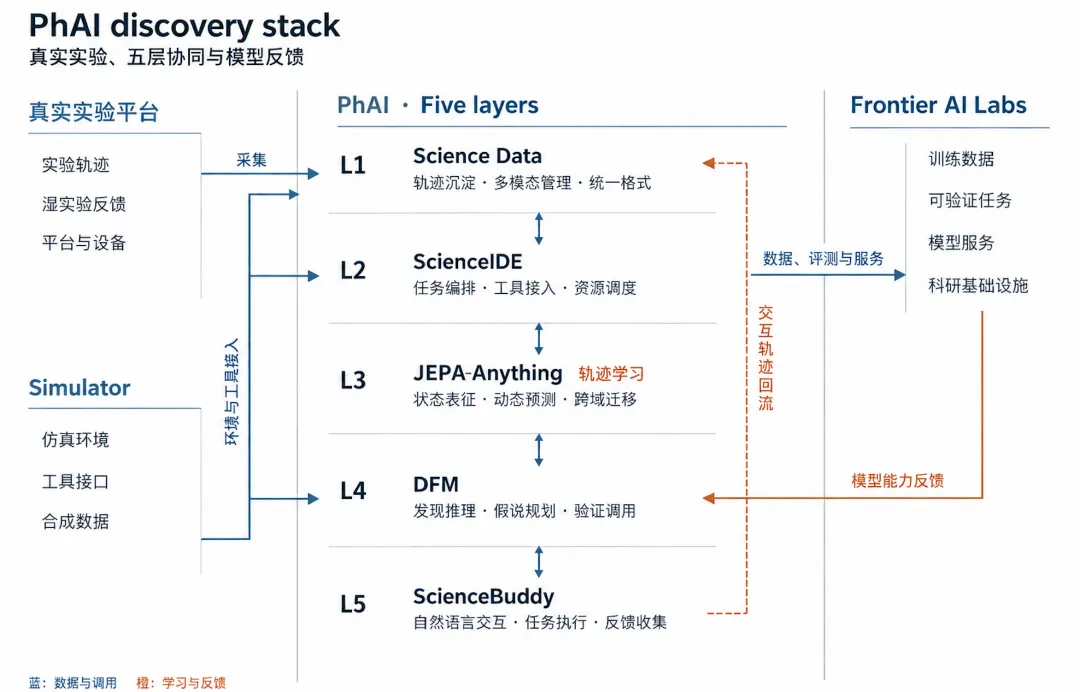
PhAI Labs 的五层能力体系:ScienceBuddy 位于与科学家实时交互的 L5 层(图源:PhAI Labs DFM 发布)
PhAI Labs 是一家自称"Neo Lab"的新型研究组织,核心团队来自斯坦福、牛津、普林斯顿等高校及产业机构,成员在 Cell、Nature、Science 均有第一作者论文——吴英成自己的履历就是这句话的注脚。9 月 15 日,他们先发布 DFM 技术报告,提出面向开放式科学发现的五层能力体系。 但版图里最早接受真实用户检验的,恰是最贴近科学家的 ScienceBuddy。
按论文的说法,ScienceBuddy 是一项独立研究,不依赖 DFM 框架:一个定义更大的方向,一个提供具体的系统对象。但两者指向同一个判断——AI 参与科学发现的关键,在于让判断、证据和经验持续积累的闭环。
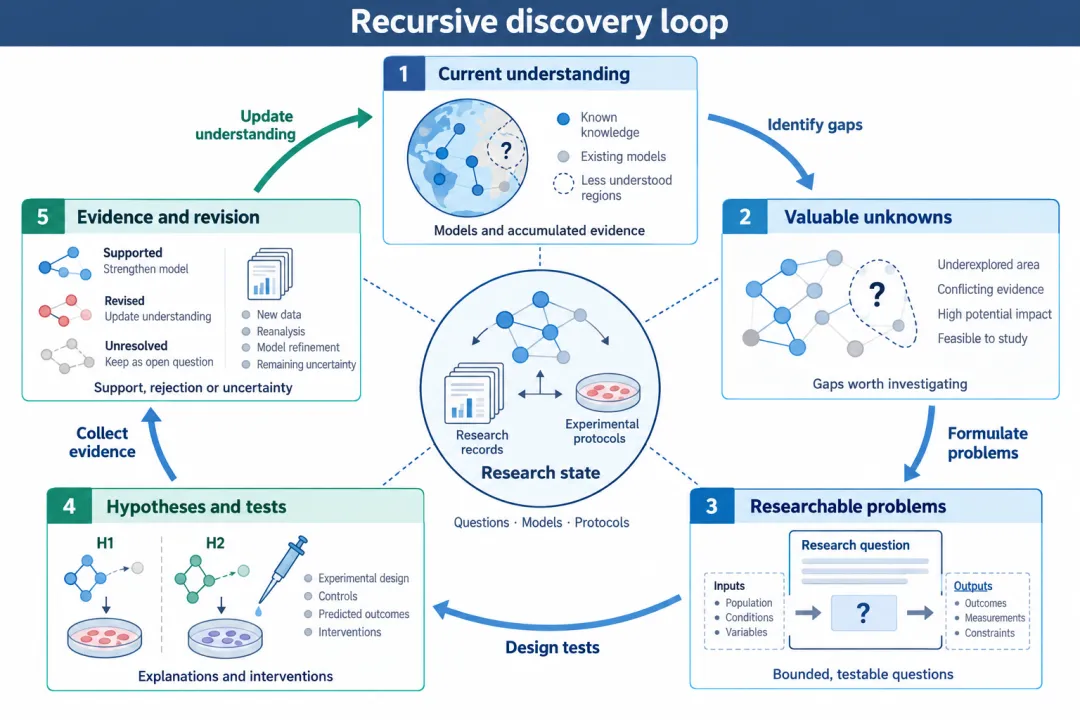
DFM 技术报告提出的递归发现循环:从问题发现、假设形成到外部验证,再回到对世界理解的更新(图源:PhAI Labs DFM 发布)
20 个点之后,问题才刚开始
需要把边界说清楚。harness 实验采用的是受约束的模拟反馈,那 45 个验证任务同时参与了适配反馈与 checkpoint 选择;模型学习只在一个 4B 模型、约两小时的训练预算上验证;交互案例是定性研究,样本量很小。但这些数字证明的只是机制存在,距离"自主科学家"还很远。 论文自己也划了线:这里展示的是研究者与 Agent 的协作能力,而非可检验的终极结论。
但方向已经足够清晰。在编程领域,真实交互数据已经在重塑 Agent 的迭代速度,科研 Agent 大概率会重演这一幕——谁先让科学家的每一次追问都沉淀成可复用的经验,谁就先拿到下一张门票。ScienceBuddy 开源了代码,也挂出了科学家合作计划,显然想让更多真实研究进入这条回路。
吴英成把未来粗略分成 AGI 之前和 AGI 之后。如果通往 AGI 的路真要穿过实验室,ScienceBuddy 想先修好门口那一段:让 AI 从科学家的追问里,学会做科研。 但这段路能铺多长,取决于有多少科学家愿意把自己的"不对"交给它。