ARTICLE · 1025040
AI Agent 的八大记忆策略:你的 AI 助手是怎么「记住」东西的?
AI Agent 的八大记忆策略:你的 AI 助手是怎么「记住」东西的?
我用 AI Agent 干活有一段时间了,一直有个问题困扰我:它到底是怎么「记住」事情的?
你有没有遇到过这种情况,你让 AI 帮你处理一个项目,聊了半小时,它突然忘了你开头说的关键需求。或者你昨天告诉它一个偏好,今天再开对话,它又变回了一张白纸。
这锅不在 AI,在记忆机制没设计好。最近我深入研究了一下,发现业界其实已经有八种主流的记忆策略,每种都有各自擅长的场景。今天就来聊聊这个。
为什么记忆这么难?
先说个前提。
人类的记忆是写在大脑神经元里的,睡一觉醒来还在。AI 的记忆呢?本质上是上下文窗口里的 token,对话一结束,全部清零。
这就像你在白板上画图,聊完天白板就擦干净了。下次再聊,又是一块干净的白板。
所以 AI Agent 要解决的核心问题就两件:怎么把重要信息存下来,以及下次需要的时候怎么高效找回来。
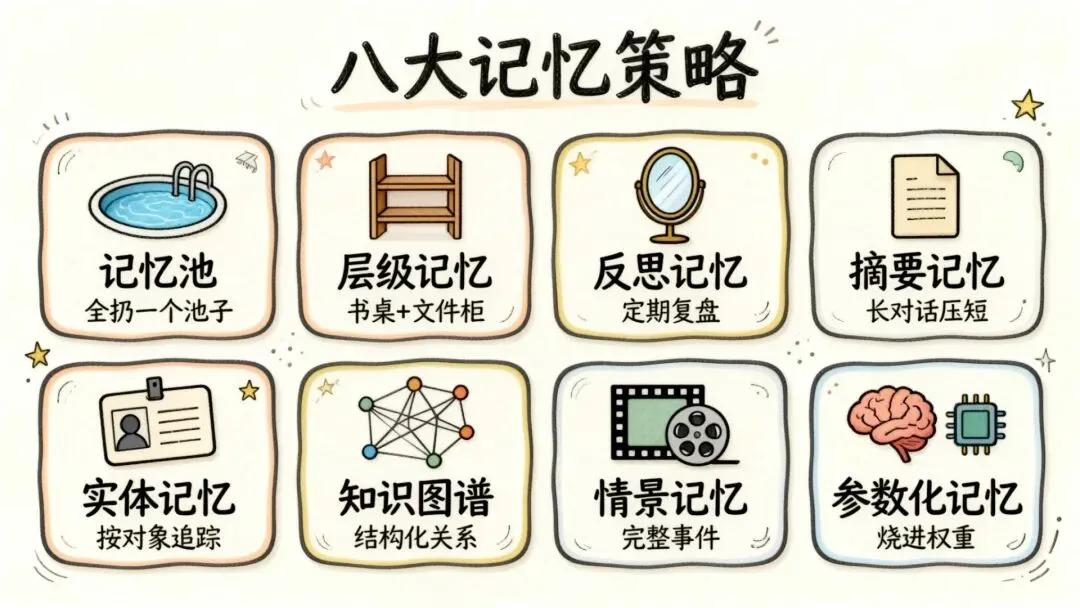
策略一:记忆池
最简单粗暴的方式,所有记忆全扔一个池子里。
对话记录、用户偏好、历史结论,全部塞进一个大数组。下次需要的时候,算一下相关性,把最相关的几条捞出来塞进上下文。
实现起来确实简单,但池子一大,检索质量就崩。就像你把所有笔记都堆在桌上,东西少了还好,堆了一百份你根本翻不过来。个人助手、小型项目用它还行,记忆总量上去了就不够看了。
策略二:层级记忆
那怎么办?分层呗。
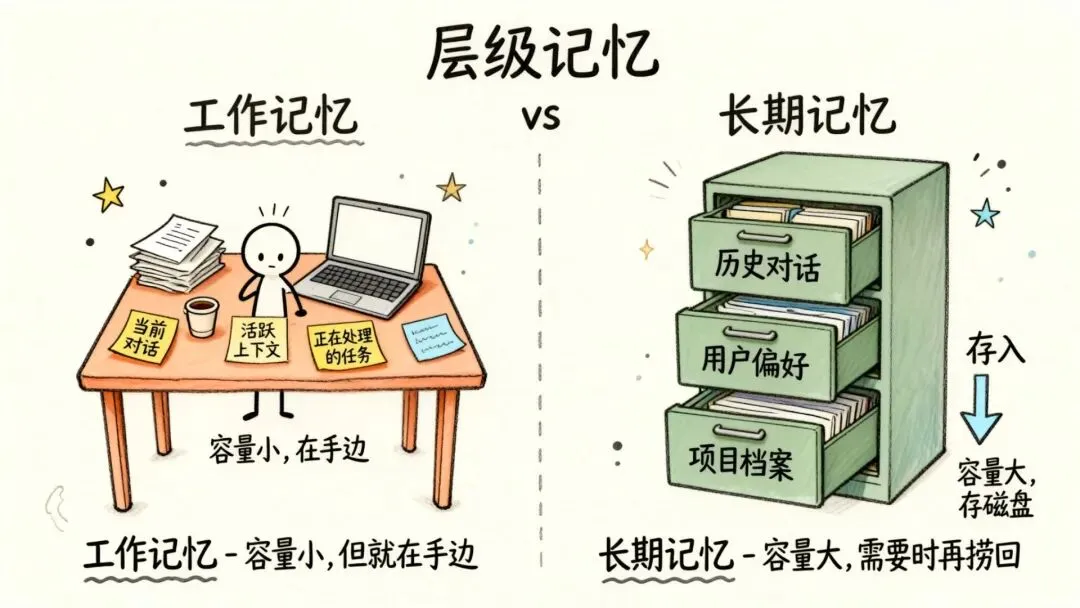
工作记忆放当前对话的上下文,活跃但容量有限。长期记忆存磁盘上,容量大但不活跃。工作记忆快满了,就把不活跃的内容挪过去;需要的时候再捞回来。
书桌和文件柜的关系。书桌上放正在处理的文件,文件柜里存历史档案。桌面空间有限,但最常用的东西就在手边。
我做的 planning-with-files 这个 Skill 就是典型的层级记忆,三个 Markdown 文件(task_plan、findings、progress)充当文件柜,当前对话就是书桌。
策略三:反思记忆
这个策略比较有意思,Agent 会定期停下来「复盘」。
比如完成一个任务后,它回顾整个对话历史,自己总结几条经验:「用户不喜欢这种代码风格」「这个 API 有坑,下次要注意」。存起来,下次遇到类似场景就能用上。
像不像你每天睡前复盘一下今天干了啥、学到了啥?记住的不是每一分钟的细节,是规律性的认知。
self-improving-agent 这个 Skill 干的就是这事,同一种错误犯三次以上,自动升级成永久规则写进配置文件。Agent 越用越聪明,靠的就是反思记忆。
策略四:摘要记忆
把长对话压缩成短摘要。
100 轮对话可能产生几万个 token,但核心信息可能就几句话。摘要记忆让 AI 自己去读历史对话,把关键信息提炼出来,丢掉细节。
比如你跟 AI 讨论了一个项目的技术方案,聊了 50 轮。摘要记忆会把它浓缩成:「项目用了 React,后端是 Go,数据库选了 PostgreSQL,核心难点在于实时同步」。下次再聊这个项目,AI 读这几句话就能接上。
claude-mem 用的就是摘要记忆加向量检索,三层渐进式检索省 Token。
策略五:实体记忆
换个思路,以「对象」为单位来组织记忆。
对话中会出现各种实体:人名、项目名、技术概念、API 接口。实体记忆把每个实体单独抽出来,建一个专属档案。下次再提到这个实体,直接把它的档案调出来。
比如你告诉 AI:「小王负责前端,小李负责后端,这个项目叫 Phoenix,用的 TypeScript」。它会分别记住小王、小李、Phoenix 项目各自的信息,互不干扰。
复杂项目管理场景特别需要这个,每个实体都有清晰的追踪记录,不会张冠李戴。
策略六:知识图谱
再进一步,把记忆结构化成一张图。
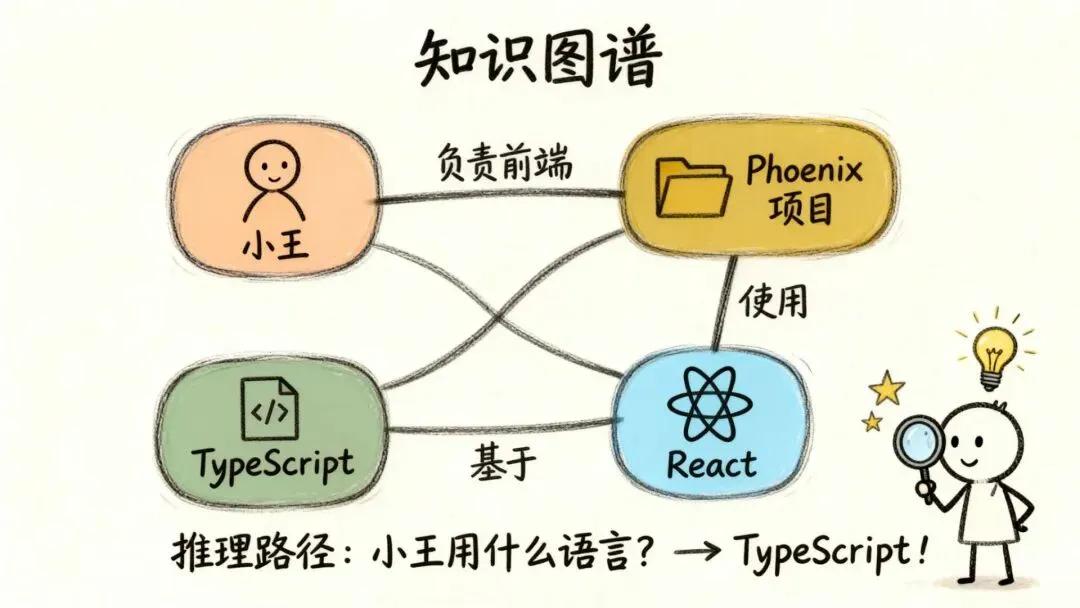
节点是概念,边是关系。「React 依赖 Node.js」「Phoenix 项目用了 React」「小王负责 Phoenix 的前端」。这些信息构成一张网络。
好处是能做推理。你问 AI「小王用什么语言写代码?」,它能通过图上的路径推出来:小王 → Phoenix 前端 → React → TypeScript。
构建成本高,维护也复杂。但如果你要做企业知识库或者技术文档管理,知识图谱的精确关系推理是别的方式给不了的。
策略七:情景记忆
前面几种都在「提炼」,情景记忆反其道而行——保留完整的事件片段。
什么时候、在哪里、发生了什么、结果如何,整个场景原封不动。就像你记得去年那次团建,去了哪里、吃了什么、谁讲了个冷笑话全场笑翻。
对 Agent 来说这比较奢侈,完整保留事件的 token 开销很大。但在某些场景下它不可替代,比如 debugging。你上次排查一个 bug 的全过程,包括走了哪些弯路、最终怎么解决的,这种完整经验对下次遇到类似问题特别有价值。
策略八:参数化记忆
最激进的一种,直接把经验烧进模型权重里。
前面七种都是显式存储,原文或者摘要都存在某个地方。参数化记忆不一样,它通过微调把经验内化到模型参数中,不再需要显式存储。
就像你学会了骑自行车,不会再去回忆「先抬左脚再踩踏板」的步骤,身体自然就记住了。
推理快、不占上下文,这是它的优势。但不可逆,你没法追溯它到底从哪条经验学到了什么,也没法轻松修改某条具体记忆。像肌肉记忆一样,一旦形成就很难刻意修改。
怎么选?
八种策略讲完了,你可能会问,我该用哪个?
看场景。
简单的个人助手,记忆池加摘要就够了。复杂的项目管理,实体记忆加知识图谱更靠谱。需要 Agent 不断进化,反思记忆是核心。需要保留完整经验,情景记忆不可替代。
现在的趋势是混合使用。人类的大脑也不是一种记忆打天下,你记一个电话号码用的是短期记忆,骑自行车用的是程序性记忆,昨天吃了什么用的是情景记忆。AI Agent 的记忆系统也在往这个方向走,多种策略组合,各取所长。
别贪多,想清楚你的核心场景,选一两种最匹配的深挖就够了。
以上,既然看到这里了,
如果觉得不错,随手点个赞、在看、转发三连吧,
如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章