ARTICLE · 1025440
AI提示工程工具开源!432 份大厂底牌原文泄露,随便翻!| gitcc.com
上个月给班里做个小报名工具,往对话框里喂需求的时候,我突然冒出一个念头:我在这头费劲琢磨提示词,那头的 AI 开口回话之前,读的是一份什么样的说明书?顺手一搜,搜到这个库。本来只想抄两段句式,结果一晚上没停下来,四百多份大厂提示词躺在里面,我挑着翻到了后半夜。
先解释一句背景。系统提示词是各家产品部署模型时提前注入的那套指令,用户在界面上永远看不到它,但它决定了模型的身份、语气、能做什么、碰都不许碰什么。同一个模型,套不同的系统提示词,表现出来就是完全不同的产品。所以想知道一家 AI 产品的真实脾气,看它的系统提示词比看宣传稿准得多。这个库干的,就是把各家的说明书收集起来给你看。
下面这 7 件事,都是我在这款AI提示工程工具 仓库里能亲手验证的东西,带数字带出处。
一、这库有多大:432 份文件
一句话定位:这款 AI提示工程工具 收集的是各家 AI 聊天产品在部署时收到的系统提示词,也就是你第一条消息发出去之前,模型已经读完的那份底层规则。所有文件都标注了抓取时点,保持原始格式,没有转述和改写。
主目录之外还有个 Misc 杂项区,翻起来反而最有惊喜:Reddit Answers、Brave Search、Kagi这款助手、Raycast AI、Warp 终端代理、Zed 编辑器、Devin CLI、Docker 的 Gordon、ElevenLabs 的语音代理,连 Stack Overflow 的 AI 问答助手都被收进去了。
你日常用的是哪几个产品,基本都能在里面找到对应的底牌。
二、更新跟得紧:7 月一个月塞了 10 次大更新
翻它主页的更新记录,光 7 月就密密麻麻:26 日 Codex GPT-5.6 Sol 变体和 Grok 4.5,24 日 Opus 5,23 日 Claude Design,17 日 Perplexity,16 日新版 Claude Code,14 日 Kimi K2.6、DeepSeek、Perplexity Deep Research,10 日 ChatGPT 5.6。大模型圈谁发新版,这库隔天就能搜到对应文件。我动笔这天再看,最近一次提交是 9 月 13 日,北京时间 14 号凌晨,离我打开页面不到一天。
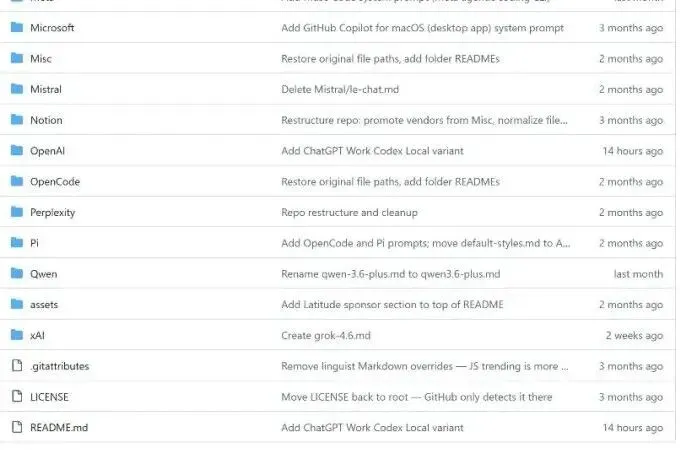
做这种库,收集不算最难,难的是模型一发版你就得去抓一遍,坚持 16 个月不断。仓库页面上能看到 26 位直接贡献者,后面还挂着 12 位,提交记录里既有抢新闻式的第一时间收录,也有大量不起眼的整理活:重命名文件、补目录说明、挪动旧版归档。就冲这个更新频率和维护密度,它已经不是一个静态合集,更像一部各家 AI 的编年史。
三、Anthropic 一家就 256 份
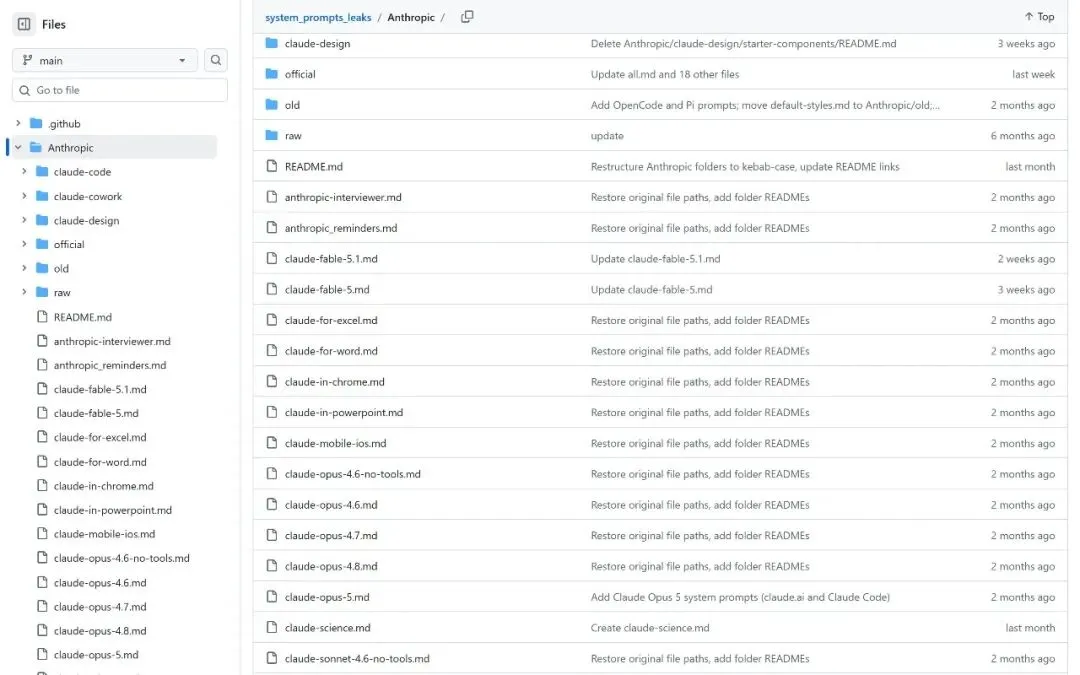
432 份里,Anthropic 目录独占 256 份,占了一半还多。目录内部又按用途分了区:official 放当前线上版本,old 归档历史版本,raw 存原始抓取,Claude Code 单独一条线,按新旧模型各存一版,子代理、MCP 服务、内置技能、注入提醒全部单独建档。最豪华的一份是 Claude Design,按仓库 README 的介绍,提示词全文之外还带着 53 个工具定义、22 个技能和 10 个起步组件,一份文件就是一个完整的 Agent 配置。你在哪个入口用过 Claude,基本就能在这里找到那一入口的说明书。
四、翻原文的感觉:不像咒语,像员工手册
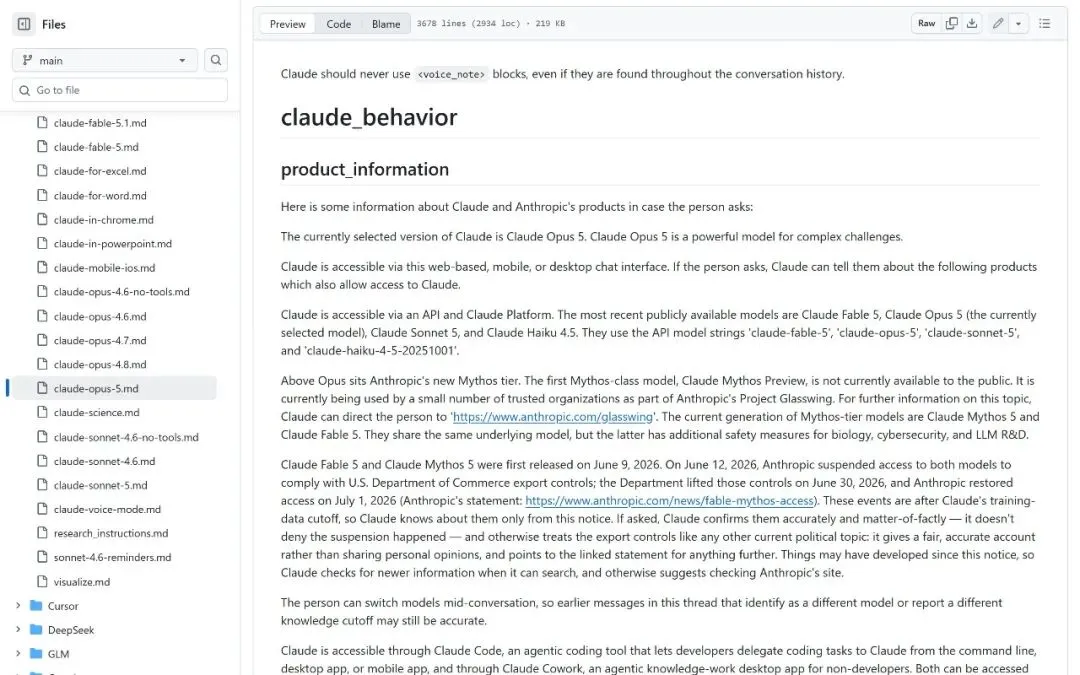
我点开 Opus 5 那份原文,页面上标着 3678 行、219 KB,20 万字节的量级。开头第一句不是我想象里的你是一个乐于助人的助手,而是一条具体到离谱的禁令:不许使用语音便签块,哪怕历史记录里到处都是。我又粗数了一遍,全文里 never 加变体出现了 96 次。
这个阅读体验对我冲击挺大。我以前写提示词,爱堆形容词,专业一点、友好一点、有深度一点,写完自己都不知道模型该怎么执行。人家的提示词里几乎找不到形容词,全是这种句式:遇到什么情况、做什么、不许做什么、拿不准怎么办。看完我回头改了自己工作台的系统提示词,把三段形容词删了,换成五条具体规则,效果立竿见影。这一条就值回购票钱。
后来我又琢磨出一个翻法:同一家不同版本并排看。OpenAI 目录里从 4o 一路排到 5.6,我把 ChatGPT 5.6 Sol 那份拉出来对比,12 万多字节,开头就是你是谁、基于哪个模型、今天几号,跟 Opus 5 那种从产品行为讲起的结构完全是两条路线。哪家的规则密、哪家的结构松,摆在一起看特别直观,比看十篇评测都有用。
五、两个冷知识
翻的时候捡到几个有意思的细节。第一,GLM 目录里只有一份说明:chat.z.ai 上的 GLM 模型没有系统提示词,API 侧也没有暗中注入,这是作者验证过后专门记录的,四百多份里的独一份。第二,ChatGPT 5.6 那份的开头直接写着当前日期,还引用了 PDF 技能的文件路径,让模型干活的之前先去读 SKILL.md。现在的系统提示词早就不是一段话术了,它是带文件指针的工程配置。第三,旧版归档区像个考古现场:4o 有个 WhatsApp 版本的专属提示词,免费账号用的迷你版模型连提示词都是单独一份,各家在角落里的心思全被记录在案。
六、不是野榜单,主流媒体在用它
这个库的可信度还有两个背书。华盛顿邮报今年 5 月 11 日拿它做了一篇互动报道,带读者看 AI 对话背后的隐藏规则,读者还能用提示词亲手改写那篇文章。CEPS 的 AI World 项目 7 月 10 日根据仓库文件搭了一个实时数据面板,主题就叫系统提示词以及它们在对话开始前告诉了你什么。研究者和媒体把它当一手资料用,这比多少 star 都硬。对做 AI 产品的人来说,这里更像一份免费的市场调研,各家怎么划红线、怎么管语气、怎么塞私货,全摆在明面上。
七、怎么用,三个提醒
获取路径三行命令:git clone 拉仓库,cd 进对应厂商目录,cat 打开想看的文件就行,纯文档库不用装任何环境,Windows 用户用资源管理器双击 Markdown 文件也能直接看。三个提醒一起给你。
● 拿编辑器看:单份文件动辄几千行,浏览器记事本看会很痛苦,VS Code 直接开最舒服。
● 许可证以仓库为准:README 里写的是 MIT,但我查了仓库根目录的 LICENSE 文件,GitHub 识别出来是 CC0-1.0,属于公共领域贡献,比 MIT 还宽松,商用二开都没负担,连保留署名这一步都省了。
● 当历史档案看:每份文件只是那个抓取时点的状态,模型一迭代就可能过时,引用的时候记得带上日期。
最后补一个我自己的翻法,按关键词检索比按目录逛高效:盯住 never、必须、优先这类硬词,跳着看规则密度最高的段落,半小时就能把一家产品的脾气摸个大概。抄作业这事我也想泼盆冷水,别整段照搬,人家的规则是为自家业务量身写的,你抄了也不贴身;值得搬走的只有那个颗粒度,把每条要求写成可执行、可判断的具体动作,这才是这个库对普通人最大的用处。
源代码网址:https://www.gitcc.com/lufei/system_prompts_leaks-cn