ARTICLE · 1025684
用 AI 生成接口文档:它会给你 40 个“看起来对”的端点
前天有人问我一个挺具体的问题:接了个 40 张表的库,手里只有一份三年前的 Confluence 文档,期限三天,接口文档怎么交。
这活儿搁两年前答案就是“写不完,先把核心的几个写了”。现在能做了,因为这件事正好落在大模型最舒服的区间:给你一堆结构化信息,批量产出格式规整的文本。
但我这次做完,最大的收获不是“AI 能写接口文档”。是看清了它会在哪几个位置,给你一份挑不出格式毛病、但内容是错的文档。这种错误最贵,因为它不会报错。
一、先想明白手写 Swagger 为什么一直没人干
不是因为懒。是因为这件事的投入产出比一直是负的。
YAML 的缩进、每个字段的 description、每个错误码的说明、每个请求体的示例值,全是纯体力活。写的时候没人看,写完三个月没人更新,过一阵子就变成一份谁也不敢信的历史文件。
所以现实里只有三条路线在跑。
这张表里最要紧的一句话是:前两条解决的是“结构同步”,第三条解决的是“语义填充”。它们不是替代关系。
我见过有人把三条混着用,结果拿到一份结构对、语义错的文档,还因为 Swagger Editor 没报红,就直接发给前端了。
二、四个它一定会踩的坑
下面这四条,全部来自公开的实战复盘,我把它们和我们自己项目的情况对了一遍,基本都撞上了。
坑一:不给外键约束,你会拿到 40 个平铺端点
这是最容易被忽略的一条。
你把一份只有表名和字段名的 schema 丢过去,AI 会老老实实给你每张表生成一组 CRUD。40 张表大概就是 160 个左右的 path。
看起来挺完整。但它不知道 users 和 orders 是什么关系,所以本来应该是 /users/{id}/orders 的嵌套资源,被拆成了 /orders?userId=。前端对接的时候要多写一层手工拼参,测试写用例要多造一次数据,而且这类平铺接口特别容易漏掉权限校验。
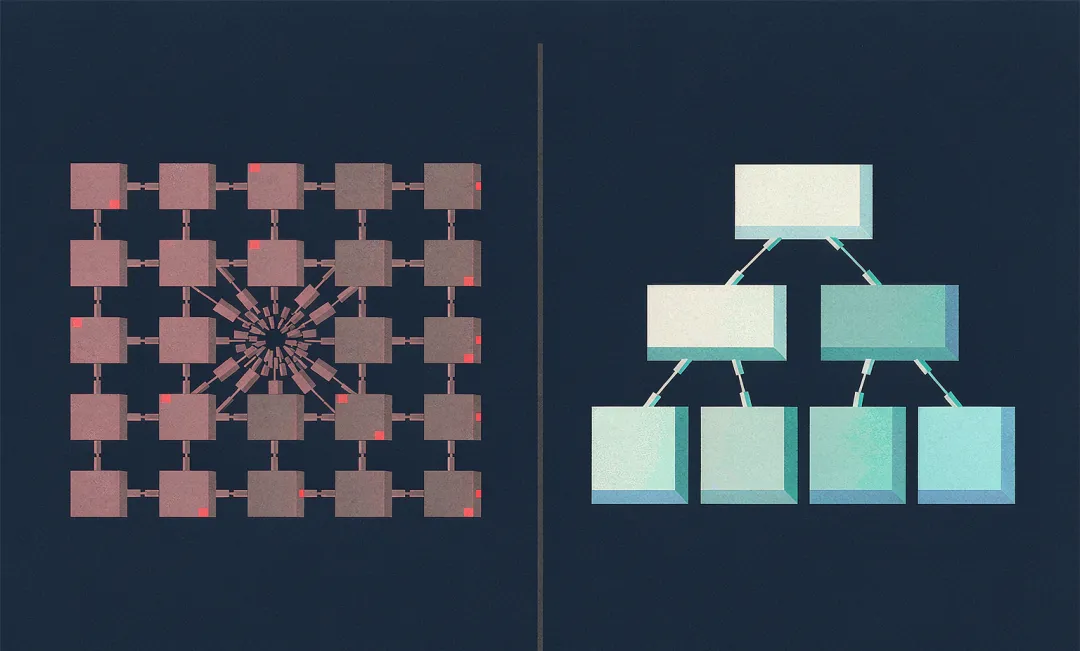
左图是它交上来的东西,几十个端点长得一模一样,全部平铺在同一层。右图是它本该交上来的东西,父子关系清清楚楚。两张图的差别,只在于我有没有把那句外键约束给它。
关键点在于:AI 不是不会做嵌套,是它没有材料。外键约束就是材料。
所以第一条铁律是,导 schema 的时候要导带类型、带 NOT NULL、带 unique、带外键的完整 DDL,或者 Prisma、TypeORM 的 schema 文件。只给表名和字段名,等于让它在没有地图的情况下画地图。
而且这件事有个恶性的地方:发现问题的时候,你要改的不是几个字段,是半个 spec 的 path 结构,基本上等于重写。
坑二:复合主键会被静默丢列
生成器在处理复合主键时,常见的行为是取第一列当作唯一标识,第二列就没了。没有警告,也没有注释。
最容易中招的是中间表。比如一张关联表主键是 (waste_id, category_id),生成出来的路径参数里只剩一个。
这类错误比坑一更难发现,因为丢掉的列往往不是必填项,接口能跑,只是永远查不全数据。
我们能做的很土但有效:把所有复合主键的表单独列一张清单,逐张核对 path 参数。表不多的话,十分钟能核完。
坑三:枚举值超过一定长度会被截断
状态列是最典型的。一个 status 字段如果有二十几个取值,生成结果里经常只剩下前面若干个。
这份文档最危险的地方就在这:不是缺了字段,是缺了但你从格式上看不出来。前端照着文档实现,遇到没列出来的状态值就走进 default 分支,然后线上出问题。
唯一的办法是拿数据字典对着核。这个动作没法交给 AI,它不知道你字典里到底有几个值。
坑四:校验全绿,不等于内容对
这是四个坑里最需要单独拿出来说的。
Swagger Editor 这类工具做的是结构校验。它只关心 YAML 语法对不对、必需字段在不在。一个很典型的结构报错长这样:
Structural error at paths./x.get.responsesshould have required property 'description'这类错误在错误响应的定义上尤其常见,因为 AI 经常只写状态码不写说明。
但反过来推一下就知道问题在哪:结构校验通过,只能说明这份文档能被解析,不能说明它描述的是你的系统。
再补一刀。发布环节还有个假绿灯。文档站一般带缓存,同步失败的时候站点不会白屏,它照常展示上一次构建成功的内容。于是页面看起来完全正常,只是端点数已经和库里对不上了。有人做过统计,这种“看起来正常的过期文档”能挂好几天,直到有人发现接口数量不对。
三、让它不出错的五步做法
把上面四个坑反过来说,就是一套能落地的流程。
第一步:把 schema 当唯一事实源
不要给 AI 看 Java 代码让它猜字段含义。直接给它数据库的 DDL,或者框架的 schema 文件。
理由很简单,代码里的字段名是给人看的,数据库里的字段类型和约束是给机器看的。AI 需要的是后者,顺带还能拿到前者。
第二步:补三件它猜不出来的约定
这三件事在整个仓库里都找不到答案,只能你告诉它。
命名映射。数据库的 gmt_create 和接口的 createdAt 之间是什么关系,软删字段到底叫 deleted 还是 deleted_at,值是 0 还是 NULL。
单位约定。quantity 这个字段到底是吨还是千克,最多几位小数。我们这边就吃过一次,前端按千克传,后端按吨存,库存数字直接放大了一千倍。
幂等语义。同一个入库单号重复提交,是返回首次结果,还是再插一条。这件事必须写在接口说明里,因为它决定了调用方能不能安全重试。
第三步:要求每个字段都有 description、枚举全集和可用的 example
不要满足于“结构完整”。把这三项写成硬性要求,AI 通常都能补出来,只是你不要求它就不写。
示例值要给真的,不要给 "string" 这种占位。price_cents: 1200 表示 12 元,前端看一眼就懂,联调的时候能省掉一轮沟通。
第四步:反向核对,用 spec 去请求真实服务
这一步是整套流程里最关键的,也是最多人跳过的。
不要用眼睛看 spec。把生成的 openapi.json 拉出来,对着每一个 path 向真实启动的服务发一次请求。404 说明文档里有服务没有的接口,500 说明参数定义和实现不一致,返回字段缺了说明文档漂移了。
如果项目用 Spring Boot,可以在编译期就把 spec 落盘,配置大概是这个样子:
<plugin><groupId>org.springdoc</groupId><artifactId>springdoc-openapi-maven-plugin</artifactId><version>1.4</version><executions><execution><id>integration-test</id><goals><goal>generate</goal></goals></execution></executions><configuration><apiDocsUrl>http://localhost:8080/v3/api-docs</apiDocsUrl><outputFileName>openapi.json</outputFileName></configuration></plugin>注解这边可以写得再具体一点,把单位、字典范围、幂等语义都写进描述里,让它们直接变成文档的一部分:
@Operation( summary = "危废入库登记", description = "同一 inboundBatchCode 重复提交时返回首次结果,接口幂等,可安全重试")@PostMapping("/waste/inbound")public Result<InboundVO> inbound(@Parameter(description = "入库数量,单位吨,最多三位小数", required = true)@RequestParam BigDecimal quantity,@Parameter(description = "危废类别编码,取值见数据字典,形如 HW08", required = true)@RequestParam String wasteCategory,@Parameter(description = "入库单号,全局唯一,作为幂等键", required = true)@RequestParam String inboundBatchCode) {// ...}写注解比写 YAML 的心理门槛低得多,这是注解驱动能长期活下来的真正原因。人只愿意做顺手的事。
第五步:spec 进 Git,代码改动时 CI 里比一次
这一步是把文档纳入代码管理。spec 文件提交进仓库,CI 里加一条 diff 检查,代码改了但 spec 没改就直接报红。
这条断言要能拦住一个具体的场景:端点数和服务实际注册的路由数对不上。以前靠人发现,现在靠流水线。
附:一段可以直接抄的提示词
把下面这段连同 DDL 一起发出去,上面四个坑能避开大半。核心思路是把“不许你猜”的边界提前划清楚,而不是等它交完稿再去挑错。
你是一名后端接口文档工程师。我会给你一份数据库 DDL 和 Controller 源码。请生成 OpenAPI 3.0 规范,遵守以下硬性要求:1. 有外键关系的表一律用嵌套路径表达,不要平铺成查询参数。2. 复合主键的表,路径参数必须包含全部主键列,一个都不能省略。3. 枚举字段必须列出全部取值。如果你不确定全集,标注“待人工补全”, 不要自行截断,也不要自行编造。4. 每个字段都要有 description,说明业务含义、单位、取值范围。5. 每个字段都要给真实的 example,不要写 string、0 这类占位符。6. 写入类接口必须说明幂等语义:重复提交同一业务主键时会发生什么。7. 每个错误响应都要有 description 和触发条件。输出完 spec 之后,请单独列出你不确定或做了假设的字段清单。第 7 条和第 3 条是这份提示词里最值钱的两句。要求它自己交出不确定清单,等于把“它猜了什么”从暗处搬到了明面上。人不用去猜哪里可能错,看清单就行。
四、接口文档现在有三类读者
这一点很多人还没反应过来。
过去接口文档是写给两类人看的。前端要看参数和示例值,测试要看错误码和边界条件。人有个好处,看不懂会来问。
现在多了第三类读者,AI Agent。它会读你的 OpenAPI 去决定调哪个接口、按什么顺序调、失败之后要不要重试。
这类读者有个特点:它不问。
你的文档里没写“这个接口幂等”,它就按不幂等处理,重试三次给你留三条脏数据。文档里没写单位,它就按字面值填,然后把责任推给上游。
所以接口文档的准确度要求,实际上比过去高了一档。以前写错是人和人之间的沟通成本,现在写错是直接的数据问题。
反过来看,既然有机器在读,文档里就该补上那几句过去常被省略的话:什么情况下不要调这个接口,调用它的前置条件是什么,失败之后重试安全不安全,单次最多能传多少条。这几句话人看了觉得啰嗦,机器看了刚好够用。
五、发出去之前的核对清单
留六行,每次出文档过一遍。
spec 里的 path 数量,是否等于服务实际注册的路由数量 每张表的外键,是否都落成了嵌套路径或明确的查询参数 复合主键的表,是否逐张核对过路径参数 枚举字段,是否对着数据字典核过全量取值 写入类接口,是否都写清了幂等语义和单位约定 spec 是否已提交进仓库,CI 是否有 diff 检查
我的答案
接口文档这件事有个反直觉的地方。它坏掉的时候,页面还在。
链接能打开,缩进很整齐,Swagger UI 也能正常渲染,只是里面的东西和代码已经分家了。这种坏法不会报警,不会抛异常,也没有任何一处显示成红色。它只会让前端多问一句“这个字段是什么意思”,让测试多造一次数据,让某个 Agent 在不该重试的时候重试了第三次。
所以别把“生成”当成终点。AI 帮你省掉的是那部分体力活,剩下的那部分判断,一样都没少。