ARTICLE · 1025736
保姆级WorkBuddy+腾讯文档教程,手把手带你搭建全自动工作流
-第 12篇原创-
熊大AI实验室
1945 年的那台机器,今天终于落地了
1945 年,万尼瓦尔·布什在《大西洋月刊》上发表《As We May Think》,描述了一台叫 Memex 的机器:
“A device in which an individual stores all his books, records, and communications, and which is mechanically coupled to his memory.”
一个人的所有书籍、记录、通信,都存在一台机器里,并且跟他的记忆机械耦合。
这话说的是 80 年前。那时候没有互联网,没有云端,没有 AI。布什只能靠想象。
但他想明白了一件事:人的记忆是不可靠的容器,真正值钱的,是「记忆的外挂」。
hi,你好,我是熊大。今天,给大家汇报下我最近玩工作台解决的一个困扰我很久的问题,它彻底通了。
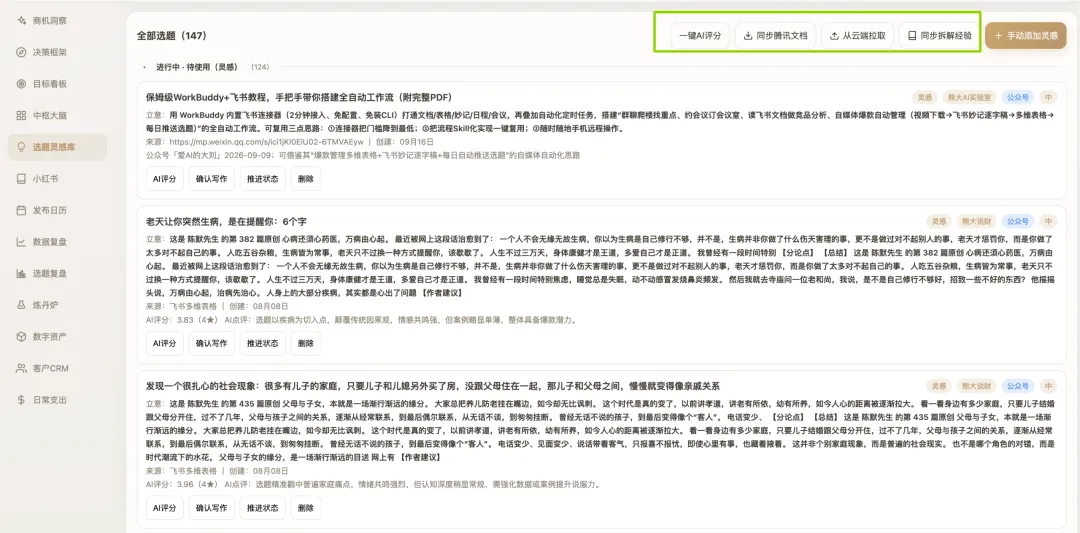
我的出发点其实很简单:比如我看到一篇不错的选题素材,我随手转给 WorkBuddy,然后它自己去拆解去沉淀进腾讯文档里的选题素材库,然后工作台直接同步显示腾讯文档里的选题素材库,然后我在工作台的数据分析、爆款拆解、经验沉淀自动填写进腾讯文档。
说干就干!
于是有了,59 条复盘数据、139 条选题素材、21 条爆款拆解经验,全塞进一张腾讯文档表。然后我让 AI干了一件很多人不敢干的事,清了浏览器缓存。
再打开,工作台满血。一条不少。
那一刻我脑子里就一句话:这不是备份,这简直就是我的第二条命。
今天这篇,把整套云端飞轮拆给你看。
你收藏的 100 篇爆款,和没收藏没啥区别
先说一个让人不舒服的事实。
你微信收藏里躺着几百篇「写得真好」的文章,你的笔记软件里躺着几千条「以后用得上」的素材,你的浏览器书签栏分了十几个文件夹,整整齐齐。
然后呢?
你上一次打开它们是什么时候?你上次写东西的时候,真的去翻了其中哪一条?还是又打开一个空白文档,从零开始想?
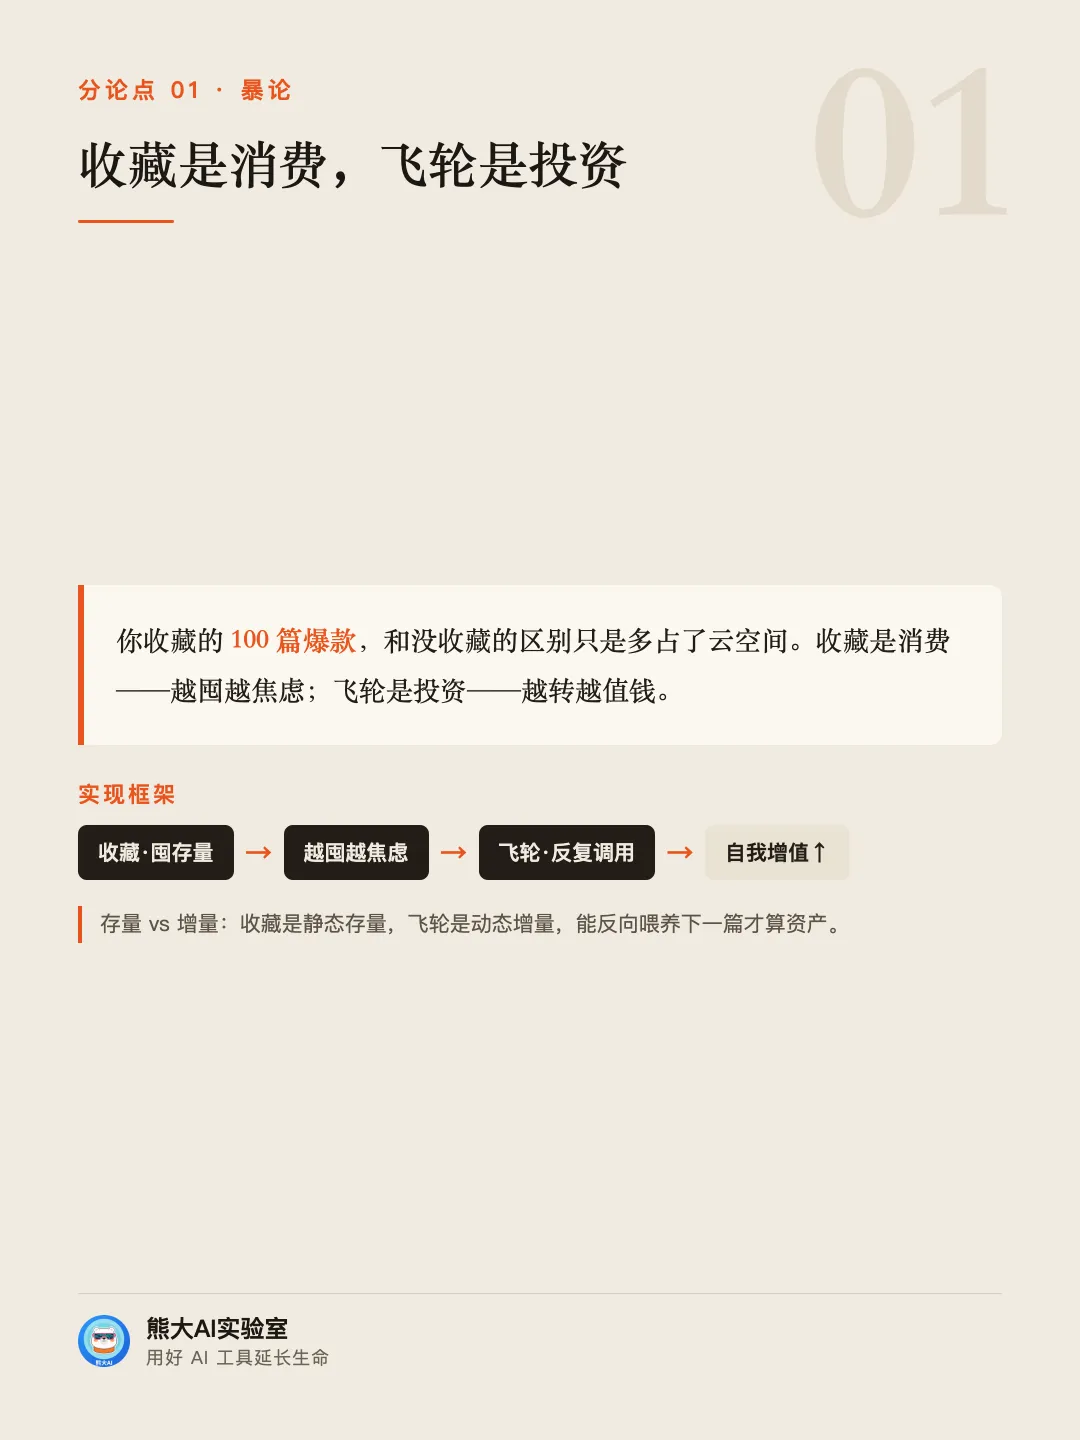
收藏是死的,囤着不动的资料不叫知识库,叫数字杂物间。
只有能反复调用、能自我增值、能反过来喂你下一篇内容的系统,才叫资产。
这是我认为「云端飞轮」和「资料仓库」最本质的区别:
仓库只进不出,越堆越乱;飞轮是「拆 → 萃 → 反哺 → 验证」一圈圈转,每转一圈,下一次创作就更快、更准、更不费脑子。
你囤的是资料,我们要建的,是一套会自己长大的系统。
收藏是消费,飞轮才是投资。前者越囤越焦虑,后者越转越值钱。
你不需要写代码,不需要数据库,不需要懂 API
先把丑话说在前面,也把门槛拆掉。
很多人一听「搭知识库」、「建工作流」,本能反应是,我不会写代码,这跟我没关系。
错!
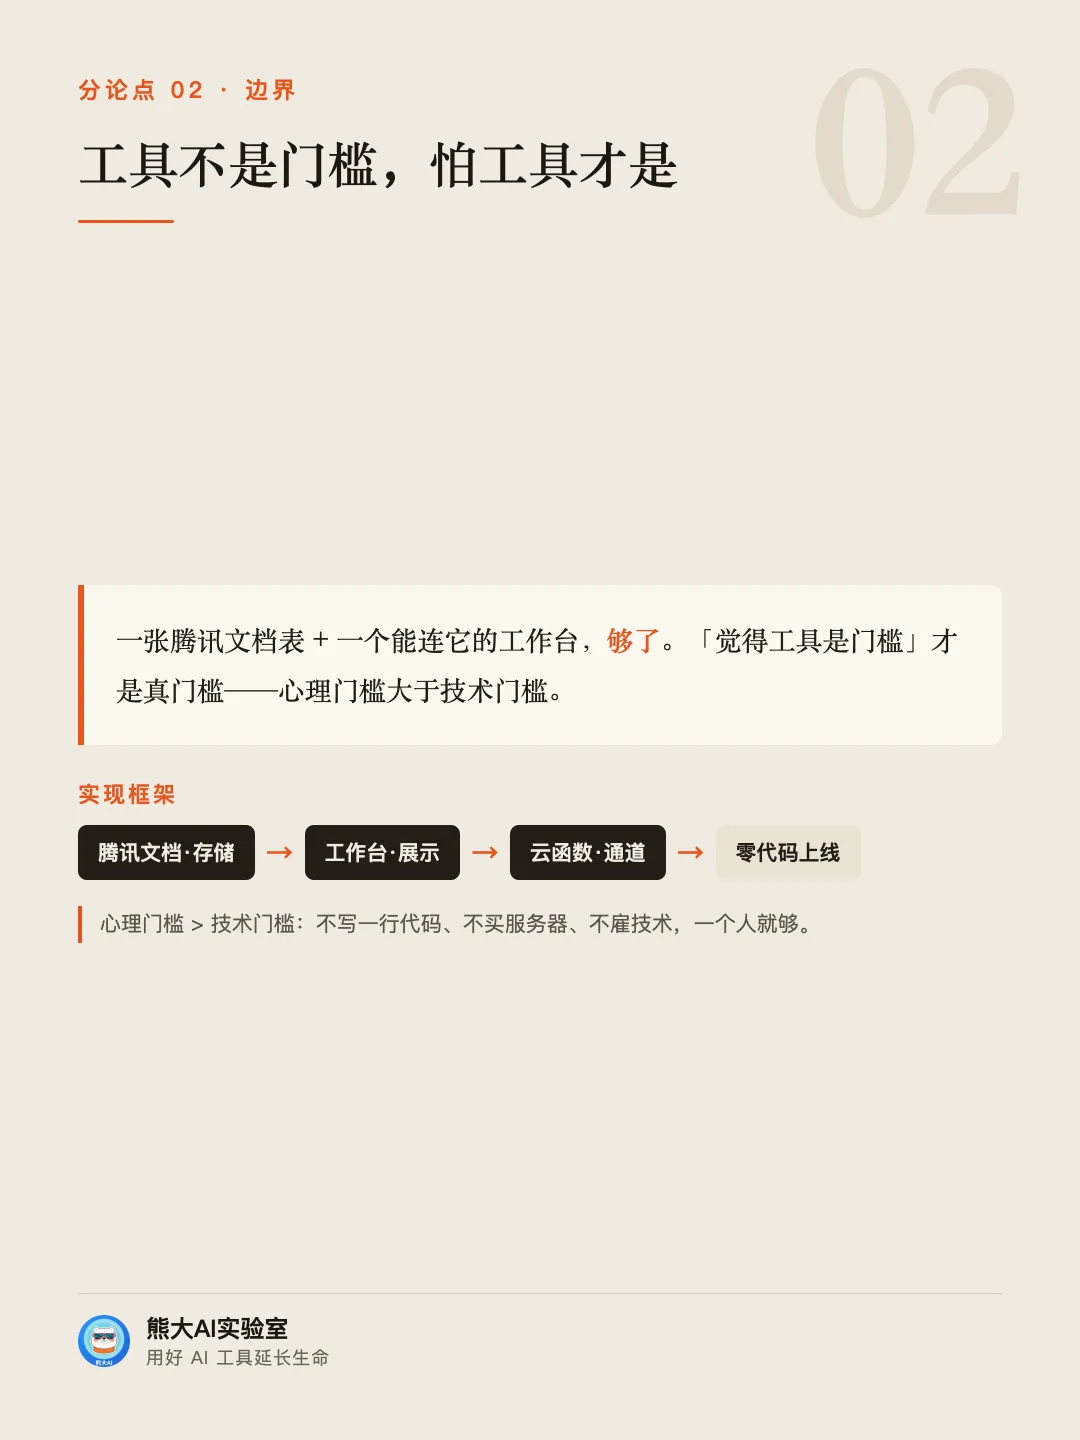
我们跑通的这套东西,核心就三样:
| 腾讯文档 | ||
| WorkBuddy 工作台 | ||
| 云函数 |
你不需要写一行代码,不需要买服务器,不需要懂什么叫 API,不需要雇技术团队。
一个人,一张表,一个工作台,够了。
技术人看到这会想:这不就是 CRUD 吗?内容人看到这会想:这不就是 Excel 吗?老板看到这会想:这不就是不用招人吗?
都对,关键是:你动手了吗?
那些说「等我学会 Python 再搞自动化」「等我招人搭中台」的同行,还在等。我们的飞轮已经转了三个月,数据越滚越大。
工具从来不是门槛,「觉得工具是门槛」才是门槛。
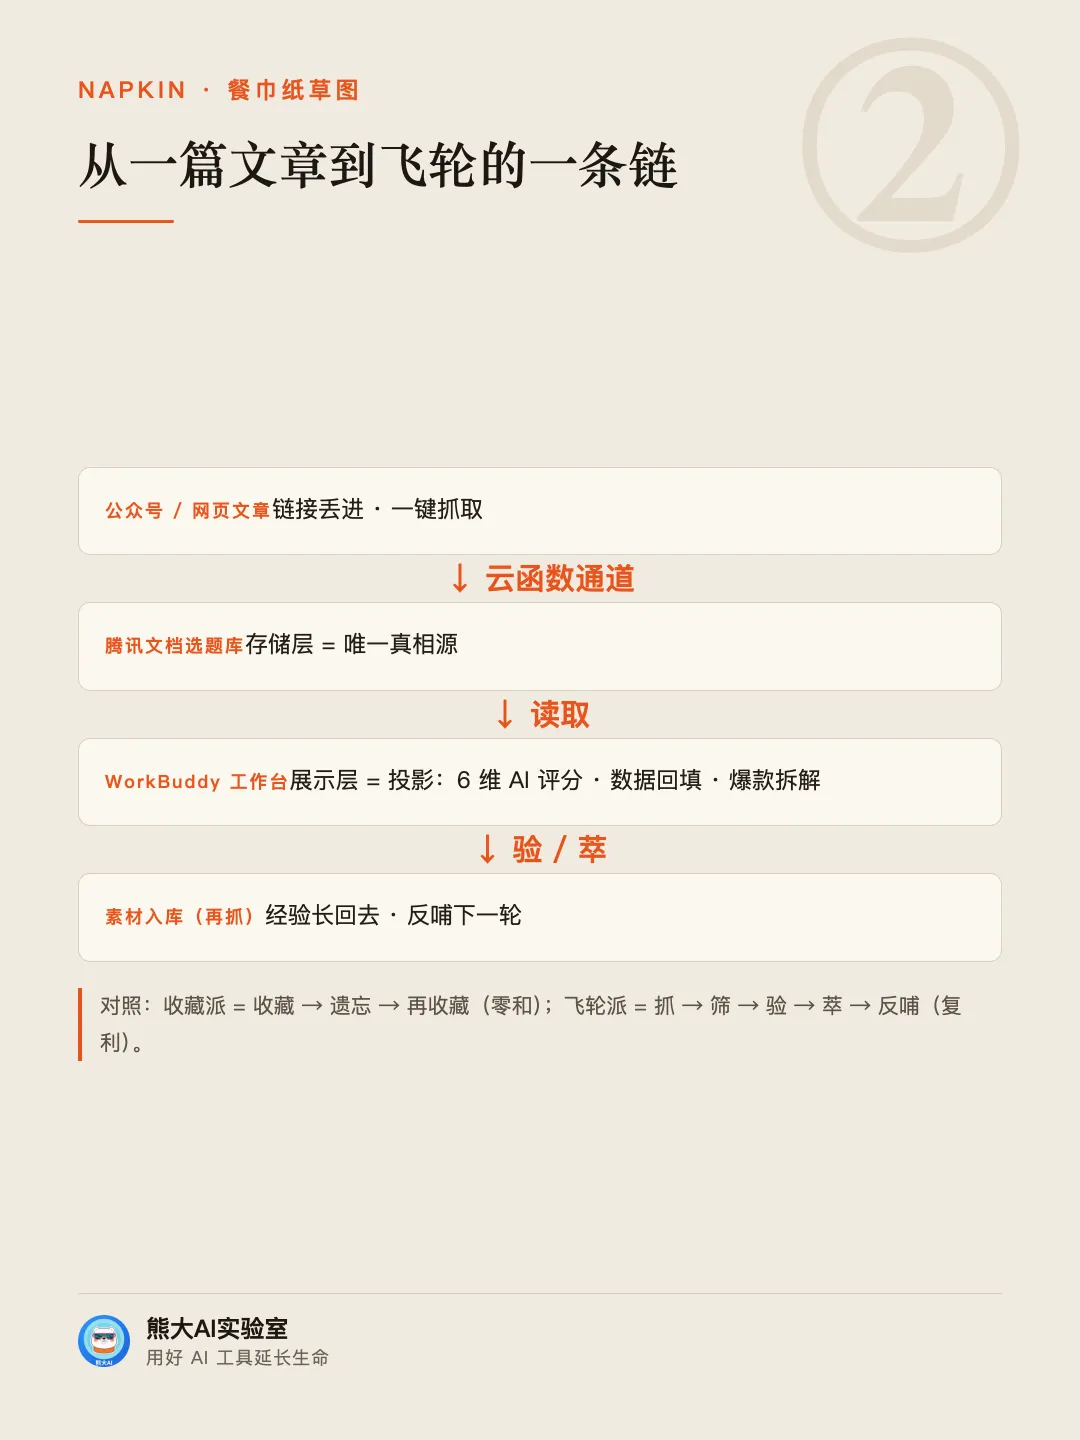
存储、展示、通道,三层解耦
好,现在讲这套系统为什么能跑通、能复制、能长大。
核心就四个字:三层解耦。
| 存储层 | ||
| 展示层 | ||
| 通道层 |
为什么要拆开?因为揉在一起的系统,一处坏全盘崩。
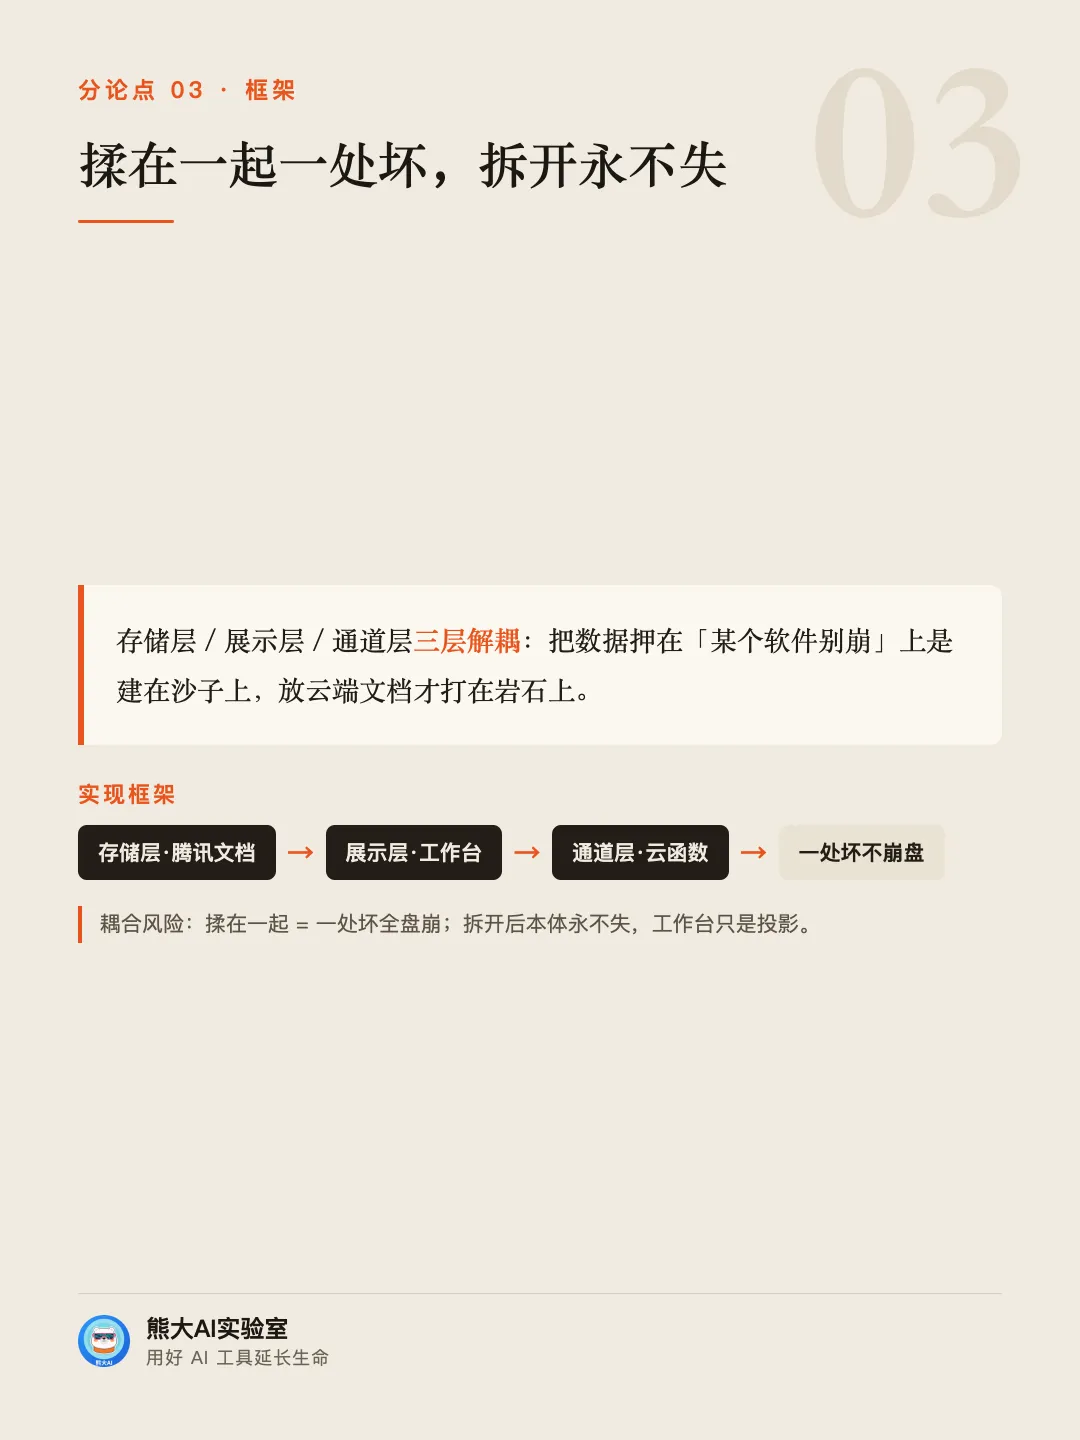
你把数据存在某个软件的本地数据库里,那个软件崩了、你换电脑了、缓存清了,数据就没了。你把数据和界面绑死在一个平台里,那个平台改规则、收费、关停,你就得从头再来。
但拆开之后——
腾讯文档是你的「唯一真相源」,不管工作台怎么折腾,数据本体永远在云端躺着。工作台只是「投影」,坏了换一个,数据一条不丢。通道层就是一根管道,管道堵了修管道,不动两边的本体。
把数据押在“某个软件别崩”上,是把资产建在沙子上。把数据放在云端文档里,才叫把地基打在岩石上。
技术人懂这个道理,但懒得动手。内容人不懂这个道理,被工具绑架了都不知道。老板懂这个道理,但不知道不用招人也能搞定。
这篇文章就是来拉平信息差的。
清了缓存打开还是满血,真资产和假资产的区别
光说架构没用,验证给你看。
9 月 16 号那天,我们把整套流程跑完之后,做了一个“破坏性测试”。
直接清了浏览器缓存。
换成以前用本地文件、本地数据库的方案,这一下就是灾难。你存的 JSON 文件、你的 localStorage、你的缓存快照,全没。
但这次,重新打开工作台,59 条复盘数据、139 条选题、21 条爆款拆解,一条不少,满血复活。
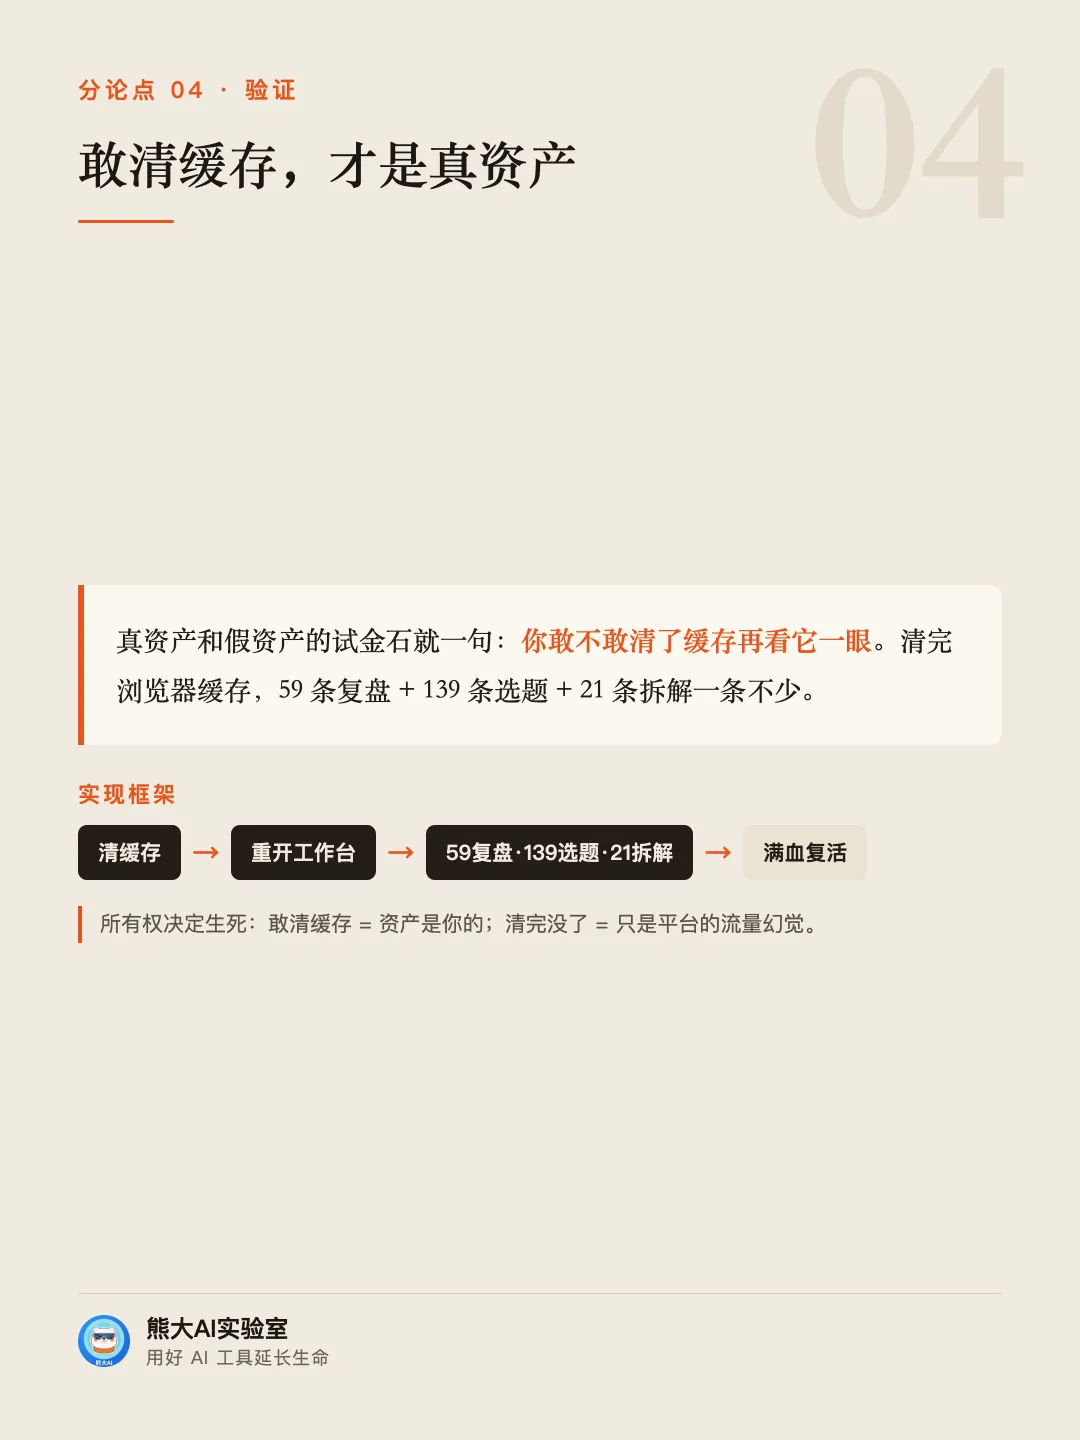
为什么?因为数据根本不在浏览器里,不在本地文件里,不在任何「会丢」的地方。它在腾讯文档里,在云端,在你自己的账号下。
真资产和假资产的区别就一句话:你敢不敢清了缓存再看它一眼。
你存在某个笔记软件里的资料,你敢卸载那个软件吗?你存在某个平台后台的数据,你敢想象那个平台关停吗?
如果不敢,那不是你的资产。那是你租来的,随时会被收走。
数据的所有权,决定了你内容资产的生死。
素材入库:公众号链接 → 腾讯文档选题库
好,验证完了,现在讲飞轮怎么转。
Step 1,素材入库。
动作极简:你在公众号、网页、任何地方看到一篇文章,觉得「这个选题可以」「这篇写得好」,链接复制,丢进腾讯文档选题库。
关键一步:打上账号标签。
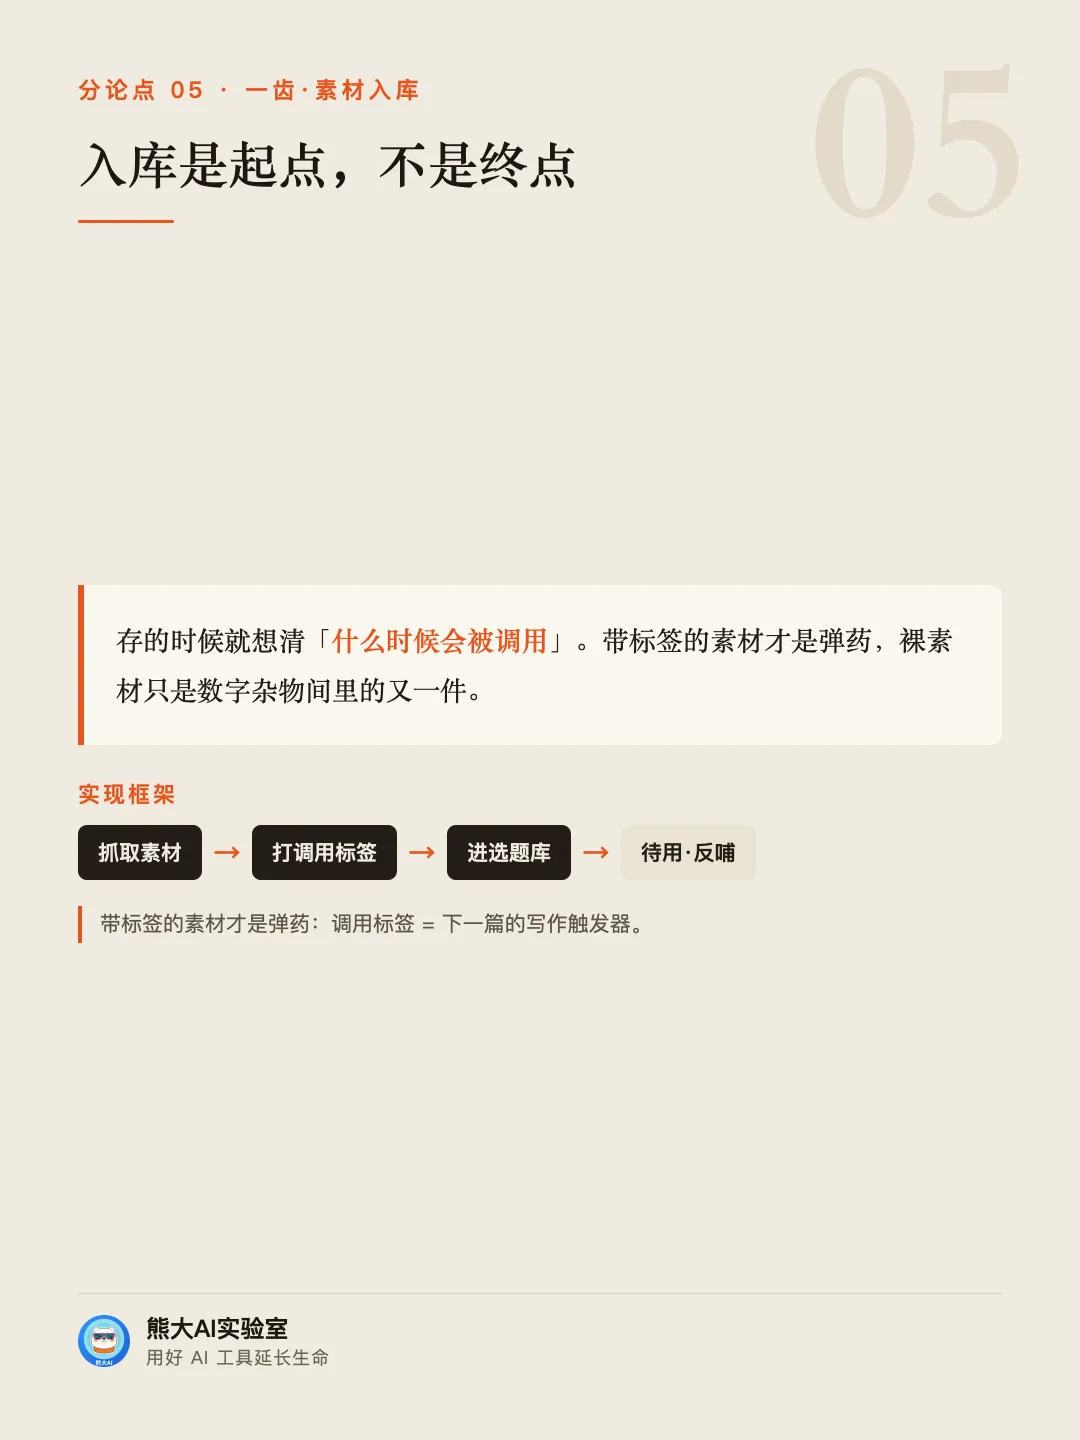
我们目前的选题库 139 条,按「账号」字段打标分组,「熊大说财」138 条,「熊大AI实验室」1 条。为什么要打标?因为不同账号的调性、受众、选题方向完全不同,混在一起就是一锅粥。
打上标签之后,每条素材天然就有了归属。后面做筛选、做评分、做派单,全部按标签走,不乱。
素材入库的核心不是「存」,是「存的时候就想清楚怎么用」。
没有标签的素材是垃圾,有标签的素材才是弹药。
入库不是终点,入库是起点。你存的那一刻,就得想好它以后怎么被调用。
AI 打分:6 维评分卡给选题做 CT
素材进来了,但不能全写。你得知道哪些值得写、哪些是垃圾。
Step 2,AI 打分。
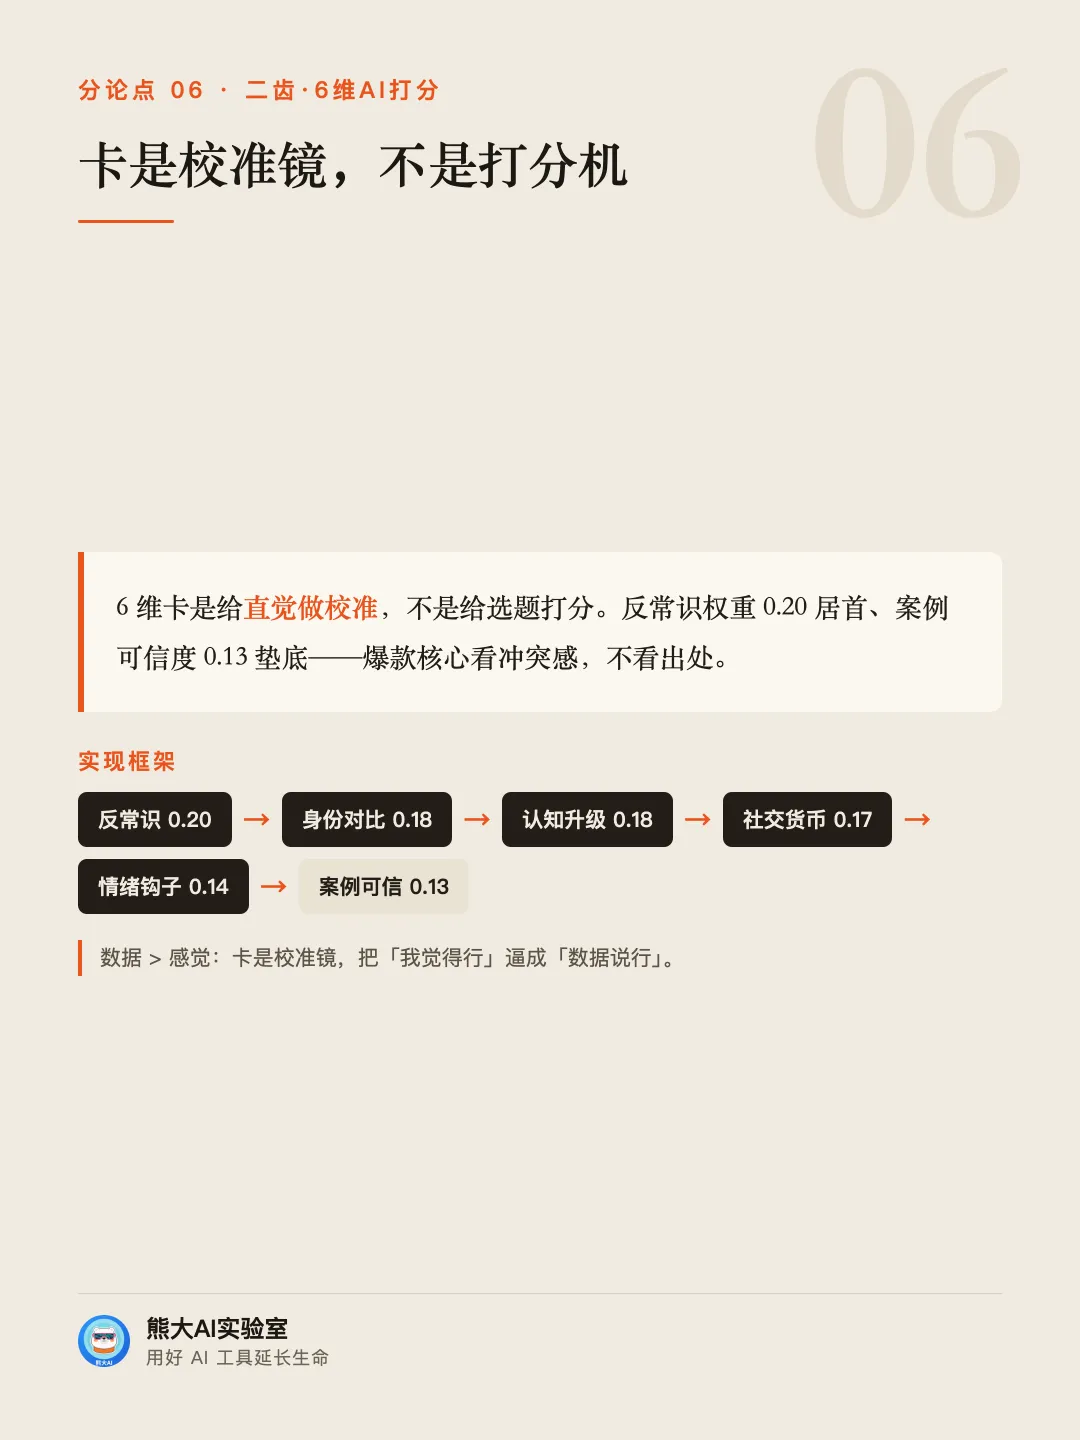
工作台上有一个「一键 AI 评分」按钮。点下去,系统给每条选题做 6 维 CT:
| 反常识 | ||
| 身份对比 | ||
| 认知升级 | ||
| 社交货币 | ||
| 情绪钩子 | ||
| 案例可信度 |
6 个维度加权算总分,转成 1-5 星。星级 ≥4 且反常识维度高的,优先派单。
注意看权重,反常识 0.20 排第一,案例可信度 0.13 垫底。这不是随便排的。选题能不能爆,核心看“有没有反常识的冲突感”,案例只是加分项不是决定项。
技术人可能会问:为什么不用更复杂的模型?因为够用了。内容人可能会问:这不就是给我的直觉打分吗?对,但比你的直觉稳定。老板可能会问:这能省多少时间?139 条选题,人工筛半天,AI 打分几秒钟。
6 维评分卡不是给选题打分,是给你自己的直觉做校准。你以为的好选题,AI 用数据告诉你能不能打。
数据回填 + 选题复盘,用真实阅读验证判断
打分筛完了,文章写了,发出去了。然后呢?
大部分人的流程到这就结束了。文章发出去,看阅读数高就高兴,低就算了。从不想为什么?
Step 3,数据回填 + 选题复盘。
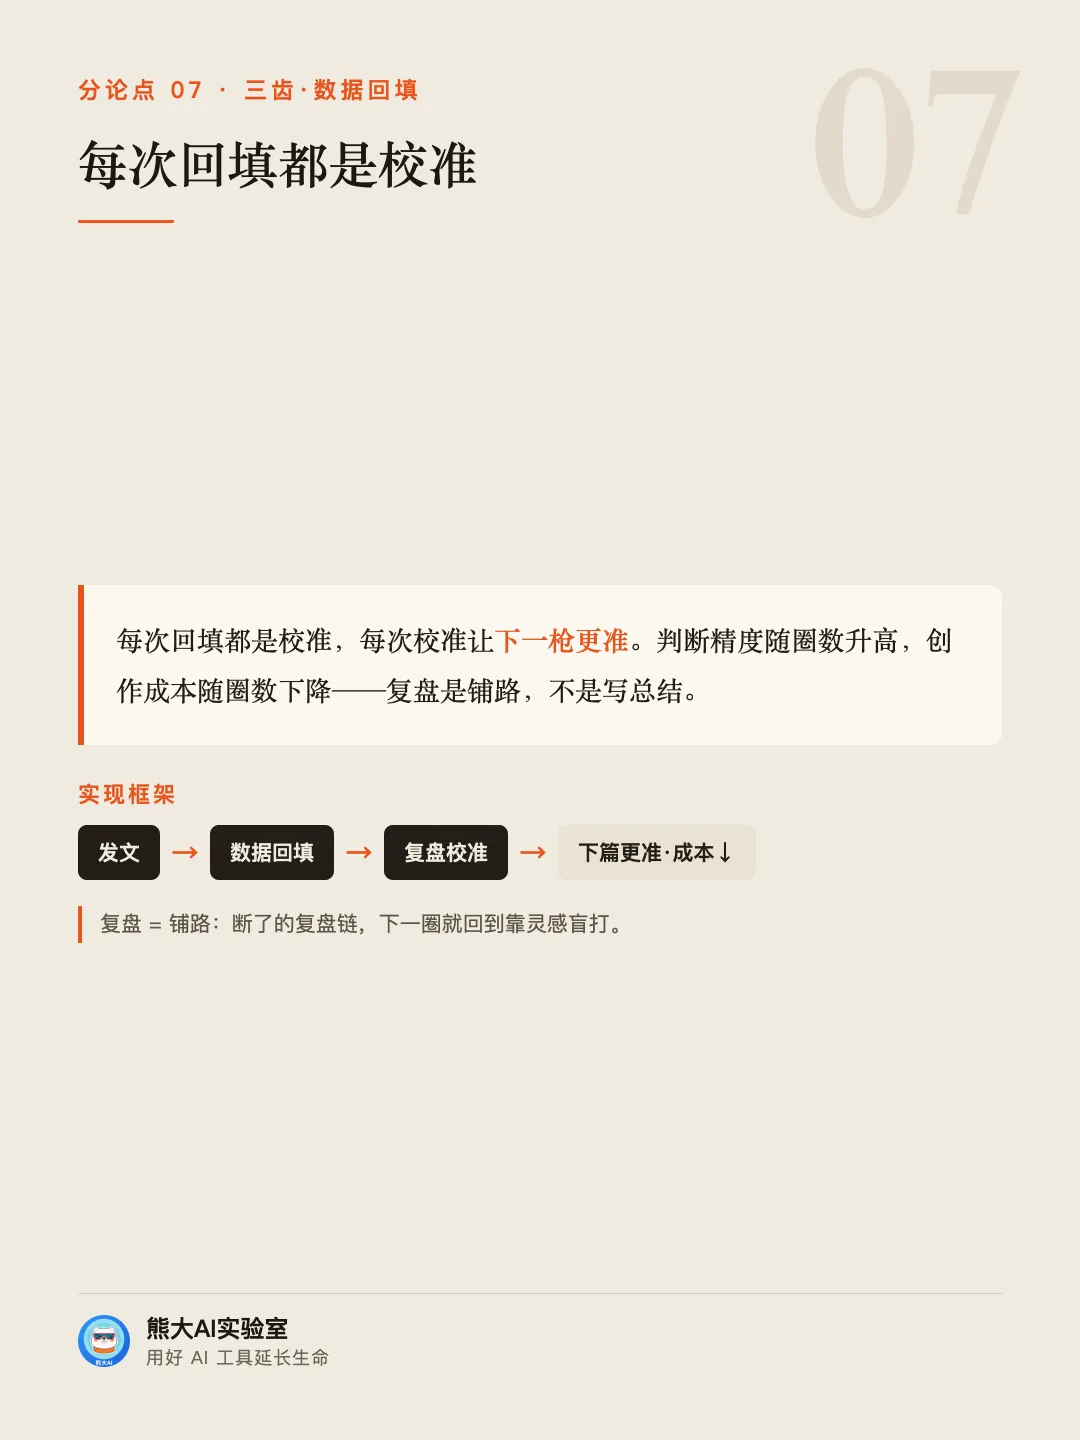
我们把 59 篇文章的真实数据:阅读、点赞、转发、收藏、评论、完读率、推荐率、收入....全部回填到腾讯文档复盘表里。不是截图,不是大概印象,是逐条精确到个位数。
回填之后干什么?复盘。
这篇文章当时 AI 打分是几星?实际数据跑出来匹配吗?如果打了 4 星结果阅读量扑街,问题出在哪?如果打了 3 星结果意外爆了,是哪个维度被低估了?
每一次回填都是一次校准,每一次校准都让下一次打分更准。
不复盘的人永远在靠蒙。蒙对了一次觉得是实力,蒙错了觉得是运气。复盘的人,每一篇都在为下一篇铺路。
数据不是用来看的,数据是用来校准下一枪的。
爆款拆解 + 经验沉淀,让经验长回去,喂下一代选题
这是飞轮最关键的一齿,也是大多数人从来不做的。
爆款拆解 + 经验沉淀。
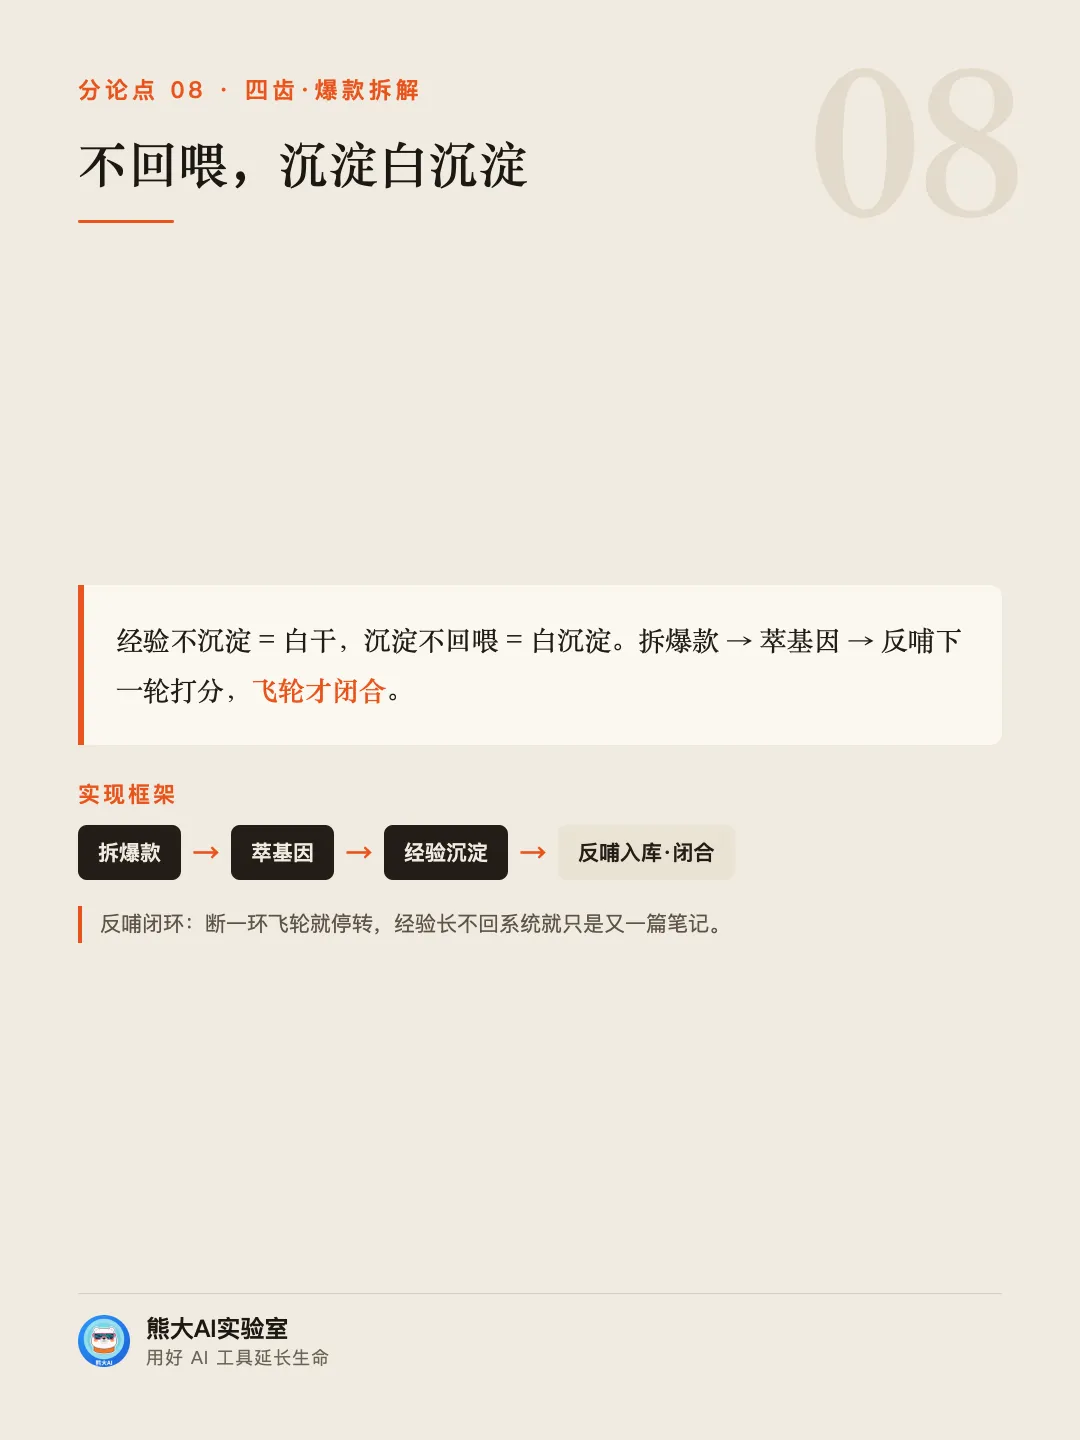
我们从复盘数据里挑出表现最好的文章,做 13 维拆解——标题结构、开头钩子、段落节奏、情绪曲线、金句密度、案例类型、结尾升华……每个维度单独拉出来看。
拆完之后不是放进收藏夹吃灰,是萃取成经验条目,写回腾讯文档爆款拆解经验库。
目前这个库里有 21 条经过验证的拆解经验。每条经验都带着「这篇文章为什么爆」的完整归因。
这些经验反过来变成下一代选题的评判标准。
比如拆解发现「身份对比」维度高的文章,转发率平均高出 40%,那下一轮 AI 打分的时候,「身份对比」的权重就要往上调。比如发现「开头用反问句」的文章完读率明显高于「开头用陈述句」,那下一篇文章的开头就优先用反问。
这就是"反哺",你的每一条经验不是躺在笔记本里,而是活过来,直接参与下一轮创作的决策。
别人的知识库是仓库,越堆越乱。你的知识库是飞轮,越转越快。
经验不沉淀,等于白干。经验沉淀了但不回喂系统,等于白沉淀。
飞轮四齿咬合,越转越大
到这里,四个齿全部讲完了。把它们咬合在一起看:
素材入库(抓)→ AI 打分(筛)→ 数据回填(验)→ 爆款拆解(萃)→ 经验沉淀(反哺)→ 回到素材入库(再抓)
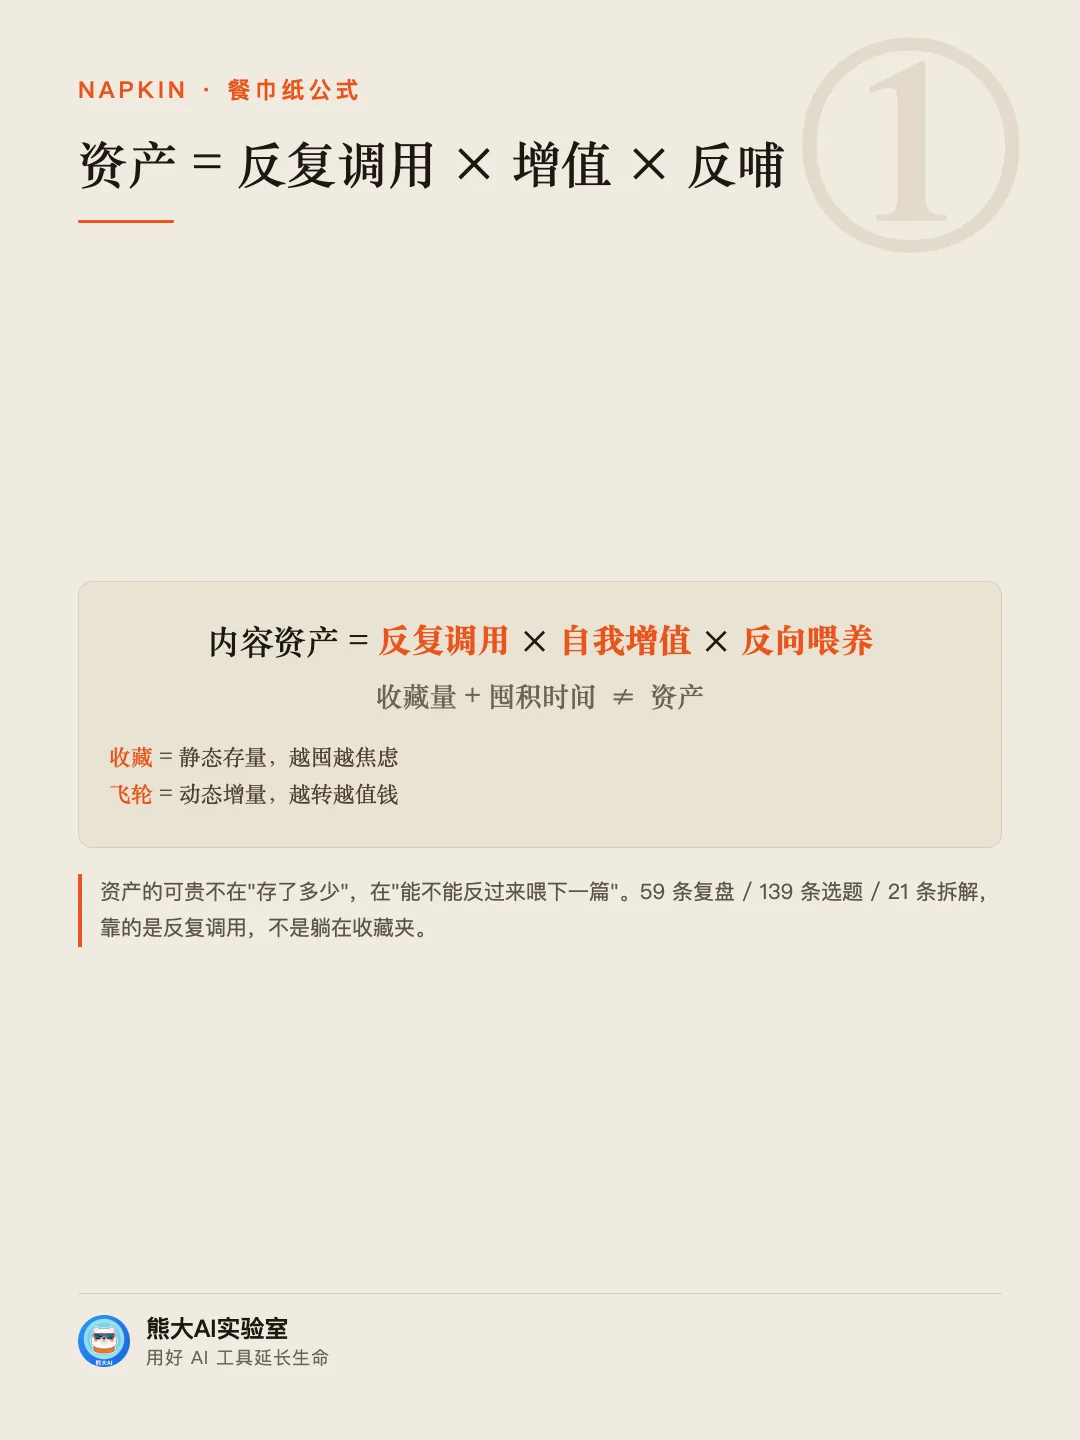
这就是一个完整的闭环,一个自我喂养的飞轮。
它每转一圈,会发生三件事:
1. 选题质量上升:上一轮的经验校准了这一轮的打分标准 2. 判断精度上升:上一轮的数据验证了这一轮的预判能力 3. 创作成本下降:上一轮沉淀的拆解经验,让这一轮不用从零想
而且因为所有数据都在云端腾讯文档里,这个飞轮不会因为换电脑、清缓存、软件崩溃而停下来。它 24 小时在那里,你随时接上去,随时继续转。
飞轮最可怕的地方不是它转得快,是它停不下来。每转一圈,你和「靠灵感写作的人」之间的差距就拉大一圈。
4 个真实踩坑:每一个都是拿钱买不到的教训
讲得再好,不如把踩过的坑亮出来。以下 4 个坑,是我们在跑通这套系统的过程中真实撞上的,每一个都让数据出过问题。
坑 1:合并打分退化,取到了最旧的数据。
同一篇文章,本地有快照、云端有快照,合并的时候系统“先到先得”,结果取到了 9 月 14 号的旧数据,阅读数差了一大截。
教训:跨源同篇合并,必须取「阅读数最大」的那条,而不是「最先遇到」的那条。
坑 2:只补齐不覆盖,旧值永远挡住新值。
本地存了一条旧数据,云端来了更新,但系统只「补齐空字段」不「覆盖已有值」,导致旧数据永远不被更新。
教训:数据同步不能只「补」,必须「以权威源为准覆盖」。我们最终确认了:老板桌面备份 = 最高权威。
坑 3:互动率字段映射错误。
把「traffic」字段当成了互动率来算,结果数据全偏。查了半天发现,traffic 是流量主收入(元),互动率的正确公式是(赞+转+藏+评)÷ 阅读 × 100。
教训:字段映射必须逐一验证,不能靠「差不多」猜。
坑 4:同名多快照,取数退化成「先到先得」。
同一个选题在不同时间有多个快照,系统按「非空字段数」打分选快照,结果退化成了先到先得。
教训:同名多快照,必须取「阅读最大」者作为权威版本。
这四个坑有一个共同规律:数据合并和同步的逻辑,必须有一条明确的「权威优先级」。没有这条线,数据就乱;有了这条线,系统才可信。
会建飞轮的人,淘汰只会收藏的人
说回开头那台机器。
万尼瓦尔·布什 80 年前就在想:怎么把人的记忆外挂到一台机器里?他的答案是 Memex。我的答案是:一张腾讯文档表,一个能连它的工作台,一条云端通道。
工具变了,但那个核心命题没变:你的经验值不值钱,取决于它能不能被反复调用、能不能自我增值。
个人层:你的内容资产
这套飞轮意味着你写的每一篇文章、踩的每一个坑、验证的每一个判断,都不会白费。它们沉淀在云端,变成你下一篇内容的弹药。
别人写文章是消耗,你写文章是积累。
团队层:经验不随人走
飞轮意味着经验不再锁在某个人的脑子里。任何一个人离开,系统还在。任何一个人加入,站在前人 59 条复盘、21 条拆解经验的肩膀上开始。
技术人走了,代码还在。内容人走了,选题库还在。老板不用慌,因为资产在云端,不在人脑里。
时代层:AI 时代的生存技能
AI 拉平了「写」的能力门槛。以前你文笔好就能赢,现在 AI 谁都能写出 80 分的文字。真正的分水岭变成了:谁有持续进化的知识系统,谁能把每一次创作的经验喂回系统里让下一次更强。
收藏是农业时代的动作,飞轮是工业时代的引擎。AI 时代,信息囤积者正在被信息炼金者碾压。
会建知识飞轮的人,淘汰只会收藏的人。
你不需要写代码,不需要数据库,不需要懂 API。
一张腾讯文档表,一个能连它的工作台。
内容资产,自己长大。
-END-
点击👇下方卡片关注熊大AI实验室,加★星标