ARTICLE · 1026228
腾讯开源的文档神器:AI 自己维护知识库
企业内部的知识库,问题从来不是"文档不够多",而是"文档太多、太乱,没人整理"。PDF、Word、表格、飞书文档散落各处,真到要查一个东西的时候,要么搜不到,要么翻出来的是三年前的旧版本。更尴尬的是,现在把文档喂给大模型,它有时能答对,有时一本正经地编造——因为检索没到位,模型只能靠"印象"硬答。
腾讯开源的 WeKnora,想解决的正是这件事。它不只是一个"文档问答"工具,而是把"检索、推理、整理"三件事串成一个能自己转起来的知识系统。
项目地址:https://github.com/Tencent/WeKnora
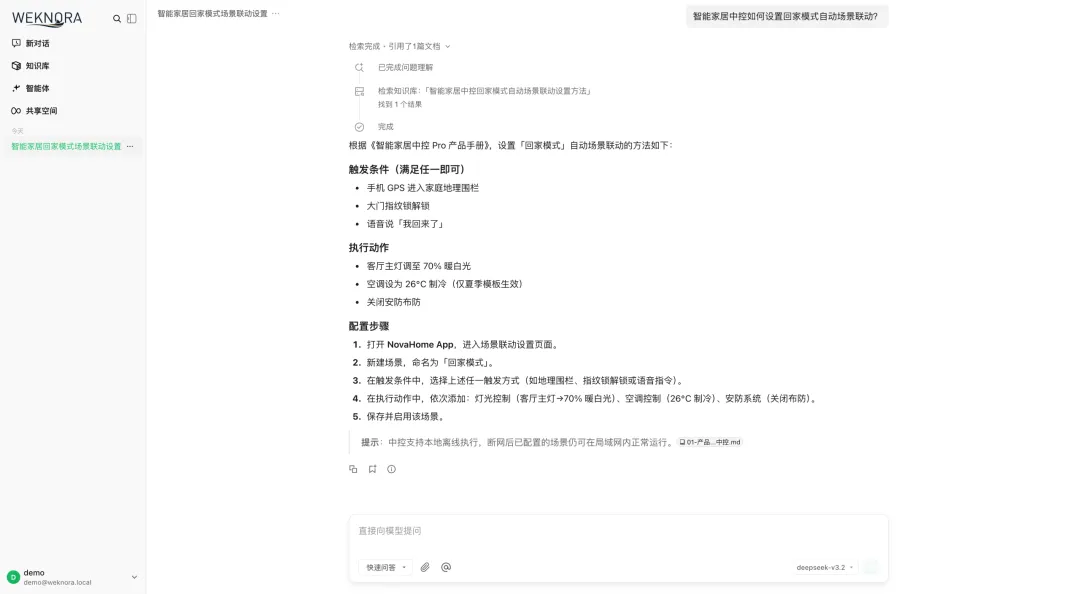
不只是检索,它会自己拆问题
大多数 RAG 工具的套路是:把文档切成块,用户提问时做向量检索,把最像的几段塞给模型,让模型照着答。这条路在简单问题上够用,但遇到"帮我把这几份文档里的数据对比一下、再给出结论"这种多步任务,就卡住了。
WeKnora 在这个基础上多了一层:一个基于 ReAct 的自主推理 Agent。问它复杂问题时,它不是直接返回检索结果,而是自己规划步骤——先去知识库里查,查不到就调 MCP 工具或联网搜索,中间如果信息不够,再回头补充检索,最后才给出结论。整个过程是可追溯的,接了 Langfuse 之后,每一步推理、每一次工具调用、消耗了多少 token,都能在面板上看到。
这种"会自己想办法找答案"的能力,让它从"检索器"变成了真正能干活的助手。
会自己更新的 Wiki,才是它的杀手锏
最值得说的是它最近主推的 Wiki 模式。传统知识库是"人写、机器存",文档更新了,还得有人手动去改百科页面,久而久之就没人维护了。
WeKnora 的 Wiki 模式反了过来:把原始文档丢进去,Agent 会自动把这些散乱的资料提炼成一篇篇互相关联的 markdown 页面,还带知识图谱和版本历史。文档改了,Wiki 跟着更新;发现写错了,还能一键回滚。等于让 AI 自己当那个"整理文档的编辑",人只需要负责上传原材料。
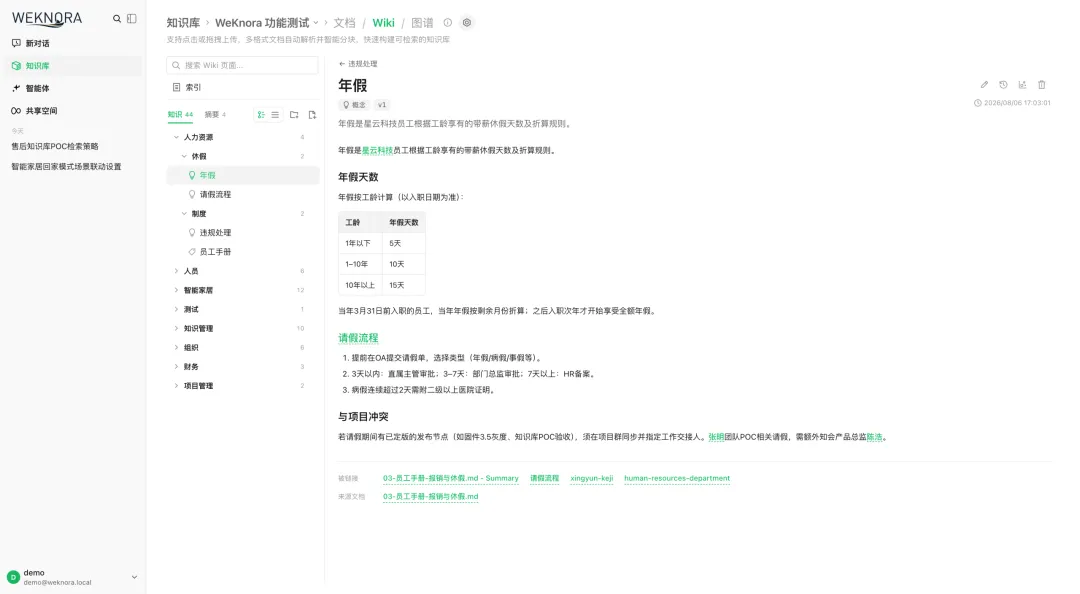
这个方向的意义在于:它把知识库从"一次性建设"变成了"持续自维护"。对文档一直变、又没人愿意天天整理的团队来说,这是真正踩到痛点的功能。
适合谁用
WeKnora 的模块化设计给得很足:模型可以换(OpenAI、DeepSeek、Qwen、Gemini、MiniMax、Ollama 都支持),向量库可以换(pgvector、Milvus、Elasticsearch 等),存储也可以换,本地或私有化部署都能做,数据主权在自己手里。支持 PDF、Word、图片、Excel 多种格式,还能直接通过企业微信、飞书、Slack 这类 IM 渠道提问。
截止目前它在 GitHub 上有 25420 Star,今天一天涨了 1197,这个增速放在 RAG 赛道里算是相当能打。背靠腾讯、MIT 开源协议,加上文档解析、Agent 推理、自我维护 Wiki 这套完整闭环,很适合那些"文档多、想搭企业级知识库、又在意数据不出门"的团队。
要说它不适合谁,大概是只想做个轻量个人问答、连 Docker 都不想碰的人——它的定位从一开始就是企业级知识平台,轻量场景反而显得重。
项目地址:https://github.com/Tencent/WeKnora
📌 往期推荐
如果觉得有用,可以点个 关注 和 推荐,也欢迎 转发