ARTICLE · 1026365
【C&E】小学阅读中学生自主提问的自动评分:一种机器学习方法
01
核心摘要
学生自主提问(SGQ)能够促进认知投入,但由于缺少标准化指导,人工评分耗时耗力,对自主提问质量的评估一直存在很大挑战。自动评分有希望解决上述难题,并提供及时反馈。本研究探究利用机器学习(ML)评估学生自主提问质量的可行性,对比两种技术路线:(1)基于可解释语言特征的特征工程模型;(2)基于预训练词嵌入的深度学习模型。
研究被试为 265 名 3‑8 年级学生。学生阅读文本后自主生成问题。本研究采用分类评价指标与二次加权卡帕系数对模型开展评估。深度学习模型准确率达到 84%,评分结果高度接近人工打分。特征工程模型可解释性更强,但性能相对偏低。研究结果表明,自动评分技术可用于评估阅读任务中学生自主提问的质量;面向教育实际应用,开发与评分量规对齐、具备可解释性的模型十分关键。
02
研究问题
研究问题 1:以准确率、精确率、召回率、F1 分数为指标,自动评分模型对学生自主提问质量的分类效果,相较于人工打分表现如何?
研究问题 2:使用二次加权卡帕系数衡量,自动评分与人工评分的一致性达到什么水平?
研究问题 3:在特征工程模型中,哪些语言特征对模型评分决策影响最大?
03
研究方法
1. 研究对象与数据采集
研究对象:被试共 265 名 3‑8 年级学生,平均年龄 10.47 岁
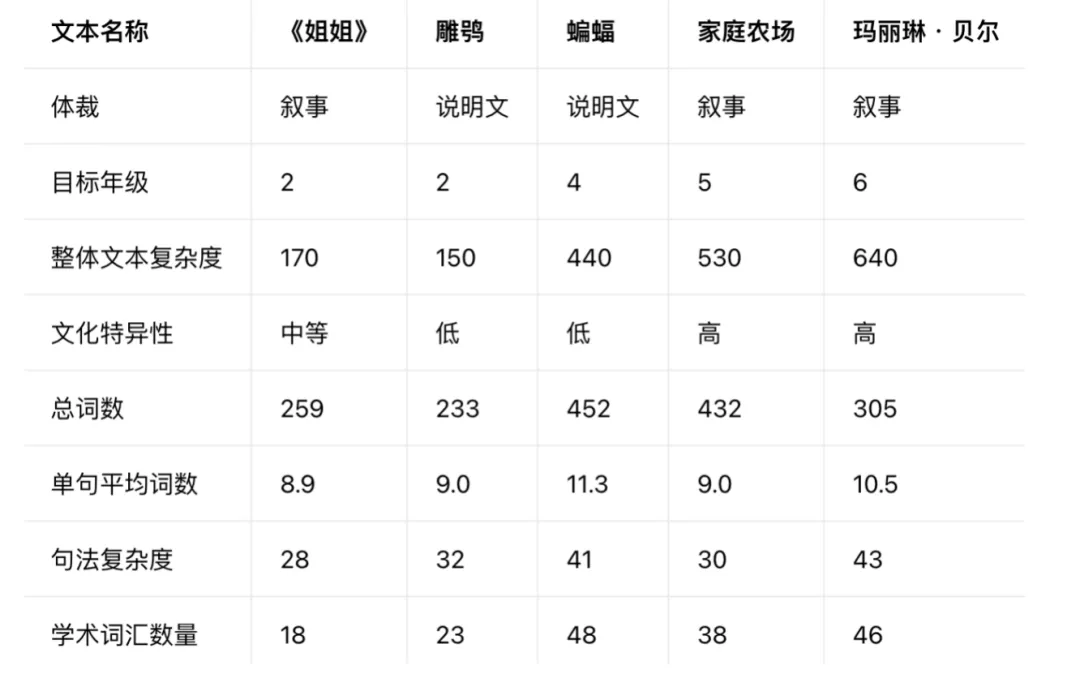
试题:5 篇阅读文本。每篇阅读都回答下面的问题:基于刚刚读到的内容,你想要提出哪三个问题?
2. 评分方式
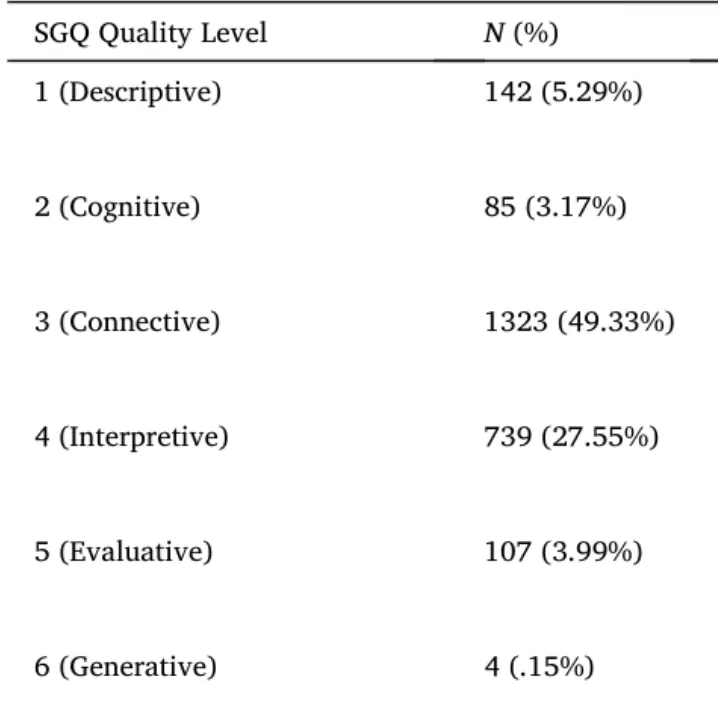
采用 6 等级整体评分量规人工打分,评估学生针对叙事、说明文生成问题的质量。(分数 1‑6 分)
整体量规基于布鲁姆分类法划分:
1描述性(字面复述)、2认知性(推理澄清)、
3联结性(文本结合已有知识经验)、
4解释性(分析主题、意图、逻辑关系)、
5评价性(批判性反思、做出评判)、
6生成性提问(整合观点,拓展文本边界)
3. 模型选择
本研究搭建两类监督学习分类模型用于评估自主提问质量:
1特征工程机器学习模型:多项式逻辑回归、线性支持向量机 SVM。
2深度学习模型:BERT 词嵌入模型、OpenAI 词嵌入模型。
全部模型基于 Python 实现;深度学习模型使用 PyTorch 框架。数据集划分:训练集 80%、验证集 10%、测试集 10%。
04
研究结果
1. 描述性统计
计算方法:均值、分布、皮尔逊相关系数
研究结论:1 深度学习模型输出得分和人工评分高度接近,特征工程模型偏离较大。2 SGQ质量和学生整体文本理解有微弱联系,但很大程度独立于普通阅读能力
2. RQ1 探究自动评分模型相对于人工金标准的分类准确率
计算指标:准确率、精确率、召回率、F1 分数
研究结论:深度学习模型整体表现最优。(BERT嵌入准确率 0.84)
3. RQ2 计算自动评分与人工评分之间的一致性
计算方法:QWK
研究结论:1 机器‑人工评分的 QWK 从 0.83‑0.93,处于较高一致性区间。2 深度学习模型一致性最优
4. RQ3 探究特征工程模型哪些语言特征对评分决策影响最大
计算方法:SHAP 可解释性分析
研究结论:主要受三类可解释特征影响:问句形式(影响力最高)、词汇特征、句法复杂度。
05
研究结论与启示
1. 基于预训练词嵌入的深度学习模型,无论准确率还是可靠性,都可以高度复刻人工评分;而特征工程模型的优势在于可解释性。
2. 自动评分可以捕捉和认知投入相关的语言可观测信号,但不能把提问质量完全简化为表层语言特征。
3. 深度学习预测性能更强,但可解释性不足,制约在重视可解释性、教师信任的教育场景落地。特征工程模型准确率略低,但输出具备可解释,服务教学决策与形成性评估。两条路线结合,教育场景既可以获得准确预测,又得到有教育意义的解释。
06
文献来源
[1]Kim, H., Ignacio, A., & Jang, E. E. (2026). Automated scoring of young learners’ student‑generated questioning in elementary reading: A machine‑learning approach. Computers & Education, 252, 105674. https://doi.org/10.1016/j.compedu.2026.105674