ARTICLE · 1029086
AI 不该每次失忆:12k Star 的 MemOS,让 Agent 跨工具记住项目,Token 消耗最高省超 80%
开源 Agent 记忆系统解读:Codex、Claude、DeepSeek 接入教程、提示词与关键命令
大家好,欢迎来到心眸AI笔记,我是jackli!今天日期是2026年9月17日,周四快乐,下面带来今日资讯。
懒人总结
开源 Agent 记忆项目 MemOS 已在 GitHub 获得 12k star,目标很明确:解决 Agent 每次新会话上下文清零、经验无法沉淀的问题。 接入记忆后,作者归纳出四个直接收益:比 Skill 更轻松地沉淀经验、持续跟踪项目进度和客户画像、新开对话不用反复复述要求、大幅节省 Token。 接入路径不复杂:先去 memos-dashboard.openmem.net 注册并获取 API Key,再安装 @memtensor/memos-cloud-cli,最后用 memos init给 Codex、Claude、DeepSeek 等 Agent 配置。给 Codex 的完整 Prompt、验证命令、初始化命令都要保留;API Key 只能在本机终端隐藏输入,不能进入对话或日志。 记忆不是简单存聊天记录。作者实测发现,做完一个项目后让 Agent 梳理“可复用规则”,才能把客户偏好、PPT 思路、排版表达逻辑沉淀下来。 记忆可以跨 Agent、跨项目复用。从 Codex 换到 Claude,或者新开文件夹继续做任务,Agent 能在计划阶段就调用已有记忆。 要求变了,记忆也能更新。可用 memos feedback命令修改规则;但旧文件不会自动变,仍要重新生成或修改。官方在 LoCoMo 长期对话记忆评测中给出数据:相比 OpenClaw 原生记忆,MemOS 的 Token 消耗减少超过 80%。
一、Agent 的“失忆症”,终于有解了
用 Claude、Codex、OpenClaw 或 Deepseek Harness 的人,大多遇到过同一个尴尬:每次新开会话,上下文清零。之前确认过的项目前提、客户偏好、经验归纳,统统要重来一遍。
这不是小麻烦。项目越复杂,重复沟通越贵。时间被吃掉,Token 也在燃烧。
GitHub 上有个开源项目叫 MemOS,目前已经拿到 12k star。它想解决的,就是 Agent 记忆问题。作者在文章里以 Codex 为例演示接入,其他 Agent 的逻辑基本一致。
接入后,效果可以概括为四点:
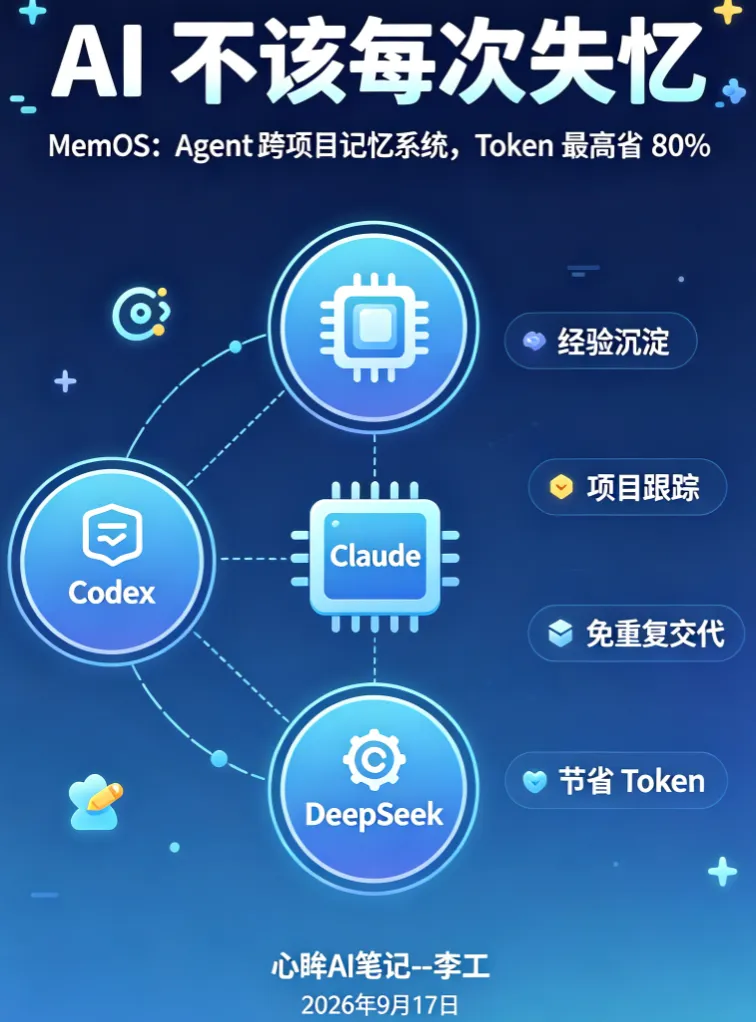
比 Skill 更轻松的经验沉淀; 项目进度和客户画像持续跟踪; 每次新开对话不需要再复述以前的要求; 大幅节省 token 消耗。
最后一点,最实在。
二、第一步:获取 API Key
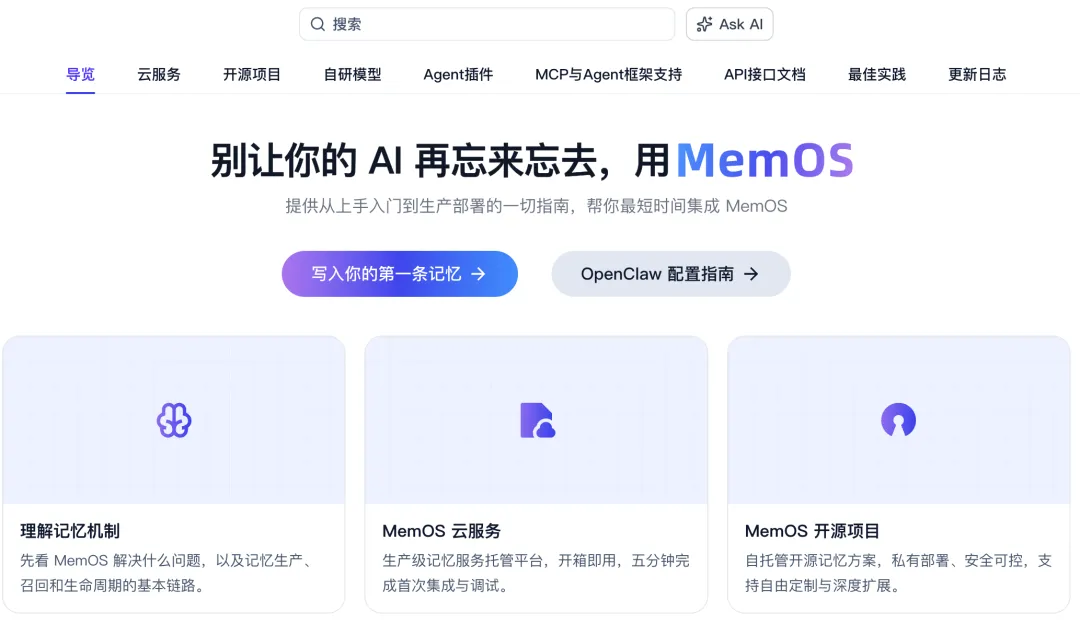
访问 memos-dashboard.openmem.net,注册并登录。找到 API Key 的创建入口,生成一个 Key,保存好。
这里要注意:Key 留着稍后在本机终端输入,不用粘贴进 Codex 对话。
三、给 Codex 安装配置 MemOS
打开 Codex,发送下面这段完整 Prompt:
请按 https://github.com/MemTensor/MemOS-Cloud-CLI 为当前Codex安装配置MemOS,直接执行并验证。
1. 检查Node.js、npm和memos,补齐环境;缺CLI时运行 npm install -g @memtensor/memos-cloud-cli,检查版本与帮助。
2. 先备份配置,沿用已有Key和user_id,没有user_id则用 memos_article_demo。初始化后对照备份,保留无关设置。
3. 用确定的user_id执行 memos init --agent codex --user-id 实际标识。缺Key时先把命令交给我在本机终端隐藏输入,回复“已完成”后核验,不再重复初始化。Key不得进入对话或日志。
4. 检查接入配置,用 memos_search "MemOS连接检查" --format json 验证请求。报告版本、user_id、结果及重启步骤,自动检索和写入留待新会话验证。
如果缺少 Key,在本机终端运行:
memos init --api-key YOUR_API_KEY --agent codex
把 YOUR_API_KEY 替换成前面获取的 API Key。配置完成后,终端会返回内容。再回 Codex 回复“已完成”,配置就完成了。
四、多个 Agent 共用一套记忆
如果多个 Agent 都要共用记忆,各自配置一下即可:
memos init --agent claude | |
memos init --agent deepseek |
配置逻辑一致,换 Agent 不等于换记忆。
五、记忆沉淀:留下真正用得上的东西
作者实测发现,做项目时,一个客户基本会做 4、5 个 PPT。每次做新的 PPT,听众是谁、喜欢什么版式、上次改过哪些地方,都要重新交代。
更有效的做法是:正常做一个 PPT,过程中多轮交互,产出满意版本后,再向 Agent 发送指令:
请你仔细检查做这个 ppt 的过程中,我和你讨论的一些做这个类型 PPT 规则。为我梳理有哪些适合放入 MemOS 中的,未来我可以进行复用的的记忆。
梳理出多种层次的记忆后,让 Agent 存储起来。后台可以看到记忆列表。
记住的主要部分包括:项目对象画像是谁、这类 PPT 的思路、排版以及表达逻辑。这些不是一次性聊天记录,而是下次还能用的规则。
六、跨 Agent、跨项目复用记忆
有开发者实测后,新开一个文件夹,在已经配置好的 Claude 中发布任务,直接发需求。
在计划阶段,Agent 就已经把记忆抽出来,针对当前项目做计划,包括大纲逻辑、版式逻辑、色系等。随后,Agent 凭借记忆和当前资料做出设计方案。
第一版效果是:白底、蓝色分隔线、重点用红色提出来,风格统一;热力图、柱状图、流程图均使用。
记忆和模板在这里互相配合:模板提供具体版式和色值,记忆用来延续之前确认的制作要求,新资料决定这次讲什么。
七、记忆更新:要求变了,记忆跟着变
客户要把 PPT 拿到会议室讲,字要放大,页面太满要拆开。这时可以更新记忆。
在终端输入:
memos feedback "后续用于现场汇报的PPT,正文至少18pt,内容放不下时拆页;此前更小的正文字号要求不再适用于现场汇报。" --format json
也可以直接告诉 Agent。
但要注意:记忆更新后,旧 PPT 文件不会自己改变,要让 Agent 重新修改或制作。
跨工具延续也一样。从 Codex 换到 Claude 做过一次,以后继续换工具,就能接着查这份记忆。以前至少需要几天时间调一个精确的 Skill 出来,下次才能复现;现在只需要记住就好。
八、Token 省在哪?
第一份 PPT 来回聊了十几二十轮,改大纲、调版式、补结论,一点点磨成想要的样子。这些对话里藏着很多以后能用的东西:客户关心什么、哪种讲法更合适、什么地方必须给结论、做成什么样才算合格。
接上记忆后,交互过程自动记录,把确认过的要求整理好,留给后续任务使用。
做第二份 PPT 时,把新需求、新资料和模板交给 Agent,让它沿用之前的经验开始做。反复确认和返工减少,多轮对话消耗的 Token 就有机会省下来。
官方评测数据是:MemOS 在 LoCoMo 长期对话记忆评测中,相比 OpenClaw 原生记忆,**Token 消耗减少超过 80%**。
九、关键网址与命令清单
| memos-dashboard.openmem.net | |
| https://github.com/MemTensor/MemOS-Cloud-CLI | |
| memos-docs.openmem.net | |
npm install -g @memtensor/memos-cloud-cli | |
memos init --api-key YOUR_API_KEY --agent codex | |
memos init --agent claude | |
memos init --agent deepseek | |
memos_search "MemOS连接检查" --format json | |
memos feedback "后续用于现场汇报的PPT,正文至少18pt,内容放不下时拆页;此前更小的正文字号要求不再适用于现场汇报。" --format json |
十、思考与呼吁
作者在文末回顾时指出:一次次选择和修改,慢慢留下的,就是做事的方式。如果 Agent 能把这些积累带进下一次工作,知道哪些要求该沿用,也能在改变想法时跟着调整,才会觉得它越来越懂我。“世界上的另一个我”,也许就是这样一点点长出来的。
我的判断是,Agent 记忆不该被理解成“多存一点聊天记录”。它更像是把项目上下文、用户偏好、验收标准,变成可复用的资产。越早把记忆当成基础设施,越少在重复沟通里消耗时间和 Token。
如果你也在用 Codex、Claude 或 DeepSeek Harness,不妨按上面的步骤试一次。先接入,再沉淀,最后让记忆跨项目滚动起来。
如果这篇内容对你有帮助,欢迎点个赞、转发给需要的朋友,再点一下“在看”。要是方便,也顺手给心眸AI笔记加个星标⭐️,下次更新文章你就能第一时间见到。谢谢你读到这里,我们下篇再见。