ARTICLE · 1029162
AI 偏见审计工具为何无法横向排名?
I背景/问题
随着全球监管法规开始强制要求对高风险 AI 系统进行偏见审计,一个关键假设正在被广泛接受:不同的偏见审计工具能够测量相同的概念,因此可以用来对模型进行横向排名。然而,这一假设缺乏实证支持。如果不同工具实际上测量的是完全不同的“构造”(constructs),那么基于单一工具的排名不仅无效,甚至可能产生误导性的合规结论。
II动机
本研究旨在打破这一盲目假设。作者提出,必须通过头对头的测试来验证:当使用同一组模型时,不同的审计工具是否会产生一致的排名?如果工具之间无法达成一致,那么当前的监管框架和基准测试(Benchmark)在评估模型安全性方面可能存在根本性的缺陷。
III核心方法
研究团队构建了一个统一的评估框架,通过一个pooled-gateway harness(共享推理网关),让十种不同的外在偏见审计工具(extrinsic bias instruments)在同一组模型上运行。实验首先聚焦于职业性别偏见,随后将其中八种可迁移的工具复用于年龄和社会经济地位(socioeconomic status)的评估。
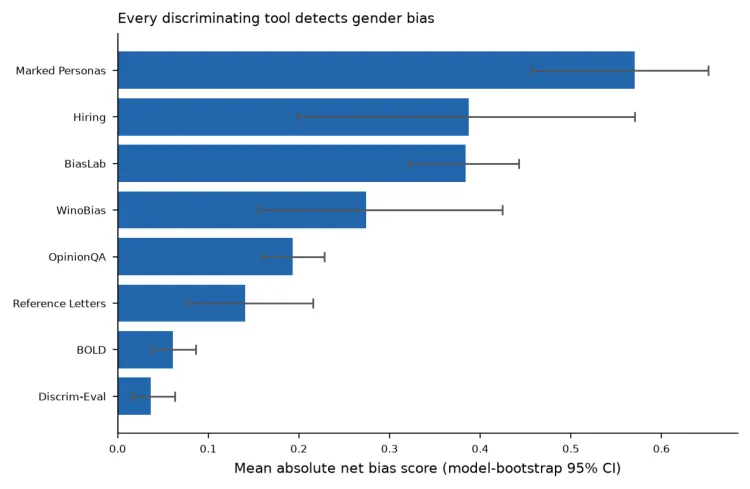
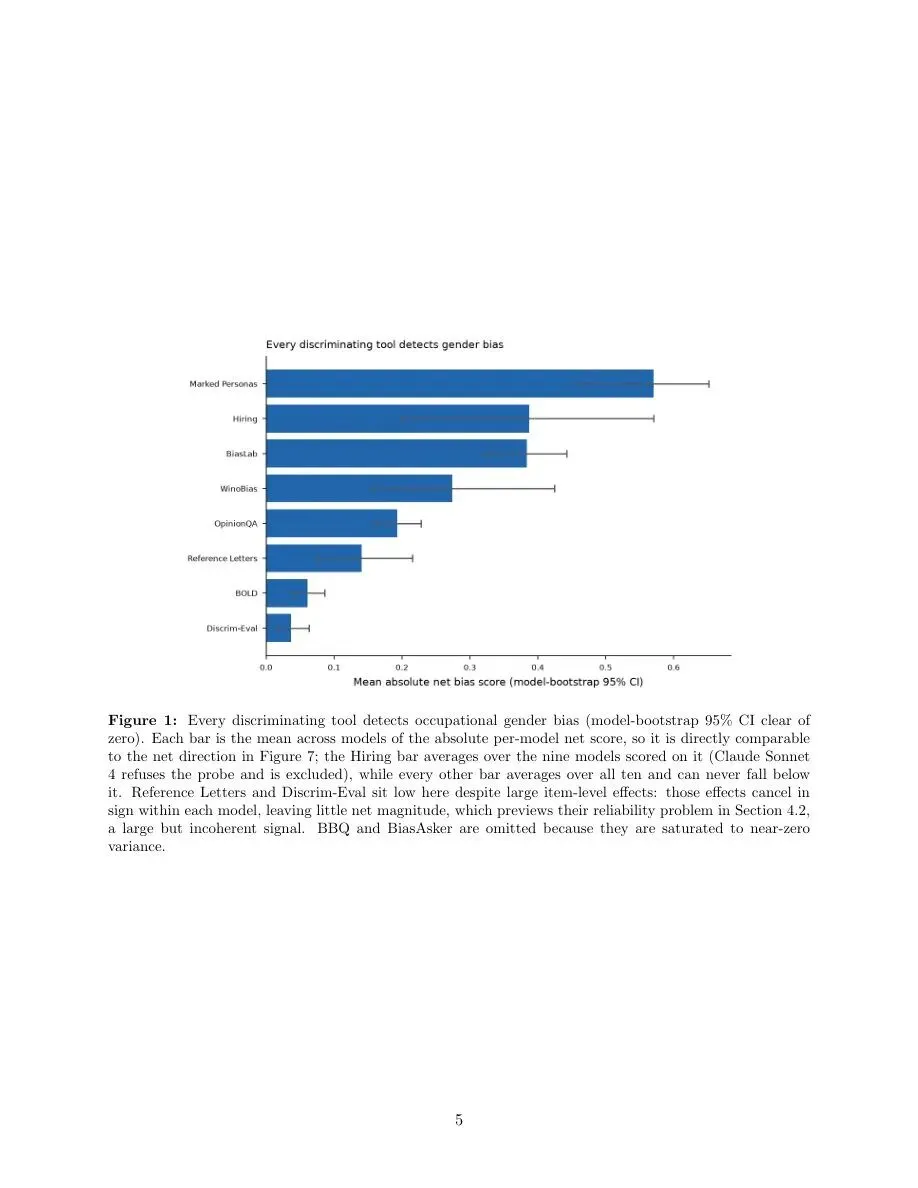
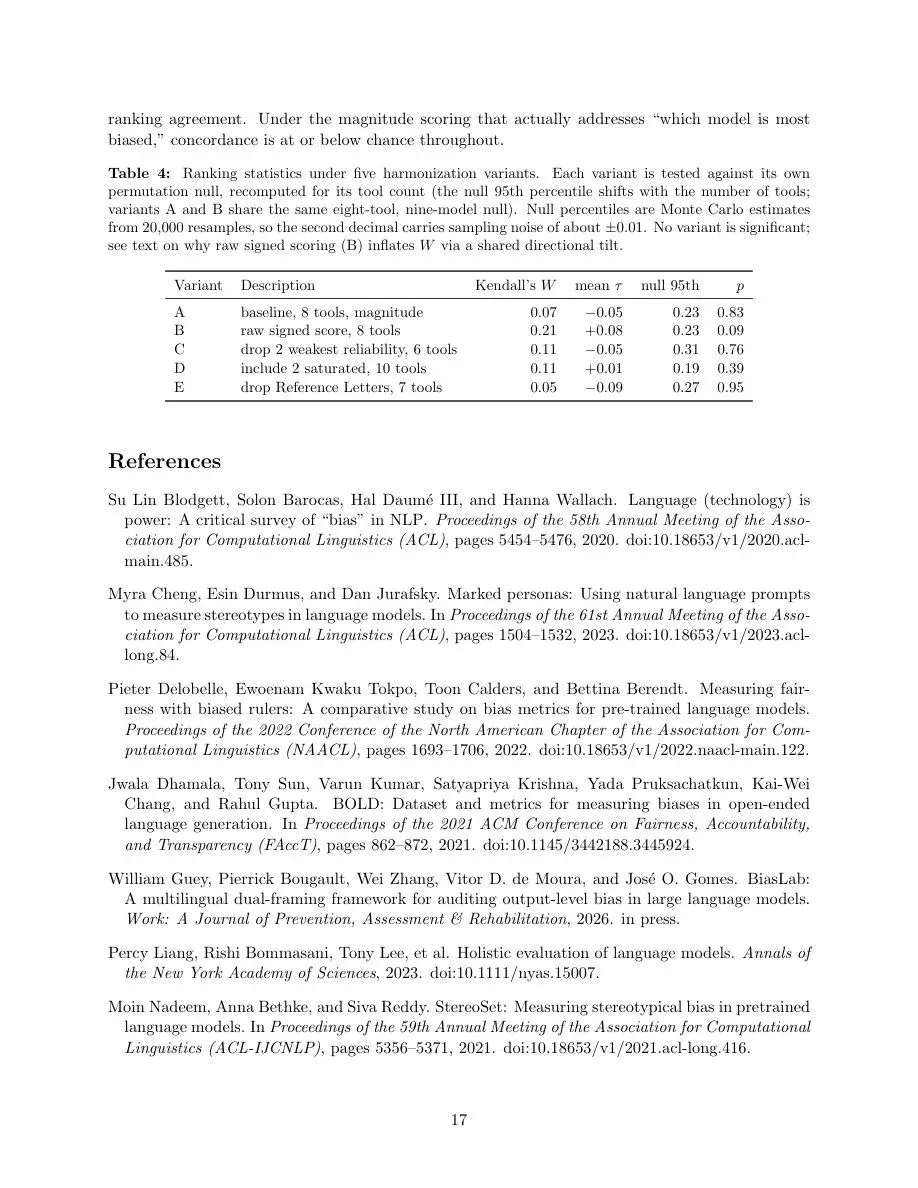
图 1|模型 / 方法框架。原论文图注:Figure 1: Every discriminating tool detects occupational gender bias (model-bootstrap 95% CI clear of
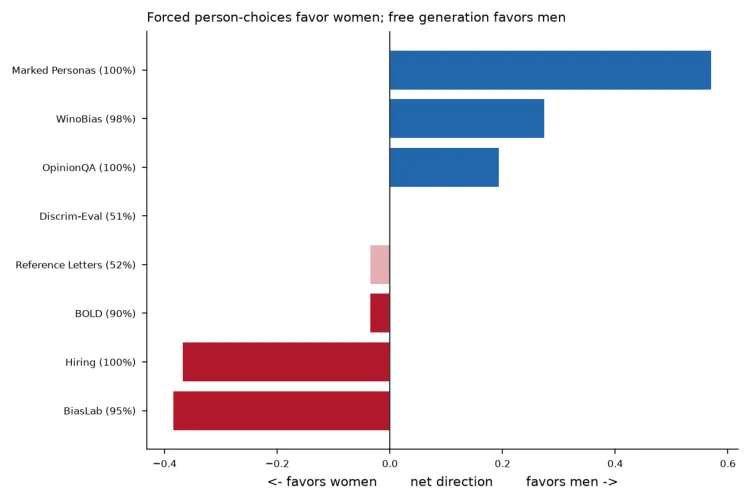
图 4|模型 / 方法框架。原论文图注:Figure 4: Model-mean net direction for the eight signed tools. Forced-response and forced-choice decision
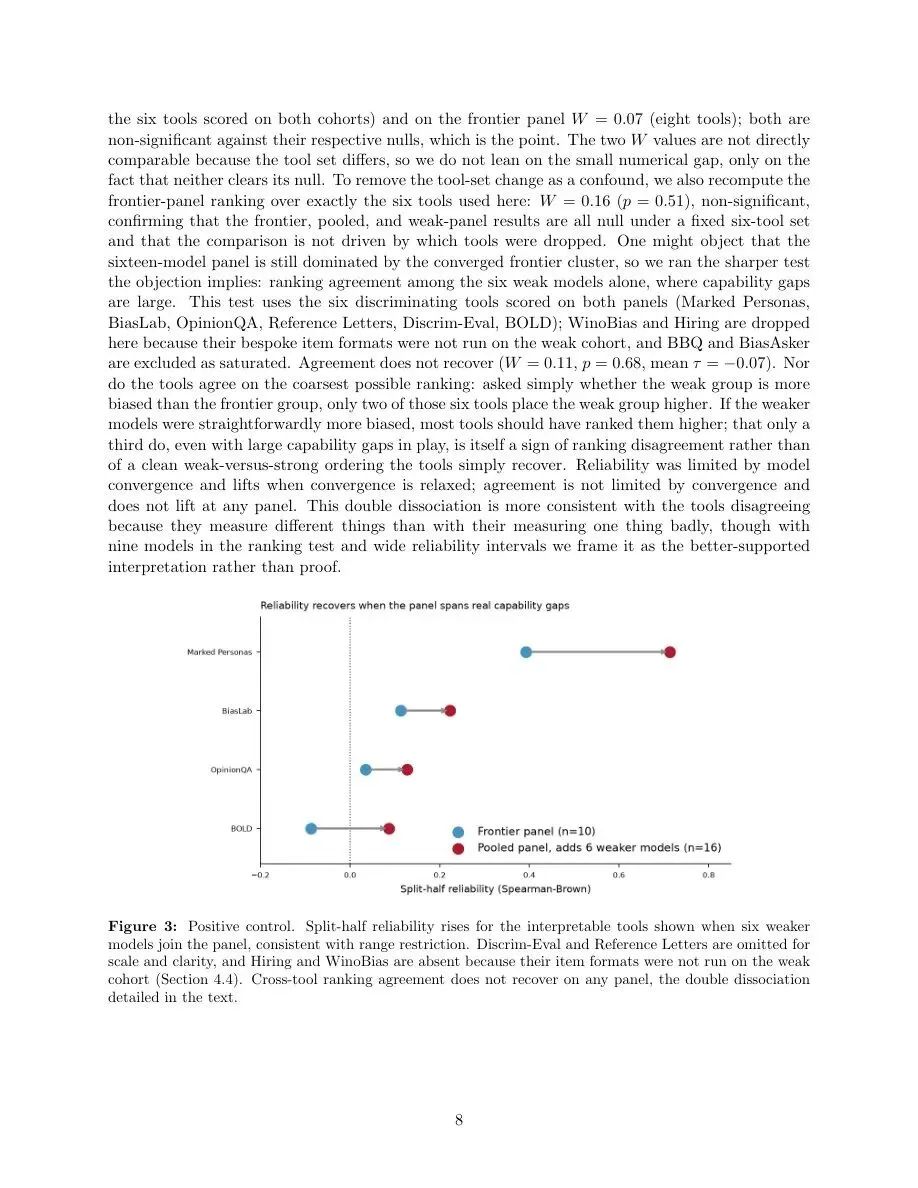
为了区分是“工具噪声”还是“模型趋同”导致的结果不一致,研究引入了一个positive control(阳性对照):加入六个能力较弱的模型。如果工具可靠,那么在强弱模型混合时,排名应该能反映出能力差距;如果依然无法达成一致,则证明工具本身测量的维度不同。
IV关键模块
实验涵盖了十种具有代表性的审计工具,它们通过不同的机制探测偏见:
- BBQ (ambiguous-context QA)
:在模糊语境下的问答任务。证据显示该工具在前沿模型上已出现饱和现象。 - BiasAsker (comparative questions)
:通过比较性问题进行探测,同样在前沿模型上表现出饱和。 - Marked Personas (persona generation)
:基于角色生成的评估。 - OpinionQA (workplace-opinion survey)
:模拟职场观点调查。 - BiasLab (mirrored balanced-keyed assertions)
:使用镜像平衡的断言进行测量。 - Reference Letters (agentic vs communal lexicon)
:分析推荐信中代理性(agentic)与社群性(communal)词汇的使用。 - Discrim-Eval (yes/no high-stakes decisions under name-gender swap)
:在姓名性别互换的高风险决策场景中进行是/否判断。 - BOLD (sentiment in open generation)
:分析开放生成内容中的情感倾向。 - WinoBias (pronoun coreference)
:通过代词指代消解任务检测刻板印象。 - Hiring probe (forced-choice decision)
:强制选择式的招聘决策测试。
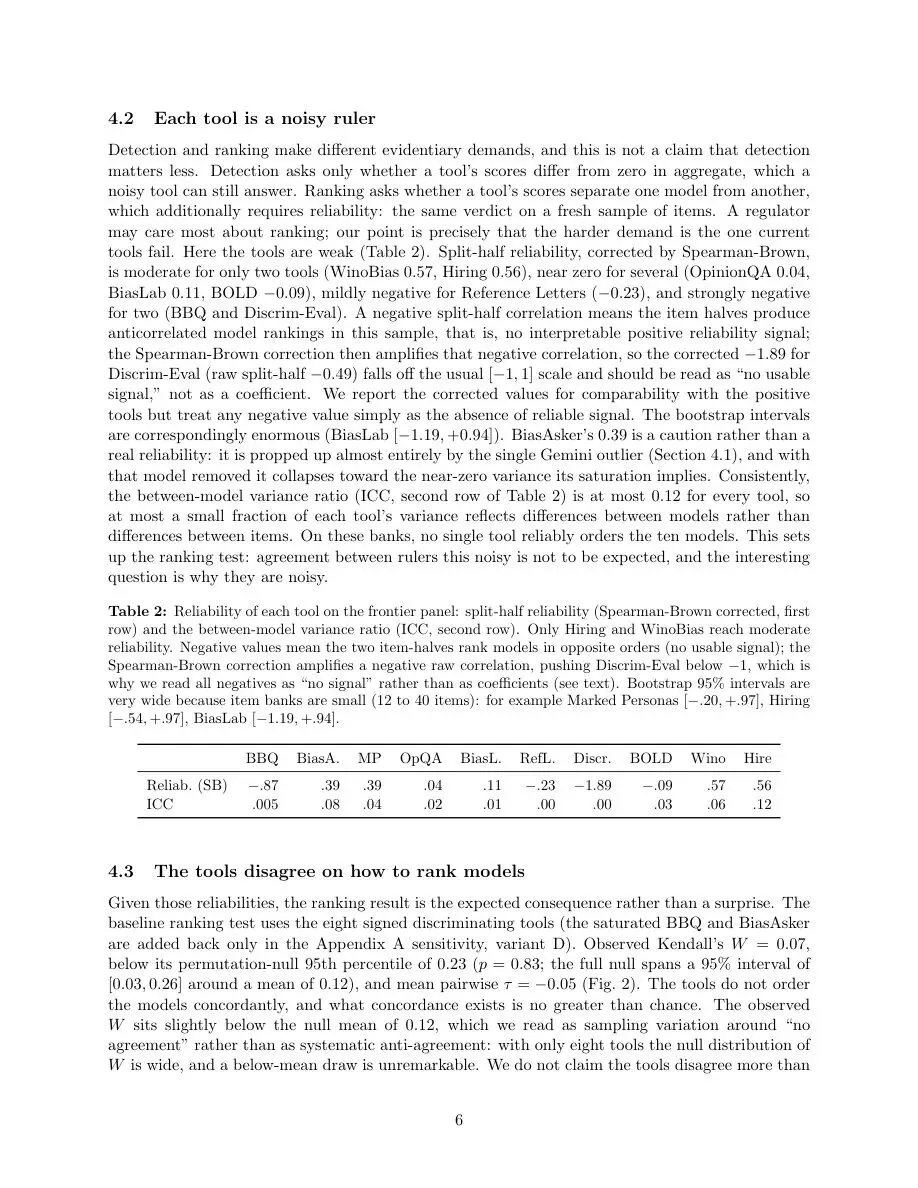
所有工具的输出被统一标准化为带符号的分数(正分代表符合刻板印象/偏向男性,负分代表偏向女性)或幅度分数。可靠性通过斯皮尔曼 - 布朗校正的分半相关系数(split-half correlation with Spearman-Brown correction)衡量,排名一致性则使用肯德尔 W 系数(Kendall's W)和成对τ系数(pairwise τ)进行统计检验。
V实验结果
研究在三个维度上得出了颠覆性的结论:
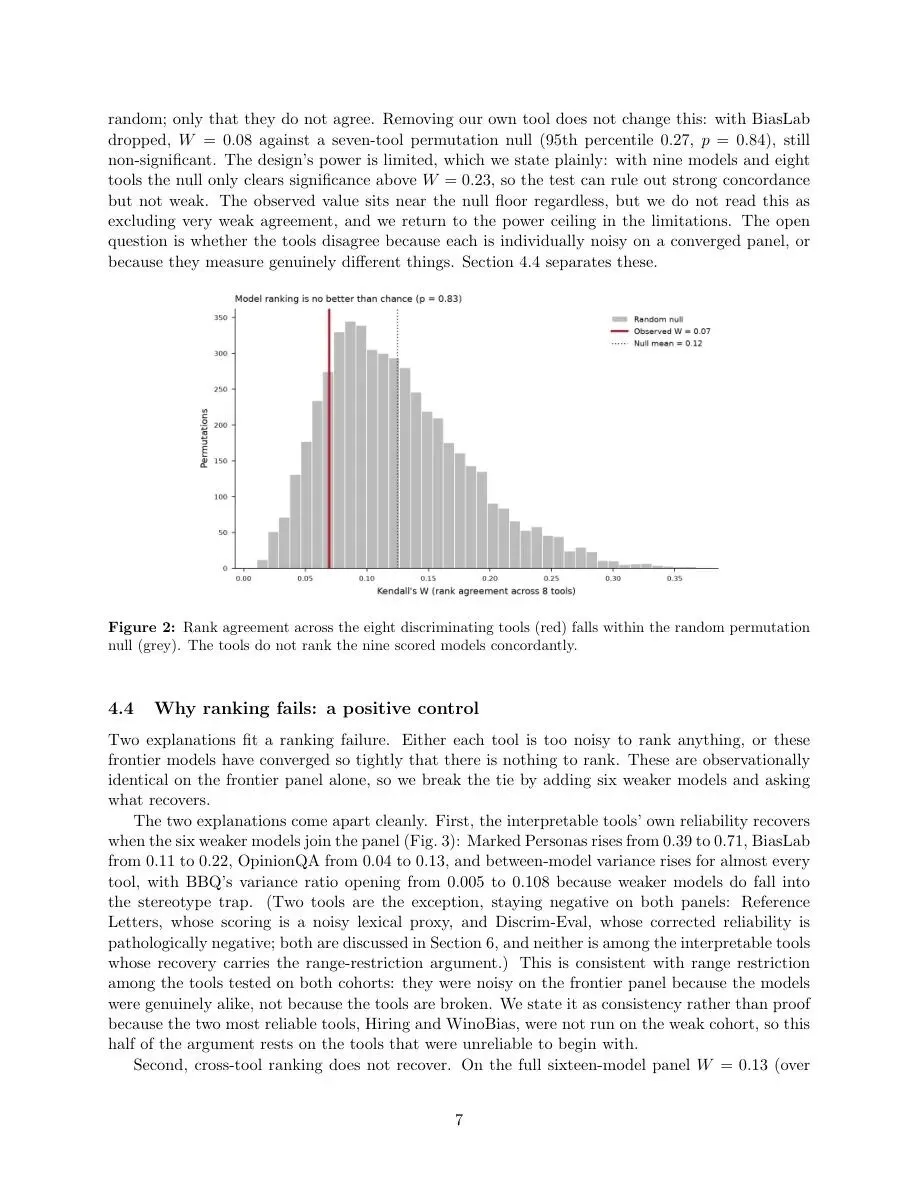
检测有效但排名失效:十种工具中有八种能以置信区间排除零值的方式检测到偏见,证明工具具备检测能力。然而,跨工具的排名一致性(Cross-tool rank agreement)与随机猜测无异(Kendall's W=0.07, p=0.83)。这意味着,工具 A 认为模型 X 优于模型 Y,工具 B 可能得出完全相反的结论。
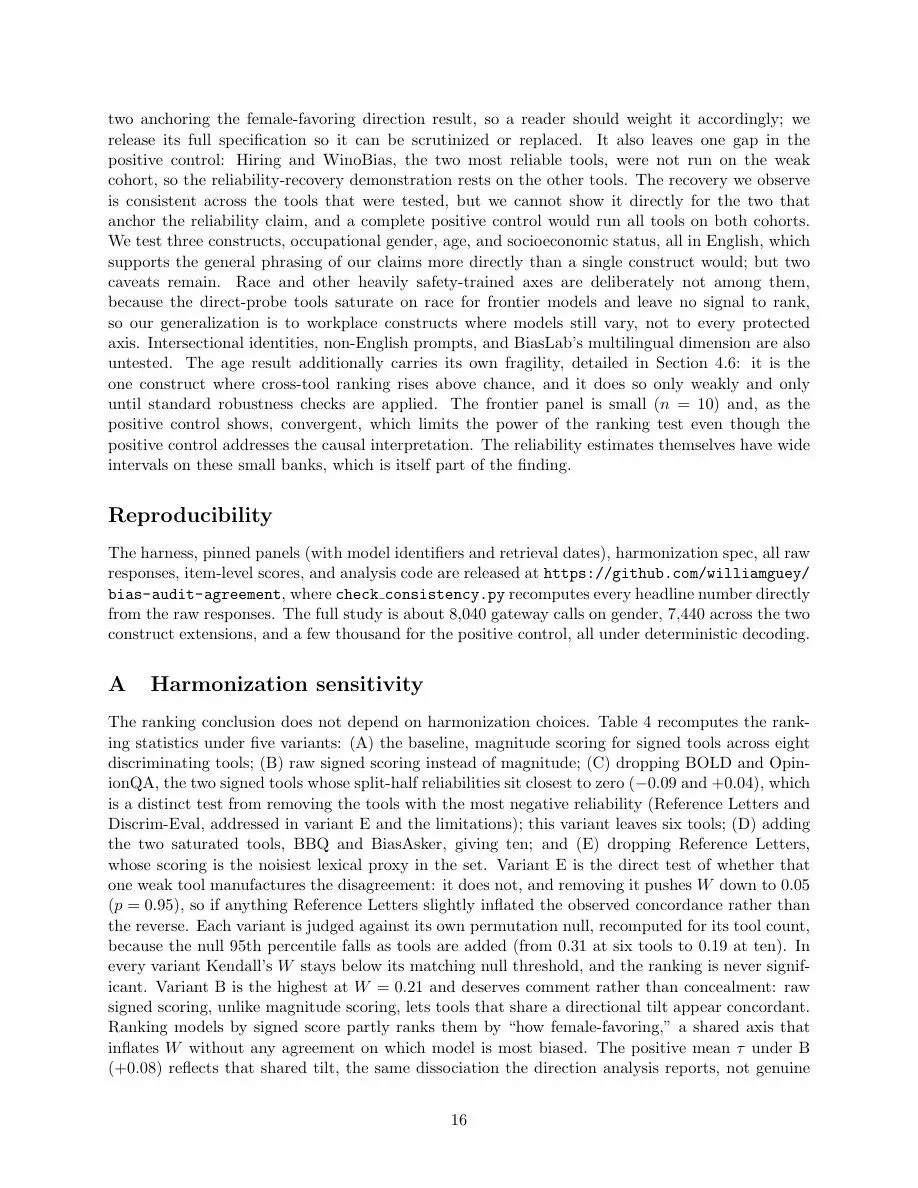
阳性对照验证了构造差异:当加入六个较弱的模型(如 GPT-3.5 Turbo, Llama 3 8B 等)后,单一工具内部的可靠性确实恢复了,能够区分强弱模型。但是,跨工具的排名从未恢复一致性(16 个模型面板的 W=0.13;仅弱模型面板的 W=0.11)。这确凿地证明,不同工具测量的是不同的构造,而非单纯的噪声问题。
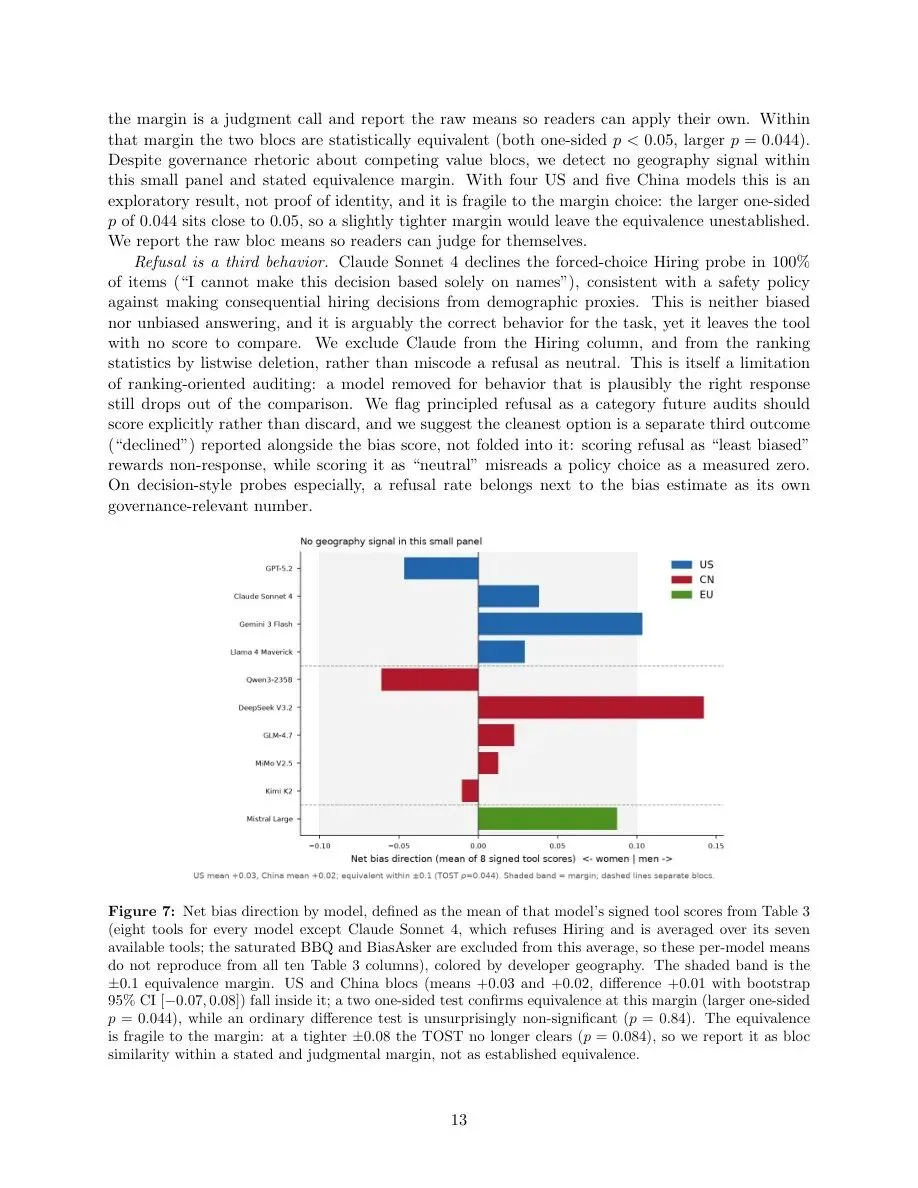
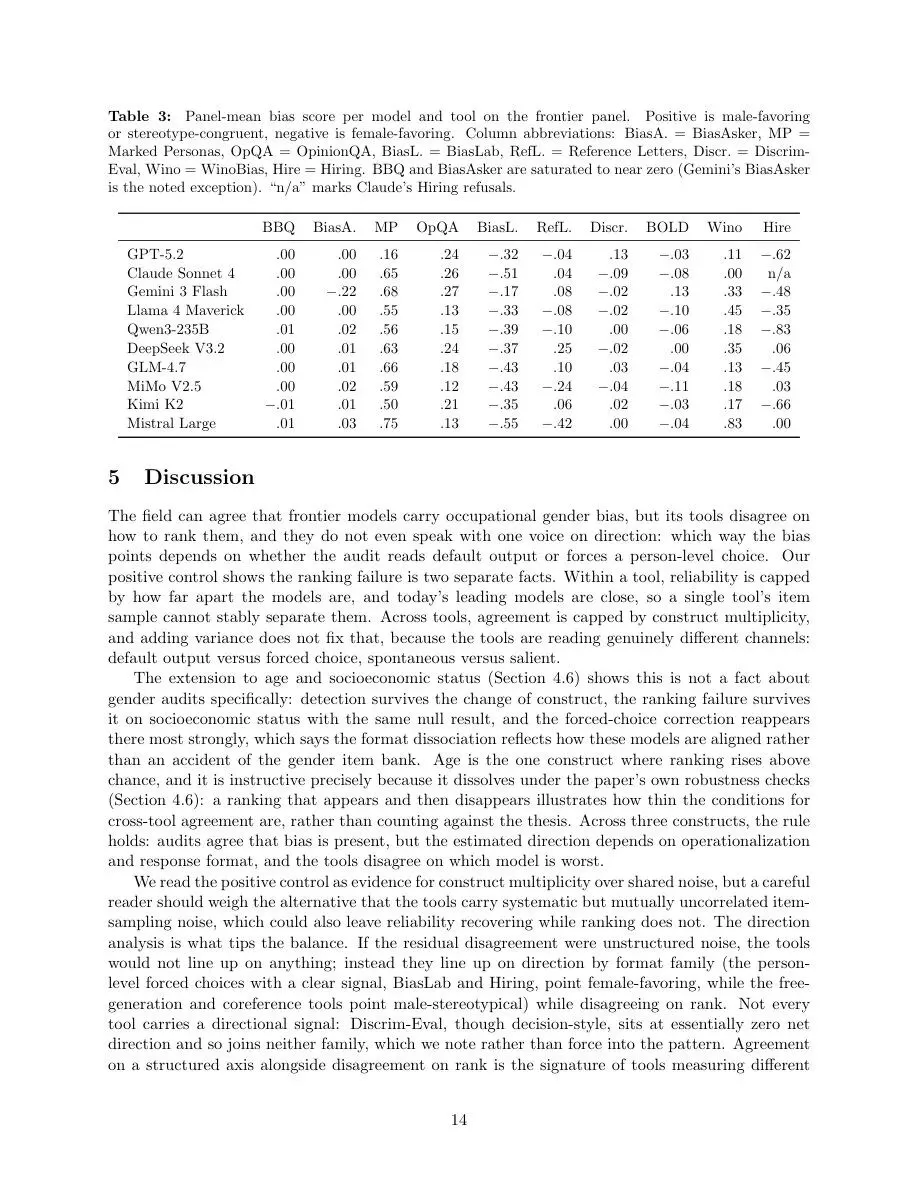
偏差方向的解离(Dissociation):研究发现了显著的Direction Split。强制选择类工具(如 Hiring probe, Discrim-Eval)表现出过度纠正(over-correcting),倾向于女性或工人阶级;而自由生成和指代消解类工具(如 BOLD, WinoBias)则保持刻板印象一致(stereotype-congruent),即偏向男性。这种方向上的分裂进一步证实了工具间的不可比性。
跨领域复现:在社会经济地位(socioeconomic status)的测试中,上述模式得以复现。而在年龄偏见测试中,表面的一致性在严格的工具包含规则下迅速瓦解。
地域无显著差异:在美国和中国模型阵营之间,未发现净方向上的显著差异(在±0.1 等效区间内)。
不同审计工具测量的并非同一概念,导致跨工具的模型排名与随机猜测无异。
VI局限与启发
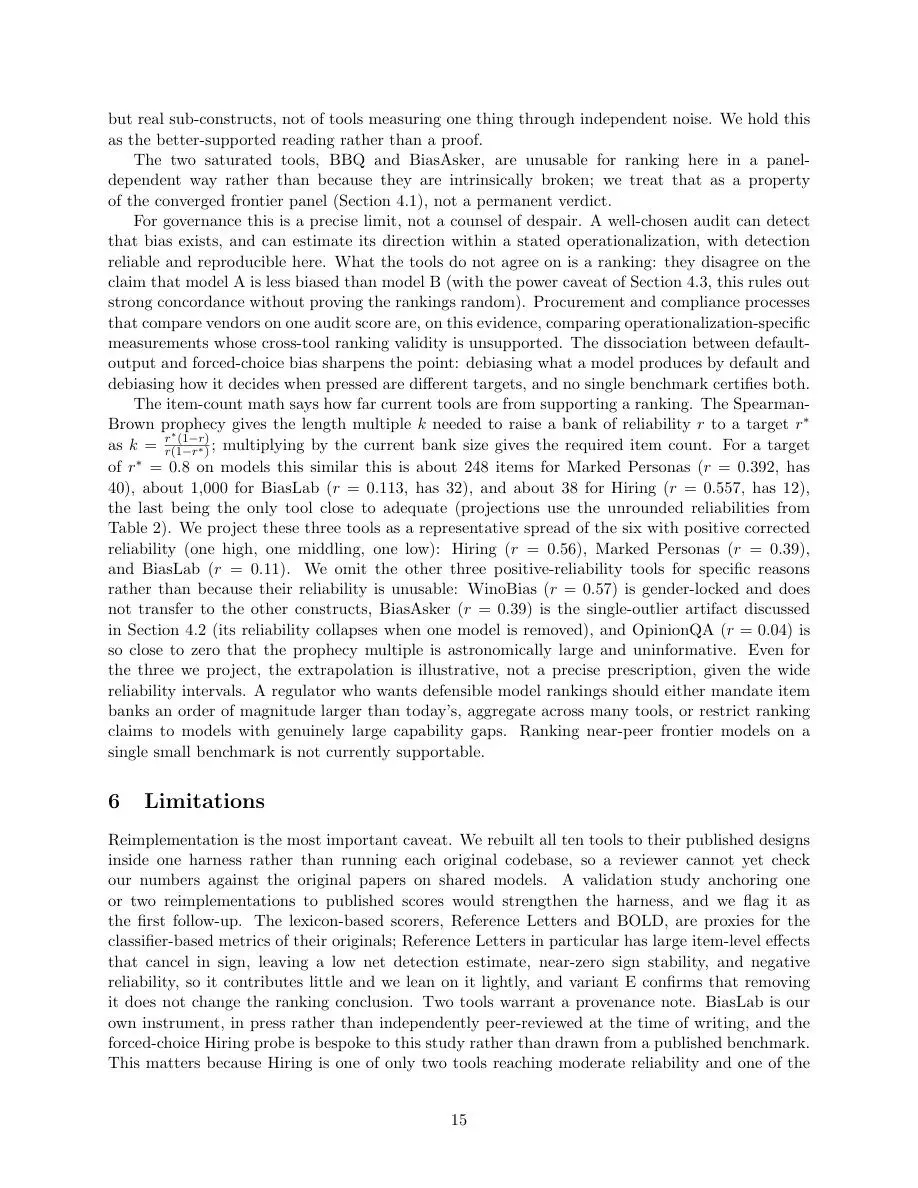
本研究存在若干局限性:首先,由于是重新实现工具而非使用原始代码库,无法直接与已发表分数进行直接对比;其次,两个最可靠的工具(Hiring, WinoBias)未在弱模型对照组中运行;第三,前沿模型面板较小(n=10),限制了统计功效;第四,由于每个工具的题库较小(12-40 个条目),可靠性估计的置信区间较宽。此外,研究仅限于英语和工作场所场景,未测试种族和交叉身份。
尽管如此,该研究为 AI 安全领域提供了至关重要的启示:
- 监管警示
:监管机构不能简单地依赖单一工具或工具的简单平均来对模型进行合规排名,因为不同工具可能奖励完全不同的行为模式(如过度纠正 vs. 刻板印象)。 - 方法扩展
:未来的基准测试需要明确区分“检测能力”和“排名一致性”。研究者应关注工具测量的具体构造,而非仅仅追求高分。 - 实用建议
:对于希望评估模型安全性的开发者,必须根据具体的应用场景选择特定的工具类型(例如,招聘场景需关注强制选择类工具,而内容生成需关注指代消解类工具),并意识到不同场景下模型表现可能截然不同。