ARTICLE · 1029247
别再让 AI 只会搜代码:这个开源项目,把整个仓库变成了知识图谱
当项目只有几十个文件时,AI 搜索代码的效果通常不错。但一旦进入多语言、多服务、数十万行代码的 Monorepo,“搜到相似片段”和“真正理解系统”之间,还隔着一张关系网。
如果你让 AI 回答“用户登录最终会调用哪些服务”,向量搜索可能找到 login、auth、token 相关代码,却未必知道谁调用谁、类继承了什么、数据又流向哪个出口。
开源项目 Code-Graph-RAG 想解决的,正是这个问题:它不只给代码做分块和向量化,而是先用 AST 理解程序结构,再把函数、类、方法、模块以及它们之间的关系,组织成一张可查询的代码知识图谱。
它和普通代码 RAG,到底差在哪里?
普通代码 RAG 常见的思路是:将文件切成若干片段,生成向量,再根据问题找出语义相近的内容。它很适合回答“哪段代码与订单退款有关”,但面对跨文件调用链、类层次、入口到出口的数据流,单纯的“相似度”往往不够。
Code-Graph-RAG 的做法更像给仓库绘制一张“结构地图”。
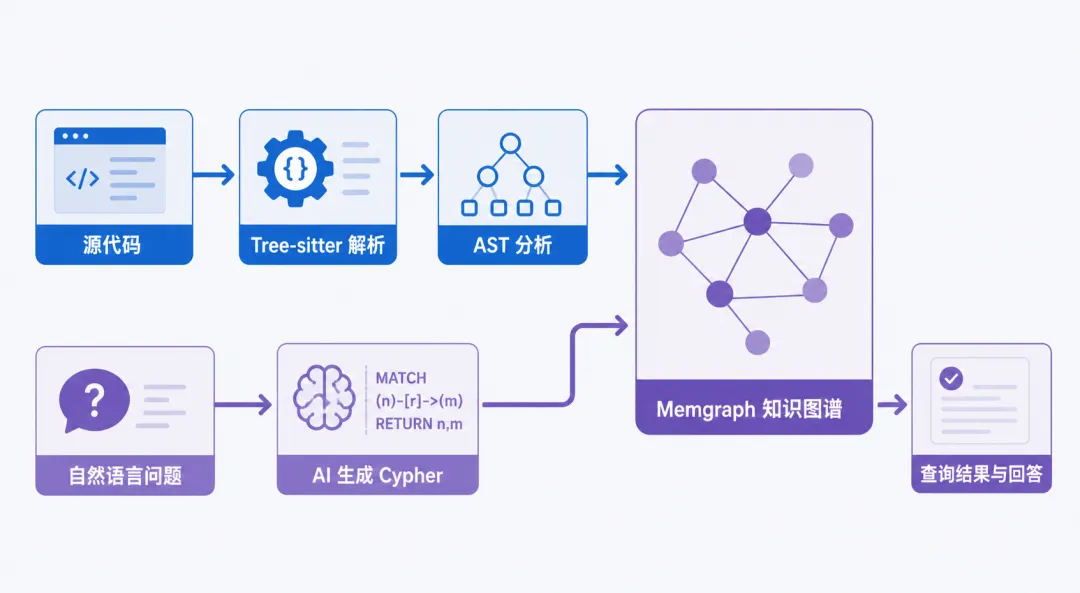
它先用 Tree-sitter 解析不同语言的抽象语法树,识别函数、类、方法、模块、调用、引用和继承等结构;然后把这些节点与边存入 Memgraph。当你用自然语言提问时,AI 会将问题转换为 Cypher 图查询,沿着真实的程序关系寻找答案。
这意味着,它关心的不只是“这段代码像不像你要找的”,还包括“它与其他代码究竟是什么关系”。
一张图,能给 AI 带来什么?
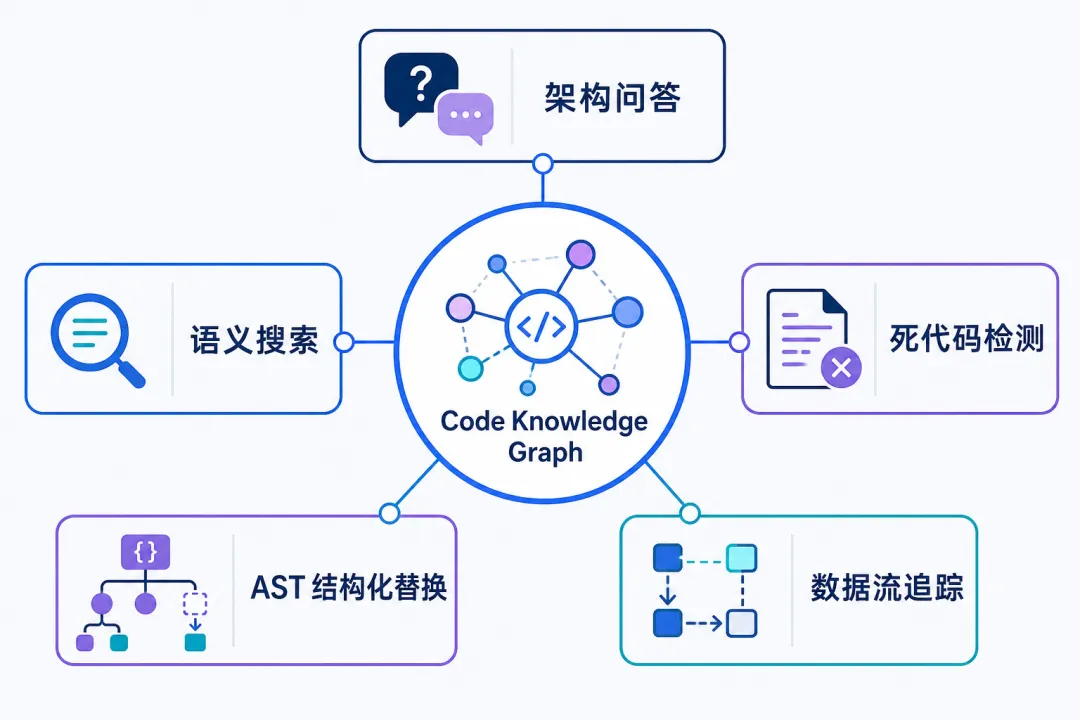
首先是更可靠的架构问答。你可以查询哪些函数调用了某个服务、某个类包含哪些方法,或者哪些模块共同依赖一个底层组件。回答不再只是一堆相似代码片段,而是建立在关系之上的检索结果。
其次是跨语言理解。项目当前完整支持 Python、TypeScript、TSX、JavaScript、Rust、Go、Java、C、C++、C#、PHP、Lua 和 Dart;Scala 仍在开发中,Ruby 则通过可插拔的 ast-grep 层提供结构化支持。对“前端 TypeScript + 后端 Go + 数据处理 Python”这类现实仓库,统一图模型的价值会更明显。
再者,它不只能“看”,还可以帮助修改代码。项目提供基于 AST 的定位和外科手术式替换,可以先返回 diff 预览;结构化搜索与替换则通过 ast-grep 匹配语法结构,比正则表达式更适合批量改写同一类代码。
最值得关注的新能力:数据流追踪
最近的功能中,很值得关注的是 FLOWS_TO 数据流边。它尝试追踪值如何经过赋值、函数调用以及 I/O 出口传递,并对“某个输入能否到达某个敏感出口”给出三种结论:找到路径、没有路径,或因分析覆盖不完整而无法确定。
这种“明确表达不确定性”的设计很重要。在安全审计里,“没找到路径”不等于“已证明不存在风险”。如果部分语言或文件不在数据流覆盖范围内,系统会返回 UNKNOWN,而不是给出过度自信的否定答案。
接入 AI 编程助手,才是它最实用的形态
Code-Graph-RAG 可以作为交互式 CLI 使用,也可以运行为 MCP Server,让 Claude Code 等 MCP 客户端直接调用。
它暴露的工具不只有通用问答,还包括查询代码图、获取精确源码片段、语义搜索、结构化搜索、结构化替换、增量更新仓库以及数据流判定。对 AI Agent 而言,这相当于从“读文件”升级到“查代码地图”。
一个很典型的使用场景是:开发者要求 Agent “给所有数据库连接函数增加日志”。Agent 可以先用语义或结构化搜索锁定目标,再查询调用关系评估影响,最后以 dry run 形式生成 diff。这比“让模型逐个猜文件”更接近一条可检查的工程流程。
五分钟上手,但前提不算少
cgr 已发布到 PyPI。项目推荐用 uv 安装包含全语言解析和语义搜索的扩展版本:
终端 · 命令
$ uv tool install "code-graph-rag[treesitter-full,semantic]"
它还需要 Docker、CMake 和 ripgrep。安装完成后,先启动 Memgraph + Qdrant 服务栈:
终端 · 命令
$ cgr daemon up
然后对仓库建图,再进入交互式查询:
终端 · 命令
$ cgr start --repo-path /path/to/repo --update-graph$ cgr start --repo-path /path/to/repo
建图后,你可以直接问:
示例
哪些函数调用了 UserService.create_user?找出所有处理身份验证的函数。给数据库连接函数增加日志,先给我看 diff。
这里需要特别提醒:图数据库可以共享多个项目,但 --clean 会清空整个共享图,不只是当前仓库。脚本和 CI 中也不应轻率地加上跳过确认的参数。
它适合谁,又不适合谁?
如果你的仓库足够大,存在多种语言、跨模块调用、复杂继承或需要进行影响分析,Code-Graph-RAG 很有吸引力。它尤其适合以下人群:
●接手陌生大型仓库,需要快速理清调用关系的开发者;
●维护多语言 Monorepo,希望给 AI Agent 更完整上下文的团队;
●需要死代码检测、结构化批量改写或跨文件影响分析的工程团队;
●关注本地化、私有化或隔离网络部署的组织。
但它不是没有成本。你需要运行 Memgraph,语义搜索时还会用到 Qdrant;仓库建图需要时间和资源,图也要随代码更新。对几百行的小工具、一次性脚本或只想查找某个字符串的任务,直接用 ripgrep、IDE 索引或普通向量搜索可能更轻。
最后的看法
Code-Graph-RAG 真正有价值的地方,不是把“知识图谱”变成又一个 AI 概念,而是把代码中本来就存在的结构关系,变成模型能查询、能引用、能用于行动的上下文。
向量搜索告诉 AI:“哪些代码可能与问题相关。”
代码图谱则进一步告诉它:“这些代码之间,到底如何相连。”
对正在走向复杂工程任务的 AI 编程助手来说,后者很可能是从“会补全代码”走向“能理解系统”的关键一步。
项目地址: https://github.com/vitali87/code-graph-rag