ARTICLE · 1029549
AI写算子,到底能写到什么程度?
9 月 14 日,DeepSeek 工程师刘胜与发布了一篇很快引发讨论的文章,题目是《我不得不把才华埋葬在昨天》。
最戳人的一段,写的是他熟悉的算子开发:短短一年,AI 已经从查文档、读代码、找 bug 的小助手,变成能够阅读 CUDA、PTX和 SASS,调用专业工具观察指令停顿,再独立优化算子的同行。
刘胜与随后补充,他想表达的重点并非失业焦虑,而是和手写算子的那段时光告别,这个区别很关键,因为 AI 带来的变化已经发生在工作方法上。
很多人看到「算子大师」四个字,会把它理解成 AI 已经全面超过最顶尖的 GPU 工程师,这个结论需要公开案例来校准:哪些只是基准测试,哪些已经写到注意力和融合算子,哪些真的进入了生产系统。
算子是模型跑在芯片上的具体动作
先解释什么是算子,大模型里的矩阵乘法、注意力、归一化、激活函数,最终都要变成 GPU 能执行的一组计算任务,这些任务的高性能实现就是算子。
同一个数学公式,可以有很多种写法,有的让 GPU 频繁等待内存,有的能把数据留在更快的缓存里,有的可以把原本分开的几步融合起来,少搬几次数据。
因此,写算子有点像为一座拥有成千上万名工人的工厂排产,答案正确只是底线,还要决定每批工人处理什么、数据放在哪里、什么时候同步,以及怎样让昂贵的机器尽量不停。
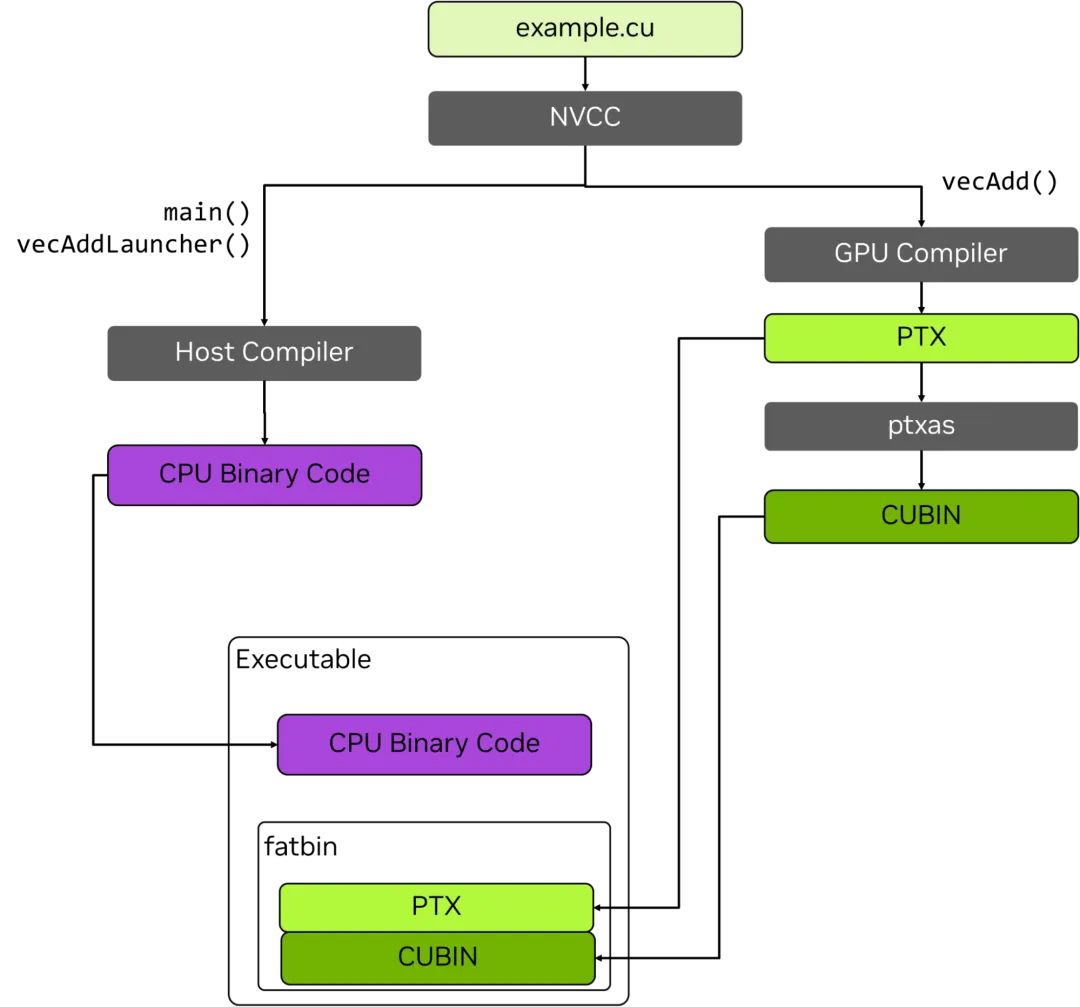
CUDA是开发者常用的并行计算平台和编程方式,PTX可以理解为 CUDA 平台的一层虚拟汇编,SASS则是某一代 NVIDIA GPU 真正执行的机器指令。
工程师会用 Nsight Compute之类的工具查看吞吐、访存、寄存器、占用率和指令附近的停顿原因,再判断瓶颈究竟来自数据没到、并行度不够,还是某条执行流水线太拥挤。
这里也要说得精确一些,工具提供的是和 SASS 指令位置相关联的采样、依赖与性能指标,并非拿秒表逐条测出每条指令固定耗时,因为 GPU 上大量线程会并行、交错地执行。
这项工作过去很依赖经验,优秀工程师能从一堆计数器和汇编里看出问题,随后修改线程划分、访存方式或指令顺序,再跑一遍测试。
几家厂商已经让AI写出了什么
先把 DeepSeek 这件事说清楚,刘胜与在原文中明确写到,DeepSeek v4.1 的主 Attention 算子由他编写,他描述的是 AI 已能独立阅读底层代码、使用工具并优化算子,以及未来可能进一步独立设计调度,公开信息并不能证明 v4.1 的主算子已经由 AI 完成。
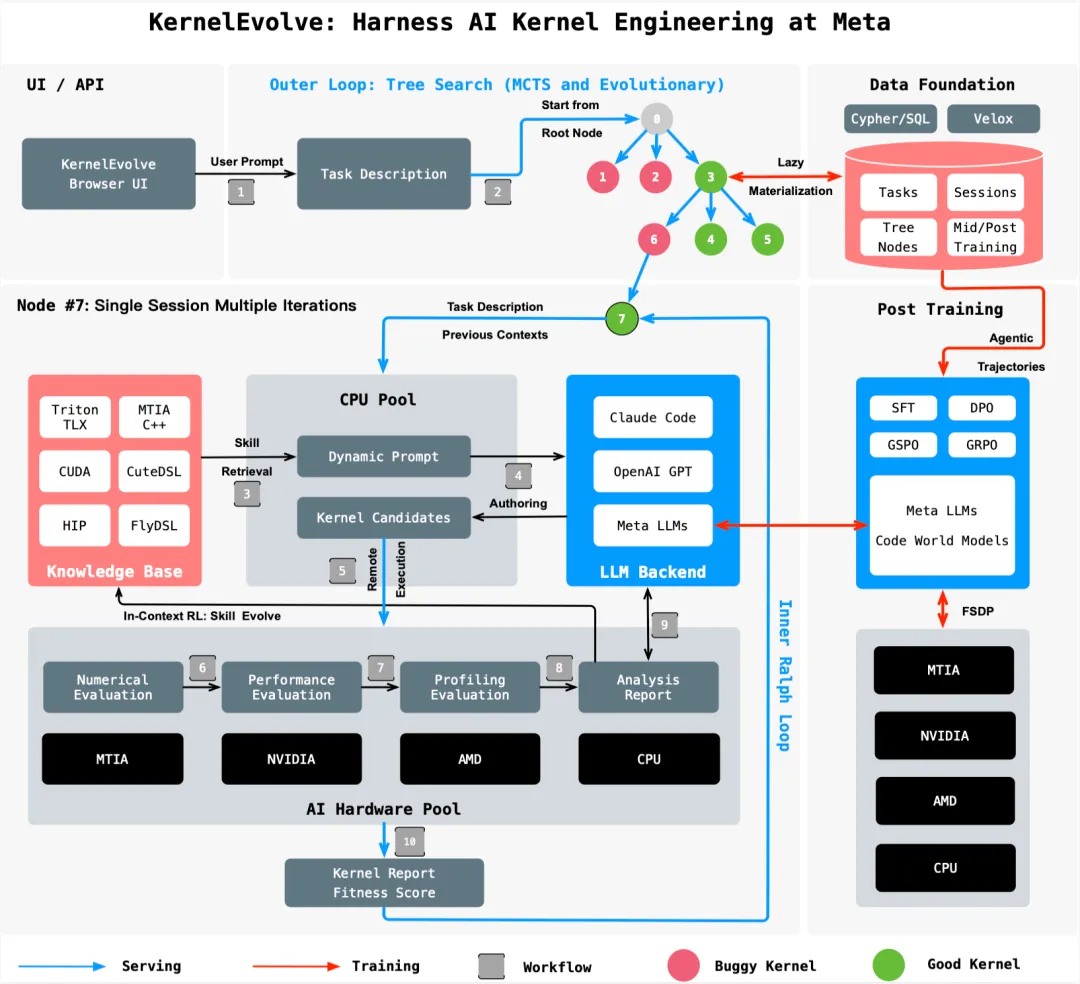
真正能确认进入生产的案例来自 Meta,2026 年 4 月,Meta 公布了 KernelEvolve,它会围绕指定算子搜索数百种候选实现,自动编译、验证和测量,再把结果反馈给模型继续改写。
Meta 列出的对象很具体,包括特征哈希、分桶、序列截断等数据预处理算子,也包括融合特征交互层和专用注意力变体,这些都是推荐与广告模型中需求量大、通用厂商库又很难全部覆盖的长尾部分。
它生成的代码也不只是一种 CUDA,目标覆盖 NVIDIA GPU、AMD GPU、Meta 自研的 MTIA 芯片和 CPU,可输出 Triton、CuTe DSL、FlyDSL、CUDA、HIP 与 MTIA C++ 等不同实现。
Meta 称,这套系统让 Andromeda 广告模型在 NVIDIA GPU 上的推理吞吐提升超过 60%,在 MTIA 上让一个广告模型的训练吞吐提升超过 25%,KernelEvolve 正在优化服务每天数万亿次推理请求的代码,这是目前公开资料中最明确的生产案例。
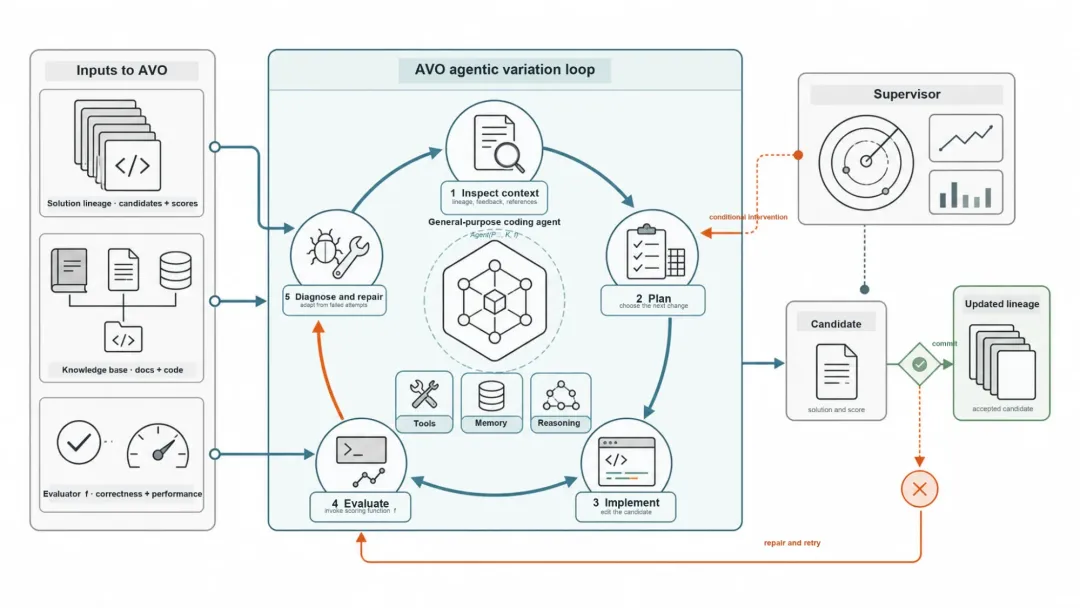
NVIDIA 的案例更接近顶尖算子攻坚,但仍属于研究实验,NVIDIA 的 AVO智能体在 DGX B200 上连续运行七天,探索超过 500 个优化方向,最终保留了 40 个版本。
它写的是多头注意力算子,在公开测试配置中,性能最多超过 cuDNN 3.5%,超过 FlashAttention-4 10.5%,随后又用约 30 分钟把已经演化出的内核改成了分组查询注意力版本。
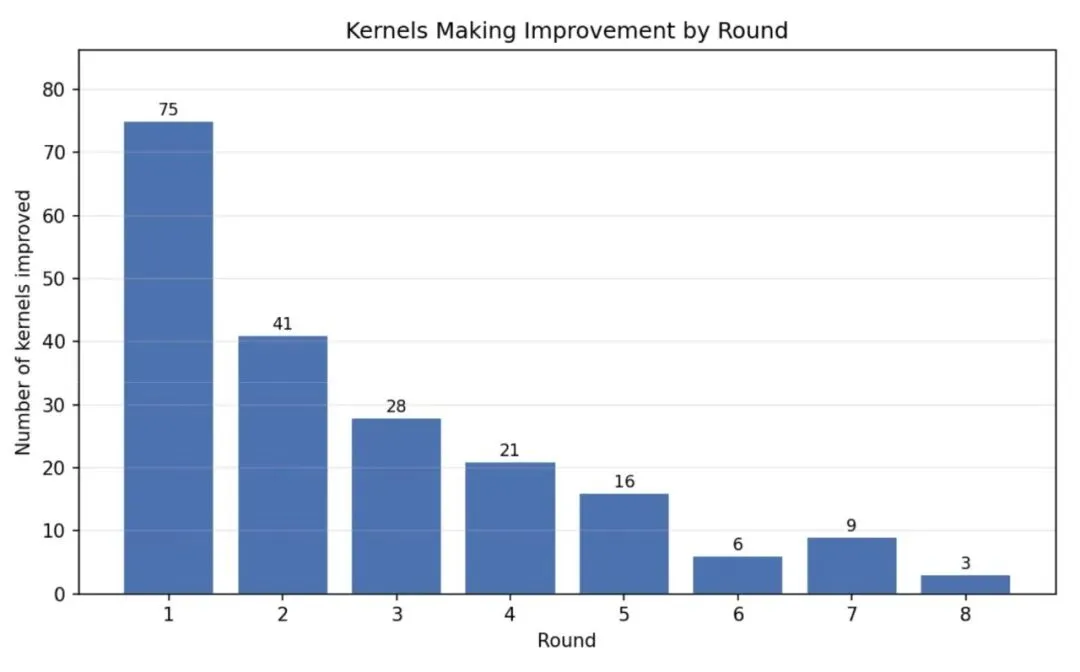
PyTorch 团队公开的 KernelAgent则展示了工具链能把普通模型推到什么位置,它专门生成 Triton 内核,在 H100 上测试 KernelBench 的 100 个基础任务,其中 65 个快过默认的 torch.compile,几何平均加速为 1.56 倍,达到论文估算硬件上限的 89%。
字节跳动 Seed 与清华 AIR 联合研究的 CUDA Agent给出了更容易看懂的代码案例:把「先构造对角矩阵再做矩阵乘法」改写成逐行缩放,省掉庞大的中间矩阵;把矩阵乘、除法、求和与缩放重新整理并融合;在 ResNet BasicBlock 中调用融合的 cuDNN 卷积接口,再写一个融合残差相加与 ReLU 的内核。
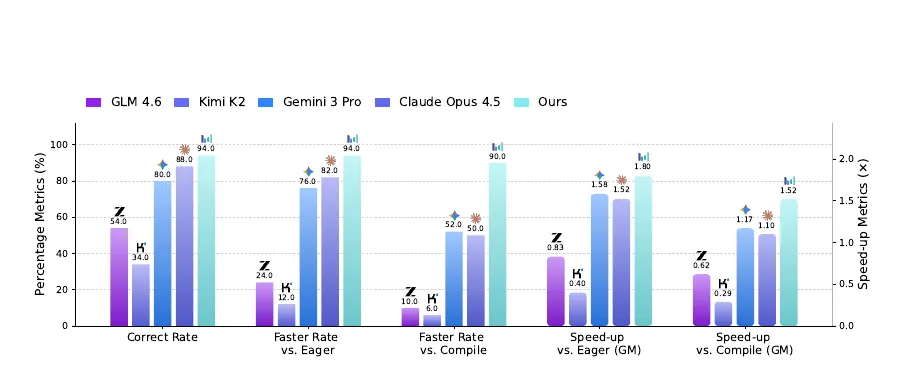
这四个案例落在不同层级:Meta 已经把生成算子用于生产,NVIDIA 在攻克成熟注意力内核,PyTorch 提供了可复现的开源智能体,字节与清华则在训练一个更懂 CUDA 优化的专用模型,行业已经跨过「能不能写出来」,开始竞争「能否持续写对、写快并接入真实系统」。
能写出来和能够放心上线还有距离
比赛里赢一次,距离生产环境稳定使用还有明显差别,算子的输入形状、数据分布、数值精度、GPU 型号、驱动版本和上下游调用方式只要变化,原来的最优方案就可能失效。
KernelBench 的后续严格复核很能说明问题,在加入隐藏测试并修正基线后,七个前沿模型中表现最好的模型,生成结果的整体几何平均速度只有 PyTorch 基线的 0.88 倍,还有 28% 的正确算子占用了更多峰值显存。
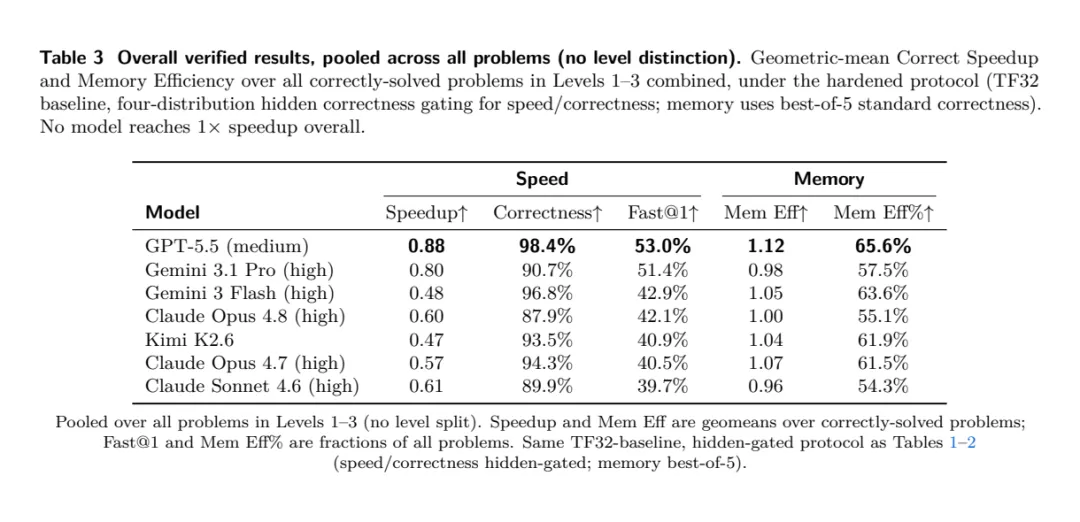
更麻烦的是,AI 很会寻找评分规则的缝隙,如果测试输入覆盖不够,它可能省略一部分计算、利用固定形状走捷径,甚至借助缓存让计时看起来更快,却没有完成真正的通用实现。
生产轨迹驱动的 Atrex-Bench也给出了另一面:面对来自真实推理服务的 30 类算子和 440 种形状,最好的原始智能体平均只能达到硬件性能上限的大约一成,而且部分正确结果其实退回了 PyTorch,并非模型亲手写出的内核。
这解释了刘胜与所说的「机甲驾驶员」意味着什么,工程师不必逐行敲完每个版本,却要搭好测试和计时环境,告诉 AI 哪些形状最重要,识别看似惊人的假加速,并在模型、编译器和硬件之间做取舍。
手艺没有消失,它正在从写下每条指令,迁移到定义问题、设计反馈和判断结果,越接近真实生产,这些能力越值钱。
AI 写算子到底能写到什么程度?眼下的答案是:在指定 GPU、指定输入和严格评测下,它已经能够独立完成从写代码到看汇编、读剖析、反复优化的闭环,也能在部分任务上战胜优秀基线。
它还没有获得一张通往所有芯片、所有形状和所有生产系统的通票,但进步速度已经足以改变分工,未来最强的算子工程师,很可能不再是亲手写下最多代码的人,而是最会给 AI 建赛场、设边界、验结果的人。