ARTICLE · 1029574
AI写得越自信,你越要让它自己挑错
AI写得越自信,你越要让它自己挑错《AI协作飞轮》07/12|:让AI自己挑错:对抗审查比夸它有用 朋友前阵子栽了个跟头。 他用AI写了一份行业分析,发给老板之前自己通读了一遍——数据翔实,结构清晰,语气专业。他很满意。 汇报开到一半,老板问:「这个市场规模的数据,哪来的?」 他答不上来。那个数字是AI写的,他根本没核过。老板没再说什么,但散会之后,他把那份报告又从头到尾核了一遍——发现了三处编造的「事实」。 AI写得越流畅、越自信,你越危险。因为流畅会传染给你一种错觉:它懂。 先想一个问题 上一次AI交出一份你很满意的稿子,你做了什么? 大部分人的动作是:通读一遍,挑不出毛病,发出去。 注意,「挑不出毛病」不等于「没有毛病」——只等于你用的审查标准,和AI的生成标准是同一套。它按这个标准写的,当然经得起这个标准的检查。 反直觉的地方在这 我们的本能是:东西写好了,夸一句「不错」,然后要它「再检查检查」。 这基本没用。第2篇讲过机制:让AI审自己刚写的稿,它是在写作的假设上接着写——同一上下文里的自查,是假审查。你问它「有问题吗」,就像问一个刚考完试的人「你觉得自己考砸了吗」,他大概率觉得没有。 高手的动作是反的:不证明自己是对的,主动构造一个反方,证明自己可能是错的。 这就是对抗性思维:默认第一稿一定有缺陷,区别只是缺陷暴露在哪——暴露在交付之前,是修改;暴露在交付之后,是事故。 红队玩法:一句话就够了 做法简单到不像话:把稿子发给AI,让它扮演最想搞砸这件事的人(建议截图): 「假设你是这个方案最苛刻的反对者,你的目标是让它被否决。找出最可能被攻击的3个弱点,说明攻击理由,越不客气越好。」 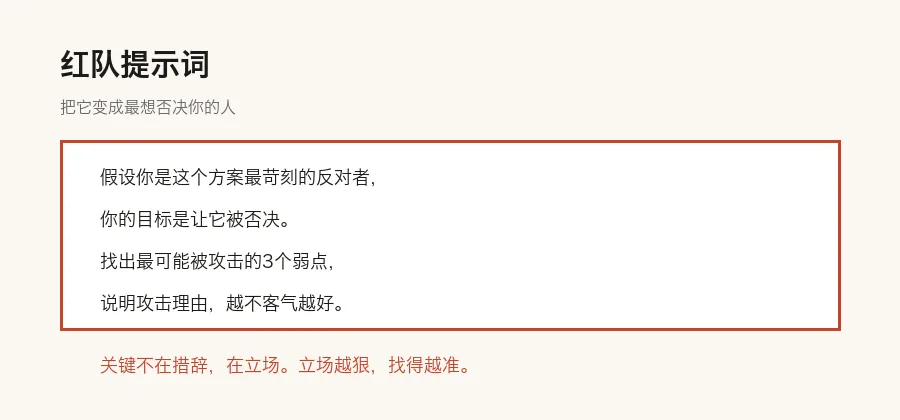
关键不在措辞,在立场。「帮我检查一下」是空立场,它只会顺着夸;「目标是让它被否决」是真立场——立场越狠,找得越准。 如果内容重要,再进一步:开一个新对话,只贴稿子,不给任何背景,让它在「不知情」的状态下挑错。同一个AI,换了个上下文,就是另一个人——这是把第2篇的「一个对话,一个立场」用到极致。 六维审查清单 红队提示词管「找茬的方向」,这张清单管「你自己的最后一遍」: ●事实:每个数据、引文、人名,有出处吗?还是「看起来像真的」? ●逻辑:结论真的由论据推出来的吗?有没有因果硬接的地方? ●遗漏:如果你是读者,读到这里还想知道什么? ●立场:通篇是不是只讲了有利于结论的证据? ●措辞:有没有「显著提升」「广受好评」这种没有支撑的大词? ●边界:哪些是确定的,哪些是推测的?推测的标出来了吗? 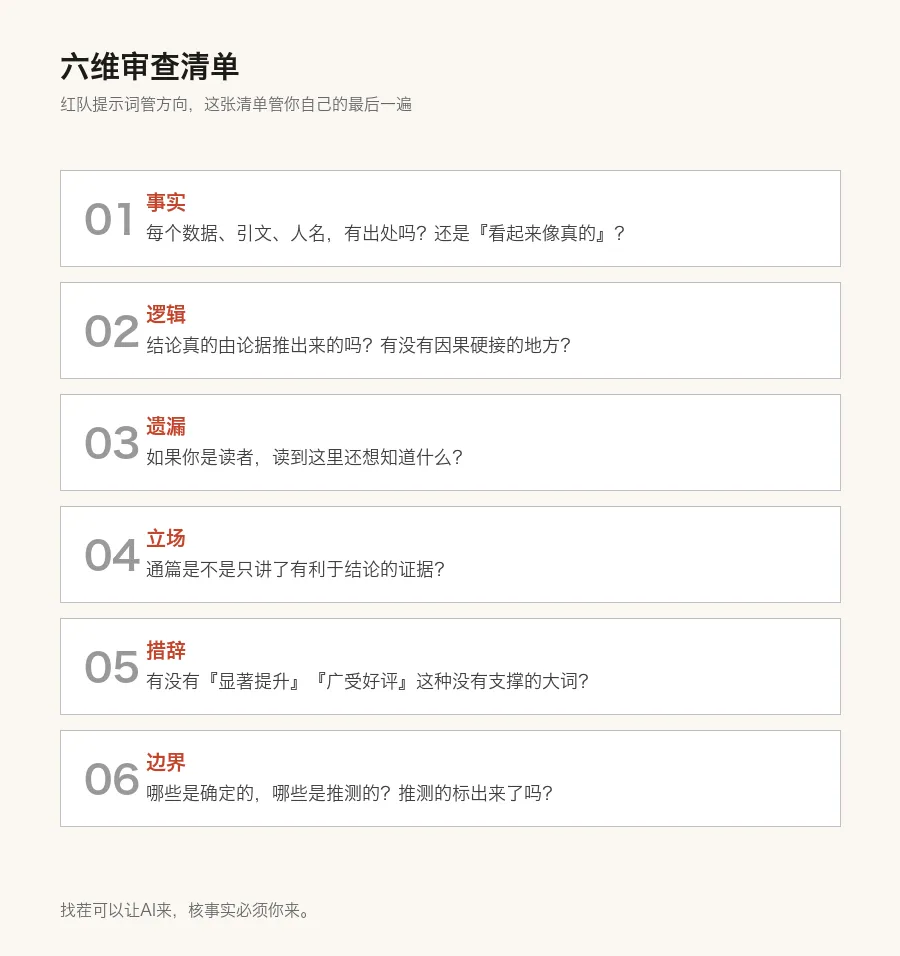
人比AI贵的地方,就在这条边界上 最后一维要单独说。 AI最擅长编的,不是一眼假的错,是合理到不会被怀疑的错:一个不存在的报告编号、一句张冠李戴的引言、一个差了一位数的百分比。它们全都流畅、自信、格式标准。 所以分工要清楚:找茬可以让AI来,核事实必须你来。它说「这个数据来自某某报告」,这句话本身也需要核。凡是出了错你要负责的环节,验证权永远在你手里。 失败对话改造室 改造前: 帮我看看这份方案有没有问题。 改造后: 你是评审会上最想否决这个方案的人。找出3个最可能被攻击的弱点,说明理由,不要客气。另外,把文中所有数据和事实性陈述单独列一张清单,标注哪些是可以验证的、哪些是推测的。 前者你收到的是安慰,后者你收到的是弹药。 看完马上能做的 练习(10分钟):翻出一份你最近已经发出去的AI产出——周报、方案、邮件都行。用红队提示词审一遍,看它能找出几个你当时没发现的问题。 复盘(5分钟):回忆一次「当时很满意、事后出问题」的交付。拿六维清单对一下:当时缺的是哪一维?多数人会发现是「事实」或「立场」。 到这一步,这个系列的第二模块就闭环了:想清任务(1-3篇)、管好输入(4-5篇)、控住过程(6-7篇)。下一模块,我们开始处理真正复杂的事。 下期预告 第8篇:《复杂任务不要硬问:把AI接成一条流水线》——没有大任务,只有没拆的小任务。 互动:你被AI「看起来很专业」坑过吗?评论区说说它给你编过什么