ARTICLE · 1029697
10 万字的文档丢给AI,AI 为什么只用回头「看」128 个字?- KV 缓存机制
AI 聊天时每多写一个字,都要把越来越长的全文从头再算一遍吗?答案藏在一个机制里:KV 缓存。
为什么基模厂商会区分缓存命中和缓存未命中?缓存命中」和「缓存未命中」为什么价格相差50倍?答案也藏在一个机制里:KV 缓存。
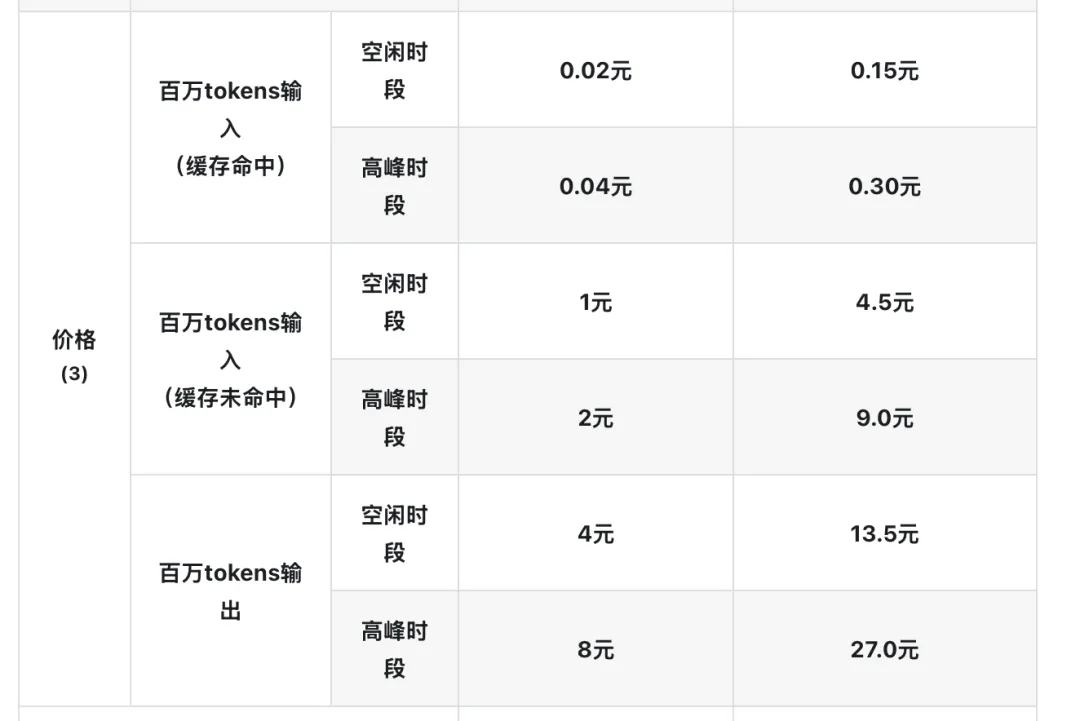
deepseek v4 flash、v4pro 定价表
你打开一个 AI 助手,把一份几十页的项目文档贴进去,说一句「帮我总结一下」。AI 开始回答,一个字一个字往外蹦。写下一个字的时候,它显然还得「看着」你给的那份文档,和它自己前面已经写出来的话。不然怎么保证前后连贯、不离题?
如果你不了解大模型是怎么工作的,也可以先看一下:文字是如何在AI大脑里"蜕变"的?——以给李华写道歉信为例
简单来说,LLM的工作原理,就是根据你输入的文字,切为token,放进一个由几十万亿的数据炼成的有几万亿高纬权重的炼丹炉里,然后输出会“准确”的预测到你下一个想要的词。
那问题来了:每写一个字,都要把越来越长的全文从头到尾重新算一遍吗?那得多慢、多费电。
答案是不用。AI 会把一部分已经算好的结果存下来,下次接着用。这就是KV 缓存(KV cache)。这里的 K 和 V 是什么,为什么只缓存它俩、却不缓存 Q?下面慢慢说。
一、每生成一个字,都要从头算吗
先把这个过程缩到最小。假设你输入的句子是「The sky is」(天空是),AI 接下来要生成「 blue」(蓝色的),再生成「.」(句号)。
第一步,AI 把整个输入一口气处理完,在每一层建立起缓存。这一步叫prefill(预填充),可以理解成先把材料备好。最后一个词的输出,用来选出第一个要生成的词。
它选了「blue」。这个「blue」被当成新的输入,送回模型,去预测下一个词「.」。
这里有个关键,可以想象一排货架:
已经算好的 K 和 V,像一排摆好的货架,原地不动;
新来的「blue」,只是在货架末尾加一格;
更要注意顺序:生成「blue」这个词的时候,它自己的 K 和 V 其实还没算出来,要等它被送回模型、去预测下一个词时,才补上这一格。
所以模型并没有偷懒到「不计算新词」。它只是省掉了对前面那些旧内容的重复计算。
二、为什么留下 K 和 V,却不留 Q
在每一层里,每个词都会经过一次「变换」,被拆成三样东西,记住三个字母:Q、K、V。
用一队人接力发言来比喻来理解:
K(招牌):每个人贴一张便利贴,写「我知道什么」,让人一眼找到他。
V(内容):便利贴下面挂个袋子,装着他真正的那点信息。
Q(问题):轮到谁发言,谁心里先冒出一个 Q(需求):「我该找前面谁取经?」
当一个新词(比如「blue」)进来时,它会拿出自己的 Q,去跟前面所有词的 K 比对:谁的标签跟我最相关?比出结果后,再按相关程度,去读对应的 V,加权求和,得到这一层的输出。
关键就在这:下一个词会产生它自己的、全新的 Q,但它仍然需要读前面那些词的 K 和 V。
而那些旧词当年的 Q 呢?它们在「自己出生那一刻」就完成了使命,用来问「我当时该看哪里」。事后再也没有人会问同样的问题,所以Q 用完就可以扔,K 和 V 要留着给别人读。
这就是「KV cache」这个名字的由来:K 和 V 留着供后面反复读取,Q 随每个新词重新现算。
三、文章变长了,为什么旧计算还有效
回到那份项目文档。假设开头写着「预算为100 万元」,后面是进度、人员、交付计划。
现在对比两个动作:
① 在文档末尾追加一句:「请总结一下风险。」
② 把开头的「100 万元」改成「50 万元」。
哪个会让旧缓存作废?先想一下。答案是第 2 个。
原因在于,这种模型有个只看前面、不看后面的规矩,专业点叫因果注意力(causal attention):每个词只能看见自己和前面的内容,看不见后面的。
你在末尾追加问题,不会反过来改变前面那些词已经算好的状态,所以旧缓存照用;
你改开头的预算数字,会影响后面每一个词的语境,原来的缓存就失效了,得重新算。
一句话:续尾易如反掌,改头牵动全身。
四、新词进来时,到底算了什么
现在把「blue」刚被送回模型的那一下放大看。前面说的「查资料取经」,模型里其实不是只查一次——它同一时刻派了好几个小助手,各自从不同角度去查,每个小助手专业上就叫一个「注意力头」。我们只看其中一个小助手,它做了四件事:
- 墙上的历史 K/V 原样不动;
- 新位置「blue」现场算出自己的 Q、K、V;
- 用新的 Q 去读所有能读到的 K/V;
- 新算出的 K/V 先挂上墙、再参与取经,所以「blue」的 Q 也能「看到它自己」。
这一层算完,输出继续往后传,经过模型的其他部分,最后才得到「下一个词该选谁」的分数。
顺带说一句:只要输入和执行条件对得上,用了缓存和没用缓存的结果,应该只在很小的数值误差范围内一致。缓存省的是时间,不该改变答案。
五、省了计算,为什么又费显存
天下没有免费的午餐。缓存省下了重复计算的时间,还有各位的钱包,却要吃显存。
文档越长,要留的 K/V 就越多。可以这样数一数:多少条序列、多少层、每层留多少个位置、多少个 KV 头、每个头多宽、每个元素占几个字节。把这些数字乘起来,就是缓存的大小。
拿一份假设配置举例:
24层 1条序列 8个 KV 头
每个头宽 64 每个元素 2个字节
留 4096 个位置,KV 缓存大约是192 MiB;留 8192 个位置,就翻倍到384 MiB。
所以「位置越多越费显存」。这也逼着人们想办法压缩、共享缓存,而不是无脑全存。
六、同一份文档,换个问题还能用吗
你刚让 AI 总结完风险,又想问「截止日期是哪天」。这两个请求可以这么拆:
请求 A:〔同一份文档〕+「总结风险。」
请求 B:〔同一份文档〕+「列出截止日期。」
如果文档那一大段在两次请求里一个字不差,模型设置又兼容,系统也还留着这段缓存,那文档部分的 K/V 就可以复用一次、两份都用,只需要分别去算两个不同的问题和它们的续写。
这个策略叫前缀缓存(prefix caching)。
厂商提到的「缓存命中」其实也就是指这里的「前缀缓存」命中。
三个词容易混,这里区分一下:
prefill:处理输入、把缓存建立起来的那一步「计算阶段」。
KV cache:被保存下来的 K/V 状态本身。
prefix caching:把已有的前缀状态「重复利用」的策略。
注意:就算不启用 prefix caching,普通的连续生成也照样会用到 KV cache。
实际场景里,反复问同一份年报、同一本软件手册,就是典型用法:第一次 prefill 建好缓存,后面命中了共同前缀,就直接复用 K/V,省掉重复的 prefill 计算。
但要说清楚:换新问题时,新问题本身还是要算,新的回答也还是要一个字一个字生成。prefix caching 省的,是重复的「预处理」工作,不是生成本身。
还有个容易被忽略的点:如果请求 B 在文档前面多加了一段不一样的说明,那「共同前缀」就变短了。哪怕后面的文档文字一模一样,也不能想当然地认定它的状态相同,因为「只看前面」的规矩,前面一改,后面就全跟着变。
七、如果换个思路重新设计 KV
前面说的都是「每一层各自保存自己的 K/V」。理解了这套依赖关系,就能看懂DeepSeek-V4.1-Flash在缓存上做的几处改动。
第一处:来源变了,编码器加解码器。
这个模型里,解码器要用到的「全局 KV」(可以理解成「整篇文档的大纲索引」),不是解码器自己慢慢攒的,而是来自一个编码器(encoder)的最终输出。解码器的各层仍然自己算自己的 Q,以及一个「局部滑动窗口 KV」(只记最近的一小段)。
第二处:跨层共享。
先补一句背景:大模型是一层层叠起来的,像一栋楼。一句话进去,从底层到顶层,一层层往上「加工」,每一层都要做一遍「查资料取经」。
麻烦在于:取经要用的那份「整篇文档大纲」(全局 KV),如果每层楼都自己算一份,二十层就是二十份重复劳动,又慢又费显存。
DeepSeek 的做法是:指定其中一层——在这份报告里是第 21 层——把大纲整理成一本公用手册,往大厅一放。第 21 到 40 层这二十层楼,谁要用就借这本,不用各抄一份。
再盯着第 21、22 层看:它俩借的是同一本手册,但各自想问的问题(Q)、手头最近记的东西(局部状态)还是自己的。借同一本手册,不代表结论一样——谁读哪几页,各凭本事挑(这叫「稀疏选择」)。
第三处:K 和 V 合成一个。
通常 K 和 V 是两份独立的数组。这里用的是共享 KV 表示(Shared KV representation):同一个被选中的向量,既参与 Q 的匹配打分,也参与输出的加权求和,一鱼两吃。
可以想象一个画面:一份「全局 KV」像一座资料库,连接着好几层;放大其中一个向量,会发现它两头都出力,既帮新词「找答案」,又帮输出「算结果」。
顺带澄清一句:模型仍然保留着局部缓存、索引器状态等数据;「共享 KV 表示」跟「把两份独立的 K/V 数组肩并肩存放」,是两码事。
再回到那份项目文档。假设这次输入有10 万个词,报告里的部署方案这样跑:
编码器处理完整输入,产出构建「全局 KV」的表示;
解码器随后只处理最后 128 个词,重建「局部状态」;
更早的历史内容,仍然通过「全局 KV」来访问。
换句话说,「全局 KV 从哪来」,会直接影响 prefill 阶段哪些计算可以省、哪些不能省。而生成后续词时,新输入仍然要经过编码器和解码器。
八、串起来,回到开头那份文档
现在可以把整条 KV cache 的线索,沿着同一个场景串起来:
继续写回答:新位置算自己的 Q,读仍然有效的历史 K/V。
改文档开头:从 token 前缀真正变化的地方,重新检查能复用的范围。
换一个问题:检查共同前缀、执行条件,以及缓存是否还被保留着。
读一份更长的文档:留意保留位置带来的显存增长,以及架构如何组织这些状态。
看完这些,再回头看标题那个问题,为什么缓存 K 和 V,却不缓存 Q,答案其实就是一句话:Q 是「问完就作废的问题」,K 和 V 是「会被反复借阅的资料」。
我是林繁,关注我关注最有用最有趣的AI 前沿资讯。欢迎点赞、在看、转发,我们下篇见。