ARTICLE · 1030276
IF=11.7|AI翻译儿科出院说明:西语接近人工,中文仍落后
引言

出院说明里的剂量、复诊和危险信号不能“差不多”。AI翻译看似能快速填补语言服务缺口,但同一系统对不同语言的表现可能完全不同:对西班牙语接近专业翻译,并不代表对中文、越南语或索马里语也安全。
这篇文章为什么值得关注?

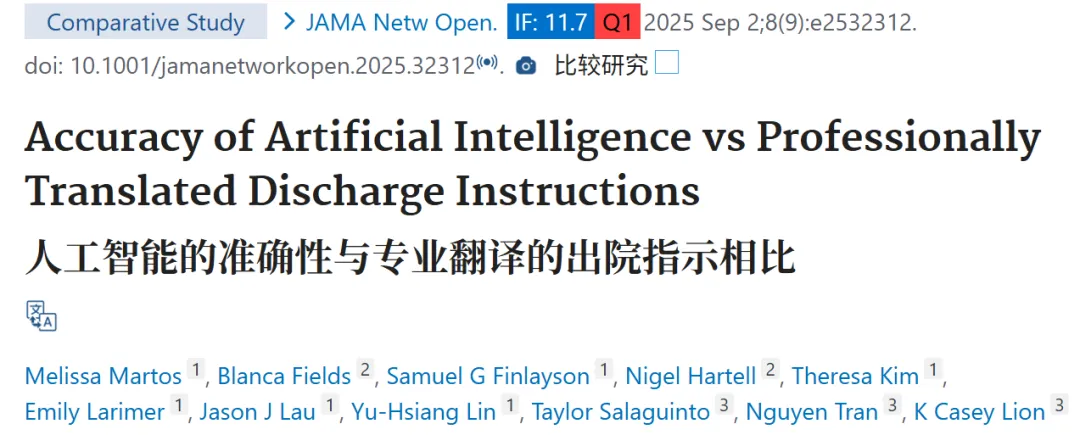
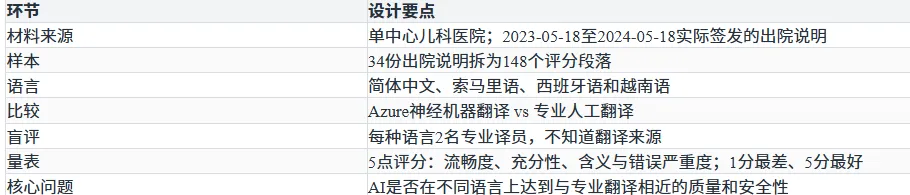
研究使用真实发给家庭的儿科住院出院说明,而不是通用句子或考试语料,并由每种语言2名专业译员在不知道来源的情况下评分。这样的设计更接近日常医疗风险。
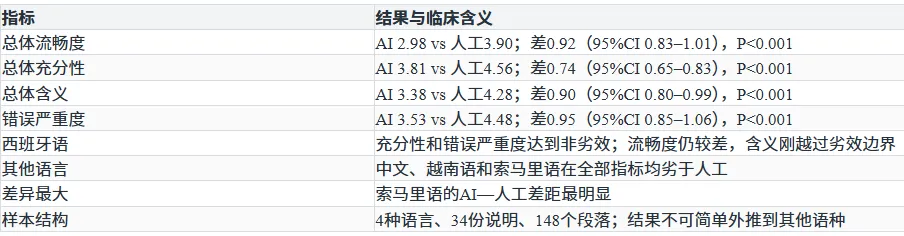
最大的信息不是“AI平均比人差”,而是语言之间差异巨大。资源较少的语言表现最弱,提示自动化可能把原有语言不平等再次放大。
核心方法

机制解释

机器翻译依赖训练语料覆盖与语言结构。高资源语言拥有更多平行医学文本,模型更容易学到术语和句式;低资源语言、复杂形态或语序差异会增加意义丢失。医疗文本还包含药名、剂量和操作指令,普通语义相近并不足够,任何关键成分遗漏都可能转化为风险。
核心发现:数据说话

局限性与讨论

单中心且仅34份出院说明,语言内部不同方言、识字水平和文化表达未充分覆盖。
评分者是专业译员,未直接测量家庭理解、用药错误、复诊依从性或再入院。
研究评价单一商业翻译系统;模型更新后结果可能变化。
段落级平均分可能掩盖少数高危错误,医疗安全更需要按药物剂量、否定词和危险信号做严重性分层。
科研王师兄的解读

为什么能发顶刊:研究不追求一个总体BLEU分数,而是使用真实出院材料、专业盲评和分语言非劣效判断,把公平性直接嵌入安全评价。
值得思考:AI翻译不能因为某一种语言通过验证就“一键开放全部语种”。语言应像不同医疗器械适应证一样逐一验证。
科研启示:下一步应采用风险分级的人机协作——低风险固定文本可自动处理,高风险剂量和警示语必须专业复核,并追踪患者理解。
一句话总结

医疗翻译不是“能不能读懂大意”,而是每个关键指令都不能错;这项研究提醒我们,AI在高资源语言上的成功,绝不能替低资源语言提前背书。
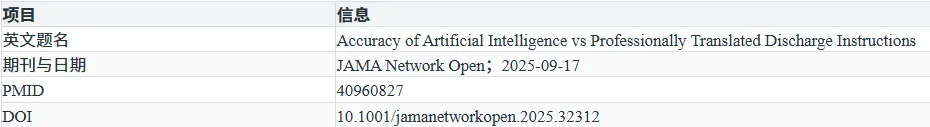
原文信息卡

读完这篇,你可能在想如何将AI4S、AI4M思路应用到自己的研究中
训练营:第37期!AI科研工作流 + 医学SCI全流程「光速科研写作训练营与线上师门」:你缺的不是AI工具,而是一条从选题到投稿返修的科研路径
欢迎加微信深聊 ↓
——— 开启你的光速科研之旅 ———
扫码添加 · 王师兄
微信号:wpro999
关注「光速科研SCI」,添加微信 wpro999 咨询
「光速科研」协和/复旦/湘雅博士团队出品