ARTICLE · 1030360
翻完 GPT Researcher 的源码,它最花心思的地方跟 AI 没关系
AI代码蜂巢X
探索编程的无限可能
编辑:嘉禾
Agent 拼的是更强的模型?
拆开一个活了三年的研究 Agent
里面全是四十年前的老手艺
五层分层 · 上下文压缩 · 显式契约 · 成本回调
GPT Researcher
在 Agent 这个赛道,一个项目活过一年就算长寿。
GPT Researcher 活了三年多。
它 2023 年 5 月建仓,到今年 8 月还在发版本,GitHub 上快 3 万 star。这种项目,值得从头翻一遍。
翻的时候本来想看两件事,现在主流的 deep research Agent 模型是怎么接的,prompt 是怎么写的。
结果翻完,最先想聊的是它的目录结构。
代码分五层,从上往下。
最上面是后端 API 层,FastAPI 的接口、WebSocket 的事件推送、报告落盘都在这儿。往下一层是编排层,就一个文件,里面那个 GPTResearcher 是主协调器。再往下是 Skills 层,持有状态,负责驱动流程。然后是 Actions 层,里面全是纯动作函数,不记状态。最底下是 Providers 层,检索器、爬虫、模型接入,全堆在这儿。
看到这儿可能会觉得,这不就是常规分层吗。
对,是常规分层。但最有意思的是中间那条线,画在 Skills 和 Actions 之间。
Skills 持有状态,Actions 不持有。这两类东西被严格分开了。分开的好处很实在,任何一个 Actions 里的函数都能单独拎出来测试,也都能被整个换掉,不用动上面任何一行代码。
整个项目翻下来,这个原则贯彻得特别彻底。没有一份几百行的主文件什么都干,而是一堆各管一件事的类。主协调一个,研究执行一个,写报告一个,管上下文一个,来源排序一个,递归研究一个,生图一个。所有 prompt 收在一个叫 PromptFamily 的类里,配置装载单独一个类。
配置也单独拎出来放,默认值一份文件,类型约束另一份,用的是 TypedDict。
好,分层看完了。从请求进来那一刻开始,顺着往下走一遍。
后端开两个入口,一个是 REST 的接口,一个是 WebSocket。前端走的是后者。入口函数只做三件事,注入 MCP 环境变量,按报告类型路由到不同的执行体,再把日志推回前端。
这里有第一处不太直观的设计。MCP 的接入,不是新加一条代码路径,而是把 MCP 这个名字拼进检索器的配置里,跟别的检索器一起在运行时解析。
好处是 MCP 直接复用了同一套上下文合并逻辑,一行新代码都不用写。代价是排查问题的时候得倒着找,先翻配置,发现配置里压根没提 MCP,再去翻环境变量。
乍一看挺聪明,直到后面又撞见它一次。
再往下走。研究开始的第一件事,不是检索,是让 LLM 先挑一个角色。
选角色那一步返回两个东西,一个是 agent 类型,一个是角色 prompt,这两个值后面会注入每一个生成环节。这里有个细节,注意成本回调这个参数,它在第一步就出现了。选角色这个动作本身也是一次 LLM 调用,很便宜,但照样计费。
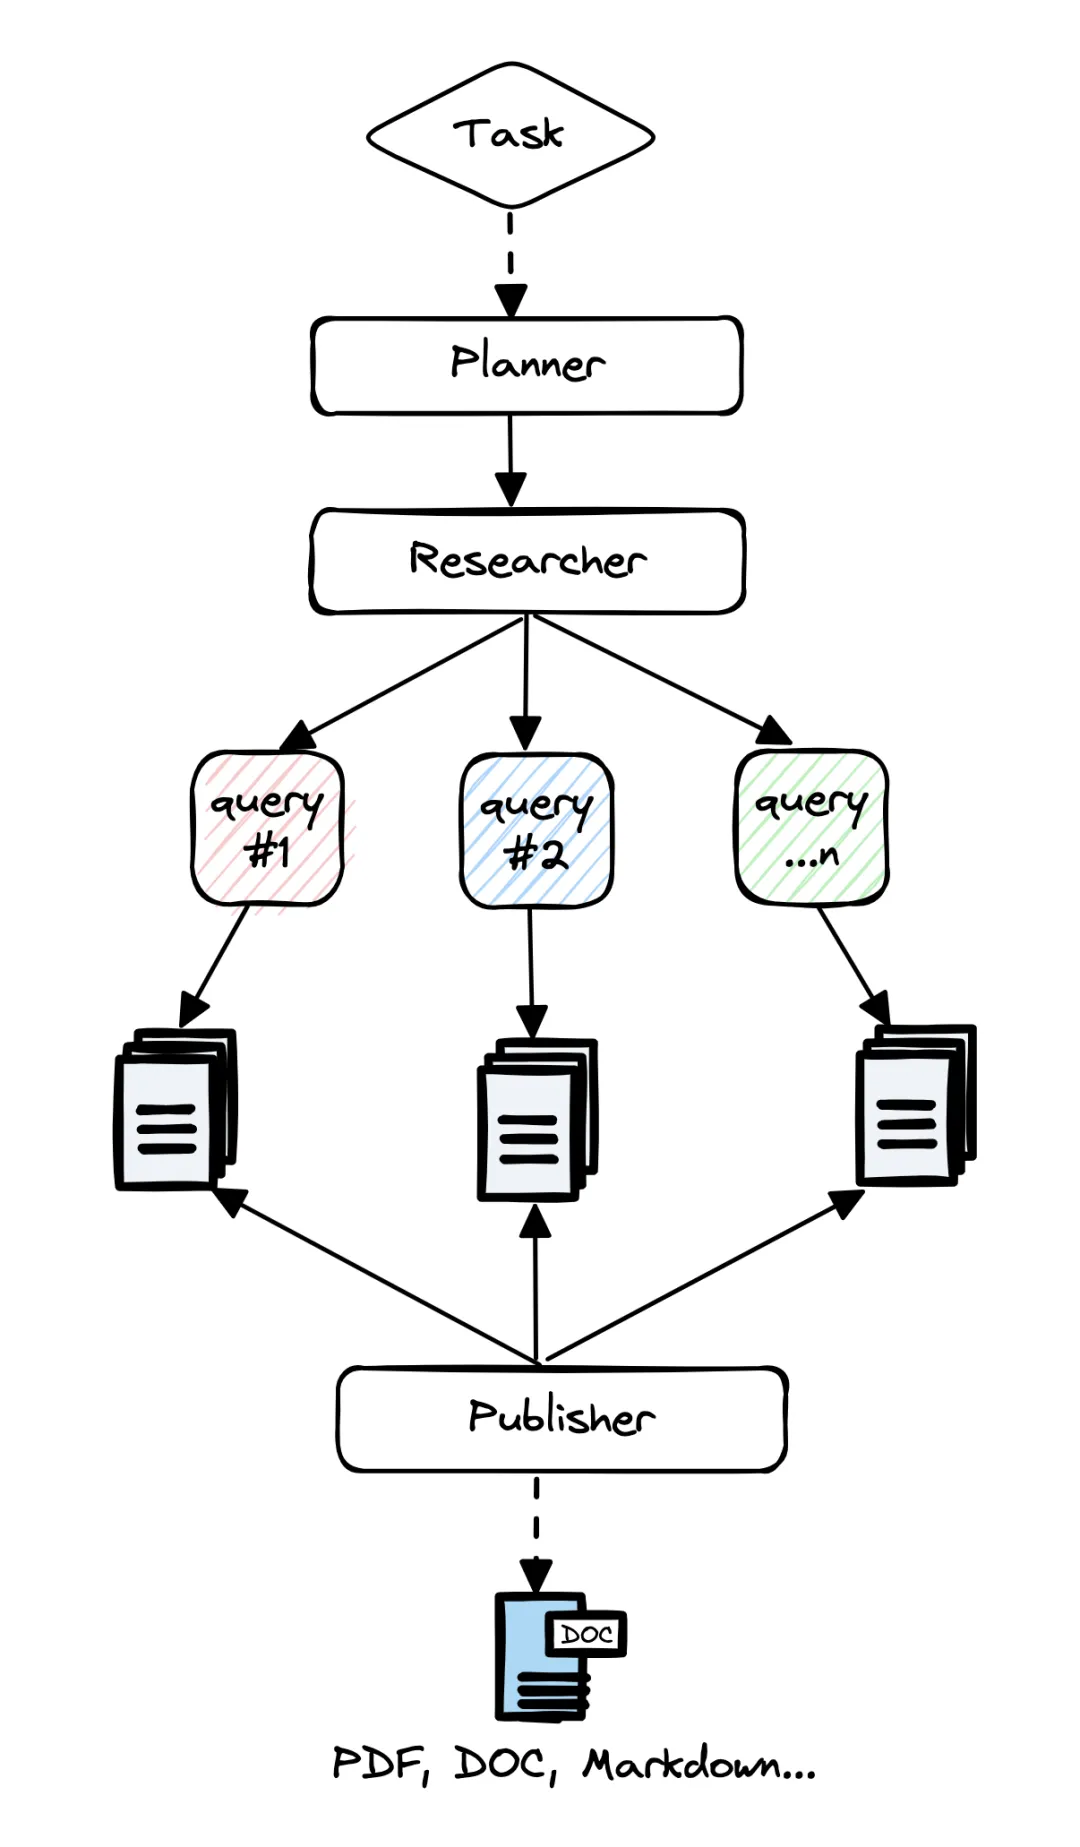
选完角色,开始规划。这一步会先跑一次初始检索,把结果喂给 LLM,让它生成 3 到 5 个子查询。
这 3 到 5 个子查询,是整个系统的并行单位。每一个后面都会独立跑一遍完整的检索、抓取、压缩。
所以想调这个系统的研究质量,真正的旋钮在这儿,不在模型参数上。子查询切得好不好,直接决定它最后能不能覆盖到想要的面。
如果报告类型传的是深度模式,流程到这儿就拐走了,普通子查询那条路一步都不走。
单个子查询要过五道手。先是 MCP 检索,再是网页检索,然后爬取,接着做嵌入相似度压缩,最后把两路上下文合并起来。
这五步里,有三处细节特别容易漏。
MCP 检索器是怎么被认出来的
靠类名字符串。类名转小写之后,去找里面有没有 mcpretriever 这个词。没有接口标记,没有抽象基类,就是纯字符串匹配。写自定义检索器的人想让自己的东西被当成 MCP 用,命名就得服从这个约定。这算不算好设计,挺可疑的,但它确实能跑。
已抓取的数据是作为参数传进来的
不是方法内部的局部变量。这个口子是给多智能体模式留的。上层已经抓过的内容,直接传进来,不用重抓一遍。
两路上下文是合并的
最后一步是把 MCP 和网页两路上下文拼在一起,不是二选一。私有数据源和公网结果会同时进入同一次研究的上下文。
接下来这一段,是整个项目里最值得抄的。
管上下文的那个类,自己不做任何匹配。它是个分派器,按数据源类型把活儿转给三个不同的压缩器。
抓来的网页交给第一个,返回 10 条,相似度阈值读配置,默认 0.42。向量库那一路交给第二个,返回 8 条。已经写好的章节交给第三个,也是 10 条,阈值写死 0.5。
前两个都好理解。第三个,有点东西。
它对付的是一个特别具体的麻烦。报告一旦长到需要分章节写,后面几节特别容易跟前面说重。内容一重复,读者立刻就走。
常规做法是什么。在 prompt 里加一句别重复前面的内容,然后祈祷模型听话。
它的做法是,把当前子主题,加上草稿里已经有的章节标题,拼成一批查询一起发出去,结果取并集去重,再截到 10 条。
这个操作值得琢磨一下。它把已经写好的内容,当成了一份可以检索的语料。每开一个新章节,先拿新章节的主题去这份语料里查一遍,看看有没有撞车。
前者是求模型自觉,后者是把重复变成一个可以计算的东西
注意,这一整段跟 AI 一点关系都没有,纯是工程思路
这也是整篇稿子想说的主线,后面还会回来。
嵌入向量是从统一的记忆模块拿的。压缩器自己不持有 embedding 模型,所以换模型只改一个地方。
下面聊聊检索器。这个目录底下导出了 21 个。
通用搜索最多,Tavily、Google、Bing、Brave、DuckDuckGo、Searx、Serper、SerpApi、SearchApi、Exa、BoCha,这一挂全在。学术源单独一组,Arxiv、Semantic Scholar、PubMed Central、OpenAlex。社交源有两个,Xquik 和 GetXAPI。剩下的 GroundRoute、CRW、MCP、Custom 归到其他。
21 个,覆盖面比想象中宽。
注册表就是一段 match 语句,配延迟导入。解析顺序是请求头优先,然后是配置,都没有就落到默认的 Tavily。名字写错,它不报错。
静默回落。
!踩坑提示 🕳
把检索器写成 RETRIEVER=tevaly,这个拼写错误不会抛异常,日志里也不喊一声,只会在若干小时之后让人纳闷,为什么今天的结果质量突然这么差。调检索相关问题的时候,第一个动作就该是确认实际生效的到底是哪个检索器。
然后说一个修得很漂亮的改动。
v3.6.1 之前,它判断检索回来的结果要不要再爬一次,靠的是这个条件,len(raw_content) > 100。
就是拿内容长度去猜内容的性质。超过 100 个字符,就认为这是个摘要页,得去爬原文。
这种代码能活很久,因为大部分时候它是对的。但它其实是错的,只是错得不明显。
现在改成检索器自己声明。PubMed Central 和自定义检索器声明为不需要,因为它们返回的就是全文。Tavily、DuckDuckGo、Searx 声明为需要,拿到的只是摘要,得去爬原文。
21 个检索器里目前只声明了 5 个,剩下的保留默认值,为的是不把社区已经写好的检索器搞坏。这个取舍挺成熟的,新契约先铺路,不搞一刀切。
把隐式的猜测,换成显式的契约
自己加一个检索器要四步。建文件,注册表里加一个分支,导出,然后用配置项启用。接口契约短得离谱,一个构造函数,一个搜索方法,返回的是一组带标题、链接、正文的对象。
深度研究是另一条路。三个参数决定这棵树的形状,每层展开几个子主题,递归几层,并行跑几个。给的默认值是 4、2、2。
算法本身是广度递归。研究主主题,按广度展开子主题,每个子主题再递归下去,最后汇总成一份报告。4 和 2 展开出来,就是一棵四叉两层的树。
内部状态分了三个列表攒着,结论、来源、上下文分开存。为的是跨分支汇总的时候,引用还能对得上号。
开销也集中在这条路上。这棵树上每一个节点,都会把前面那一整套流程完整跑一遍。
多智能体是另一套完全独立的流水线,用 LangGraph 编排的,角色比单智能体版本细得多。
主协调一个,深度研究一个,规划大纲一个,校验正确性一个,按反馈修订一个,汇总成稿一个,导出 PDF、DOCX、Markdown 一个。还有一个角色,留给人工介入。
流程是这样。先做初始研究,出大纲,然后对每一个大纲主题并行跑一轮研究、校验、修订的循环,跑完汇总,再导出。
这套东西里最容易失控的,就是校验和修订那个循环。
一个负责挑毛病,一个负责改。听着很合理对吧。但两个 LLM 凑在一起互相推,特别容易推到停不下来。修订完,校验又挑出新毛病,改完再挑,无限套娃。
v3.5.1 加了一个修订次数上限来兜这个底,v3.6.0 又给循环加了一道界,还引入了精确的哨兵值。多智能体跑飞一次的成本,比单智能体高一个量级,这个循环必须盯死。
回到 MCP。服务端配置写成一个对象列表,每一项声明它是本地 stdio 还是远程 WebSocket,各自的地址和凭据。
三种策略,差别只在调用频次。
fast 是默认值,只用原始查询跑一次 MCP,结果缓存起来复用。deep 是每个子查询都各跑一次 MCP。disabled 就是完全跳过。
第一种的实现就是前面那五步里的第一段。第一次跑完写进缓存,后面每个子查询直接复制一份走。覆盖度有损失,换来的是不用每个子查询都去敲一遍 MCP 服务。
工具也不是全量塞给模型的。先用 LLM 排一次序,只留前几名,要求它返回一个数组,每项带索引、工具名、相关度分数和理由。
MCP Server 那一侧已经拆到独立仓库了,供别的 AI 应用调用。
所有 prompt 收在一个类里,靠一个按报告类型分派的 match 来取。收成一个类,是为了让模型特定的变体能继承覆盖。
子查询规划那条 prompt 规定了三件事。生成几个,彼此不能重复,每一条都得是可搜的,输出要求是 JSON 数组。初始检索的结果会同批喂进去,所以子查询不是凭空想的。
报告生成那条是临场拼的,引用格式支持 APA、MLA、Chicago、Harvard、IEEE,再加上字数、语气、语言,还有图片嵌入指令。可用图片会以标题加链接的清单形式注入,要求用 Markdown 图片语法放到合适的位置。
配置是三级覆盖,环境变量盖 JSON 文件,JSON 文件盖默认值。
LLM 按用途拆成三个角色,这是成本控制最主要的抓手。FAST_LLM 调用次数最多,负责摘要压缩。SMART_LLM 写报告。STRATEGIC_LLM 管规划和选角色。想省钱,先动前两个。
检索侧的参数是这几个,每次检索取几条、最多爬几个页面、相似度阈值卡在多少。默认阈值 0.42。
这里是最容易绊人的地方。配置项在代码里一律小写访问,配置文件里写的是大写,代码里读的是小写。写插件的时候特别容易在这儿愣住。
还有个数字容易看岔。输出长度的默认值是 4000,但 v3.5.0 把上限从 32k 提到了 200k。这两个不打架,一个是开箱默认值,一个是允许的天花板,给长输出的模型留的空间。
图片那组参数有三项,模型指到一个 Gemini 的生图版本,最多生成 3 张,风格在 dark、light、auto 里挑。图片会在报告生成前并行预生成 2 到 3 张,落到一个按 research id 分的目录里。
成本这一块靠回调串起来。计费函数以回调的身份,一路传给所有 LLM 调用点,累计值最后从一个取值函数里读。
这个设计带来一个隐性的约束。新加一个 LLM 调用,如果忘了把这个 callback 接上,这次消耗就静默丢了,成本报告上看不见。v3.6.0 那条按真实用量计费修的,就是这一类遗漏,顺带把 Anthropic 的 cache 读写、OpenAI 的 prompt cache 折扣,都算进了成本。
从今年 4 月到 8 月,五个版本,主要在加固。先是把输出上限从 32k 提到 200k,改成从原生元数据里取 Anthropic 的用量。然后加了无来源时弃权、修订次数上限,还修了超大上下文塌缩成空的问题。接着做了 20 项检索器畸形结果防护,6 项爬虫健壮性修复,给多智能体修订循环加了界。最后是检索器显式声明要不要二次爬取,加了链路追踪,一次合入 97 个积压 PR。
这几个版本里,最值得在意的是两条。一条是检索结果为空的时候直接弃权,不生成报告。另一条是修掉超大上下文塌缩成空字符串那个 bug。
这两条都不算功能特性,属于长链路 Agent 才会碰上的失效模式。前者是幻觉防线,后者是上下文压缩在极端输入下的边界情况。搭过这类系统的人,看到这两条大概会心里一动。
写到这儿,有个念头冒出来。
这个项目里所有让人觉得聪明的地方,几乎都跟 AI 没关系
分层,是把职责切开。有状态和无状态那条线,是给状态找出边界。检索器自己声明要不要二次爬取,是把隐式的猜测变成显式的契约。那三个压缩器,一个分派,一个按需压缩。MCP 的三种策略,就是在延迟和覆盖度之间挑一个点。
这些都是软件工程几十年前就在做的事。分而治之,显式优于隐式,拿缓存换延迟。
AI 时代大家总爱说 Agent 是新的软件形态。可把这份代码从头翻到尾就会发现,Agent 的新意几乎全在它调用的那个模型里,剩下的部分,是四十年前写操作系统和编译器的人就已经想明白的东西。
所以如果也在搭自己的 Agent,这里有个不太成熟的看法。
最值得花时间的地方,可能不是 prompt 怎么写,也不是换个更强的模型,而是把它拆成几个能单独测试、能单独替换的块。模型会换,架构不用重来。
真正难的地方也不在调模型。子查询切多细,上下文压到多短,递归什么时候该收手,这几个判断没有标准答案,只能拿自己的语料和预算一点点试出来。
项目地址:https://github.com/assafelovic/gpt-researcher?__from__=talkingdev&utm_source=chatgpt.com
这个项目里最该抄走的第一样东西
把已经说过的话,变成可检索的语料
如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING
“关注公众号AI代码蜂巢x 获取更多信息”