ARTICLE · 1030383
AI 软件工厂:流水线开发 vs 传统团队,速度差距有多大?
原创 · AI工程实践笔记
“软件工厂”这四个字最近被反复提起,但讲法很乱。有人把它当成传统软件产品线的换皮,有人在 GitHub Copilot Workspace、Devin、Cursor Composer 之后把任何 AI 写代码的工具都叫软件工厂,也有人干脆拿它对比离岸外包。到底什么是 AI 软件工厂,它和过去的“工厂式开发”差在哪里?
这次我们不堆术语,只回答三个问题:AI 软件工厂到底在搭什么;它和传统软件产品线、传统外包工厂的区别在哪里;以及它现在能不能真正拿来跑业务。
一、它不是把程序员换成机器人
先澄清一个最大的误解。AI 软件工厂不是在搞“无人开发”。它要做的是,把过去散落在 Jira、Git、CI、测试、文档里的工程动作,串成一条可被大模型和 Agent 持续驱动的流水线。
Google Cloud 在解释“AI factory”时给过一个被引用很广的拆法:四个组件,分别是数据流水线、算法开发、软件基础设施、实验平台。这套结构的重点不是某一个模型,而是让模型可以在上面被持续训练、评估、部署和回滚。把它平移到软件开发场景,就是把“写代码、跑测试、合并、重构、发布、监控”这些动作,同样流水线化,再让 LLM 在每一步上嵌入。
换句话说,传统软件工厂的“人”被保留下来了,但“人”从写代码的工人,变成了流水线设计师和质量守门员。模型和 Agent 替代的是机械重复的部分,不是架构判断的部分。
二、和“软件产品线”到底差在哪
软件工程里有个老概念叫 Software Product Line(SPL,可复用软件产品线)。它强调一组共享核心资产,通过配置派生出多个产品,本质是“资产复用”。
AI 软件工厂和 SPL 至少有三个本质差别:
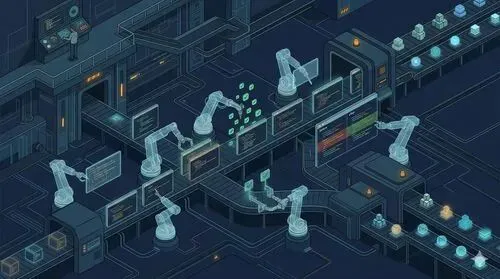
可以这么理解:SPL 是一条已经铺好的传送带,传送带上的工具是死的;AI 软件工厂是同一条传送带,但传送带上的机械臂可以被模型重新编程,每过一个产品它就改一次动作。
三、和离岸外包“软件工厂”不是一回事
另一个容易被混用的词,是传统外包行业讲的 Software Factory。它指的是 90 年代末到 2010 年代,TCS、Infosys、Wipro 这一波印度服务商替欧美企业做 Y2K 修复、应用开发、整套产品线交付时采用的项目组织方式,本质上还是按人头计价的离岸人力外包。
这种“软件工厂”有几个特征:
· 按工时和人数报价,和工厂计件很像;
· 团队驻扎在低成本地区,靠时差做 24 小时交付;
· 流程标准化,但代码本身是大量人工手写。
AI 软件工厂在底层逻辑上和它正好相反。它不是在另一个时区雇更多人来填工位,而是让现有团队在同一时区里,借模型和 Agent 把人均产出拉高。交付节奏从“按人头计件”转向“按价值计件”,需求拆解、代码生成、测试、Review 都被流水线化。
四、这条流水线到底长什么样
把抽象的“工厂”落到工程上,它大致是下面这条链路:
需求接入 → 代码生成 → 自动测试 → 代码评审 → 持续集成 → 灰度发布 → 线上监控与回滚
每一步都有 Agent 介入:
· 需求接入:把产品文档、用户故事自动拆成可执行任务,分给不同 Agent;
· 代码生成:基于仓库上下文、文档和历史 PR,让模型生成补丁或新模块;
· 自动测试:测试 Agent 自动写单测、跑回归,并把失败分类;
· 代码评审:评审 Agent 按团队规范逐行打标,把需要人介入的部分高亮;
· 持续集成:流水线 Agent 决定构建顺序、回滚点和合并策略;
· 灰度发布:发布 Agent 根据监控指标自动扩缩容、回滚;
· 线上监控:把异常日志和性能数据回流给模型,触发下一轮优化。
把它画成图,就是 addyosmani 提出的那条“agentic software factory as a closed loop”:从需求进,到代码出,再从线上数据回到流水线起点,形成闭环。
五、真实收益到底有多大
不堆宣传口号,看几个公开口径下的数字。
从一份咨询分析中给出的案例来看,企业在引入 AI 软件工厂模式后,常见的变化是:
· 一线开发人员的代码产出(含被接受的 PR)数量上升;
· 缺陷修复和回归测试的人工介入环节下降;
· 从需求到可运行版本的前置时间(Lead Time for Changes)显著压缩。
但要注意,这些都是“官方公布”或“项目文档显示”的数据,落地到不同团队差异极大。真正决定收益的,不是模型本身,而是仓库结构、CI 成熟度、代码规范、测试覆盖率这些老问题。换句话说,AI 软件工厂不是给混乱工程“擦屁股”的银弹,它更适合已经基本工程化的团队。
六、几个常见的坑
真正跑过才会发现,AI 软件工厂最容易栽跟头的地方是这些:
· 上下文不够。模型只看到几行代码,看不到整个仓库和上下游依赖,结果生成的代码能跑但风格不一致。
· 测试覆盖率不足。流水线再自动化,没有测试把关就只是更快的出错。
· 权限失控。Agent 能自动提 PR、自动合并,权限一旦没设好,事故放大速度也更快。
· 指标失真。用“代码行数”或“PR 数量”衡量 AI 工厂的产出,容易催生一堆看起来很热闹但没业务价值的提交。
这些问题,本质上都不是 AI 的问题,而是“工厂化”本身的问题。把工业流水线的那套管理逻辑生搬硬套到软件上,历史上有过教训;现在把 AI 嵌进去,并没有自动解决这些老问题。
七、它适合谁、不适合谁
先说适合的:
· 中大型团队,多个产品线并行,需求节奏快;
· 已有规范化的代码仓库、CI、测试体系;
· 有专门的平台工程团队负责维护流水线。
再说不适合的:
· 小团队或早期产品,需求每天还在变,硬上流水线只会拖慢节奏;
· 没有基本测试覆盖的“祖传代码”仓库;
· 把 AI 软件工厂当成“裁员替代”的项目来做,这通常会失败。
八、它和“AI 原生工程师”是什么关系
最近半年,业内开始频繁用“AI-native engineer”这个词来描述一类新角色:他们不是传统意义上的全栈工程师,而是懂得把模型、Agent、工具链组装起来的人。
AI 软件工厂,本质上就是这种新角色的工作环境。它不是把工程师换掉,而是给工程师一个新的操作系统:一个可以让模型、Agent、流水线协同工作的平台。在这个平台上,工程师的核心工作变成了三件事:设计流水线、定义质量门禁、处理模型搞不定的边界情况。
九、要不要现在就开始搭
我的判断是:可以开始,但别期望一步到位。
实际路径可以这样:
1. 先在一个已有产品线里挑一个边缘模块试点,跑通从需求到合并的最小闭环;
2. 把试点里用到的提示词、Agent 配置、流水线脚本沉淀成内部模板;
3. 等模板稳定、团队习惯之后,再横向铺到其他模块。
这个节奏看着不快,但已经是过去几年里被验证过的、比较稳的演进方式。它不是“上线即颠覆”,更像是软件工程自己的又一次工业化升级。
说到底,AI 软件工厂不是新瓶装旧酒,它是一条被重新定义的生产线;也不是万灵药,它对工程基础有真实要求。看清这两点,再决定要不要投入,可能比追任何一个新概念都更重要。