ARTICLE · 1050958
DeepSeek Harness 保姆级教程:安装配置、模式详解、Token消耗&竞品对比
向AI转型的程序员都关注公众号 机器学习AI算法工程
不同于传统 AI 对话工具,DeepSeek Harness 不是单纯的聊天模型,而是一套可插拔、可定制、可落地的 AI 智能体运行框架,能够直接读写本地文件、执行终端命令、自动化完成编码、重构、文档编写等开发任务,彻底实现「AI 从回答问题到动手干活」的跨越。
本文将从零起步,带你全面吃透 DeepSeek Harness:核心原理介绍、超详细安装部署、全模式功能解析、Token 消耗机制、主流竞品横向对比,新手也能一键上手!
一、DeepSeek Harness 核心介绍
1.1 什么是 DeepSeek Harness?
DeepSeek Harness 是 DeepSeek AI 推出的开源 AI Agent 运行框架,基于 MIT 开源协议,核心定位是 Model + Harness = 完整智能体。如果说大模型是 AI 的「大脑」,那 Harness 就是 AI 的「手脚与操作系统」。
传统大模型只能输出文本内容,无法对接本地环境、无法执行实操任务;而 DeepSeek Harness 作为中间运行框架,打通了大模型与本地设备的壁垒,支持文件读写、终端命令执行、工具调用、流程自动化、插件扩展,是真正面向开发者的工程化 AI 编程助手。
1.2 核心四大特性
一切皆插件(核心亮点):基于 Cordis 插件架构,文件编辑、命令执行、网页检索、模型适配等所有能力均可插拔替换,无需修改源码即可自定义功能,扩展性拉满
可视化操作界面:无需命令行硬操作,自带 Web UI,任务执行流程、工具调用记录、Token 消耗全程可视化,新手友好
安全可控机制:分级权限管控,文件修改、终端执行等敏感操作需人工审批
但请务必看清官方声明:官方 Safety Notice 的原话是「沙箱降低风险,但不保证完全隔离」(sandboxing reduces but does not guarantee isolation)。官方推荐的最小权限实践是:在一次性虚拟机或容器里运行。 我的建议是——不要把 DSH 直接挂到你的生产项目目录上,拿一个专门的测试目录先跑顺手。
轻量化低成本:部署极简、无冗余依赖,内置智能缓存机制,Token 消耗远低于同类竞品,日常开发几乎零成本
二、DeepSeek Harness 超详细安装部署(保姆级)
DSH 基于 Node.js 运行,仅需两步即可完成部署,支持 Windows/Mac/Linux 全平台,官方提供 Npx 快速启动 和 全局安装 两种方式,下面逐一讲解,附带报错解决方案。
2.1 前置环境准备(必看)
DeepSeek Harness 强制要求 Node.js 22.0 及以上 LTS 版本,低版本会直接启动失败,这是90%新手报错的核心原因。
前往 Node.js 官网 下载最新 LTS 版本
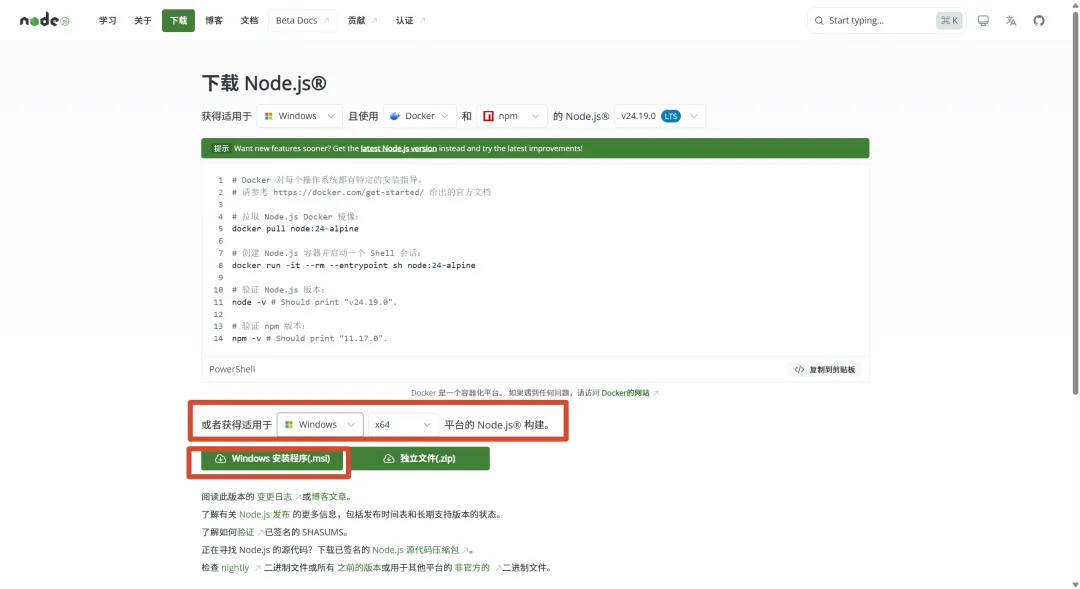
安装时默认勾选
AddtoPATH,自动配置环境变量安装完成后,打开终端(Windows 用 PowerShell,Mac/Linux 用原生终端),输入以下命令验证:
node-v
npm -v
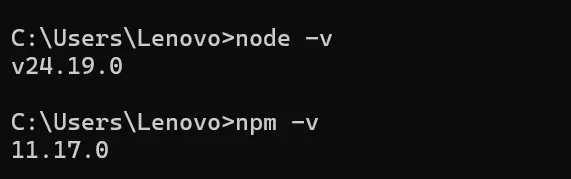
输出版本号即代表环境配置成功,若提示「不是内部命令」,需重启终端或手动配置环境变量。
2.2 两种安装启动方式
方式一:Npx 临时启动(推荐新手,无需全局安装)
无需占用本地全局依赖,用完即走,一键启动 Web 界面,适合临时体验、偶尔使用的场景。终端输入:
npx@deepseek-ai/dsh web
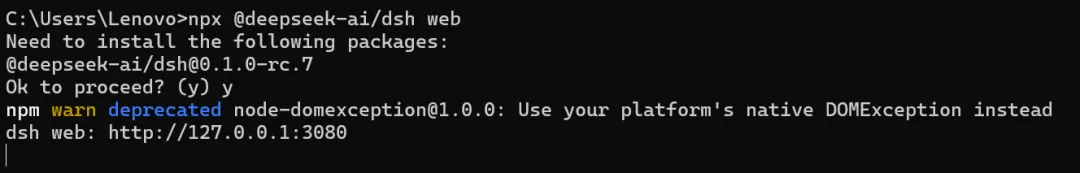
首次执行会自动下载依赖,等待1-2分钟,终端输出以上内容即启动成功。
方式二:全局安装(推荐长期使用)
全局安装后可任意目录快速启动,无需重复下载依赖,稳定性更高:
# 全局安装
npm install -g @deepseek-ai/dsh
# 启动 Web UI
dsh web
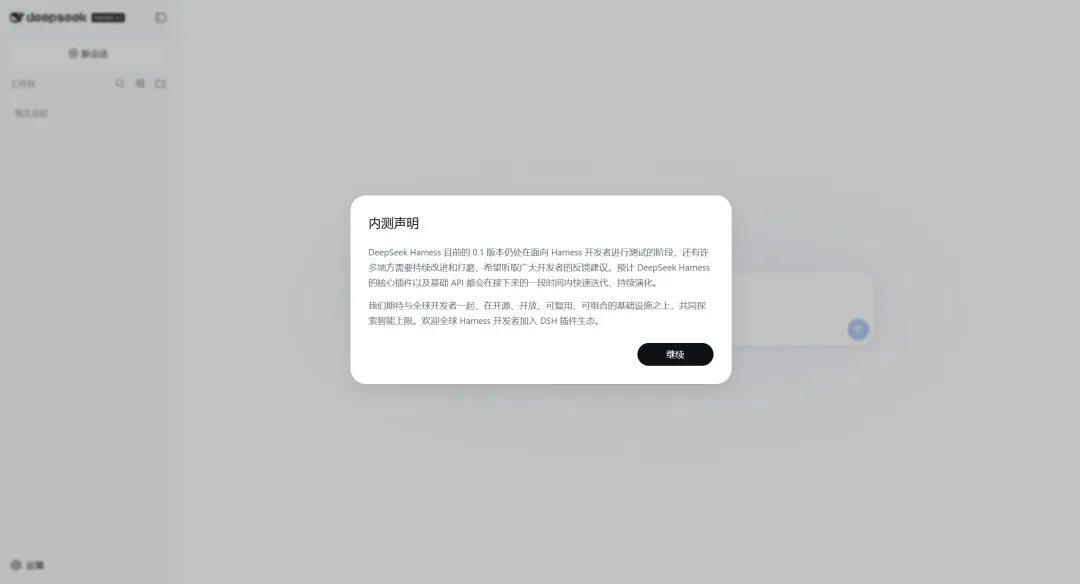
启动成功后的界面(在浏览器地址栏搜索http://127.0.0.1:3080):
2.3 常见报错与解决方案(细节避坑)
问题1:下载依赖超时、速度极慢 解决方案:切换 npm 国内镜像源,终端执行:
npm config set registry https://registry.npmmirror.com问题2:3080 端口被占用 解决方案:自定义端口启动,命令如下:
npx @deepseek-ai/dsh web --port 8080访问地址改为http://127.0.0.1:8080问题3:Node 版本过低报错 解决方案:卸载旧版本 Node,重装 22+ LTS 版本即可
问题4:浏览器打不开界面 解决方案:以终端输出的访问地址为准,关闭代理,重启终端重新启动
2.4 初始化配置
启动成功后,浏览器打开对应地址,完成基础配置:
配置模型 API:支持 DeepSeek 官方 API、本地私有化模型、第三方兼容模型
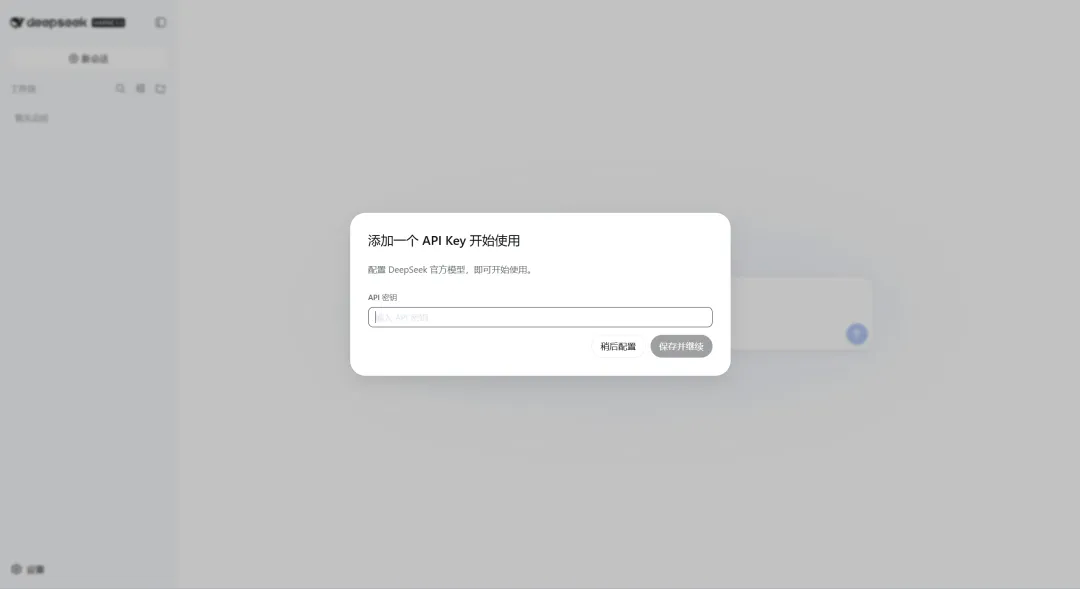
💰 关于费用,提前说清楚: DSH 框架本身是 MIT 开源、免费的,但它不自带模型——你需要自己准备 API Key。用 DeepSeek 官方 API 的话,是按 Token 计费的,需要去 DeepSeek 开放平台注册并充值。
也就是说:框架免费 ≠ 使用免费。好消息是 DeepSeek 的定价在业内属于很便宜的一档,日常学习用的开销通常在几块钱到几十块钱的量级(具体看你的使用强度)。
如果你想完全零成本,也可以接本地模型(比如用 Ollama 跑的开源模型),但效果会有明显差距,新手不建议一开始就走这条路。
2.选择工作区:绑定本地项目文件夹,限定 AI 操作范围(保障文件安全)
3.选择权限模式:默认推荐 Workspace Write 工作区读写模式
三、DeepSeek Harness 核心模式详解 & Token 消耗机制
3.1 四大内置 Agent 预设模式(功能全覆盖)
DSH 内置4种核心运行模式,适配不同开发场景,不同模式的工具权限、执行逻辑、Token 消耗差异极大,按需选择可大幅降低成本。
1)标准模式(默认推荐)
核心能力:全功能编码 Agent,支持文件编辑、Shell 命令、网页检索、计划任务、子代理、工作流自动化,覆盖90%日常开发场景
适用场景:项目开发、代码重构、BUG 修复、文档生成、批量任务处理
Token 消耗:均衡模式,上下文缓存命中率高,中等任务消耗可控,性价比最高
2)极简模式
核心能力:只保留一个 shell 工具 + 一个文件编辑工具,砍掉全部插件与检索能力
官方定位:这是给「最小环境下的模型基准测试」用的——它存在的意义是让不同模型在同样极简的工具集下跑分对比,而不是给你日常开发省 Token 用的
适用场景:跑分测试、评估模型裸能力、以及在极端受限环境下做最简单的文件操作Token 消耗:工具定义少,上下文开销确实最低,但代价是能力也最少
💡 日常开发我还是建议用标准模式。极简模式省下来的那点上下文,远不如插件带来的能力值钱。
3)PTC 模式
核心能力:PTC = Programmatic Tool Calling(程序化工具调用)。它的思路是:不让模型一轮一轮地发工具调用请求,而是让模型**直接生成一段代码**,由这段代码在本地编排完成多轮工具调用,最后只把结果返回给模型
好处:减少模型往返次数,也就减少了重复的上下文传输,对多步骤、强依赖的任务收益明
适用场景:需要串联 5 步以上的复杂流程、批量自动化脚本、对执行顺序有严格要求的任务
Token 消耗:偏高,程序化校验会增加少量 Token 开销,但任务执行精度更高
4)创造模式
核心能力:包含标准模式全部能力,额外开启插件调试、运行时检测、自定义预设创作功能
适用场景:插件开发、框架二次开发、自定义 Agent 配置
Token 消耗:最高,全程日志记录、实时校验,适合开发调试,不适合日常使用
3.2 权限运行模式(安全+成本关键)
除了 Agent 预设,DSH 还有3档权限模式,直接决定操作范围和 Token 消耗:
Read Only(只读模式):仅读取文件、查询信息,无修改权限,Token 消耗最低,适合代码解读、问题咨询
Workspace Write(工作区读写):仅操作绑定的项目文件夹,支持文件修改、命令执行,日常开发首选,成本均衡
Full Access(全权限):可操作本地系统全部文件、全局命令,风险高、Token 消耗偏高,仅特殊场景使用
3.3 Token 消耗核心机制(省钱必看)
DeepSeek Harness 相比同类工具最大的优势就是极低的 Token 损耗,核心得益于两大机制:
智能上下文缓存:重复读取的代码、配置文件、工具指令会缓存,命中后这一部分的输入 Token 按缓存价计费(通常显著低于正常输入价,具体折扣以 DeepSeek 官方定价页为准)。长会话反复引用同一批文件时,这个机制省得很明显。
按需加载插件:不会一次性加载所有工具能力,根据任务动态启用插件,减少无效上下文 Token 占用
关于具体消耗,我就不给数字了。原因很简单:Token 消耗跟项目规模、上下文长度、插件数量强相关,别人的数字对你没有参考价值。
建议你自己跑一次:随便找个熟悉的小项目,让它改个 bug,然后去 Web UI 的任务详情里看 Token 明细。自己看一眼,比看十个博主给的数字都准。
四、DeepSeek Harness vs Claude Code vs OpenAI Codex 全方位对比
目前主流 AI 编程 Agent 三足鼎立,下面从开源性、部署难度、Token 成本、扩展性、实操能力五大核心维度做横向对比,帮你精准选型。
| 开源协议 | |||
| 部署难度 | |||
| Token 成本 | |||
| 扩展性 | AGENTS.md 等自定义方式 | ||
| 本地实操能力 | |||
| 可视化体验 | |||
| 适用人群 |
我的选型建议:
想搞懂 Agent 是怎么跑起来的、或者要定制自己的 Agent → DSH。它的"一切皆插件"让每个零件都能拆下来单独看,是目前最好的开源教材。只想安安静静写代码、不想折腾 → Claude Code 或 Codex。开箱即用,生态成熟,出问题也好查。现在就想上生产 → 谨慎。DSH 目前是开发者预览版,官方明确说明会有破坏性变更,务必锁定版本号。
一句话:别把它当"免费版的 Claude Code",把它当"Agent 的乐高积木"。 这两个期待值是完全不同的
五、DeepSeek Harness 插件
依托「一切皆插件」的核心架构,DSH 社区已诞生大量优质插件和美化皮肤,可快速拓展功能、优化界面体验。
5.1 怎么找插件 & 怎么装
先说找插件的两个入口:
1. GitHub topic 检索:搜索 `dsh-plugin` 这个 topic,社区插件基本都打了这个标签2. 社区插件市场:在 Web UI 的插件页面直接浏览
安装命令(`plugin add` 后面的名字请替换成你实际查到的插件名):
# 安装插件dsh plugin add <插件名>
# 查看已装插件dsh plugin list
# 移除插件dsh plugin remove <插件名>
⚠️ 我本来想在这一节列五个具体插件,但翻了一圈发现社区插件迭代太快,写死的推荐清单一个月就会过时。
所以这里给你方法而不是清单——按上面的 topic 去搜,按装star 排序,前几个基本都能用。
5.2 两个必学的调试命令
这两个命令是我用下来最有用的,比任何插件都值钱:
# 看清启动时到底加载了哪些插件、用了什么配置# 这是理解"一切皆插件"最快的方式dsh --profile web --dump-config
# 查看当前会话的完整轨迹(模型看到了什么、调用了什么工具)# 出问题时先看这个,基本能定位 80% 的问题dsh trajectory list
5.3 追记式会话日志 & Trajectory 视图(DSH 最被低估的特性)
这是我觉得 DSH 最值得吹、但很多人没注意到的功能:
模型看到的每一次上下文注入都会写进一份 append-only(只追加)日志
这份日志可以回放(看当时模型到底看到了什么)、恢复(中断后接着跑)、分叉(从某一步重新走另一条路)
这意味着什么? 意味着 Agent 不再是黑盒。跑出来的结果不对,你能一步步倒推回去看是哪一轮的上下文出了问题。对想学习 Agent 原理的人来说,这比任何文档都管用。
六、总结
DeepSeek Harness 作为新晋开源 AI 智能体框架,彻底打破了传统 AI 编程工具的局限,凭借全插件化架构、轻量化部署、极低 Token 消耗、可视化实操、开源免费五大核心优势,实现了对 Claude Code、OpenAI Codex 的全面赶超。
对于普通开发者:它是低成本高效的编码助手,自动完成开发琐事,降低 AI 编程使用成本;对于高阶开发者:它是可二次开发的智能体底座,可自定义插件、搭建专属自动化工作流;对于团队用户:它安全可控、流程透明,可落地于实际项目开发。
最后,说点我自己的判断
写完这篇教程、也实际用了一段时间之后,我的建议是这样的:
如果你只是想让 AI 帮你写代码 → 现阶段别碰 DSH。它是开发者预览版,官方明确说会有破坏性变更,API 说变就变。用成熟工具省心得多。
如果你想搞清楚 Agent 到底是怎么跑起来的 → 强烈推荐。它把"文件编辑""命令执行""工具调用"这些能力全部做成了可插拔的插件,每个零件都能拆下来单独研究。配合 Trajectory 的回放能力,你能清清楚楚看到模型每一步看到了什么。这是目前最好的开源教材。
如果你要做团队自动化 → 等 1.0。现在拿它跑生产,是在给自己找麻烦。
工具会过时,但"理解 Agent 的运行时是怎么组织的"这件事不过时。
机器学习算法AI大数据技术
搜索公众号添加:datanlp
长按图片,识别二维码
阅读过本文的人还看了以下文章:
【模型高效部署】tensorrtx 深度解读,yolov11高性能推理实战案例
整理开源的中文大语言模型,以规模较小、可私有化部署、训练成本较低的模型为主
基于40万表格数据集TableBank,用MaskRCNN做表格检测
《深度学习入门:基于Python的理论与实现》高清中文PDF+源码
2019最新《PyTorch自然语言处理》英、中文版PDF+源码
《21个项目玩转深度学习:基于TensorFlow的实践详解》完整版PDF+附书代码
不断更新资源
深度学习、机器学习、数据分析、python
搜索公众号添加:datayx