ARTICLE · 1215886
Headroom:给 AI 编码助手的上下文装上"限高杆"
Headroom:给 AI 编码助手的上下文装上"限高杆"
75.3k 星GitHub 热度60-95%JSON 压缩率答案不变官方宣称同结果省 token
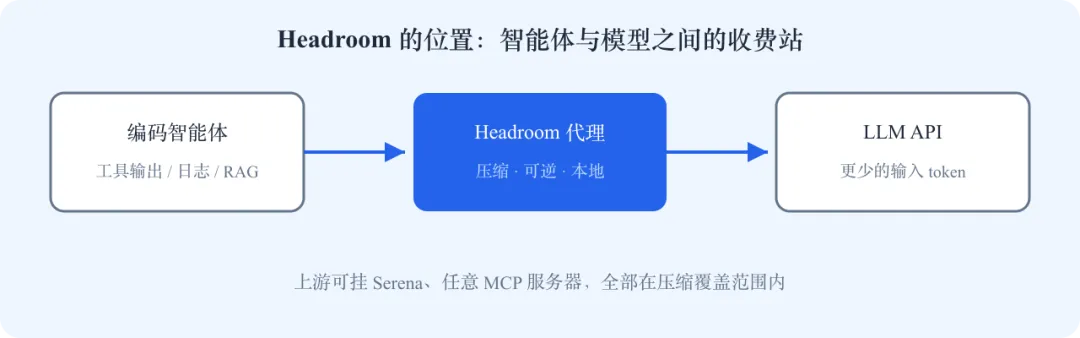
AI 编码助手最贵的不是模型,是它读进去的每一坨废话。一次 grep 返回两千行日志、一个 API 吐出五十页 JSON、RAG 检索塞回十个半相关的文档块——这些未经消化的原料直接灌进上下文窗口,按 token 计费、按 token 挤占注意力。Headroom 的思路简单粗暴:在这一切到达模型之前,先过一遍"压缩收费站"。本周它以单日 317 星再次冲上 GitHub Trending,总星数已到 75.3k。
它压缩的不是对话,是流经的一切
Headroom 的官方描述值得逐字读:"在工具输出、日志、文件和 RAG 块到达 LLM 之前压缩它们——编码智能体省 20% token,JSON 省 60-95%,答案不变。"三种交付形态:库、代理(proxy)、MCP 服务器。定位上它把自己摆在"管道"的位置:README 里那张对比表写得很直白——Compresr 这类托管 API 只压缩发给自己的文本、不可逆;OpenAI 官方 Compaction 只管对话历史、不可逆;而 Headroom 是代理,压缩流经它的一切——工具输出、RAG、日志、文件、历史,本地部署、可逆。
"可逆"是容易被忽略的关键词。压缩类工具最大的信任危机是"你压掉的东西万一正是我要的呢",Headroom 的答案是压缩发生在传输层,原始数据仍在下游可达——它更像视频编码里的码流优化,而不是把书烧成摘要。文本压缩背后是一个开源在 Hugging Face 上的专用模型(Kompress-v2-base),对 JSON 这种结构冗余极高的格式,60-95% 的压缩率并不神奇:重复的键名、嵌套的样板、大段空值,本来就是可以无损或近无损折叠的东西。
一个代理,接住所有上游
用法上它走的是"包一层"的路线:`headroom wrap` 把智能体的 API 流量劫持到代理后面,上游指向任意 OpenAI 兼容端点(文档特意提醒第三方供应商要传 --openai-api-url,否则你的 key 会被发给 OpenAI 吃 401——这种坑说明它真被大量接进了 DeepSeek、OpenRouter 和自建网关)。官方推荐的搭档是语义代码导航工具 Serena(wrap 时默认安装),再配一个精简模型输出的 Ponytail;你也可以挂任何自己的 MCP 服务器,Headroom 在所有这些的下游做压缩。
谁最需要它?重度使用 Claude Code、Cursor、OpenCode 这类智能体的开发者:他们账单的大头往往不是"模型思考",而是反复回灌的构建日志、测试输出和搜索结果。对做 RAG 应用的团队同样直接——检索块质量参差、宁滥勿缺是常态,入库前压一道等于同时省钱和给注意力窗口减负。与同类方案(Caveman 那类"让模型少说话"的输出端优化)相比,Headroom 吃的是输入端,两者理论上可以叠加。Apache 2.0 协议、Rust 写的核心 crate、Docker 与 devcontainer 齐备,接入摩擦很低。
省 20% 听着寒酸,乘以一万次就不寒酸了
对编码智能体只省 20%,这个数字乍看不惊艳,但要放在正确的分母上看:智能体是长会话、高频调用的场景,一次任务几十轮工具往返,每轮都带着滚动的历史——20% 是乘在调用次数和上下文长度上的复利。更要紧的是上下文污染:塞得越满,模型抓错重点的概率越高,压缩带来的"变聪明"可能比"变便宜"更值钱。推测这也是它把 Serena 设为默认搭档的原因——先让智能体精准取码,再压缩兜底,两头一起挤水分。
值得警惕的一面:压缩层坐在你和模型之间,它"认为不重要"而折掉的内容,你并不总是知道。可逆设计缓解了这一点,但关键任务上仍建议对照裸跑验证。上下文工程正在成为一门独立手艺——窗口越来越大没有消灭这个问题,只是把账单推迟了。
核心观点:如果你的 AI 编码月账单里"输入 token"占大头,Headroom 是目前性价比最高的一次实验:wrap 一层、Apache 2.0、不动任何业务代码,跑一周对比账单和答案质量再决定去留。上下文不是燃料,是氧气——限高杆省下的每一克都会复利。
— END —
LC 智趣厅 · 科技与生活的交点
ihygg.cn