ARTICLE · 1240864
315KB 变 5.4KB:这个开源插件号称帮 AI 编程 Agent 省 98% 的 token
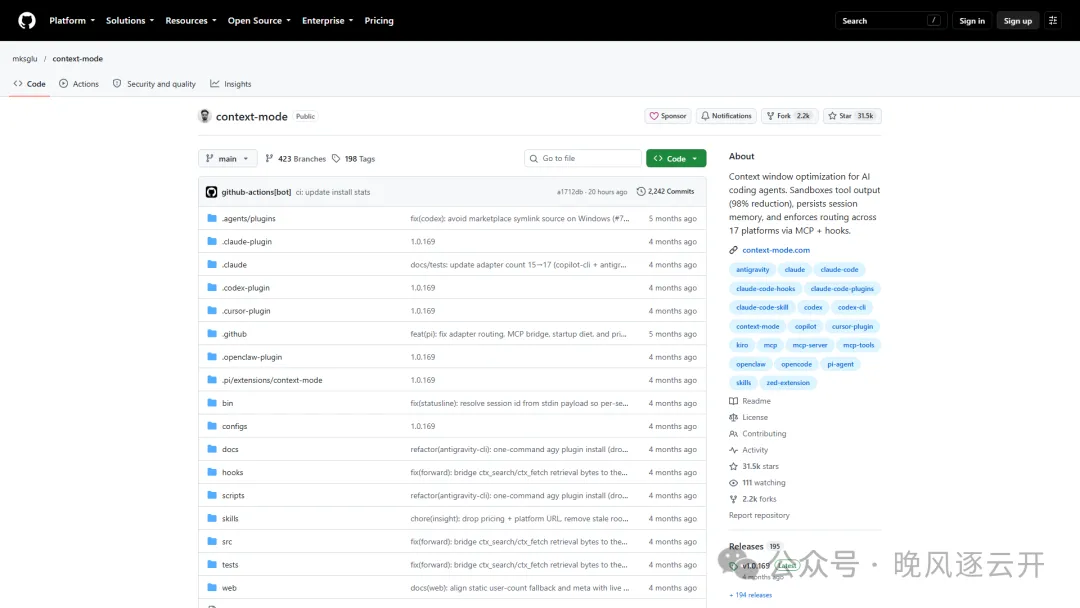
最近,一个登上过 Hacker News 第一的开源项目在程序员圈子里刷了屏——Context Mode(GitHub: mksglu/context-mode)。README 里的数据很唬人:一场完整的编码会话,原始输出 315KB,经过它处理只剩 5.4KB;会话有效时长从约 30 分钟拉长到约 3 小时。项目作者的宣传语更是直白:"如果你还没用这个,那你就是在白白烧 token——它能把编程 Agent 的 token 消耗最多砍掉 98%。"
它到底是黑魔法,还是营销数字?我把它的仓库翻了一遍,这篇就来拆解:钱到底烧在哪、它怎么省、数字怎么看、值不值得装。
用过 Claude Code、Cursor 这类编程 Agent 的人都有体感:聊着聊着,模型开始"变笨"——忘了改到哪个文件、重复问你要信息、答非所问。这不是模型变笨了,是它的"工作记忆"(上下文窗口)被塞满了。
Context Mode 的 README 里给了一组很有画面感的数字:
• 一次 Playwright 页面快照:56KB • 拉取 20 个 GitHub Issue:59KB • 读一份访问日志:45KB
这些工具调用的原始返回值,会原封不动地堆进上下文。半小时下来,40% 的上下文窗口没了——装的还全是你根本不需要逐行看的"过程数据"。
更糟的是连锁反应:上下文满了,Agent 就触发压缩(compact),把旧对话挤掉来腾地方。压缩是有损的——它正在改哪些文件、进行到哪一步、你上次的反馈是什么,全可能被挤掉。于是你不得不把需求重新讲一遍,这些重复的输入输出,又是一笔 token。
也就是说,浪费是双向的:输入侧被原始数据灌满,输出侧还夹着寒暄和废话。
二、它的思路:数据不许进会议室,只许递结论
Context Mode 本质上是一个 MCP 服务器 + 一组钩子(hooks)。它的核心哲学一句话就能说清:LLM 应该拿到的是"结论",而不是"原始数据"。
具体拆成三招。
第一招:沙箱执行,只放行 stdout
以往 Agent 分析一份日志,是把整份日志读进上下文再"用眼睛看"。Context Mode 把这一步搬进了隔离子进程(沙箱)里:支持 JavaScript、TypeScript、Python、Shell、Go、Rust 等 12 种语言,脚本在沙箱里跑,只有最终的 stdout 会进入对话上下文,原始数据从头到尾不落地。
举个它 README 里的例子:想让 Agent 统计 50 个 TypeScript 文件的行数——
• 老做法:47 次 Read 调用,约 700KB 进上下文; • 新做法:写一段脚本在沙箱里循环读取、计数、只 console.log汇总结果,3.6KB 搞定。
这就是它的第二条理念——
第二招:Think in Code——让模型当程序员,别当计算器
它强制推行一个范式:能用代码算的,绝不用模型"看"。模型的角色是写分析脚本,而不是把 50 个文件读进脑子里逐个数。一次脚本调用替代十次工具调用,上下文开销差出两个数量级。
这个思路其实和很多资深工程师手动用 Claude Code 的习惯一致:与其让它翻文件,不如让它先 grep、先写个临时脚本。Context Mode 只是把这件事变成了强制的、自动的路由——你的每次工具调用都会被钩子拦截检查:"这个活儿,是不是该进沙箱干?"
第三招:会话记忆,压缩后不再"失忆"
针对 compact 失忆问题,它把会话里的每个关键事件——文件编辑、git 操作、任务状态、报错、用户决策——全部记录到本地 SQLite 数据库。压缩发生时,它不把这些数据重新倒回上下文(那就白省了),而是先建快照;之后用全文检索(FTS5 + BM25 排序)按需捞出当前相关的那几条,让模型"无缝续班"。
搜索这一层做得相当细:双路检索(词干匹配 + trigram 子串匹配)用倒数排序融合(RRF)合并、多关键词按邻近度重排、Levenshtein 距离纠错(把 kuberntes 自动纠正成 kubernetes)、返回围绕关键词的智能片段而非截断。另外还有 TTL 缓存——同一个 URL 文档 24 小时内不重复抓取,命中缓存只花约 0.3KB 而不是重新拉 48KB。
还有个防钻空子的细节:渐进式节流。前 3 次搜索正常返回,第 4~8 次开始减少结果并警告,第 9 次起直接拦下,逼模型改用批量接口——防止"搜索上瘾"反过来把上下文吃回去。
三、数字说话:官方基准
README 给的基准数据(原始体积 → 进入上下文的体积):
整场会话汇总:315KB → 5.4KB,会话可用时长从约 30 分钟延长到约 3 小时。
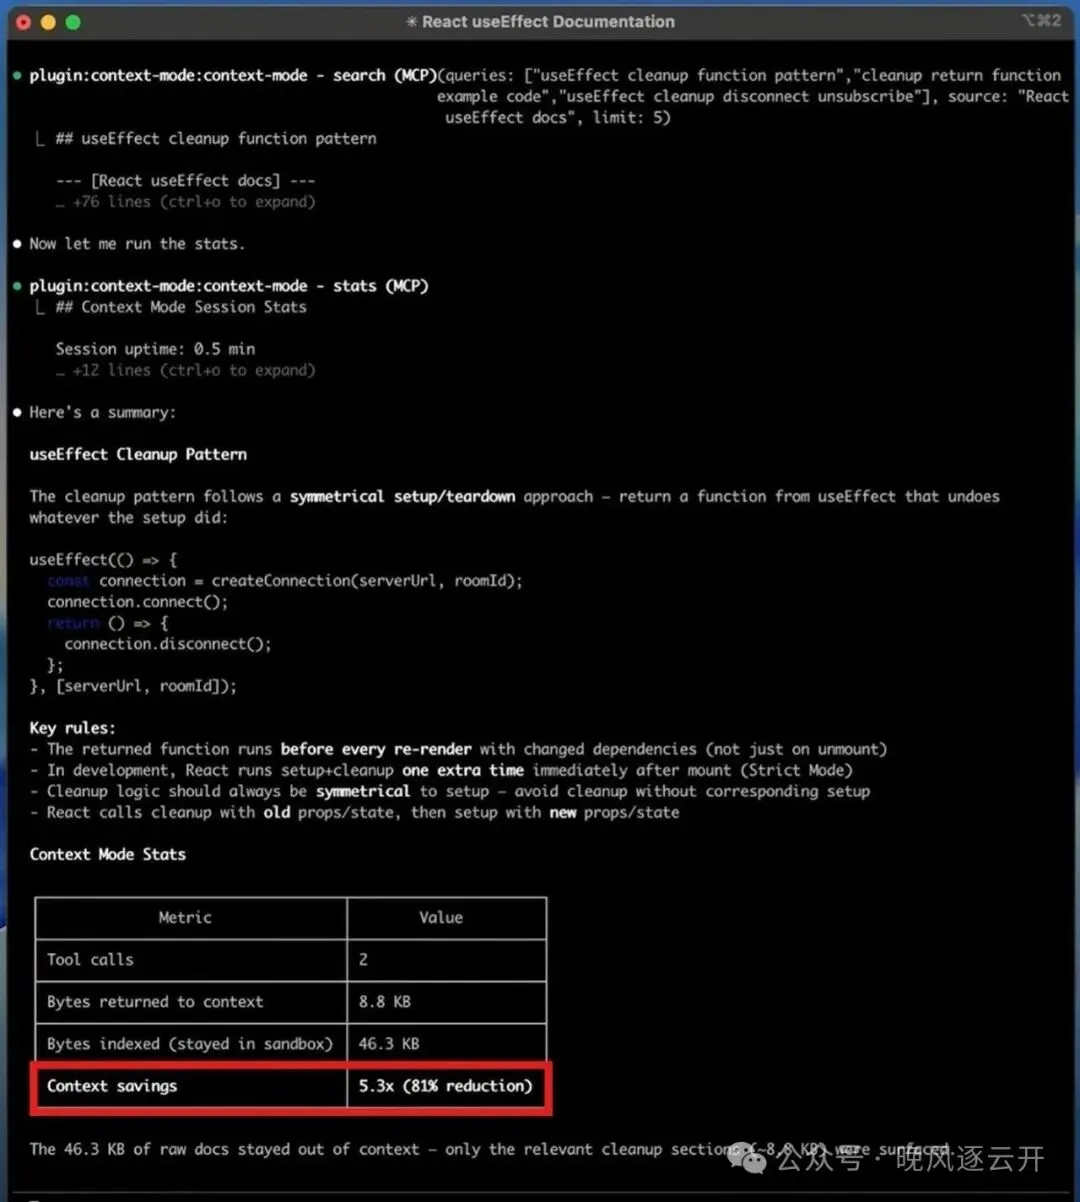
项目作者也展示过一段实测终端画面:一次 React 文档检索,46.3KB 的原始文档留在沙箱里没进上下文,只有约 8.8KB 的相关片段被递给模型,统计面板显示 Context savings:5.3x(81% reduction):
四、三行命令装上(以 Claude Code 为例)
/plugin marketplace add mksglu/context-mode/plugin install context-mode@context-mode重启后运行 /context-mode:ctx-doctor 自检,全部打勾即可。之后全程自动:钩子会在会话启动时注入路由规则,把该进沙箱的工具调用自动引流,你几乎感知不到它的存在。想看省了多少,随时敲 /context-mode:ctx-stats。
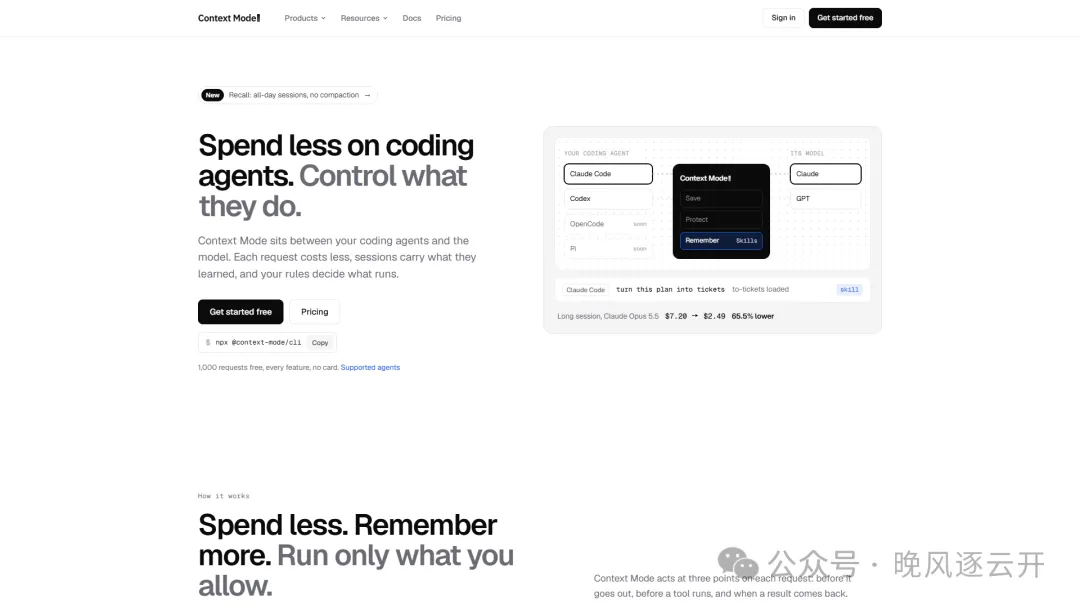
项目官网同样简洁,首屏一句话点明定位——"让编程 Agent 花得更少,由你决定它们做什么":
除了 Claude Code,它还支持 Gemini CLI、Codex CLI、Cursor、Copilot、OpenCode 等一长串客户端(官方标称 17+)。但要注意区分:在有钩子支持的平台上是硬拦截,节省约 98%;在不支持钩子的平台(如 Zed)只能靠提示词文件"劝"模型,实测约 60%。
隐私方面它是全本地方案:没有遥测、没有云同步,SQLite 数据就在你自己的家目录里;沙箱还会继承你已有的权限规则——你在 Claude Code 里禁了 sudo,沙箱里同样禁。
五、冷静看:光鲜数字背后的三点保留
工具是真好用还是精装修?我觉得有三点值得在动手前想清楚。
其一,"98%"是最优场景值。 这个数字成立的前提是钩子全部生效、且任务恰好是"大体量原始数据 + 只要结论"的类型(日志分析、网页抓取、批量调研)。日常写代码里大量的小规模 Read、Edit,本来就省不了多少。真实的全场景节省率会明显低于 98%——它自己 README 里也承认无钩子环境只有约 60%。
其二,检索替代全文,有信息损耗风险。 "只看相关片段"的反面是:万一检索没命中真正关键的那一行,模型就在不知道的情况下漏掉了它。全量上下文贵,但胜在"都在"。对高风险操作(安全审计、生产排查),这个 trade-off 需要自己掂量。
其三,营销话术要打折听。 "被 Microsoft、Google、Meta 员工使用"来自 README 里一排无法验证的徽章;"Hacker News 第一"倒是真的(570+ 分),但社区热度和长期可靠性是两回事。它的许可证是 Elastic License 2.0(限制托管转售),不是传统开源的 MIT/Apache,企业引入前值得过一眼法务。
写在最后
抛开宣传水分,Context Mode 戳中的问题是真实且普遍的:上下文窗口是 Agent 时代最贵的资源,而我们每天都在往里面倒垃圾。"沙箱跑数据、只递结论、状态落库、按需检索"这套组合拳,方向上没有争议——它本质上就是把软件工程里最古老的智慧(写程序处理数据,而不是人肉读数据)搬进了 Agent 的工具调用层。
如果你日常重度使用 Claude Code 或同类工具,花两分钟装上试试,再用 ctx-stats 看看自己的真实节省率——那个数字,比任何宣传语都有说服力。
参考资料:
• Context Mode GitHub 仓库:github.com/mksglu/context-mode • Context Mode 官网:context-mode.com
一键三连「点赞」「转发」「小心心」 欢迎在评论区留下你的想法!
KEEP EXPLORING…
🌟 点亮星标 🌟
愿你的每一次尝试,都有回响