ARTICLE · 1249552
PDF 表格一解析就乱?微信开源 WeVisDoc,专攻这些难页
你好,这里是晴天AI实验室!
做论文整理、PDF 翻译、知识库,最烦的往往是同一件事:字识别出来了,表格却串行,公式变乱码,两栏正文混成一段。
腾讯微信视觉团队开源的 WeVisDoc,值得从这个问题看:输入整页图片,直接输出包含正文、LaTeX 公式和 HTML 表格的 Markdown。
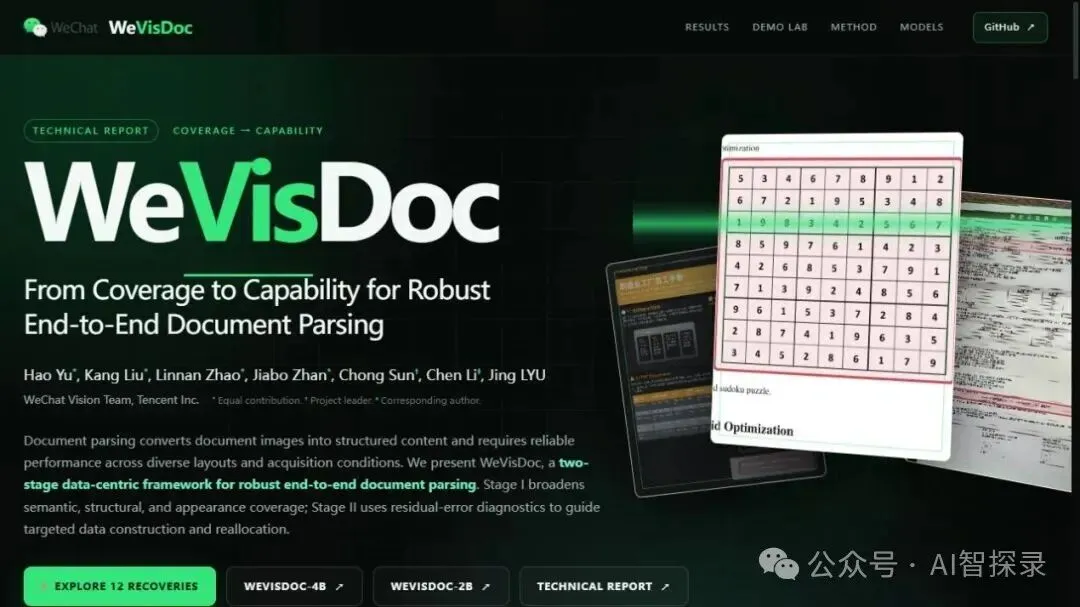
它有 2B、4B 两个版本,约 20 亿、40 亿参数,分别基于 Qwen3-VL 对应规格的指令模型微调。这篇我结合官方案例和论文,拆解它适合处理什么,以及怎么开始试。
1 先看难页:漏掉的表格,能不能找回来
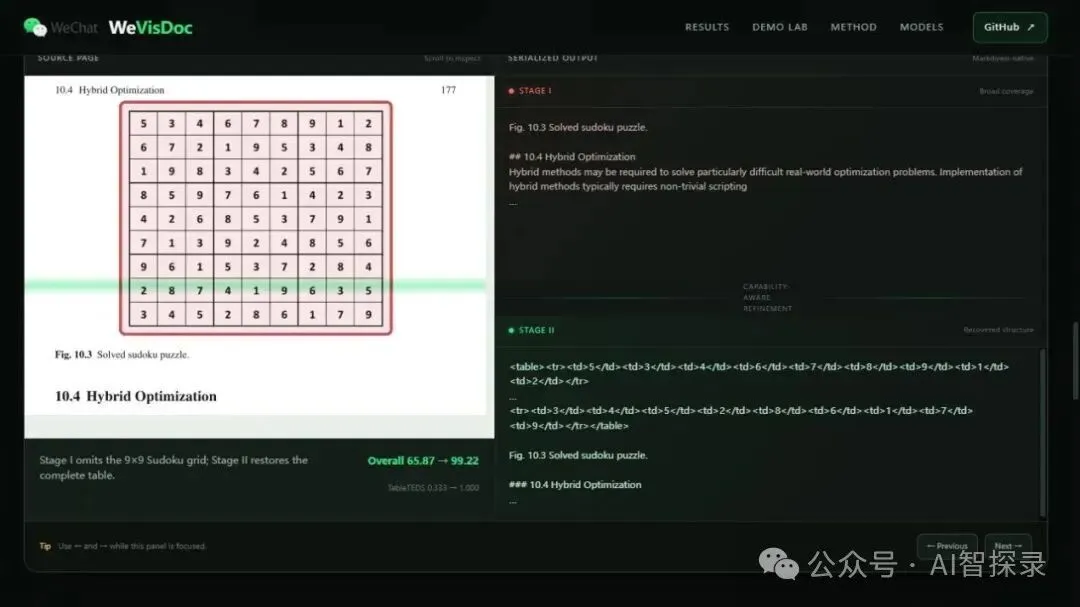
官网有一页数独材料:第一阶段模型读到了图注和正文,却漏掉了整个 9×9 网格;第二阶段恢复了对应的 HTML 表格。
这比“又多认对几个字”更有用。表格结构留下来,后面才有机会校验行列、提取数据。
另一页受到数字退化影响的材料,展示了数学表达式从普通文字恢复为 LaTeX 公式块的过程。做论文笔记和公式整理,这类输出更方便继续编辑。
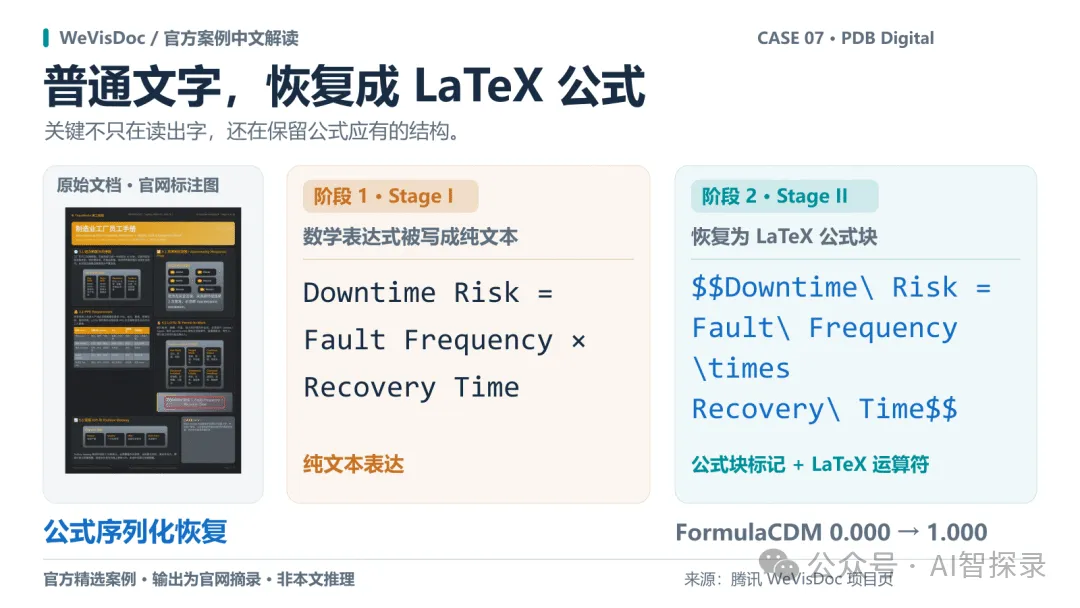
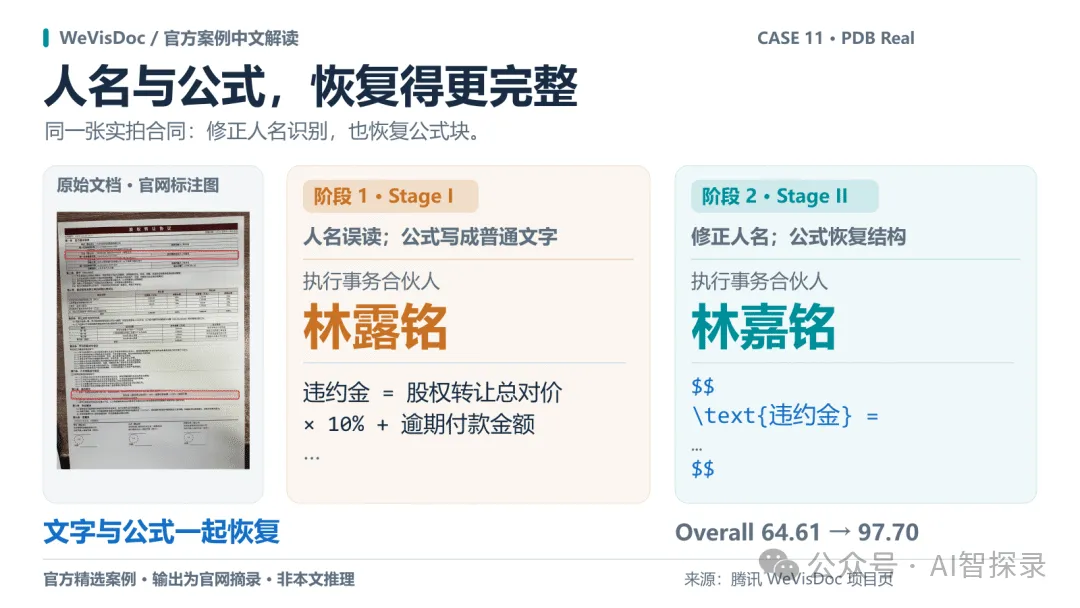
还有一张真实拍摄的合同页面,第二阶段修正了人名识别,并恢复了违约金公式的 LaTeX 表达。
这些都是官方挑选的同一页面在两个训练阶段后的输出对比。它们展示了具体修复方向,日常文档能达到什么效果,还得拿自己的页面验证。
2 整页进去,结构化内容出来
WeVisDoc 用同一个视觉语言模型生成整页结果,无需额外串联独立 OCR 引擎、文档检测器或专用表格解码器。输出里,标题用 Markdown,公式用 LaTeX,表格用 HTML。
对接知识库时,这种格式有一个实际好处:可以沿着标题和段落切分,同时保留表格、公式所在的位置与上下文。
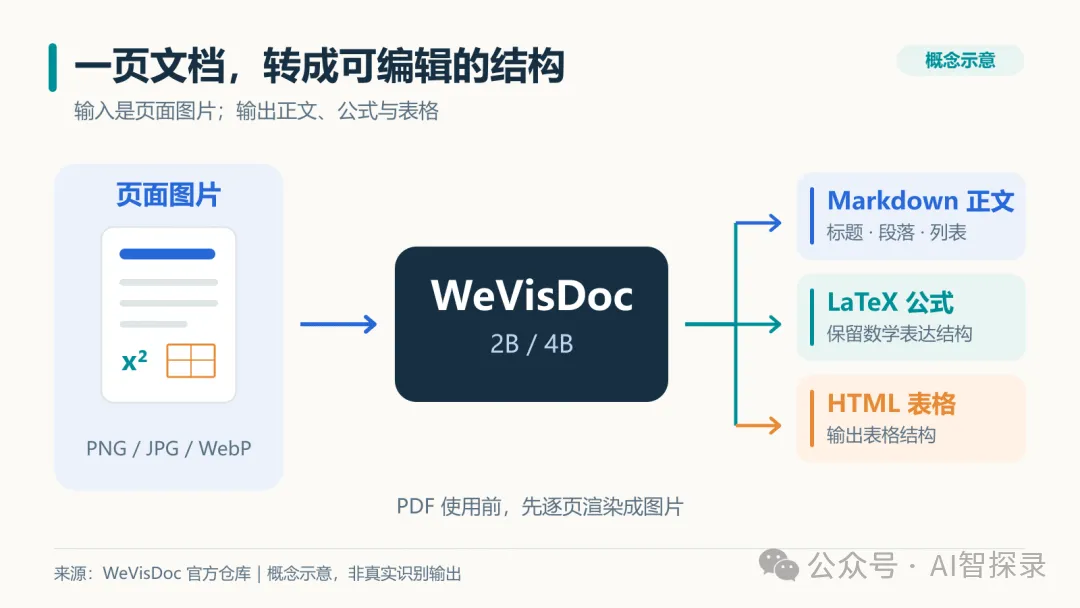
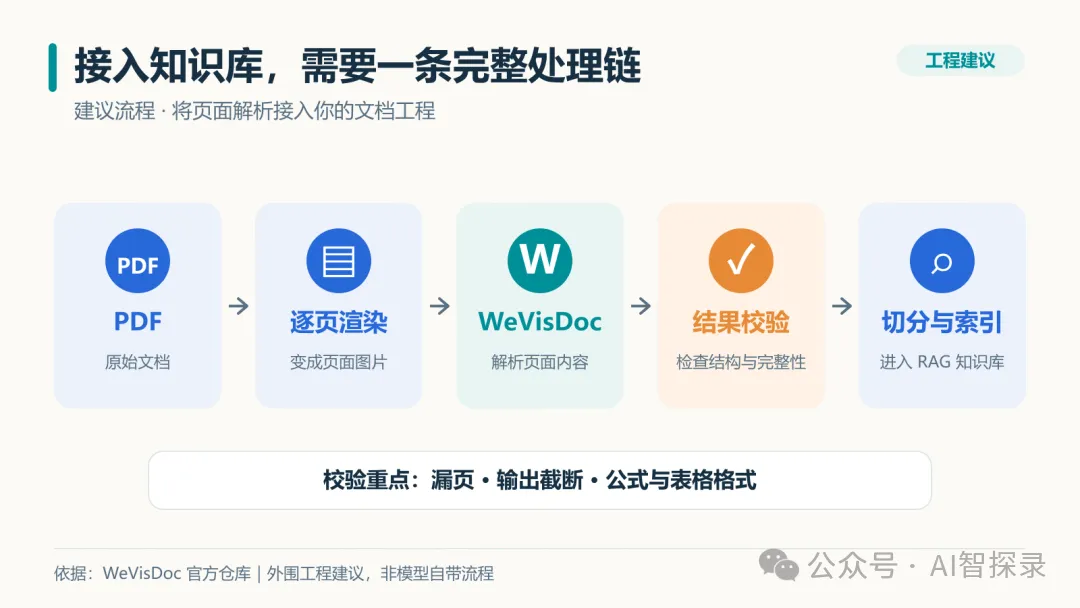
这里要分清输入边界:官方入口处理的是页面图片,PDF 需要先逐页渲染。多页合并、跨页表格、切块和索引,仍是上层工作流要处理的事。
3 分数很亮眼,选型要看细项
官方报告里,4B 在 OmniDocBench v1.6 的 Overall 是 95.38,2B 是 95.06;WeVisDoc 的结果取三次推理均值。
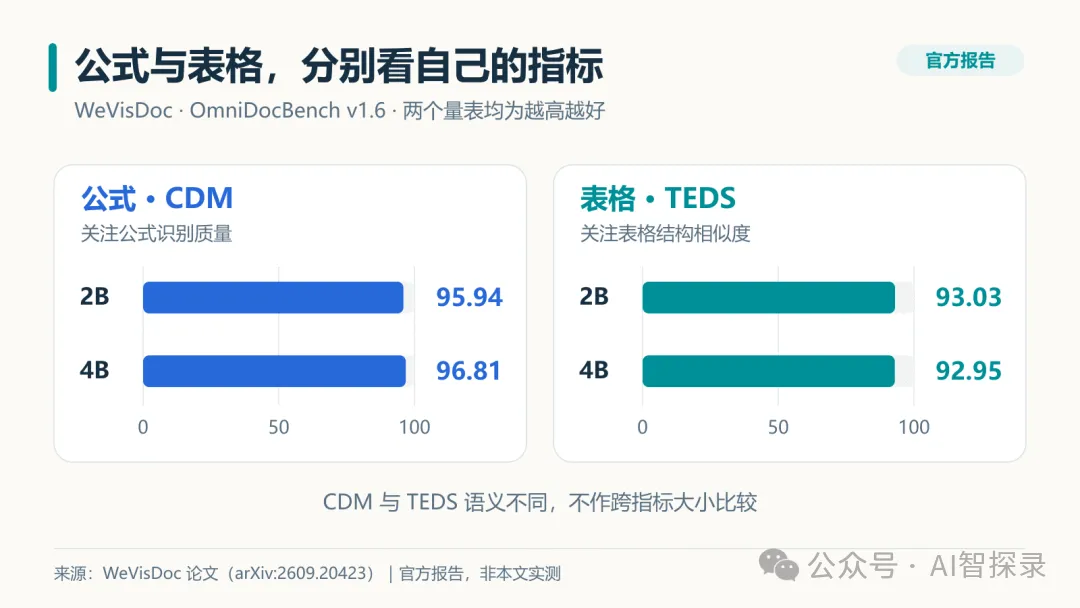
Overall 是综合指标,不能读成“识别准确率 95.38%”。4B 总分更高,表格 TEDS 分项却略低于 2B,不能只看模型大小就决定。
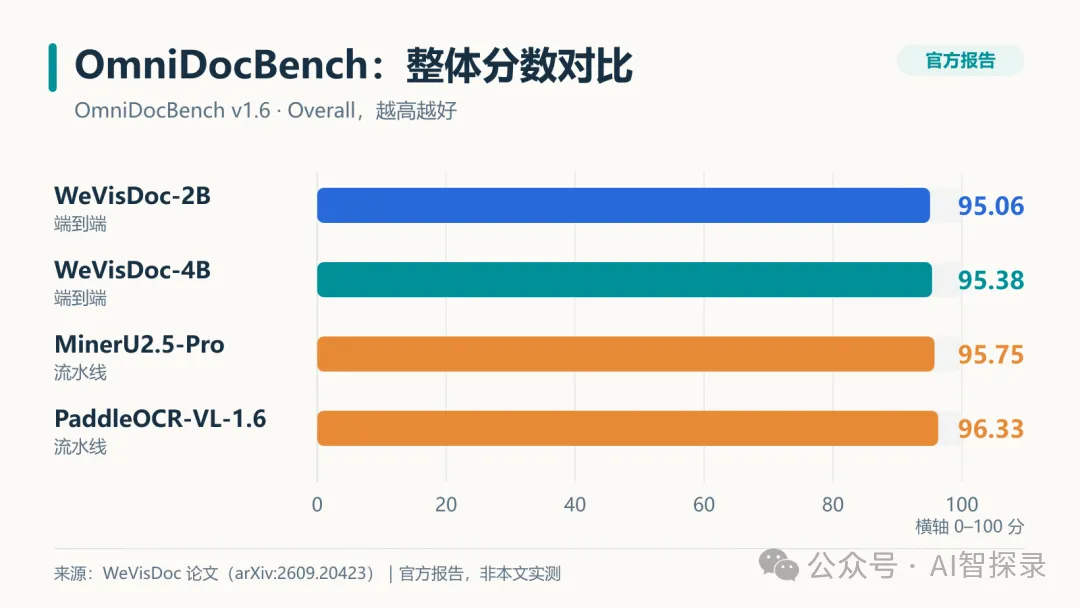
它在所比较的端到端专用模型中取得最高 Overall;论文同表里的 PaddleOCR-VL-1.6、MinerU2.5-Pro 等流水线系统,整体分数仍更高。
所以我的判断是:值得加入候选清单,尤其值得测公式和复杂页面。是否替换现有解析器,要看自己的文档和处理成本。
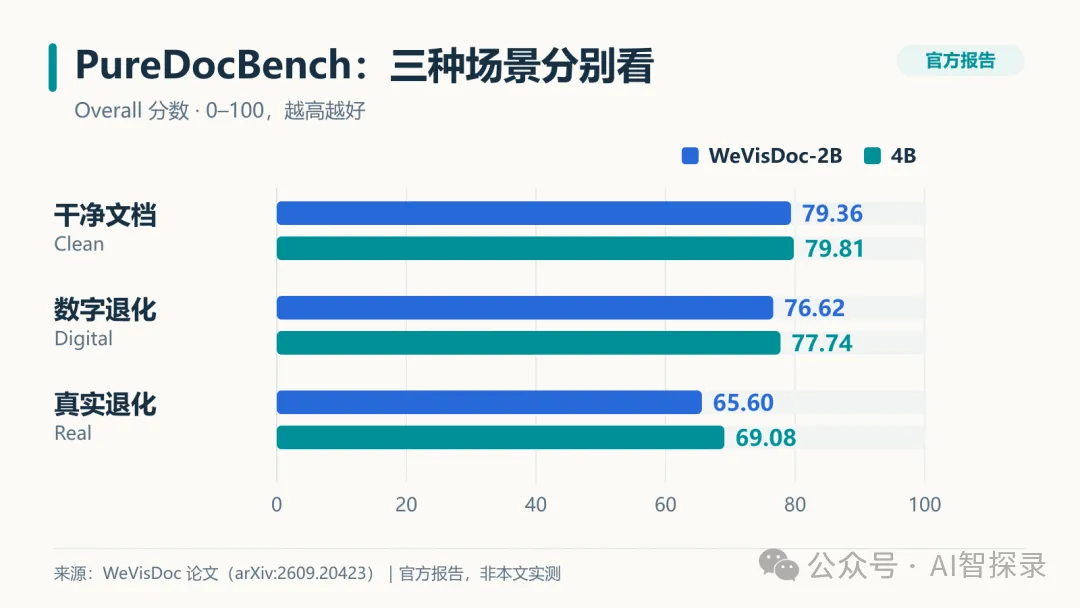
PureDocBench 更能提醒我们现实有多难:4B 在干净页、数字退化页、真实退化页上,分别得到 79.81、77.74、69.08。
同一批源页面经过算法退化或实际采集后,整体分数仍明显下降。“支持拍照文档”和“随手一拍都能解析好”,中间还有距离。
4 它怎么补短板?先广泛见题,再针对错题练
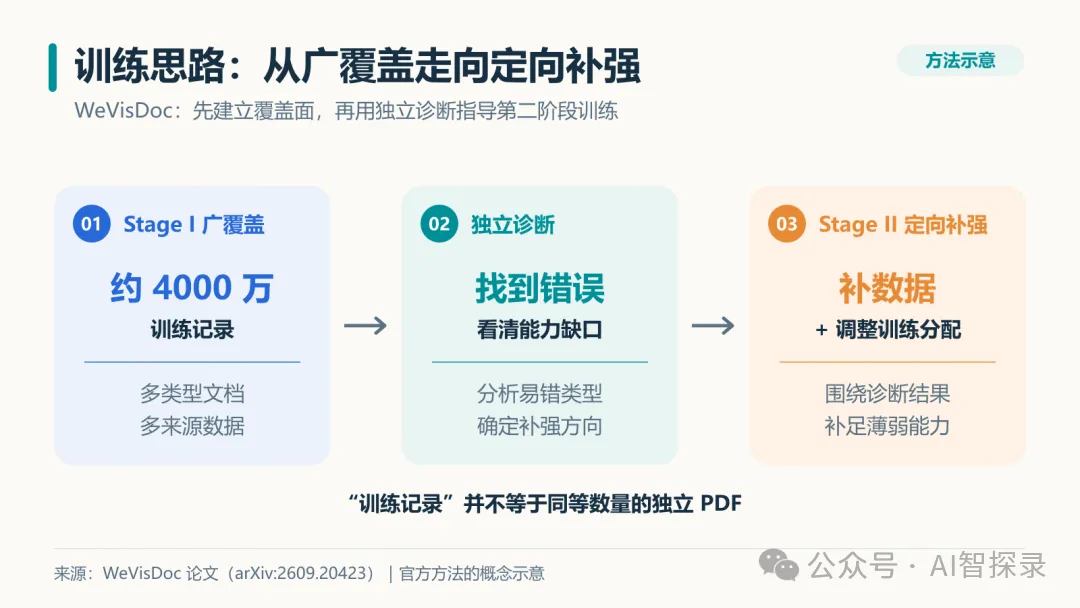
第一阶段,团队用约 4000 万条训练记录扩展内容、版式和退化外观覆盖;第二阶段用独立诊断集找剩余错误,再补数据、调整训练分配。
这里的“记录”包含页面、区域、表格和公式等,不能理解成 4000 万份独立 PDF。核心思路倒很好懂:先见得广,再把练习量花在薄弱处。
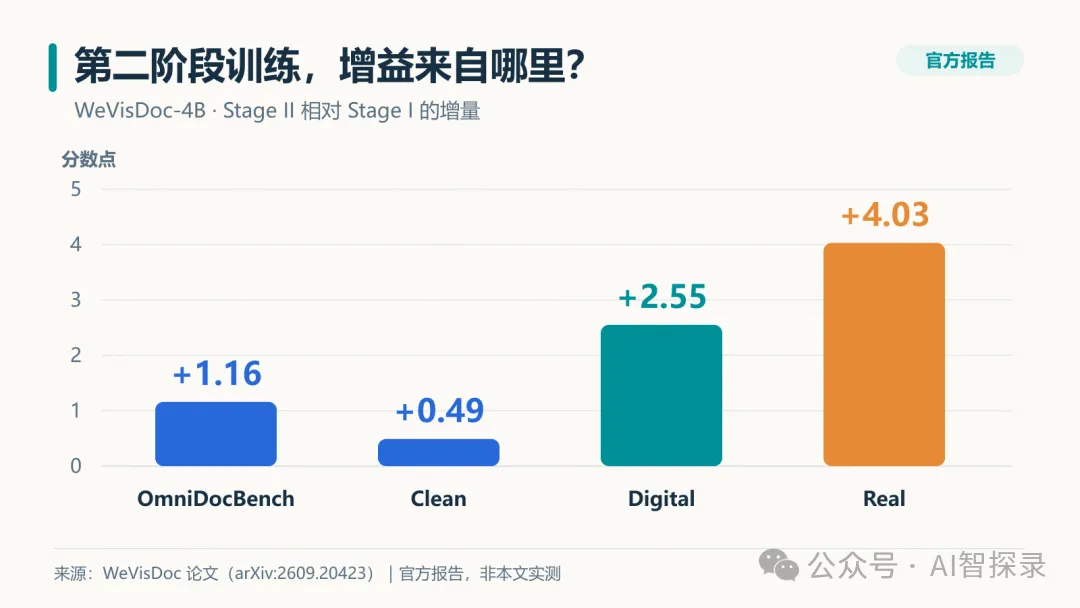
4B 在真实退化赛道上,第二阶段比第一阶段提高 4.03 个分数点,是四项设置里提升最大的一项。
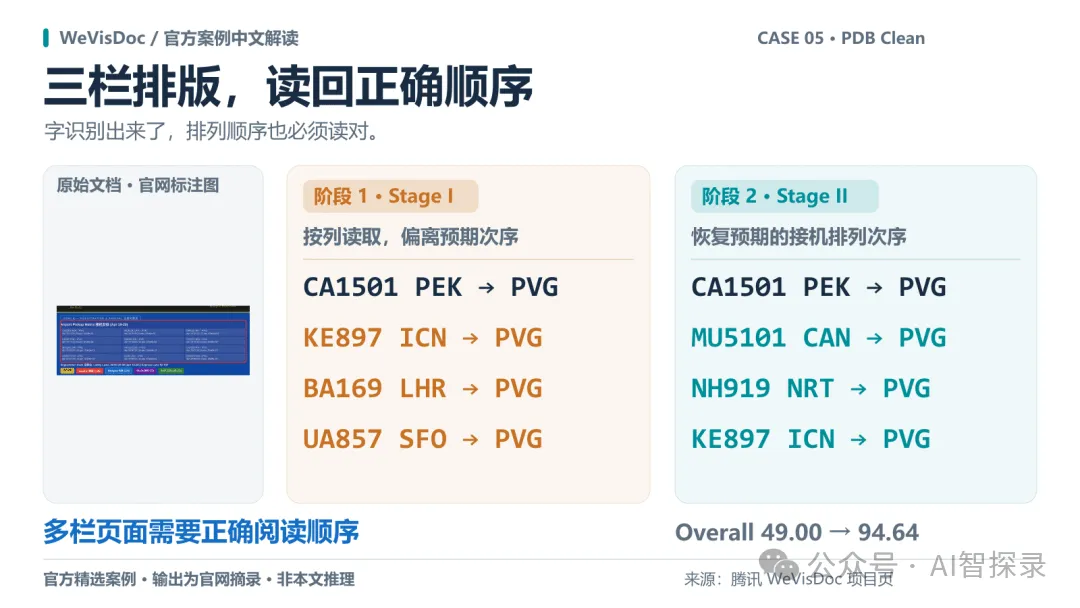
官网另一个三栏接机安排案例,也展示了阅读顺序的修复。对知识库来说,顺序错了,即使单字全对,检索到的段落也可能让人读不懂。
5 想上手,先用 2B 跑通一页
代码仓库和两个官方模型卡均标注 Apache-2.0。仓库提供 vLLM 服务部署,以及 Transformers 本地推理两条路线。
我建议先用 2B 建立基线,再拿同一批页面对比 4B。官方没有承诺固定最低显存,图片尺寸、上下文和并发都会影响实际占用。
以 Transformers 路线为例,先准备 Python 3.10+、兼容的 PyTorch 环境,在终端依次执行:
git clone https://github.com/Tencent/WeVisDoc.git cd WeVisDoc python -m venv .venv # 激活虚拟环境后继续 python -m pip install -r requirements-local.txt python -m wevisdoc.local --model Tencent/WeVisDoc-2B --image page.png --output results/page.mdWindows 用 .venv\Scripts\Activate.ps1 激活;Linux 用 source .venv/bin/activate。上面的 page.png 换成自己的单页图片。
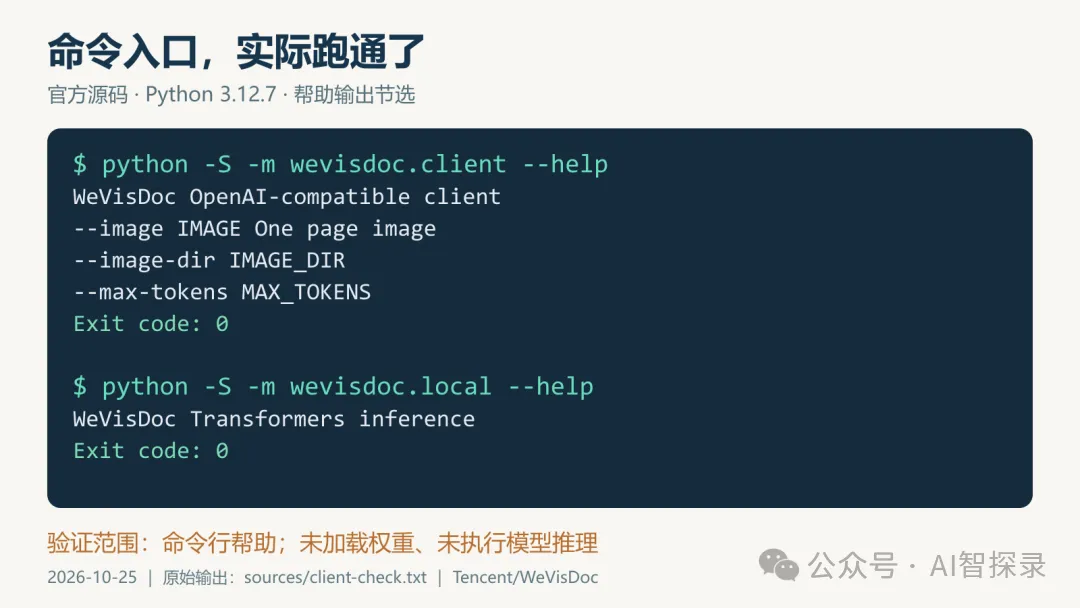
我实际跑通了官方客户端和本地入口的 --help,确认了这些参数入口;这一项验证没有加载权重或执行模型推理。
6 真要接进项目,先测这几件小事
从现有材料里选十页:普通正文、合并单元格表格、密集公式、双栏论文、手机拍照页各两页。和现在的解析器处理同一批原图。
逐页检查漏字、行列、上下标、阅读顺序,再记录耗时与输出截断。尤其看表格有没有在正确位置结束,表后的注释有没有被吞进去。
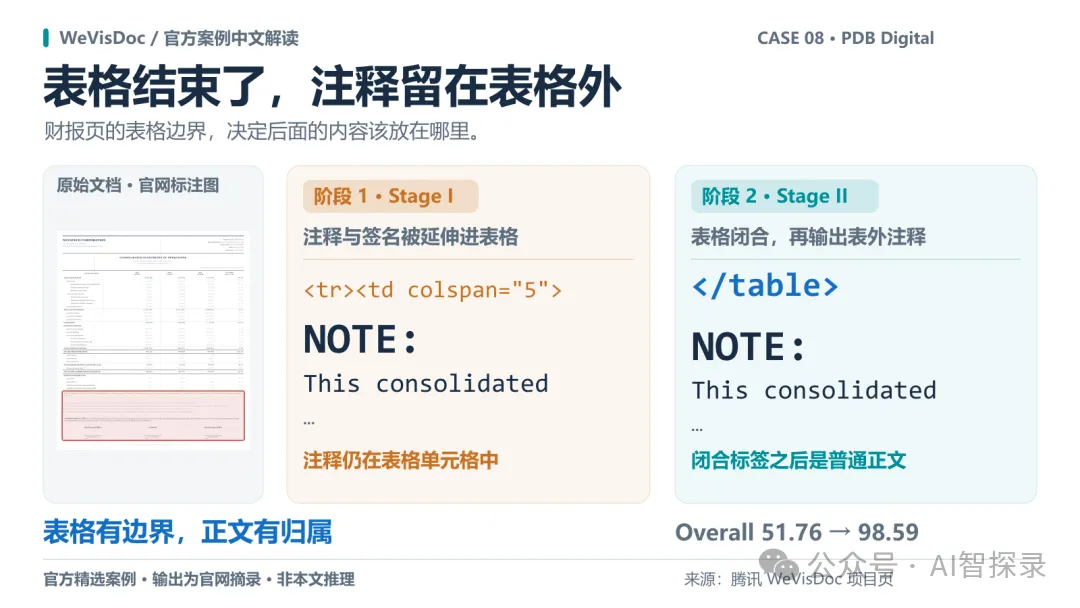
还有一个接入前要知道的限制:官方提示词要求忽略插图内容,并不承诺提取原图或生成插图说明。要做图文知识库,图片保存和关联仍需另外处理。
我更愿意把它放进文档处理工具箱:文字、公式、表格交给它试;重要数字和专名回到原页核对,再决定哪些结果可以自动入库。
最后总结一下
WeVisDoc 值得做知识库、论文整理和文档解析的读者收藏测试。
先用 2B 跑通十页,再判断 4B 的收益是否值得。
真正有用的标准,是自己的难页能否稳定变成可继续处理的内容。
资料入口:官方项目与案例|GitHub 代码与教程|技术论文|2B 模型|4B 模型与评测表。文中案例图片与输出摘录来自官方项目页,部分采用中文解读排版;数据图依据官方报告重绘,流程图为本文概念示意。
如果你觉得这篇文章对你有帮助,也欢迎给我一个三连击:点赞、转发和在看;如果可以,再帮我点一个⭐️。谢谢你看到这里,我们下篇再见。