ARTICLE · 1311437
AI大模型“陆羽”:茶业的“学霸”,为什么多数茶企用不上?
AI大模型“陆羽”:茶业的“学霸”,为什么多数茶企用不上?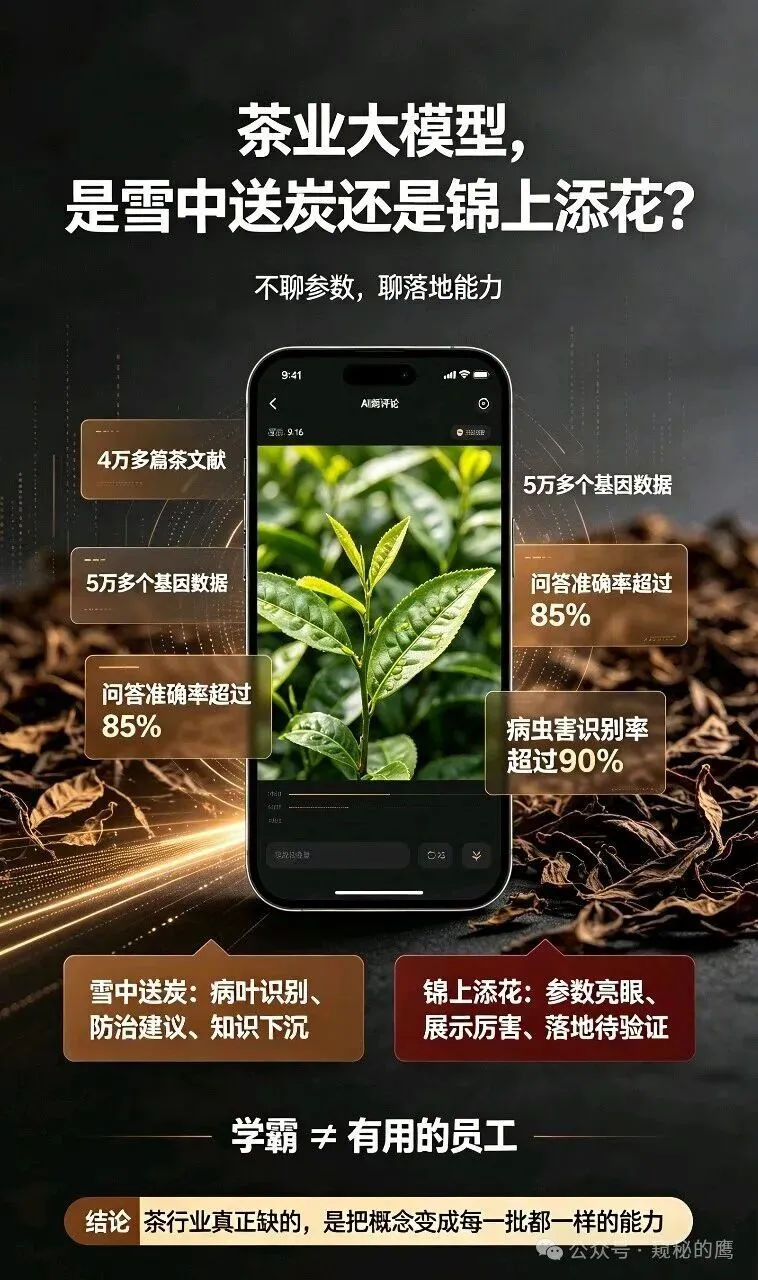
前面二十几篇,鹰从392万吨家底算到消费名品的信任账,从东方树叶的供应链危机聊到县域下沉的赌局。一路拆下来,结论越来越清楚:茶行业缺的不是概念,是能把概念变成“每一批都一样”的能力。 这一篇,聊一个听起来最不像茶行业的东西:大模型。 安徽农业大学宛晓春教授团队搞出了全球首个茶业大模型“陆羽”。4万多篇茶文献,5万多个基因数据,千亿级参数,问答准确率超过85%,病虫害识别率超过90%。单看参数,这是个“学霸”。 一个茶农拿手机拍张病叶,它就能瞧病,还能给出防治建议。 但“学霸”和“有用的员工”之间,隔着一整个产业的复杂度。 鹰今天不聊参数,聊一件更实际的事:这个“学霸”,到底是茶企的“雪中送炭”,还是又一个挂在墙上的“锦上添花”。 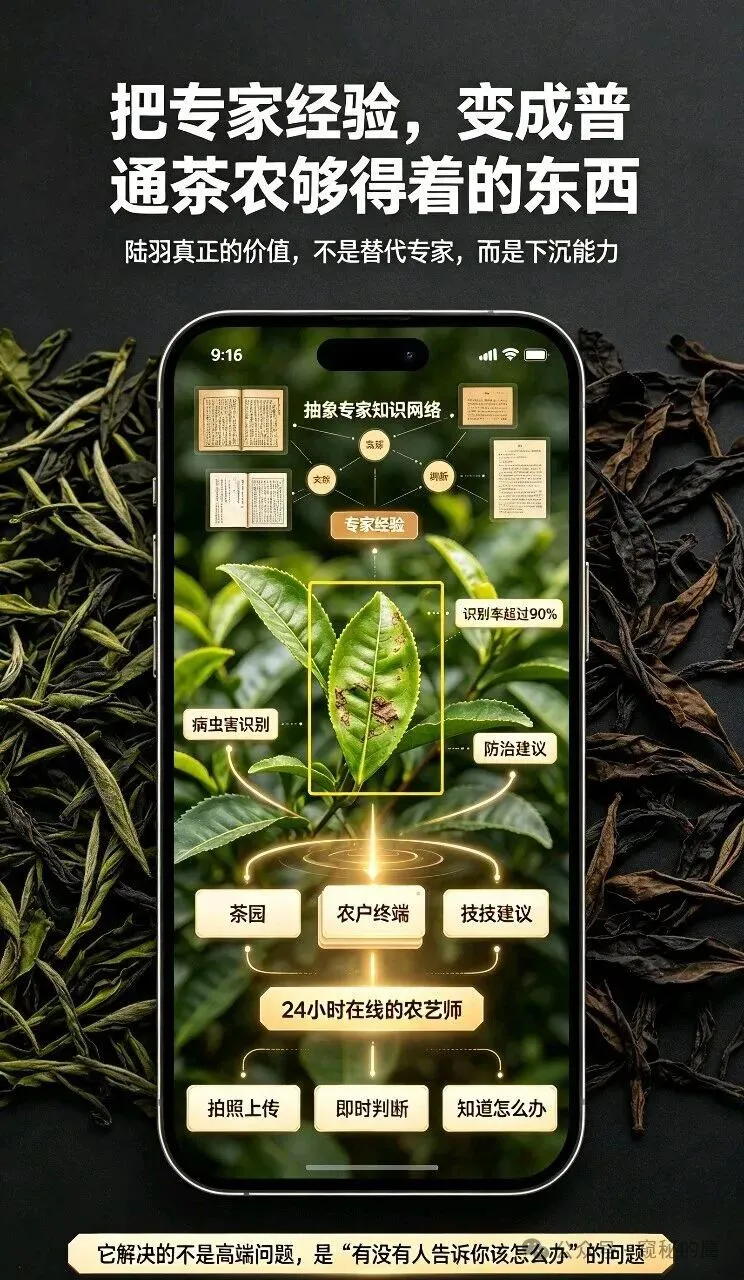
陆羽最硬的功能,是病虫害识别。 茶树生病,过去靠什么?靠老茶农的眼睛,靠农技站的技术员跑现场。一个县几百个技术员,要覆盖几十万亩茶园,根本跑不过来。一个茶农看到叶子发黄,不知道是缺肥还是生病,更不知道打什么药,往往凭经验乱打一通,钱花了,病没治好。 陆羽把这件事变成了拍照上传。识别率超过90%,还能给防治建议。对于没有技术团队的茶农和小茶企来说,这是一个24小时在线的农艺师。它解决的不是高端问题,是“有没有人告诉你该怎么办”的问题。 这是陆羽真正的价值:它不是在替代专家,是在把专家的能力,变成普通茶农够得着的东西。 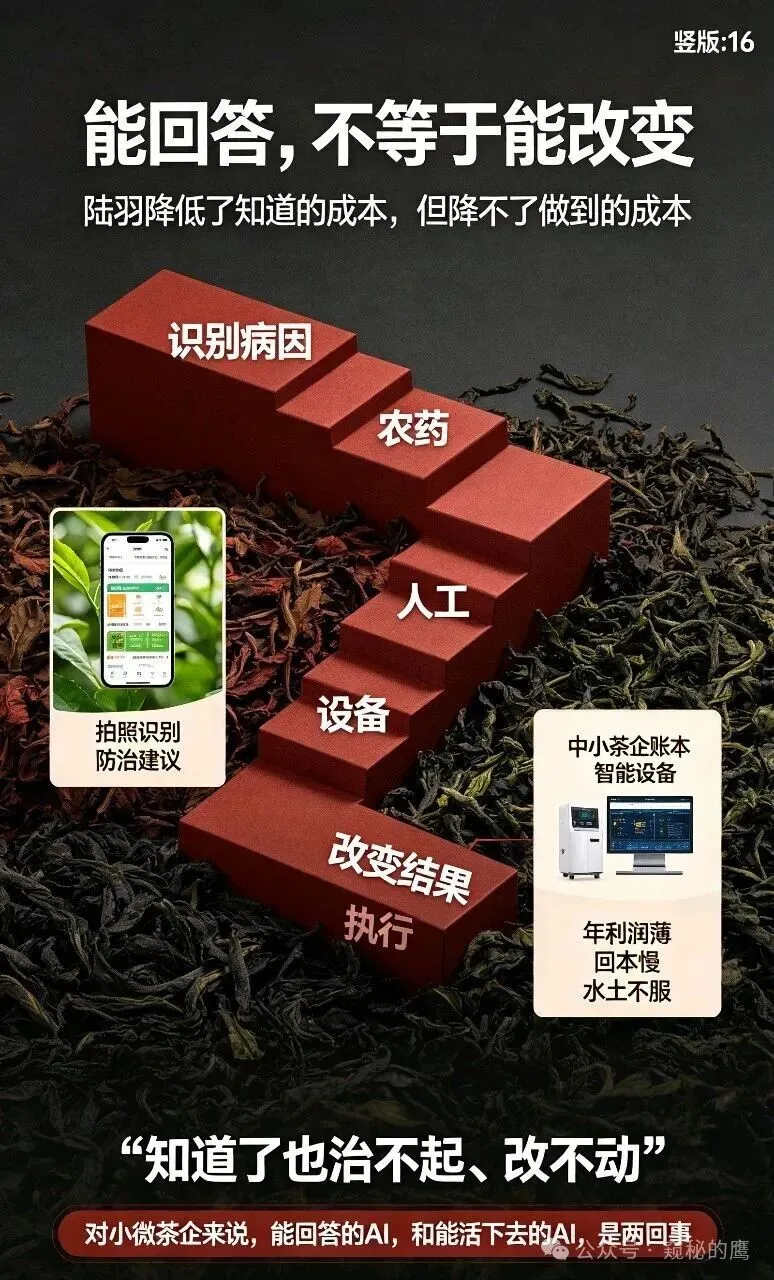
陆羽能回答这叶子得了什么病。但茶企真正要算的账是:知道了之后,要花多少钱才能改变结果? 病虫害识别出来了,对应的农药、人工、喷洒设备,要钱。防治建议有了,执行不到位,等于没有。更关键的是,茶企面临的核心问题从来不是“不知道病因”,是“知道了也治不起、改不动”。 有评论一针见血:大型茶企用智能化是降本增效,中小茶企用,大概率是负重前行。一套完整的智能制茶流水线,动辄几十万上百万,中小茶企年利润本来就薄,咬牙上了设备,回本周期漫长。 更尴尬的是,市面上多数智能设备是为大厂规模化生产设计的,而中小茶企主打小批量、多品类、定制化,大厂的顶配设备放到小厂里,大材小用、水土不服。 陆羽降低了“知道”的成本,但“做到”的成本,它降不了。 对于年营收千万以下的小微茶企来说,一个能回答问题的AI,和一个能帮他们活下去的AI,是两回事。 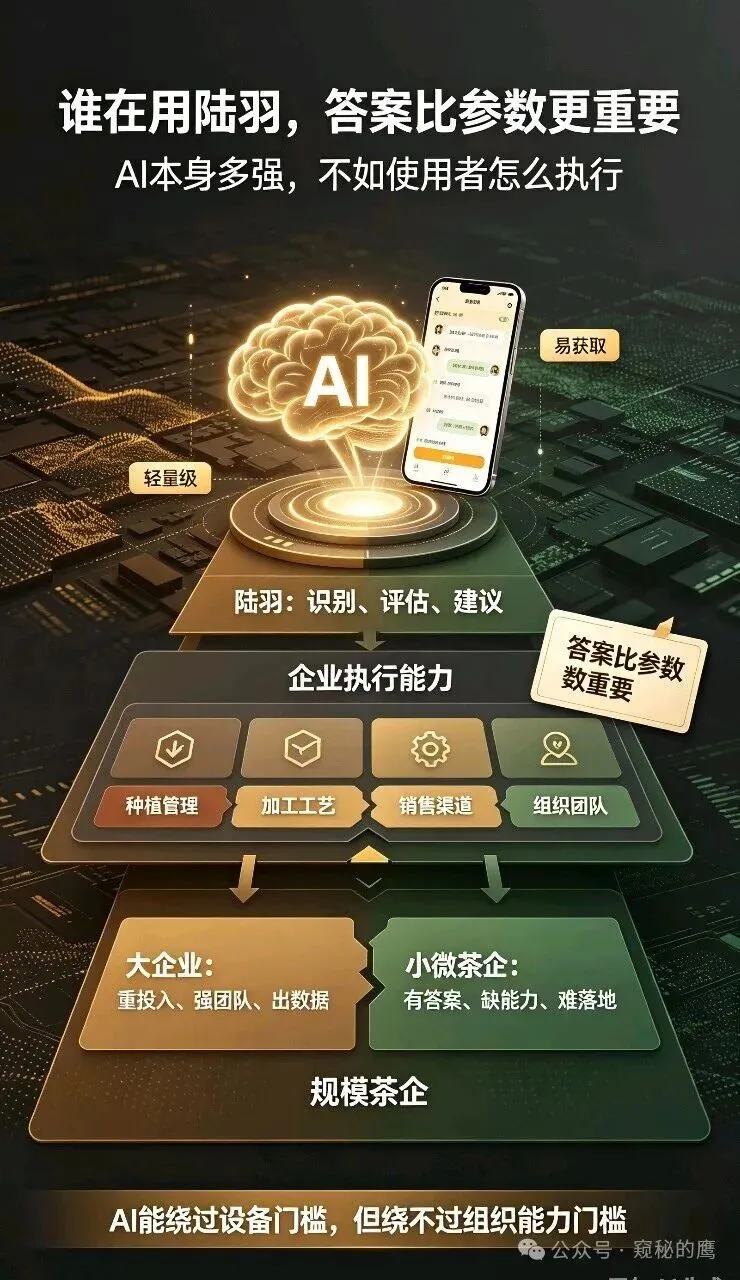
公开信息里,陆羽已经在安徽黄山、福建安溪等茶区落地。但这些落地,更多是试点,不是普及。 真正在智能化上跑出数据的,是大企业和有资本支撑的项目。 湄潭琦福苑的智能化车间,投入3000余万元,人工从80人降到20人,优质率稳定在95%以上,年新增营收5000万。 湘丰茶业通过智慧化管控,茶园亩均管理成本下降15%以上,品质稳定性提升20%。 立宇茶叶通过AI辅助鉴定和智慧拼配,每年降低约300万元成本。 这些案例说明一件事:AI和数字化,在有规模、有资本、有团队的企业里,是实打实的生产力。但它们的共同点是重投入。琦福苑的3000万,不是一般茶企拿得出来的。湘丰的物联网体系,背后是一整套技术团队在运维。 陆羽作为一个轻量级的问答工具,理论上可以绕过重资产门槛。茶农用手机就能用,不需要买设备、建系统。但它能解决的问题,停留在信息不对称层面。病虫害识别了,然后呢?品质评估了,然后呢?如果后续的种植管理、加工工艺、销售渠道不跟着变,一个知道答案的AI,改变不了没有能力执行的现实。 有一个贵州茶企的案例值得注意。神鹊茶场用AI赋能,发现AI不分地域,只要企业智库完善,就能以一线城市的服务标准服务客户。这说明,AI的价值不在于它本身多强,在于用它的人有没有能力把它的输出变成行动。 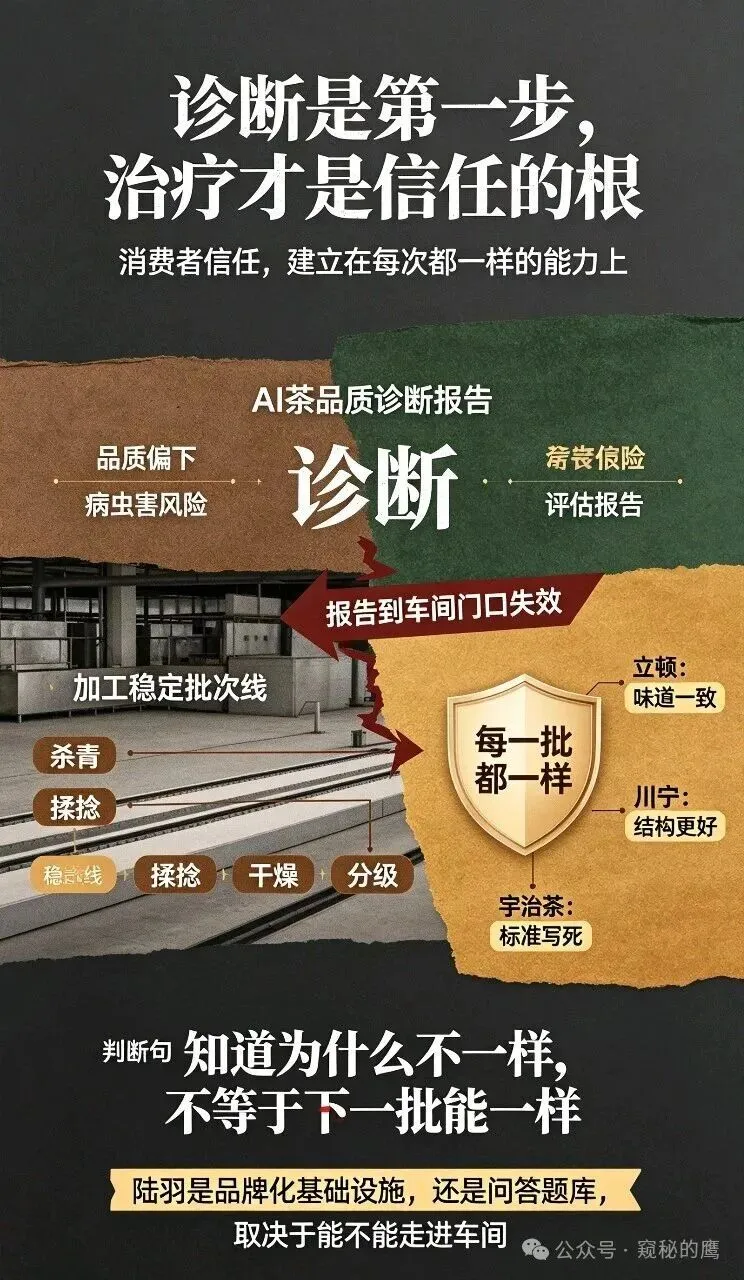
消费名品那篇写了,官方背书和消费者信任是两套货币。有名茶无名牌那篇写了,立顿不讲山头、不讲大师,只讲“这一杯永远是这个味道”。川宁活了三百二十年,靠的不是茶叶多好,是结构更好。宇治茶靠一个协同组合把标准写死,每一批都一样。 这三篇指向同一个根:品牌信任,建立在“每次都一样”的能力上,不是“知道为什么不一样”的能力上。 陆羽的病虫害识别、品质评估,理论上能帮茶企把品控做得更稳。但理论上不等于实际上。如果陆羽只能告诉茶企“这批茶品质偏下”,却不能告诉茶企“下一批怎么做到和上一批一样”,那它解决的是诊断问题,不是治疗问题。 而消费者信任,恰恰建立在治疗能力上,不是诊断能力上。 一个茶企,用陆羽查出了这批茶的品质问题,然后呢?它的加工线还是老样子,它的师傅还是凭手感杀青,它的原料还是来一批换一个产地。陆羽的诊断报告,到了车间门口就失效了。 陆羽如果真能帮茶企做到“每次都一样”,它就是品牌化的基础设施。如果它做不到,它就只是一个更聪明的问答题库。诊断是第一步,治疗才是品牌信任的根。 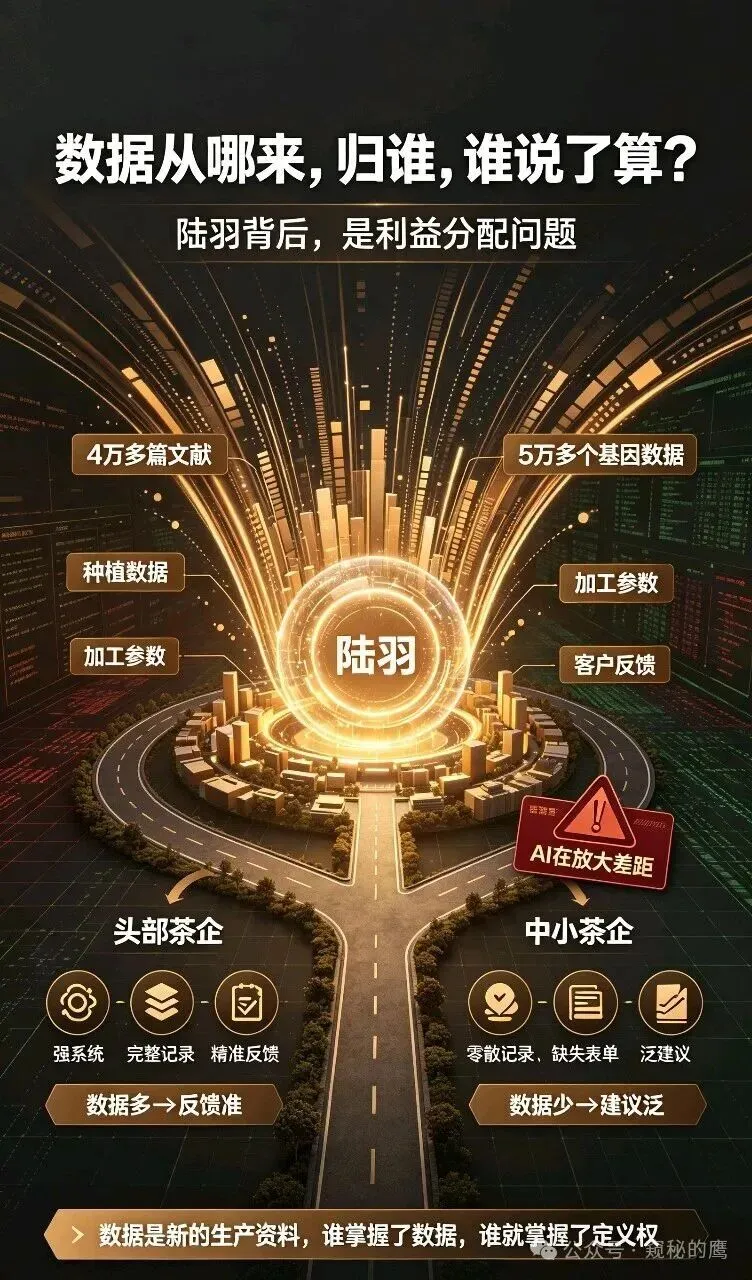
再往下问一层。 陆羽有4万多篇文献、5万多个基因数据、1000万字文本。这些数据是谁的?如果茶企把自己的种植数据、加工参数、客户反馈喂给陆羽,数据主权归谁?茶企能不能拿到自己贡献数据的分析结果?如果所有茶企的数据都汇到同一个大模型里,最后受益的是贡献数据的茶企,还是模型持有方? 这不是技术问题,是利益分配问题。 公用品牌死穴那篇写过——产权不清,谁都能用,谁都不负责。陆羽如果变成茶行业的公共大脑,但数据贡献者拿不到对等的回报,它就会变成另一个公用品牌:大家往里添柴,少数人烤火。 更现实的问题是:大模型越用越聪明,靠的是数据喂养。谁的数据多,谁的模型就强。 头部茶企有数据团队、有系统、有积累,它们喂给陆羽的数据最多,陆羽反过来给它们的反馈也最精准。 中小茶企连生产记录都不完整,喂给陆羽的数据又少又糙,陆羽给它们的建议也就泛泛而谈。 结果是:AI没有拉平差距,AI在放大差距。 这不是陆羽的错。这是任何一个数据工具在落地到一个数据能力极度不均衡的行业时,必然遇到的错位。数据是新的生产资料,谁掌握了数据,谁就掌握了定义权。 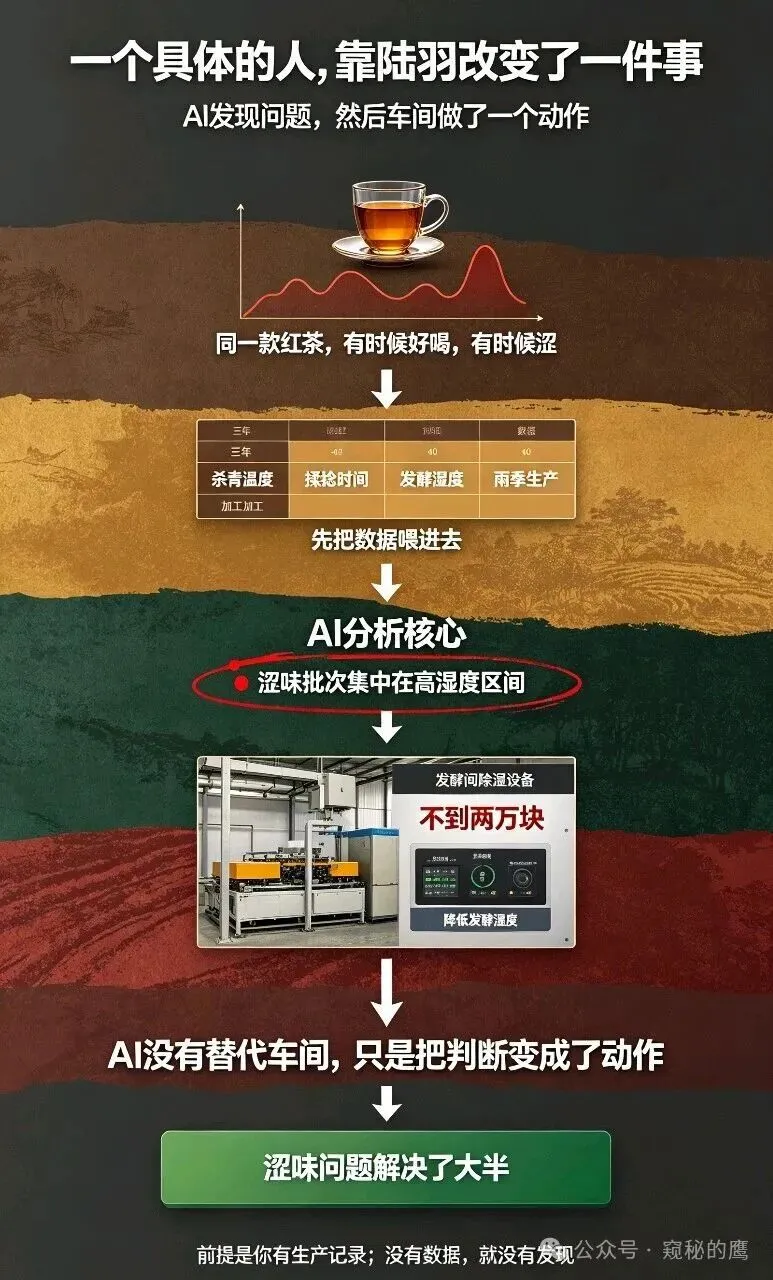
说个具体的场景。 贵州某茶企,连续三年同一款红茶,客户反馈“有时候好喝,有时候涩”。老板以为是原料问题,换了几批鲜叶,还是不稳定。 后来他把三年的加工数据——杀青温度、揉捻时间、发酵湿度——全部整理出来,喂给AI做分析。AI发现,涩味偏重的批次,发酵湿度都集中在某个区间,而这个区间的数据,刚好对应的是雨季生产的那几批茶。 老板这才意识到,问题不在原料,在雨季的发酵环境控制。他后来在发酵间加了一套除湿设备,成本不到两万块,涩味问题解决了大半。 这个案例说明什么?说明AI的价值不在于它多聪明,在于你有没有数据喂给它,有没有能力把它的发现变成车间里的一个动作。 那个老板能做成这件事,前提是他有三年的加工数据。大部分茶企连生产记录都没有,AI拿什么帮他? 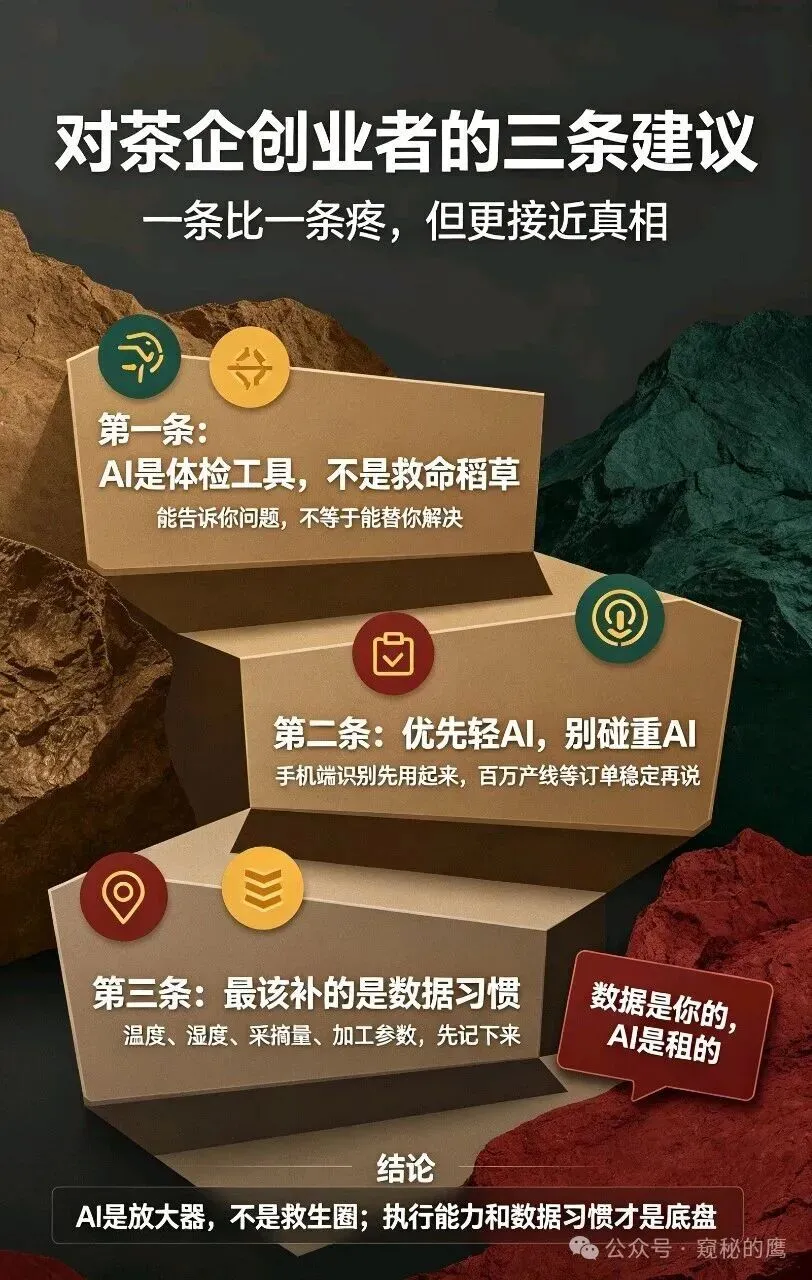
第一,别把AI当成救命稻草,当成体检工具。 陆羽能告诉你茶园的病虫害、品质的大致水平,这是体检。体检报告出来了,治不治、怎么治,是你的事。你如果本来就没有能力治,体检报告只会让你更焦虑。 第二,最疼的一条:如果你是中小茶企,优先用轻AI,别碰重AI。 陆羽这样的问答工具、手机端的病虫害识别、基础的品质评估,门槛低,先用起来。动辄几十上百万的智能产线,等你的订单稳定到不开工就违约的时候再考虑。设备买得起修不起,比没有设备更惨。 第三,AI时代,茶企最该补的不是技术,是数据习惯。 陆羽再强,也需要你告诉它你的茶园在哪、你的工艺是什么。很多粗制茶企连基本的生产记录都没有。你连自己的数据都不记录,AI拿什么帮你?先学会把每天的温度、湿度、采摘量、加工参数记下来,再谈AI。数据是你的,AI是租的。租的东西再好,房东随时可以收回去。 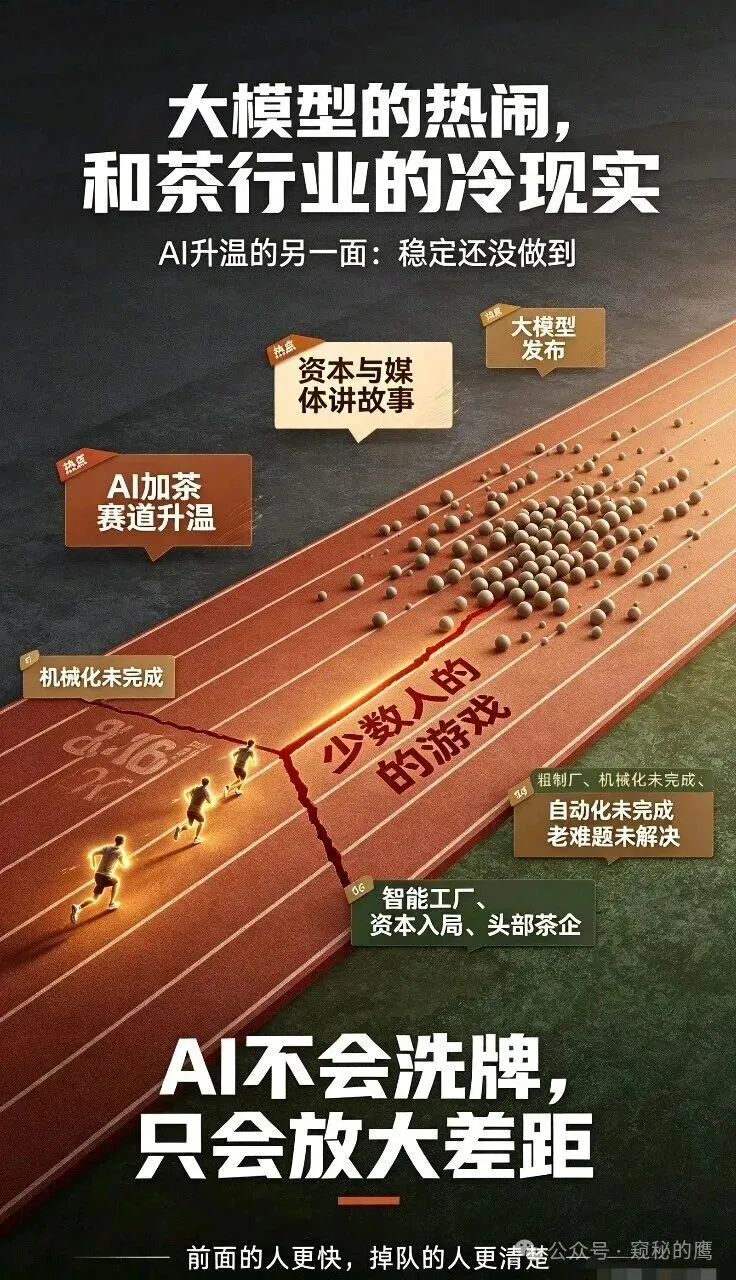
全网有一种声音很冷静:AI加茶赛道在升温,小罐茶15亿智能工厂投产,茶小牛完成数千万融资,陆羽大模型发布。资本和媒体在讲一个技术改变传统产业的故事。 但另一个视角是:中国茶行业最底层的现实,是大量粗制厂连机械化、自动化都还没完成,很多三四十年前的技术难题至今没解决。在一个连稳定都还没做到的行业里,谈智能,容易变成少数人的游戏。 AI不会让茶行业重新洗牌。它会让已经跑在前面的人跑得更快,让本来就掉队的人,更清楚地看到自己掉队了。 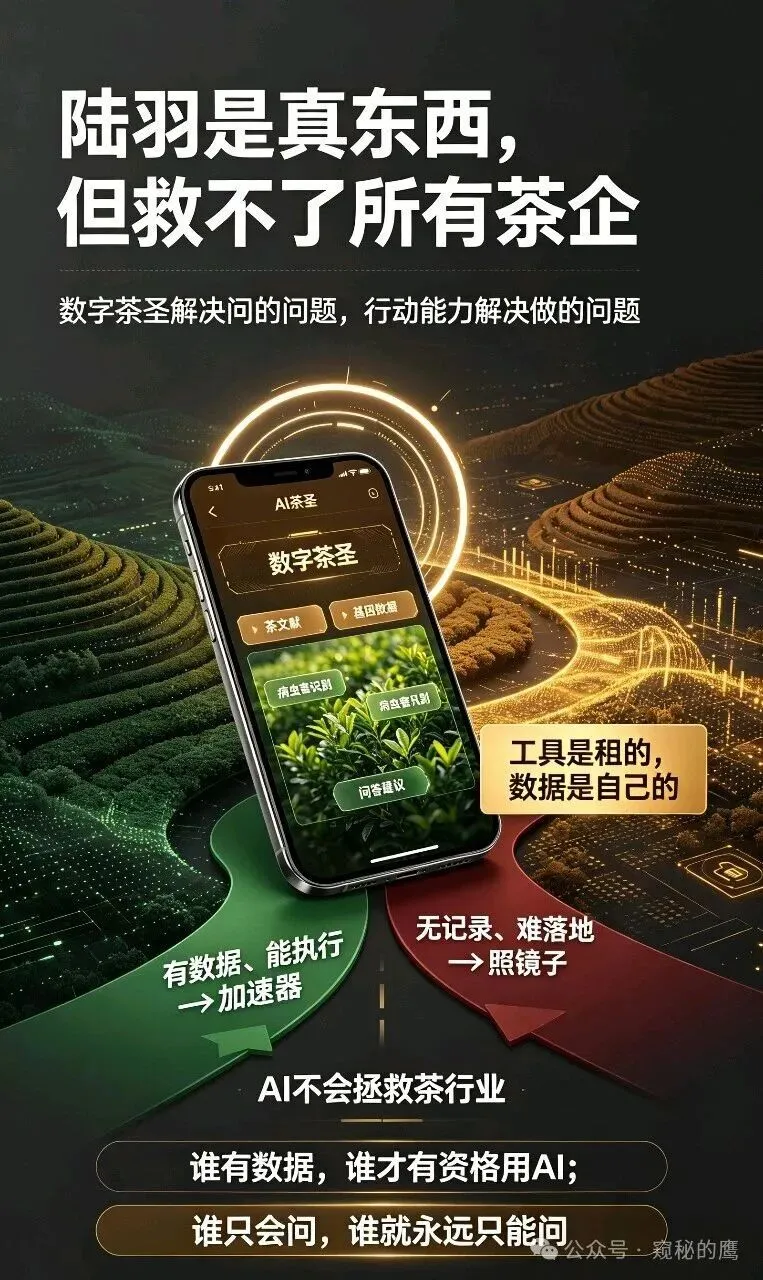
它把茶学文献、基因数据、病虫害知识,变成了一个茶农能用手机访问的数字茶圣。 但数字茶圣解决的是“问”的问题。茶行业真正的难题,从来不是“不知道”,是“知道了也做不到”。 对于有能力把AI输出变成行动的企业,陆羽是加速器。对于没有能力的企业,陆羽是一面镜子,照出了它们离现代化还有多远。 AI不会拯救茶行业。它只会让那些本来就愿意改变、也有能力改变的人,多一个工具。 但别忘了,工具是租的,数据是自己的。谁有数据,谁才有资格用AI。谁只会问,谁就永远只能问。 下篇,我们聊《未来茶厂:AI视觉识别、自动分级拣选落地案例》,下篇见。
首先,先承认“陆羽”确实做对了一件事:把专家的经验,变成了可以查的答案
其次,但“能回答”和“能改变”之间,隔着一条成本线
再次,谁在用“陆羽”,答案比参数更重要
四,跟“消费名品”那篇连起来看:陆羽能不能帮茶企建信任
五,灵魂拷问:数据从哪来,归谁,谁说了算
六,一个具体的人:谁真的靠陆羽改变了一件事
七,对创业者的三条建议,一条比一条疼
八,全网另一视角:大模型的热闹,和茶行业的冷现实
最后,窥秘的鹰认为陆羽大模型是一个真东西。它不是噱头,是实打实的技术积累。
关注我,窥秘的鹰,热点不止,洞见不停。在这里,每一个角度都直指核心,每一次剖析都剥开表象。与我同行,看见不一样的热点真相。