ARTICLE · 1312403
PDF 收藏了一堆没读过?把它变成一张知识图谱,本地跑零成本
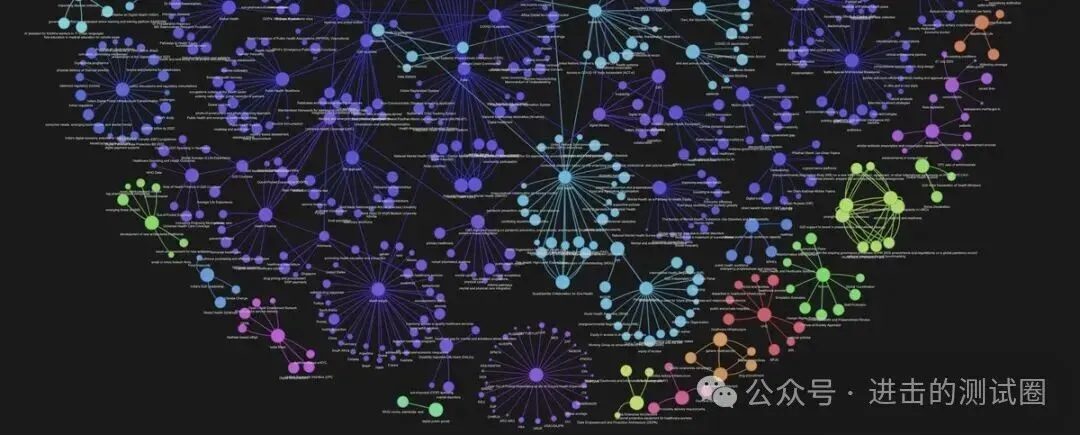
图:作者用一份 PDF 跑出来的知识图谱(图源:项目仓库)
你硬盘里是不是也有个叫「资料」的文件夹:几十份 PDF,收藏那天热情高涨,之后再没打开过。想复习,翻两页就困;想找东西,Ctrl+F 都不知道该搜哪个词。
我最近翻到一个开源项目 knowledge_graph,专门治这个:把任意文本喂进去,它输出一张知识图谱(一句话解释:把概念当成"站点"、概念之间的关系当成"线路",画出来的一张网),节点能拖、点开能看,还能缩放。
更实用的是,这张图不只是好看——它能反过来当检索器跟文档对话,这套玩法叫 GRAG(图检索增强生成:让大模型答题前先去图谱里"查地图",而不是去原文里"翻抽屉")。
整套流程在本地跑,用的也是本地大模型,不调任何付费 API。下面把我试下来的体验拆开讲讲。
图:左边是吃灰的文档堆,右边是它变成的知识图谱
先看效果
作者把一份样例文档生成的图谱挂在了网上,这个页面可以直接玩:拖节点、滚轮缩放、点开看关系。节点越大,代表这个概念在原文里越"中心"。
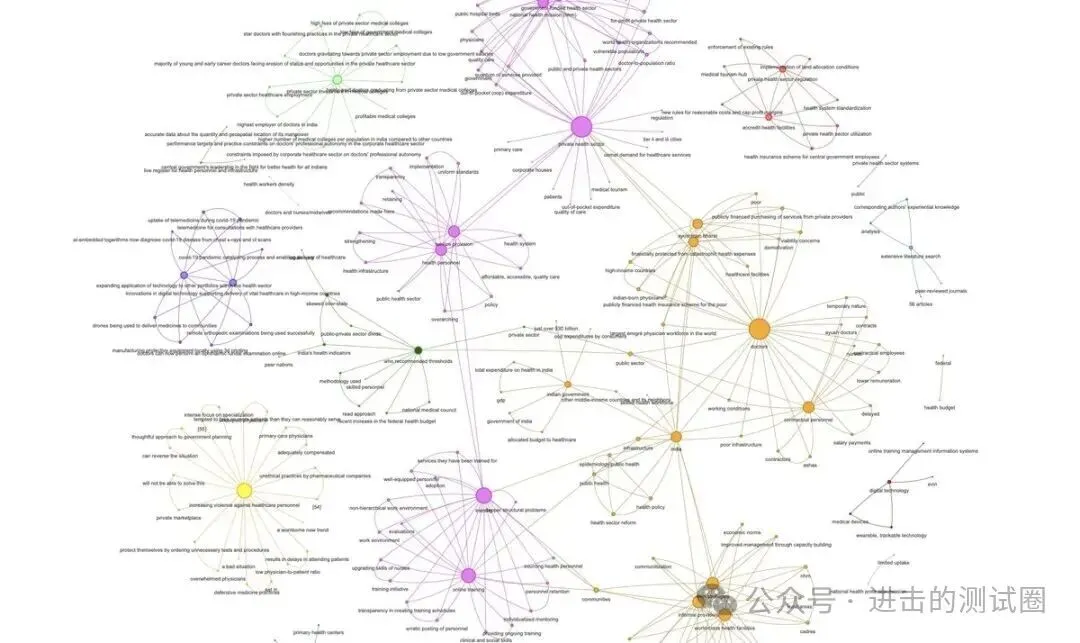
图:我试了下一份医疗主题文档生成的图谱,颜色是自动聚出的"话题社区"(图源:项目仓库)
放大看会发现节点上不是零散的关键词,而是一句句完整的小概念,比如"私立医学院的监管缺失"——一眼就能看出它是从原文哪段话里长出来的。
核心思路:提取"概念",而不是"实体"
这是这个项目跟大多数知识图谱工具最大的区别。
市面上不少图谱工具走 NER 路线(命名实体识别:从文本里抠出人名、地名、机构名这类专有名词)。这个项目用大模型提取的是概念。作者在 README 里举了个例子:
打个比方:实体图谱像通讯录,只记"有谁";概念图谱像朋友圈八卦图,记的是"谁跟谁因为什么事扯上了关系"——后者的信息密度明显高得多。
图是怎么画出来的
我翻了作者的 README 和他那篇 Medium 方法详解,整个流程就四步:
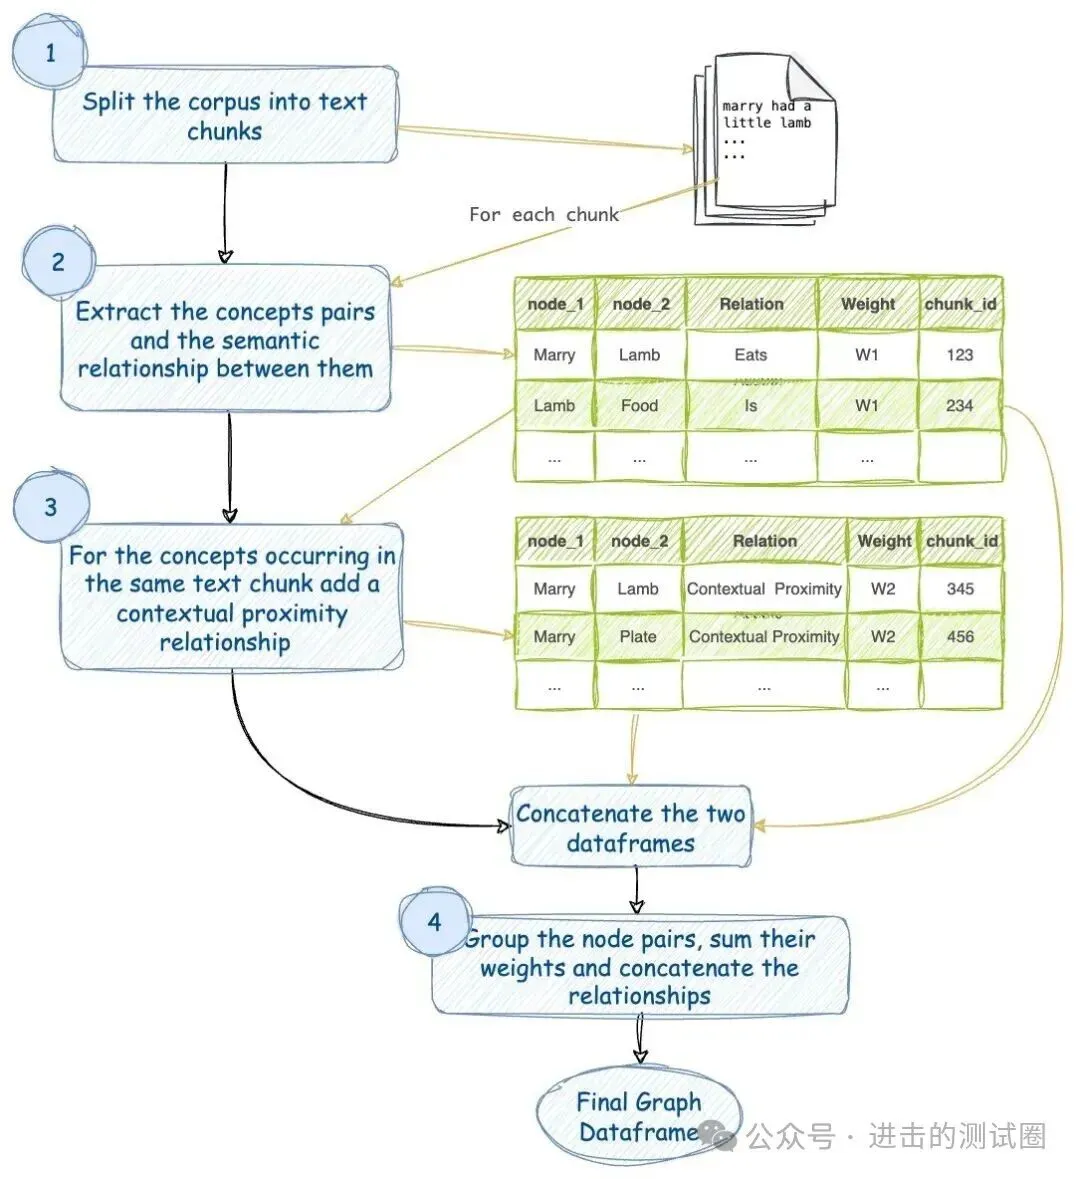
图:作者手绘的流程图,和 extract_graph.ipynb 里跑的是同一套(图源:项目仓库)
- 切块
:把长文切成一段一段的小块(chunk,分块:把长文拆成小段,每段单独处理),每段编个号; - 提概念
:用本地大模型从每个小块里提取概念对,以及它们明说的语义关系,记为权重 W1; - 补共现
:同一个小块里出现的两个概念,就算模型没说它们有关系,也默认"它俩在同一现场出现过",再记一个权重 W2(上下文邻近关系); - 合并去重
:同一对概念可能在很多块里反复出现,把权重加起来、关系描述拼在一起,最后每对概念之间只留一条边。
用生活化的话说:W1 是"这两个人当面认识,还知道是谁介绍的";W2 是"这俩人总出现在同一张合影里,八成也认识"。
最后顺手再算两个东西:每个节点的度(一个概念连了多少条线,线越多节点画得越大——相当于班里人缘最好的同学),以及社区发现(把关系紧密的概念自动聚成一簇一簇,对应上图里不同颜色的区域,相当于自动帮你把同学分成"打球的一伙""打游戏的一伙")。
图谱建好了能干什么
- GRAG 对话
:把图谱当检索器,跟文档做更深层的问答——传统 RAG 捞回来的是几段零散的片段,图谱能给出"概念 A 怎么一路连到概念 B"的完整路径; - 中心性分析
:一眼看出整篇文档里最核心的概念是哪几个; - 社区发现
:自动把全文聚成几个主题群,快速摸清文档结构; - 可视化
:生成的交互网页图可以直接托管上线,比如作者的示例图谱。
它跟向量 RAG 不是替代关系,更像互补:
怎么跑起来
路线一:Docker(省事)
Docker(把软件连同运行环境打包,一条命令跑起来)路线,三条命令:
git clone https://github.com/rahulnyk/knowledge_graph.gitcd knowledge_graphdocker build -t knowledge-graph .
docker run -p 8888:8888 knowledge-graph跑完浏览器打开 localhost:8888,就是一个 Jupyter Notebook(能一段一段跑代码的网页笔记本),核心文件是 extract_graph.ipynb,把里面的输入文本或 PDF 路径改成你自己的文件就行。
【配图建议:这里放一张自己跑 docker run 后浏览器里 Jupyter 界面的截图,能看到 notebook 文件列表或单元格即可】
路线二:本地 Ollama
不想折腾 Docker 的话,用 Ollama(在自己电脑上跑开源大模型的工具):
# 第一步:装好 Ollama 后,拉一个模型(README 推荐的是 zephyr)ollama run zephyr
然后打开 extract_graph.ipynb,改一下输入路径,逐格运行。模型用的是 Mistral 7B OpenOrca(通过 Ollama 本地托管),整个提取过程不花一分钱 API 费。
技术栈一览
我翻了 Issues:它还不完美
从社区反馈来看,这个项目的短板也比较集中,作者也在 README 里开了"求共建"板块,列了几条社区建议的改进方向:
- 概念去重
:大模型提取概念时,"doctor"和"doctors"会被当成两个节点,需要用 embedding(把文本转成向量,用来判断两段话是不是一个意思)做语义合并; - 过滤噪音
:太泛、出现太频繁的概念会被留下来,图会很吵; - 共现权重失衡
:高频概念在 W2 里权重会过大,需要优化; - 前端交互
:目前只能整体浏览,还不能"点一个概念、展开它的子话题"往下钻。
这些是这类概念图谱项目的通病,不算这个项目的锅。但如果你打算拿去做正经生产工具,得心里有数:它现在更像一个很好的"方法验证"和起点,不是开箱即用的产品。
适合谁用
硬盘里 PDF 堆成山、想给资料建一张"能看的关系网"的人; 在研究 GRAG、想搞清楚图检索和向量检索到底差在哪的团队; 不想花 API 钱、只想在自己电脑上玩 RAG/GRAG 的用户; 对概念抽取、图可视化感兴趣的研究者和学生。
项目是 MIT 协议,代码就是一个 notebook,改改路径就能跑。
名词速查表
相关链接
GitHub:rahulnyk/knowledge_graph 在线示例图谱:rahulnyk.github.io/knowledge_graph 方法详解(Medium):How to convert any text into a graph of concepts
收藏夹里的 PDF 不会自己变成知识,但"让机器替你读一遍、再把关系画出来"这件事,现在本地就能免费做到。有兴趣的话,跑一遍 notebook 比看十篇介绍都直观。