ARTICLE · 977220
AI语料库怎样登记:到底登记文档、数据集,还是知识库?
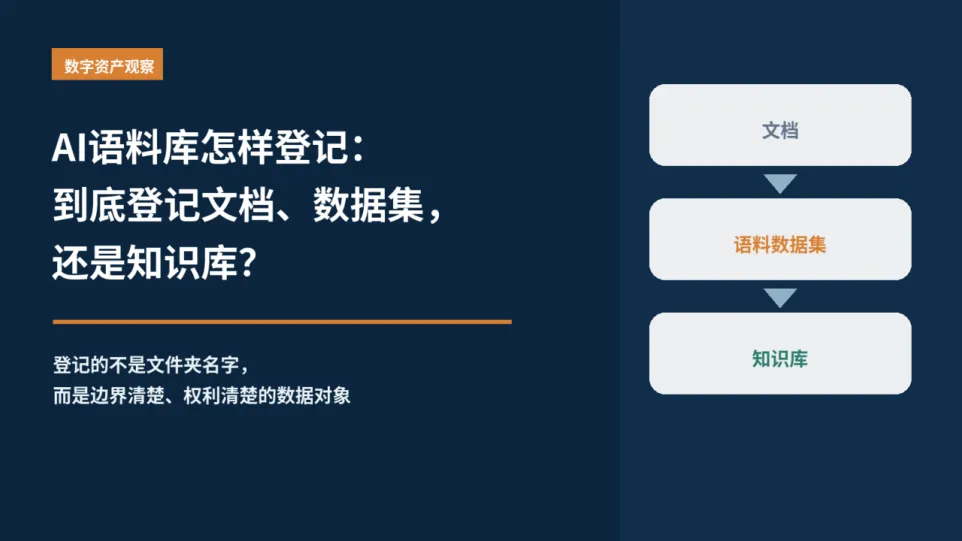
登记的核心不是文件夹名称,而是可识别的数据对象
把四层对象拆开,登记才不会从第一步就选错。
引言
Introduction
很多企业已经把制度、合同、产品手册、客服记录、图片和视频集中起来,建设AI语料库或企业知识库。项目完成后,业务部门说“我们有几十万份文档”,技术部门说“向量库已经建好”,管理层则希望把它登记成数据资产。于是问题来了:登记时,是把每份文档登记进去,还是登记清洗后的语料数据集,或者直接登记整个知识库?
先给结论:多数企业更适合把边界清楚、版本明确、经过治理并服务于具体AI场景的“语料数据集”作为核心登记对象。原始文档主要用于证明来源和范围;向量库、检索系统及知识库应用用于说明加工过程与应用价值。若知识库已经形成可对外提供的标准化服务,还可以进一步考虑数据产品登记,但不能把文档、软件、模型和数据全部揉成一个模糊对象。
AI语料库怎样登记:
How to Register an AI Corpus
01 先拆开:文档、语料数据集、向量库和知识库不是一回事
第一层是来源文档。包括企业制度、合同模板、操作手册、专家文章、客服工单、录音转写和图片。它们是语料的原料,也承担来源证明作用,但格式混杂、版本重复、权利情况不同,直接按单篇登记往往颗粒度过细。
第二层是语料数据集。企业对原始材料完成筛选、去重、脱敏、切分、结构化、分类和标注,形成问答对、段落片段、标签、摘要、图文样本或评测样本。这一层有相对稳定的字段结构、样本数量、质量指标和版本,因此更容易界定权利、成本和用途。
第三层是检索索引,包括向量、关键词索引、实体关系和知识图谱等。它们帮助模型“找得到”相关内容,可能属于数据加工结果,也可能与数据库、算法和软件功能紧密结合。第四层是知识库应用,包括检索增强生成(RAG)、问答界面、权限控制、反馈纠错和更新机制,更接近系统或数据产品。
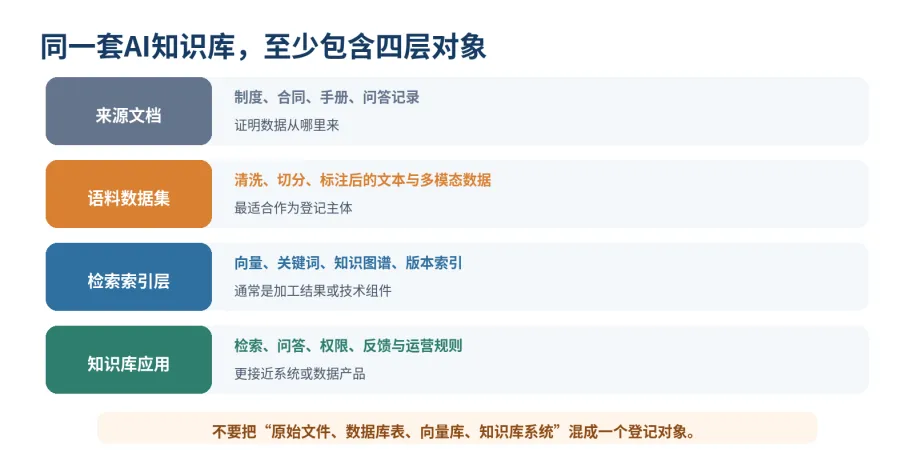
图1 AI知识库中常见的四层对象
02 为什么通常优先登记语料数据集?
登记对象首先要可识别。企业必须说清楚对象叫什么、包含哪些数据、覆盖什么时间、由谁形成、用于什么场景、当前是哪个版本。如果只写“公司全部文档”或“企业知识库”,范围会随着文件上传和系统运行不断变化,难以形成稳定基准。
语料数据集恰好位于“原料”和“应用”之间。一方面,它能够追溯到具体来源文档和授权;另一方面,它已经经过实质性治理,可以用样本量、字段数、标签体系、重复率、准确率、脱敏率和更新频率描述质量。它既能支撑模型训练、微调、评测,也能支撑RAG和智能体调用。
GB/T 47950—2026《资产管理 数据资产登记指南》将于2026年9月1日实施,强调建立数据资产信息卡和台账,登记信息覆盖基本、财务、使用、授权和处置等维度。对于AI语料,选择能够稳定填写这些信息的数据集,比选择一个不断变化的“文件夹”更符合资产管理逻辑。
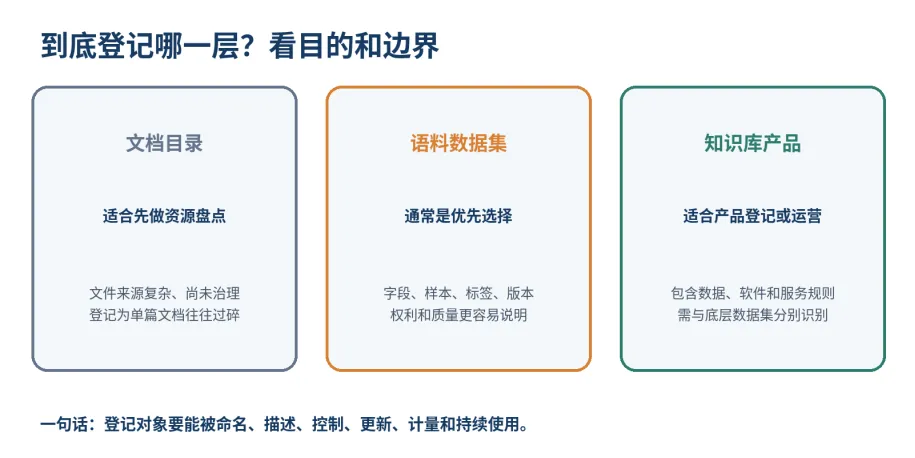
图2 文档目录、语料数据集与知识库产品的选择逻辑
03 用保险理赔知识库举例,登记对象就清楚了
假设一家保险服务企业建设理赔辅助知识库,收集保险条款、理赔规则、历史客服工单、拒赔原因和专家审核意见。技术团队把文档切成30万个知识片段,生成8万组问答对,设置险种、责任范围、材料要求和拒赔类型等标签,再建立向量索引供智能客服检索。
不建议把30万份原始文件逐一登记,也不建议只写“保险AI知识库”。更清晰的对象可以命名为“保险理赔规则与案例问答语料数据集V1.0”,明确基准日、覆盖险种、数据周期、样本量、字段和标签,并将来源文档目录、授权证明、脱敏报告、加工流程、质量报告和知识库应用说明作为附件。
需要注意,历史工单可能包含客户姓名、证件号、健康情况和理赔事实,不能因为做了向量化就当然合规。企业应说明处理目的、合法性基础、最小必要范围、去标识化方式和访问权限;采购外部文档时,还要核对著作权许可是否包含机器学习、模型训练、向量化和商业使用。
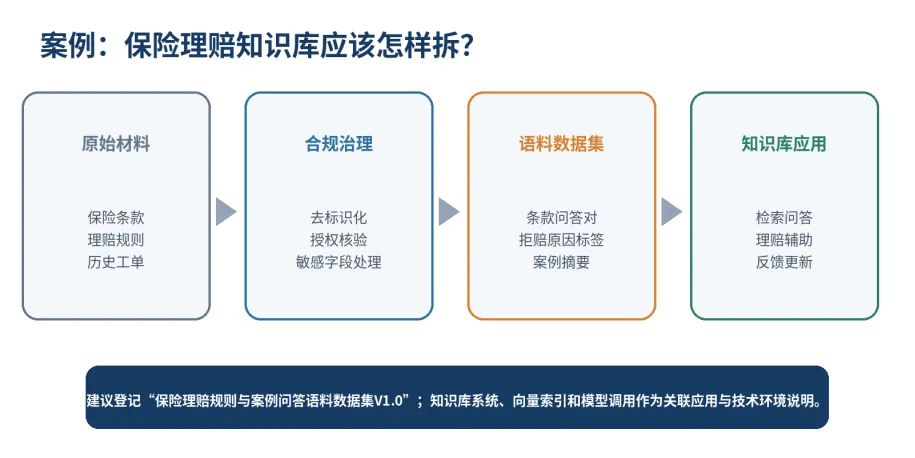
图3 保险理赔知识库的四层拆分示例
 04 交易所年报告诉我们:
企业正在建设什么,但不能替代登记结论
万达信息在深交所披露的2025年年度报告中提到,公司建设和管理了大量医卫健康数据集,为高质量数据集和语料库建设、AI应用创新、数据治理与共享开放打下基础。这说明上市公司已把语料库和高质量数据集作为AI业务底座。
但年报中的“建设和管理”不等于相关语料已经完成数据资产登记或会计入表。公开披露能证明业务布局和应用基础,登记仍要回到具体对象、来源权利、治理过程和质量证据;入表还要进一步判断企业是否控制、能否带来经济利益以及成本是否可靠计量。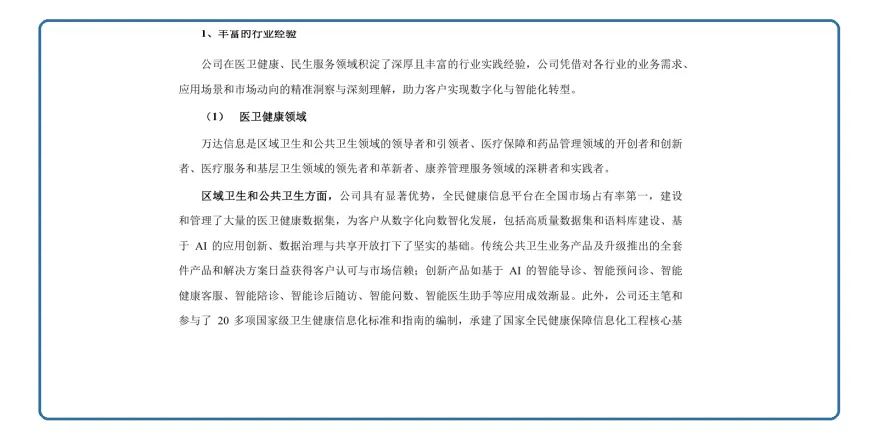
图4 万达信息年报披露医卫健康数据集及语料库建设
资料来源:深圳证券交易所:万达信息股份有限公司2025年年度报告
05 工程建设:
价值很大,但要先解决项目编码和成本归集
云鼎科技2025年年度报告列出的研发项目显示,其围绕煤矿安全生产构建高质量数据集建设体系,形成标准化方法论、技术路径、规范成果文件和实用工具,实现数据采集、质量管控、安全应用全流程覆盖。
这个案例对企业登记语料库很有启发:价值不在“收了多少文件”,而在于能否形成可重复的治理规则、可检查的质量指标、可持续的更新机制和可验证的应用结果。登记材料中应当同时呈现数据对象和数据工程能力,但二者不要混为同一项资产。
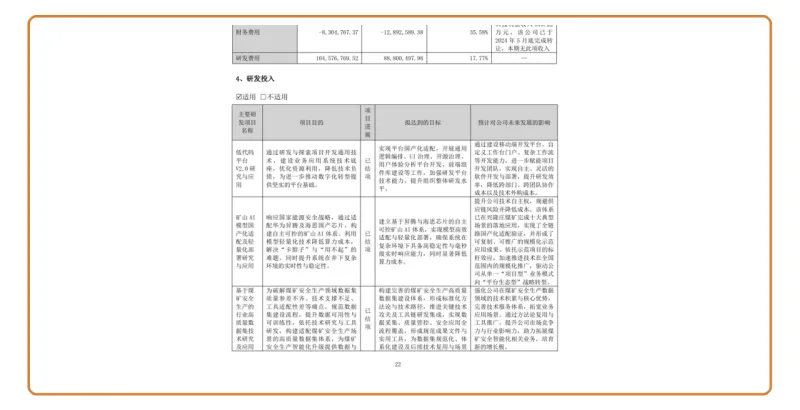
图5 云鼎科技年报中的煤矿安全生产高质量数据集项目
资料来源:深圳证券交易所:云鼎科技股份有限公司2025年年度报告
06 真正的登记案例:
3D高质量数据集为什么能成为明确对象?
国家数据局发布的工业制造典型案例记载,相关平台形成格式标准、标注明晰并嵌入版权水印的3D高质量数据集,实现全国首例面向大模型训练的3D高质量数据集资产登记,并推进挂牌交易。
它能够登记,不是因为“3D文件很多”,而是因为平台完成资源梳理、分类分级、格式转换、权利登记、授权管理、标准化交付和安全流通,形成了明确的数据集对象。对文本语料库同样如此:原始文档只是起点,真正适合登记的是经过治理、能够按标准交付和持续使用的数据集版本。
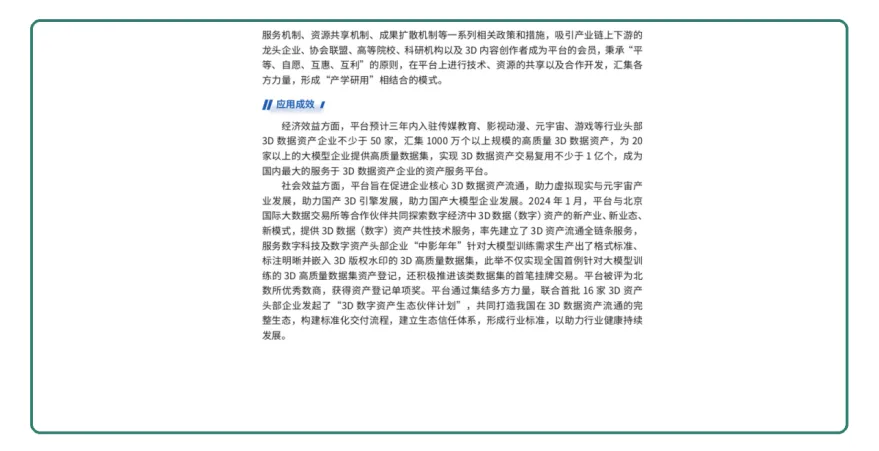
图6 面向大模型训练的3D高质量数据集资产登记案例
资料来源:国家数据局:《数据要素× 工业制造》典型案例集
07 AI语料库登记八项信息必须写清楚
对象名称不要写成“公司知识库”或“AI训练数据”,应体现行业、内容、用途和版本,例如“装备制造故障诊断图文语料数据集V1.0”。数据范围要写清文档类型、字段、样本数、文件容量、时间范围和剔除规则。
来源权利是最容易被忽略的部分。企业自有业务数据、员工创作文档、客户提交材料、公开网页、采购内容和委托加工成果,其权利基础完全不同。登记材料应对应合同、授权书、隐私告知、来源清单和处理记录,不能用一句“来源合法”概括。
质量指标要与应用场景对应。国家数据局发布的省域政务热线高质量数据集案例,形成48个行业领域、222项问题类型、4627项具体表现、15类知识库和10余万标签,并披露语音识别转化准确率97%、信息提取准确率92%、语义理解误差率不超过5%、脱敏合规率100%。这类可核验指标比单纯写“数据量大、价值高”更有说服力。
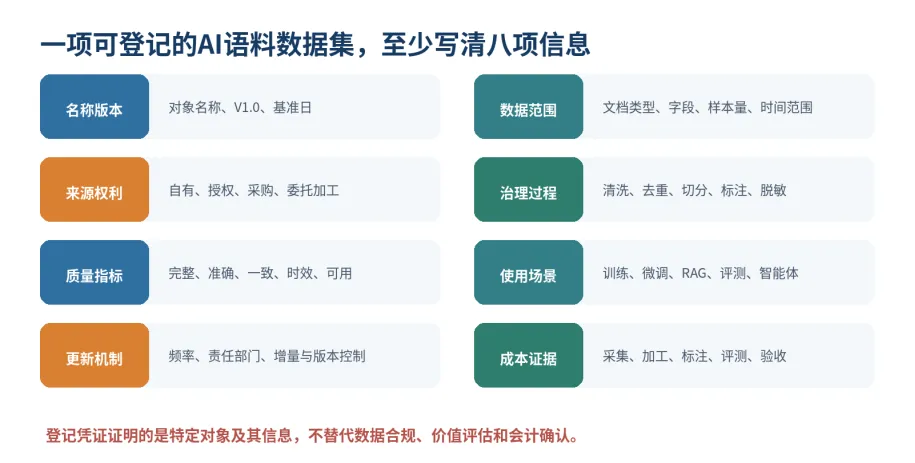
图7 AI语料数据集登记信息清单
08 登记知识库还是登记数据产品?
关键看企业怎么经营
如果知识库仅在企业内部使用,核心对象通常是底层语料数据集,知识库系统作为使用环境;如果企业向客户提供“行业知识问答API”“法规检索服务”或“智能客服知识库订阅”,则可以把标准化服务进一步识别为数据产品,说明输入、输出、服务等级、更新频率和收费模式。
数据资源登记、数据资产登记、数据知识产权登记和数据产品登记并不完全相同,各地登记机构的名称、材料和证明范围也可能不同。企业应先确定登记目的:是建立内部资产台账、证明数据持有和加工事实、支持交易流通,还是为评估和入表准备证据,再选择相应登记渠道。
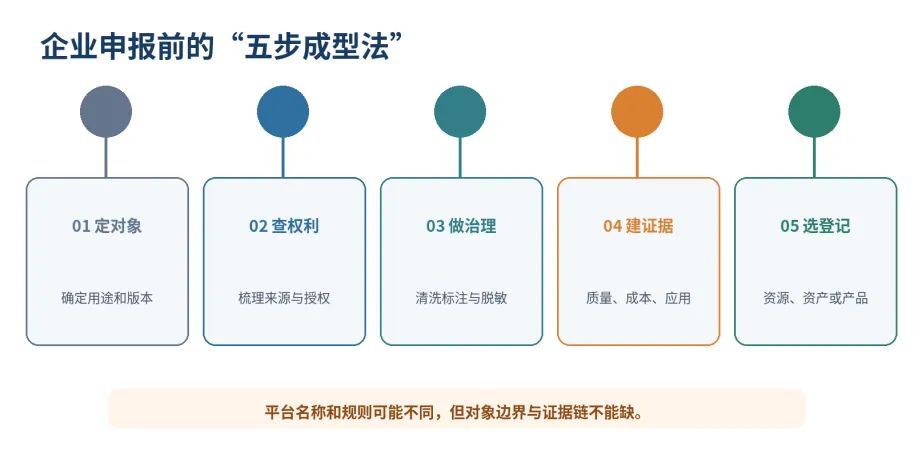
图8 AI语料库登记五步成型法
无论选择哪种登记,凭证都不是“万能确权证”。它不能替代个人信息合规审查、著作权授权、商业秘密管理、数据安全评估,也不能自动证明评估值或入账金额。登记的真正作用,是把对象、来源、治理、使用和变动信息纳入一套可持续管理的台账。
最后给企业一个简洁判断
Concise Judgment
文档尚未治理、来源复杂:先做资源盘点和文档目录,不急于逐篇登记。
已经形成清洗、切分、标注、脱敏和版本管理:优先以语料数据集作为登记对象。
知识库已形成稳定的对外问答、检索或API服务:底层数据集与上层数据产品分别识别,避免重复计算。
只有知识库软件和向量数据库,没有权力、质量、成本与应用证据:暂不宜直接包装成数据资产。
欢迎讨论
你所在的企业建设知识库时,最难说清的是文档来源、数据集边界,还是知识库的实际价值?欢迎在评论区分享你的情况。
后台私信回复“语料登记”,领取《AI语料数据集登记材料清单》。
参考与延伸阅读
1. 国家标准全文公开系统:GB/T 47950—2026《资产管理 数据资产登记指南》
2. 国家数据局:《关于推进行业高质量数据集建设行动的实施方案》
3. 深交所:万达信息股份有限公司2025年年度报告
4. 深交所:云鼎科技股份有限公司2025年年度报告
5. 国家数据局:《数据要素× 工业制造》典型案例集
6. 国家数据局:省域政务热线高质量数据集案例
7. 国家数据局:北京国际大数据交易所集中发布数据要素系列成果
8. 财政部:《企业数据资源相关会计处理暂行规定》答记者问
来源|数字科技部
编辑|王婧
校对|王婧
初审|张志恒
终审|魏正阳
深圳图腾瑞智科技有限公司出品
联系我们
联系电话:13364534944
电子邮箱:505554443@qq.com
官方网站:https://www.tutengnova.com/
欢迎随时垂询,获取详细服务方案与案例资料。
END