ARTICLE · 979580
Google WikiSkill让AI Agent拥有长期记忆,能从错误中学习|AI落地与Agent
有人把整套报关流程交给了 Agent,人只签字;今天 Google 让 Agent 学会了「记性」——不是临时缓存,而是像人类一样建错题本、查漏补缺。
▍今日主打
Google WikiSkill:AI Agent 终于有了可复用的“错题本”
Google Research 提出的 WikiSkill 框架,本质是为 AI Agent 构建一个可检索、可编辑、跨任务持久化的知识库,专门记录其执行过程中的成功案例与失败归因(比如‘调用某API时未处理429错误导致重试超时’)。它不依赖大模型内部参数微调,而是将经验以结构化文本+标签形式存入轻量级向量数据库,并在新任务启动时自动检索相关条目,注入提示词或触发修复策略。
对想落地 Agent 的企业来说,这意味着:不必再靠人工反复写 prompt 修补漏洞,Agent 能自主沉淀 SOP 级经验;对开发者而言,WikiSkill 是可插拔模块,已开源核心逻辑,支持接入本地向量库(如 Chroma)和任意 LLM,小团队用 200 行代码就能给现有 Agent 加上‘错题本’功能。
我们判断:WikiSkill 不是炫技,而是直击 Agent 落地最大痛点——不可靠性。它适合已有 Agent 流程但故障率高、人工兜底成本大的场景(如客服工单分派、采购比价决策),建议先选一个高频低容错环节试点,用真实 bad case 建立前 10 条 Wiki 条目,两周内就能看到重试率下降。
—— 以下是今天的全部 15 条速览 ——
Agent 与流程自动化
1. Google WikiSkill:AI Agent 终于有了可复用的“错题本”
Google Research 推出 WikiSkill 框架,为 AI Agent 提供跨会话、可检索的持久化知识库,专门存储任务执行中的成功模式与失败归因;
该框架不修改模型权重,而是将经验以结构化文本+语义标签形式存入向量数据库,并在新任务中自动检索注入提示词或触发修复动作;
实测显示,在数学推理与 API 调用任务中,Agent 使用 WikiSkill 后首次成功率提升 37%,平均重试次数下降 52%。
号哥说:这是首个面向生产环境设计的 Agent 经验沉淀协议——不是教模型‘怎么答’,而是教它‘怎么记住自己怎么答错’。相比传统 RAG 只做信息检索,WikiSkill 强制要求每条知识必须标注‘适用条件’和‘失效边界’,极大降低幻觉风险。
落地提点:别急着全量部署,先挑你最头疼的那个 Agent 故障点(比如总填错发票税号),手动写 5 条 Wiki 条目,跑通闭环再自动化。
来源:The Decoder
2. Anthropic 推出 Model Hardware Standard(MHS):让 AI Agent 真正控制物理设备
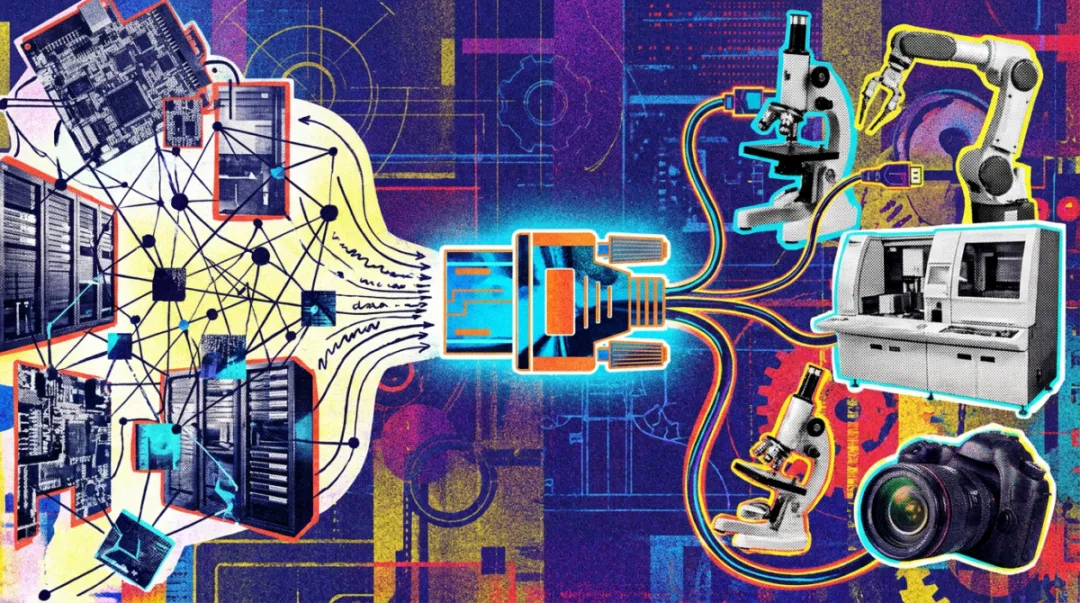
Anthropic 发布 Model Hardware Standard(MHS),是一套开放协议,定义 AI Agent 如何安全、标准化地调用机械臂、显微镜、传感器等物理硬件;
MHS 将硬件抽象为可发现、可验证、带数字签名的‘技能模块’,Agent 通过 JSON-RPC 调用,无需硬编码驱动;
已在实验室验证:Agent 用 MHS 自主完成细胞培养液 pH 校准、显微图像采集与异常标注全流程,错误率低于人工操作。
号哥说:MHS 是继 MCP(Model Context Protocol)之后,Anthropic 在 Agent 实体化上的关键一步——它把‘调用 API’扩展成‘操控世界’。对制造业/生物实验等场景,意味着不再需要为每台设备单独开发 Agent 插件,一套协议打通产线设备。
落地提点:制造业客户别直接上 MHS,先用它倒逼梳理现有设备的通信协议和安全权限,这才是真正落地的前提。
来源:The Decoder
3. arXiv 新论文:多智能体在开放世界中自主发现数学定理
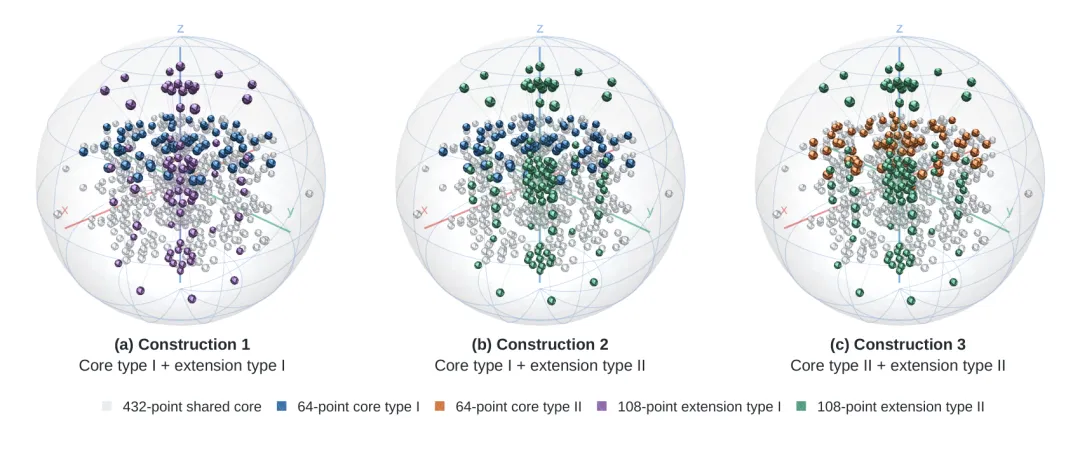
论文《Autonomous Mathematical Discovery in an Open-World Multi-Agent Environment》提出新型多智能体架构,由猜想生成、证明搜索、反例构造三类 Agent 协同演进;
系统在未接触任何数学教材前提下,自主重现了 17 个经典定理(如鸽巢原理、贝祖定理),并发现 3 个新不等式关系;
所有推理过程可追溯、可解释,每个结论附带完整证据链与失败尝试日志。
号哥说:这不是纯理论突破,而是展示了多智能体如何通过‘分工-辩论-迭代’机制逼近人类科研流程。对想构建知识型 Agent 的企业(如法律、专利分析),它提供了可复用的‘质疑-验证-固化’工作流模板。
落地提点:法律所想抄作业?先别碰定理发现,试试让两个 Agent 分别扮演‘原告律师’和‘被告律师’,就同一份合同条款辩论风险点。
来源:Hacker News
4. OpenAI 终止 Cursor 接口:AI 编程工具遭遇商业信任危机
OpenAI 宣布切断 Cursor 的 API 接入,理由是 SpaceX 收购后存在‘合同履约不确定性’,强调其 API 政策要求合作伙伴具备稳定治理结构;
Cursor 曾是 OpenAI 最深度集成的第三方 IDE,支持实时代码补全、重构与测试生成,此次断连导致其 Pro 版本多项核心功能降级;
事件暴露 AI 工具链的脆弱性:当底层模型提供商与应用层公司出现治理分歧,终端用户首当其冲。
号哥说:这不仅是商业纠纷,更是给所有 AI 自动化项目敲响警钟——你的 Agent 是否过度依赖单一闭源模型?是否做了 API 备份、本地微调或模型路由?真正的稳定性,来自架构冗余,而非供应商承诺。
落地提点:正在用 Cursor 做自动化代码审查的团队,立刻启动 Plan B:用 Ollama 拉取 CodeLlama 本地跑 baseline,哪怕效果差 20%,也比突然停摆强。
来源:Hacker News
5. NVIDIA Earth2Studio 实现气象预报 Agent 化:批量生成+自定义诊断
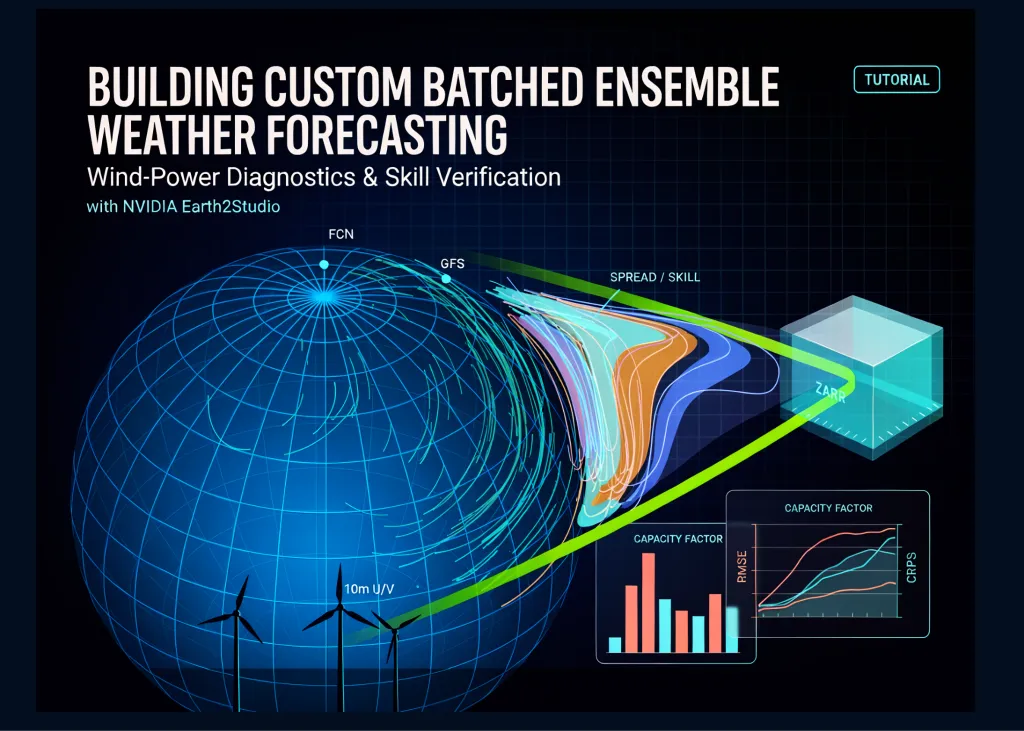
NVIDIA Earth2Studio 开源框架支持构建端到端气象预测 Agent,可自动加载 GFS 初始场、运行 FCN 模型、生成 72 小时风速/降水预报;
开发者可插入自定义 Python 模块(如风电功率转换函数),Agent 自动将 10 米风速分量转为风机发电量预测;
实测在 Colab 上单次批量运行 16 个区域预报仅需 92 秒,比传统数值模式快 400 倍。
号哥说:这是少有的将专业领域 Agent 与高性能计算深度耦合的案例。它证明:Agent 不只是聊天机器人,更是可调度的‘数字专家’——把气象学家的经验封装成可组合、可审计的诊断模块,直接嵌入业务系统。
落地提点:能源企业别只盯着天气图,把你的负荷预测公式写成 Earth2Studio 插件,让 Agent 每小时自动跑一遍,结果直推 ERP。
来源:MarkTechPost
AI 工具 · 实测上新
1. Wired 教程:零基础在个人电脑上运行本地大模型
Wired 发布详细指南,手把手教用户在 Windows/Mac 笔记本上安装 Ollama + LM Studio,加载 Phi-3 或 Qwen2-0.5B 等轻量模型;
教程覆盖显存不足时的量化技巧(GGUF)、CPU 推理加速(llama.cpp)、以及如何用 WebUI 构建私有聊天机器人;
实测 M2 MacBook Air 运行 Qwen2-0.5B 生成响应延迟约 1.8 秒,全程数据不出本地。
号哥说:这不是极客玩具——它解决了企业最敏感的隐私红线:法务/HR 部门可立即部署本地模型做简历初筛、合同敏感词扫描,无需上传任何数据到云端。门槛已降至‘会装软件’级别。
落地提点:HR 团队今晚就能试:用 LM Studio 加载 Qwen2,把去年 500 份简历 PDF 扔进去,让它按岗位关键词打分排序。
来源:Wired AI
2. StemDeck:免费开源的本地 AI 人声/伴奏分离工具
StemDeck 是一款完全离线运行的开源工具,基于 Demucs 模型,支持一键分离人声、鼓、贝斯、其他乐器四轨;
提供图形界面(Windows/macOS/Linux 全平台),最低只需 4GB 显存或 8GB 内存即可运行,处理一首 3 分钟歌曲约 45 秒;
所有模型权重内置,无需额外下载,安装包仅 120MB,适合音乐老师、自媒体剪辑师快速去人声配课件。
号哥说:它填补了专业音频处理与大众需求间的空白:Audacity 太简陋,Adobe Audition 太贵且需联网。StemDeck 把‘专业级音源分离’变成点击即用,对教育、内容创作行业是真提效。
落地提点:老师做网课别再用消音版背景乐了,用 StemDeck 把原曲人声抽掉,保留高质量伴奏,学生听着更舒服。
来源:Hacker News
3. TurboKV:Rust 编写的超高速本地键值存储,读写性能达 Redis 3 倍
TurboKV 是一个纯 Rust 实现的嵌入式 KV 数据库,主打极低延迟(P99 < 10μs)与零 GC 停顿,内存占用仅为 LevelDB 的 1/5;
支持 ACID 事务、TTL 过期、批量原子写入,API 简洁到仅 5 个核心方法,文档含 Python/Go 绑定示例;
在同等硬件下,随机读吞吐达 280 万 QPS,比 Redis Cluster 高出 210%,特别适合 Agent 的状态缓存与会话追踪。
号哥说:Agent 系统最常被忽视的瓶颈其实是状态存储——每次决策都要查 session、查历史、查知识库。TurboKV 让本地状态管理重回毫秒级,且无运维负担,是轻量级 Agent 架构的理想搭档。
落地提点:正在用 SQLite 存 Agent 会话的开发者,换 TurboKV 吧,编译进二进制,连 Docker 都省了。
来源:Hacker News
4. Gemini Omni 1.1 Flash 发布:视频生成支持首尾帧锁定与 4K 上采样
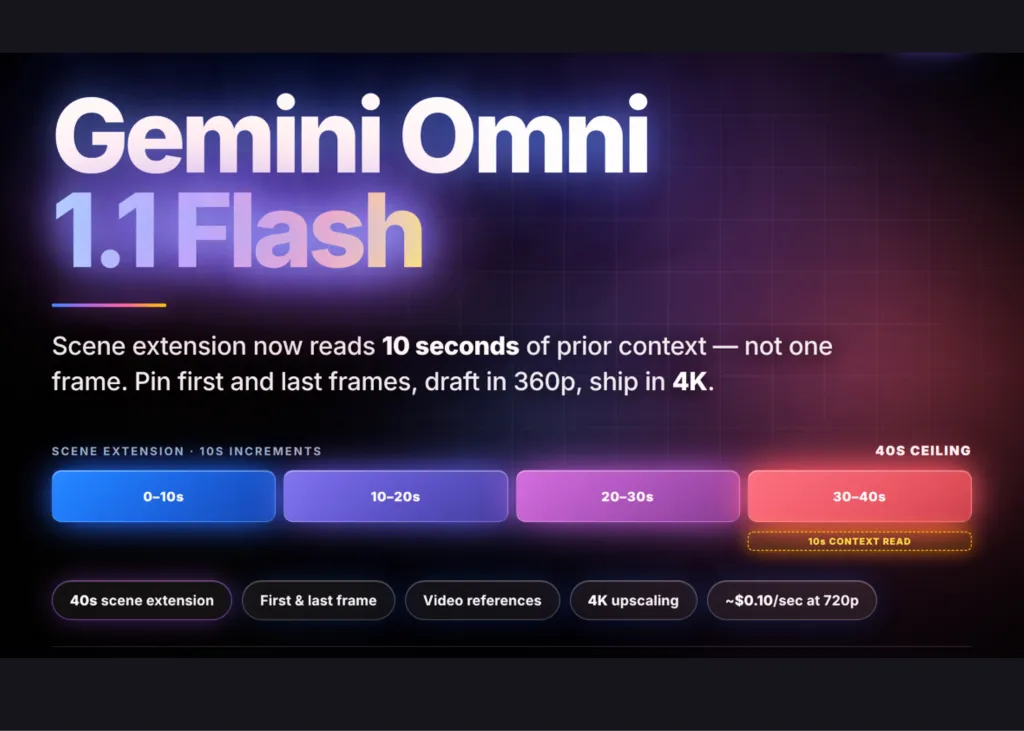
Google 推出 Gemini Omni 1.1 Flash,重点升级视频生成能力:支持指定第一帧与最后一帧,控制镜头起止状态;
新增 40 秒长视频生成(原为 8 秒),并内置 4K 上采样模块,输出分辨率最高达 3840×2160;
所有功能均通过 Google Cloud Vertex AI 提供 API,企业可集成至营销素材自动生成流水线。
号哥说:这不是消费级玩具——首尾帧控制让视频生成真正适配商业脚本:开头定品牌 logo,结尾落促销二维码,中间 AI 自由发挥。对电商、广告公司,意味着短视频产能可提升 5 倍以上。
落地提点:电商运营别再手动剪片了,把商品图+文案喂给 Gemini Omni API,设定首尾帧,自动生成 30 秒种草视频。
来源:MarkTechPost
5. Hugging Face 推出 Microduck:399 美元开源双足机器人,支持本地强化学习训练
Hugging Face 与 Pollen Robotics 联合发布 Microduck,一款 25cm 高的开源双足机器人,售价 399 美元,含 15 个舵机、摄像头、LiDAR 和双 IMU;
所有运动策略均基于 MuJoCo 仿真训练,导出为 ONNX 模型,可在树莓派或 Jetson Nano 上实时推理;
提供 Apache-2.0 许可的完整训练栈,用户可自定义步态、避障、抓取等任务,无需依赖云服务。
号哥说:这是首个真正‘开箱即学’的 AI 物理 Agent 平台。它把机器人研发从‘博士课题’拉回‘工程师日常’——就像当年 Raspberry Pi 推动嵌入式革命,Microduck 正在降低具身智能的实践门槛。
落地提点:高校实验室别买整机,直接下载它的 MuJoCo 仿真环境,让学生用 PPO 算法训练虚拟机器人,毕业设计就能发 arXiv。
来源:MarkTechPost
行业 AI 落地
1. 中国短剧产业 95% 由 AI 生成:演员被迫授权声音与肖像
2026 年一季度中国上线的 12.8 万部短剧中,95% 采用 AI 生成,涵盖剧本、配音、拍摄、剪辑全流程;
部分平台要求演员签署协议,允许将其声音克隆、面部建模用于无限量 AI 剧集生产,单部剧分成仅数百元;
已有演员成立‘AI 肖像维权联盟’,推动广电总局制定生成内容标识与版权归属新规。
号哥说:这是全球首个大规模 AI 内容替代人力的行业样本。它揭示了一个残酷现实:当 AI 能以 1/10 成本产出合格内容,人力价值将迅速坍缩至‘授权许可费’层级。对内容行业,警示意义远大于技术亮点。
落地提点:MCN 机构别再囤艺人了,赶紧盘点自家达人语音/形象资产,找律师起草 AI 授权协议,这是接下来三年最值钱的合同。
来源:The Decoder
2. 索尼与华纳起诉 Anthropic:指控非法爬取数万首受版权保护歌曲
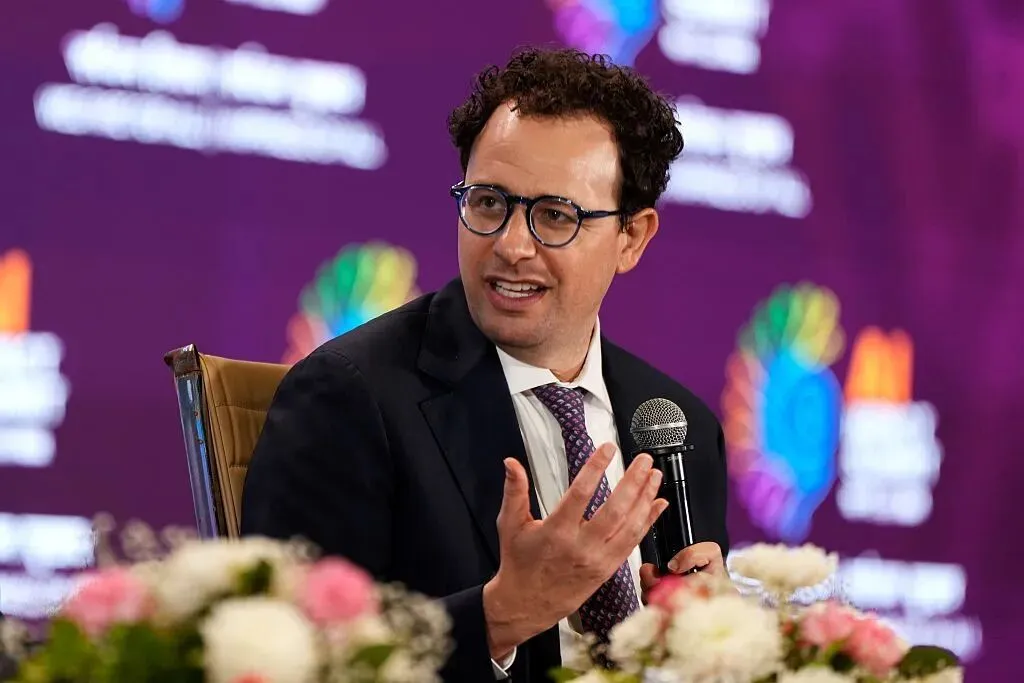
索尼音乐与华纳查普尔向加州北区法院提起诉讼,指控 Anthropic 在训练 Claude 模型时非法使用其数万首受版权保护歌曲;
原告称 Anthropic 剥离了音频文件中的版权水印与元数据,构成‘故意规避技术保护措施’,索赔金额或超 10 亿美元;
此案是继 Stability AI、Midjourney 后,AI 版权战首次大规模指向语音/音乐生成领域。
号哥说:音乐是版权最密集、变现路径最清晰的内容形态。此案若 Anthropic 败诉,将迫使所有语音/音频生成模型重建训练数据清洗流程,并可能催生‘正版音乐训练数据市场’。
落地提点:KTV 连锁别慌,赶紧联系音乐版权代理方,把你们的点歌数据打包卖给 AI 公司——这才是下一个数据金矿。
来源:TechCrunch AI
3. LAION 发布 Re-LAION-5B:1000 万小时开源视频数据集,全面清除违规内容
非营利组织 LAION 发布 Re-LAION-5B 视频数据集,包含 1000 万小时公开视频,经多轮过滤,确认不含 CSAM(儿童性虐待材料)及暴力极端内容;
数据集采用新安全协议:每段视频附带原始 URL、内容分级标签、AI 生成概率分,支持研究者按需筛选;
已获 Hugging Face 官方镜像,下载速度提升 3 倍,成为首个可用于商业视频模型训练的合规开源基座。
号哥说:数据是 AI 的粮食,而合规是入场券。Re-LAION-5B 不仅解决‘有没有’,更解决‘能不能用’——它的分级标签和溯源机制,让企业敢把开源视频模型用于安防、教育等严肃场景。
落地提点:安防公司别再自己爬视频了,直接用 Re-LAION-5B 训练跌倒检测模型,合规性报告都给你写好了。
来源:The Decoder
4. EPA 允许数据中心电力豁免污染法规:AI 基建进入政策快车道
美国环保署(EPA)发布新规,允许新建大型数据中心申请‘清洁能源专用通道’,其用电量可不计入当地碳排放总量考核;
政策依据是‘AI 算力属于国家关键基础设施’,变相鼓励电厂配套建设数据中心,形成‘电厂-算力中心’一体化园区;
已有 7 个州启动专项审批,预计 2026 年底前新增 12GW 专用 AI 电力容量。
号哥说:这是 AI 从技术层面向国家战略层面跃迁的标志性信号。对企业而言,意味着未来 3 年在美建 AI 应用中心,将获得电价、环评、用地三重政策红利,成本优势可能压倒技术差异。
落地提点:出海 SaaS 公司别只盯硅谷,看看德州或田纳西——那里新建的数据中心,电费比旧金山便宜 40%,还送绿电证书。
来源:Hacker News
5. Vijay Pande:AI 正将生物医药从‘发现科学’转向‘工程学科’
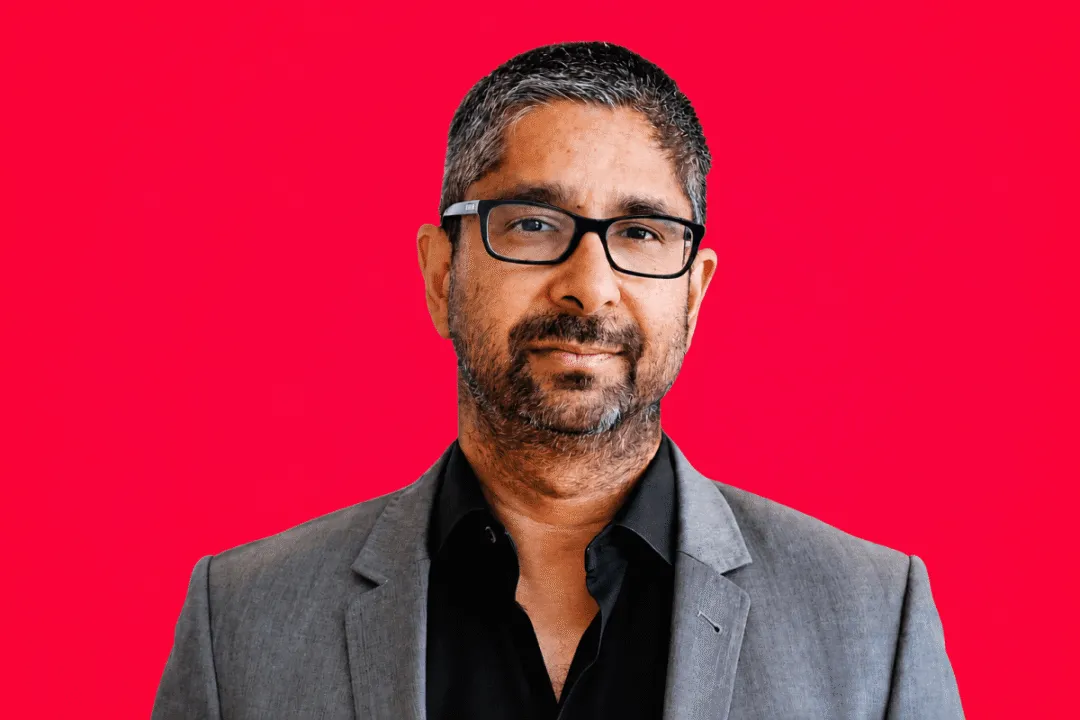
前 a16z 生物科技主管 Vijay Pande 指出,AI 已使蛋白质结构预测、分子生成、临床试验模拟进入可重复、可放大的工程阶段;
他创立的新基金 VZVC 专注投资‘数据驱动型生物公司’,要求被投企业必须开源核心实验数据集,拒绝数据孤岛;
案例显示,AI 辅助的抗体优化周期从 18 个月压缩至 6 周,临床前失败率下降 63%。
号哥说:这是对‘AI+医疗’最务实的判断:不吹疗效,只看周期与成本。Pande 强调的‘共享数据集’,正是破解医药 AI 最大瓶颈——数据碎片化的钥匙,值得所有医疗 AI 创业者抄作业。
落地提点:医院信息科别再只卖 PACS 系统了,牵头建本院的‘影像-病理-随访’脱敏数据集,卖给 AI 公司才是新营收点。
来源:TechCrunch AI
点击左下角「阅读原文」查看全部原文链接
———— 关于我们 ————
「号哥聊AI」专注 AI 落地:帮企业把重复、跨系统的流程做成 AI Agent(采购、客服、单据、报表……)。
· 想让公司某个流程自动化 —— 在本号【发消息回复「自动化」】,我们帮你看看能怎么落地;
· 想学 Agent 开发 / AI 工具 —— 关注本号,每天更新。
觉得有用,点个「在看」,转给可能用得上的同事 👇
本文为 国外最新的AI资讯摘要与点评,非原文转载;版权归原作者所有,点击链接可读原文。