ARTICLE · 979752
AI 芯片的软件和硬件设计——脉动阵列,AI 硬件的基石
/AI 芯片的软件和硬件设计——脉动阵列,AI 硬件的基石/
翻译自 Bjarke Hammersholt Roune 的博文
在 Transformer 等深度学习模型中,几乎所有数学运算(OP)都集中在矩阵乘法中。对于硬件而言,大规模脉动阵列是实现矩阵乘法最高效的方式之一,因此,脉动阵列构成了 AI 硬件的基础。
Nvidia GPU(例如 Blackwell)或 Google TPU 等 AI 加速器芯片,本质上可以看作是为脉动阵列提供计算、存储和数据访问能力的平台。AI 芯片中除了脉动阵列之外还包含许多其他模块,但脉动阵列通常是其中最重要的部分,就像汽车的发动机一样。
本文并不具体介绍什么是脉动阵列,也不讨论如何利用脉动阵列实现矩阵乘法。作者假设读者已经具备相关基础;如果此前没有接触过,也可以借助 Gemini 等 AI 助手了解其基本原理。
如果未来出现一种不再依赖矩阵乘法的新型 AI 技术,那么本文中的许多结论可能都需要重新审视。目前来看,这种情况似乎并未出现,因为矩阵乘法长期以来一直是 AI 计算的核心。但对于任何 AI 芯片厂商而言,这始终是一项无法消除的风险:随着 AI 研究的发展,今天设计的 AI 芯片未来可能不再适用。十年前如此,现在仍然如此。
Nvidia GPU 和 Google TPU 等 AI 芯片通常集成多个大型脉动阵列。如果 AI 芯片设计合理,那么 AI 计算所消耗的大部分电能实际上都会用于驱动这些脉动阵列。因此,当人们讨论 AI 消耗大量电力时,对于设计良好的 AI 硬件而言,其中很大一部分实际上对应的是脉动阵列的功耗。这并不意味着脉动阵列本身能效低;恰恰相反,如果没有脉动阵列,完成相同计算所需要的电力可能会更高。
脉动阵列在很大程度上决定了一颗 AI 芯片所能达到的性能和能效上限。通常所说的 AI 芯片“利用率”,理想情况下应接近 100%,其中最主要的含义就是脉动阵列有多少时间处于有效计算状态。芯片中的其他模块,很大程度上都是为了持续向脉动阵列提供数据和任务,使其尽可能保持满负荷运行。
在 Nvidia GPU 中,脉动阵列位于 Nvidia 所谓的 Tensor Core 中。Google 则使用矩阵乘法单元(Matrix Multiply Unit,MXU)来指代其脉动阵列。虽然“multiply”这个单词中并没有字母 X,但由于 X 有时也用于表示乘法,例如 2×3=6,因此 Google 将其称为 MXU。AMD 将其脉动阵列称为 Matrix Core,Intel 则将访问其脉动阵列的接口称为 Advanced Matrix Extensions(AMX,高级矩阵扩展)。在 Amazon Inferentia 和 Trainium 中,相关计算单元则被称为 NeuronCore。
乍看之下,各家公司似乎采用了种类繁多的 AI 芯片架构。它们之间当然确实存在差异,但作者认为,从核心计算结构来看,本质上都是以脉动阵列为中心,再配合其他模块将整个系统组织起来。换句话说,核心仍然是脉动阵列,各种不同名称更多属于厂商的品牌和市场命名。
当然,也存在不包含脉动阵列的 AI 芯片,例如早期的一些 Nvidia GPU。但与集成脉动阵列的芯片相比,这类芯片在多数 AI 应用中的功耗效率和面积效率较低,因此并不是理想选择。
因此,下次再听到某款 AI 芯片采用诸如“极光极速爱因斯坦天才核心”“牛顿苹果坠落尤里卡核心”之类的新名称时,作者建议首先想到:这些所谓的新型核心,很可能本质上仍然是在描述脉动阵列。脉动阵列本身并不是一种新技术,其概念早在 1978 年就已经提出。近年来之所以大量 AI 芯片开始采用大型脉动阵列,主要是因为 AI 的发展突然创造了对这种计算结构的大规模需求。
因此,作者认为,脉动阵列并不是某种高度现代化的新发明,而是一项历史较久、如今突然获得庞大市场需求的技术。如果深度学习早在 1978 年就已经出现,那么当时很可能同样会出现一轮脉动阵列芯片——也就是今天所谓 AI 芯片——的研发热潮,其基本逻辑并不会有太大区别。
有人可能会认为,高存储带宽和高网络带宽对于 AI 同样非常重要,因此 AI 芯片并不能只关注脉动阵列。作者对此并不否认,但进一步指出:AI 之所以需要如此高的带宽,恰恰是因为脉动阵列的计算效率非常高,需要持续以很高的数据速率向其供给数据,否则脉动阵列就会因为等待数据而闲置。如果没有脉动阵列,芯片本身的计算速度会低得多,那么单颗芯片所需要的存储和网络带宽也不会如此之高。从这个角度看,AI 革命在很大程度上建立在脉动阵列所带来的高成本效率之上。
到这里可以得到一个基本结论:
AI 芯片的“发动机”是脉动阵列,而不同公司只是为各自采用脉动阵列的芯片或计算单元赋予了不同的名称。
”在本文后续内容中,作者将主要讨论 Nvidia GPU 和 Google TPU。一方面,他曾分别在 Nvidia 和 Google 参与这两类芯片的相关工作,因此对其较为熟悉;另一方面,截至 2026 年,他认为 Nvidia GPU 和 Google TPU 也是行业中最具代表性的两类 AI 芯片产品。当然,市场上还存在大量其他基于脉动阵列的芯片,也就是通常所说的 AI 芯片。
例外情况(极客内容) :当然,也存在少数例外。例如,Groq 的 LPU 并未采用大型脉动阵列,甚至可能完全没有采用脉动阵列。LPU 主要面向低 token 延迟场景,而不是追求经济型 AI 计算。Nvidia 后来获得了 Groq 相关技术的授权,Nvidia CEO 黄仁勋在 GTC 2026 上的表述也与此一致:这类技术主要面向成本较高但要求低延迟的 token 服务,而不是通用、低成本的 AI 计算。
此外,还有一些模拟计算芯片,尝试利用光学或电学模拟计算以其他方式降低 AI 计算成本。目前这类方案尚未得到充分验证,但如果未来能够证明其实际可行性,也可能成为值得关注的发展方向
更大的脉动阵列具有更高的效率
这一节是本文少数涉及一些数学内容的章节之一。作为补偿,作者还配了一些(画得不怎么样的)示意图。
假设需要将两个 N×N 矩阵 A 和 B 相乘,得到矩阵乘积 C=A×B。那么,可以将脉动阵列直观地表示为如下形式:
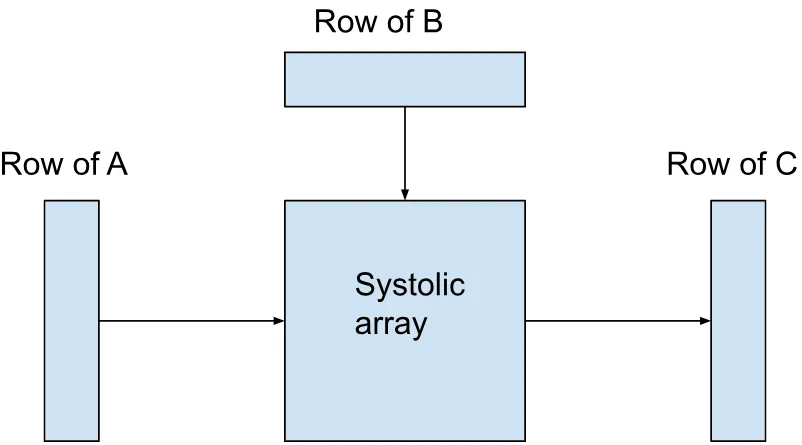
脉动阵列在每个时钟周期都会从左侧接收一个向量、从顶部接收一个向量,并从右侧输出一个向量。可以看出,这张示意图经过了简化,因为要计算 C 的一行,需要掌握整个矩阵 B 的信息,因此在完整接收到 B 之前,实际上无法生成 C 中的任何一行。
因此在实际设计中,通常会先将整个矩阵 B 送入脉动阵列并存储在阵列内部,然后再开始处理矩阵 A 的各行。不过,如果连续执行多个彼此独立的矩阵乘法,就可以在处理当前矩阵 A 并输出前一个矩阵 C 的同时,将下一次矩阵乘法所需的矩阵 B 送入阵列。这样,脉动阵列的左侧输入、顶部输入和右侧输出可以在每个周期都保持工作状态,这种情况称为 100%利用率。显然,100%的利用率是理想状态。
脉动阵列通常还会采用所谓的偏斜/错位(skew/stagger)机制,这会使实际的数据流更加复杂。不过,由于这一机制与本节讨论的重点无关,作者在此不展开介绍。
对于一个 N×N 的脉动阵列,其向量宽度为 N。那么,如果将向量宽度从 N 扩大到 2N,即由 N×N 脉动阵列扩展为 2N×2N 脉动阵列,会发生什么?其结构大致如下:
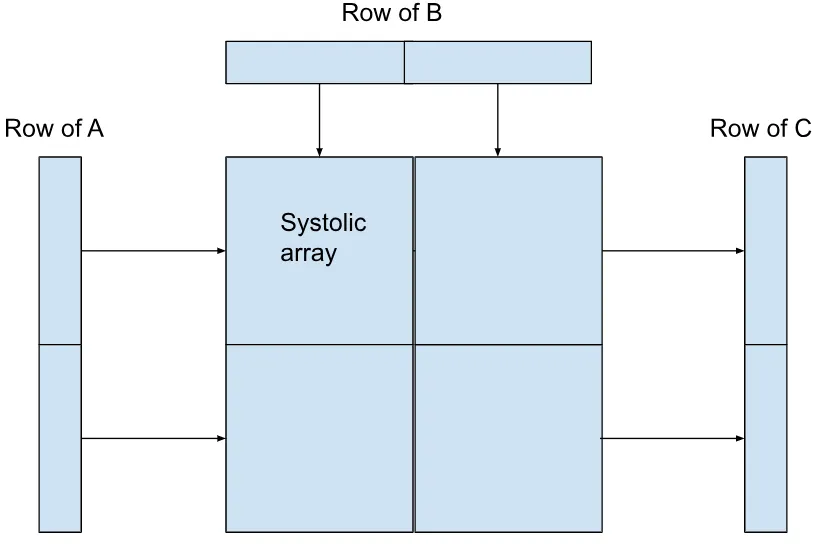
向量宽度扩大了 2 倍,而脉动阵列的规模扩大到原来的 4 倍,因此每个时钟周期能够完成的数学运算量也提升到 4 倍。
为了进一步理解将向量宽度从 N 扩大到 2N 究竟带来了什么收益,还需要将示意图扩展,把与每个脉动阵列配套的 CPU 也包含进来。这里的 CPU 也可以是类似 GPU 这样的 CPU 式控制结构,其作用是向脉动阵列下发操作指令,并负责处理来自矩阵 A、B 和 C 的各行数据,也就是相应的向量。
这一结构可以在下图中看到。
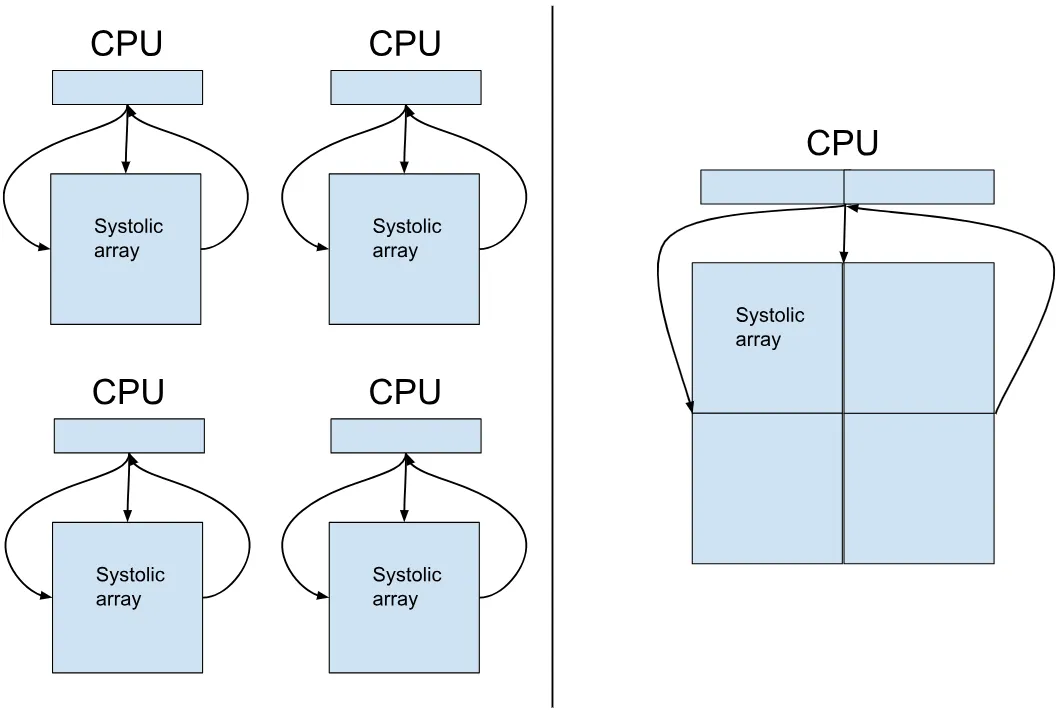
那么,使用更大的脉动阵列究竟获得了什么收益?一个 2N×2N 脉动阵列每周期能够完成的数学运算量是原来的 4 倍,因此,如果仍然使用较小的 N×N 脉动阵列,要达到相同吞吐量就需要 4 个脉动阵列,同时还需要 4 个额外的 CPU 核心,用于控制这 4 个脉动阵列并处理相应的向量。也就是说,与 N×N 脉动阵列相比,采用 2N×2N 脉动阵列后,所需的 CPU 核心数量及相关控制工作量减少到了原来的 1/4。
当然,右图中的 CPU 需要处理宽度扩大 2 倍的向量,因此 CPU 自身会变得更复杂、成本更高,但其成本增加通常小于 2 倍。因此,从左图所示结构变为右图所示结构后,在保持矩阵乘法能力不变的情况下,芯片中除脉动阵列之外的其他部分可以缩小超过 2 倍。换句话说,仅仅通过将向量宽度扩大 2 倍,就可以使芯片其他部分的效率提高约 2 倍。如果再扩大一次,收益可以达到约 4 倍;再次扩大,则可以达到约 8 倍,以此类推。
有人可能会问,是否可以只使用一个 CPU 核心来驱动左图中的 4 个脉动阵列?理论上当然可以,但这个 CPU 核心就必须具备约 4 倍的处理能力或运行速度,因此从整体资源消耗来看,并不会改变上述结论。
这些示意图解释了为什么近年来 AI 芯片中的脉动阵列正在不断增大。Nvidia GPU 在 Volta(2017 年)中采用了 4×4 脉动阵列,在 Turing(2018 年)中扩大到 16×16,而到了 Blackwell(2025 年)则进一步扩大到 64×64。Google TPU 则长期采用 128×128 或 256×256 规模的脉动阵列。
有人可能认为,上面的示意图并不适用于 GPU,因为图中画的是“脉动阵列+CPU 核心”,并没有专门画出 GPU。但对于这里讨论的问题而言,可以将 GPU 理解为一种高度专用化、具有大量向量计算能力的 CPU 式处理器,因此这一分析同样适用于 GPU。只需要将图中的“CPU”理解为“GPU”,其基本含义并不会改变。
一个值得思考的问题
2017 年时,Nvidia 已经是一家规模庞大且盈利能力很强的公司,GPU 当时以及现在都是其核心产品。相比之下,Google 虽然同样是一家大型公司,但当时 Google 内部的 TPUv2 团队规模很小,软硬件人员加起来大约只有 30 人,其中 XLA 团队大约只有 5 人。然而,从那时开始,Google TPU 却一直能够与 Nvidia GPU 保持较强的竞争力。这是如何做到的?作者认为,其中一个重要原因就在于脉动阵列规模的差异。
可以比较 Volta 与 TPUv3 的脉动阵列规模。Volta 采用 4×4 脉动阵列,而 TPUv3 采用 128×128 脉动阵列。为了理解这一差异带来的影响,可以分别从标量计算和向量计算两个方面分析。
标量计算
标量计算包括向 AI 加速器中的其他模块下发控制信息、决定其执行何种操作等工作。前面的分析表明,向量宽度每扩大 2 倍,执行矩阵乘法所需的标量控制工作量可以减少到原来的 1/4。
从 4 扩展到 128,相当于向量宽度连续扩大 5 次,因此,从 4×4 脉动阵列扩大到 128×128 脉动阵列后,标量计算方面的理论收益为:
4^5=4×4×4×4×4=1024 倍
当然,AI 芯片中的标量计算不仅用于矩阵乘法,因此这并不能代表整个芯片的全部收益,但它仍然是一个非常重要的因素。按照这一分析,TPU 为了驱动脉动阵列完成相同规模的矩阵乘法,只需要承担 Volta 约 1/1024 的标量控制工作量。
实际上,作者认为这一差距甚至更大,因为 TPU 的向量寄存器规模为 8×128,而不仅仅是 128,因此对应的比例可以达到:
8×1024=8192 倍
标量计算并不是 AI 芯片中的主要成本来源,但也绝非可以完全忽略,而 1024 倍这样的数量级差异显然具有重要影响。
向量计算
前面的分析还表明,向量宽度每扩大 2 倍,脉动阵列之外所需的向量计算工作量大约可以减少到原来的 1/2。从 4 扩大到 128 同样经历了 5 次翻倍,因此对应的理论收益为:
2^5=2×2×2×2×2=32 倍
这一差异同样十分显著。
当然,也可以认为脉动阵列内部执行的计算本身就是一种向量计算,因此严格来说,并不是消除了这么多向量计算,而只是将一部分向量计算从脉动阵列外部转移到了阵列内部。这个说法在技术上是成立的。
但关键在于,脉动阵列执行这些工作时的效率远高于通用向量处理器,包括读取输入数据和保存计算结果所需的数据搬运。因此,这种设计本质上是将计算从效率较低的执行位置转移到了效率高得多的脉动阵列内部。最终实际收益不会达到完整的 32 倍,但仍然十分显著。
如果让一位优秀的硬件工程师进一步解释这一问题,他可能会从寄存器文件、pJ 级能耗、芯片内部数据搬运效率等角度进行详细分析,甚至还会讨论各种替代架构。但无论具体分析过程如何,最终结论基本一致:规模更大的脉动阵列通常具有明显更高的整体效率。
由此也可以开始理解,为什么当时 Google 一个规模并不大的 TPU 团队能够与 Nvidia 这样强大的 GPU 厂商保持竞争。当然,其中还有其他原因,但作者认为,脉动阵列规模是其中一个非常重要的因素。
如今 Nvidia GPU 中的脉动阵列已经变得更大,但其规模仍然没有达到 Google TPU 中脉动阵列的水平。
由此自然会产生下一个问题:既然更大的脉动阵列效率更高,为什么不直接采用更大的阵列,例如 1024×1024?理论上这样不是应该更加高效吗?
这正是下一节将要讨论的问题。