ARTICLE · 979786
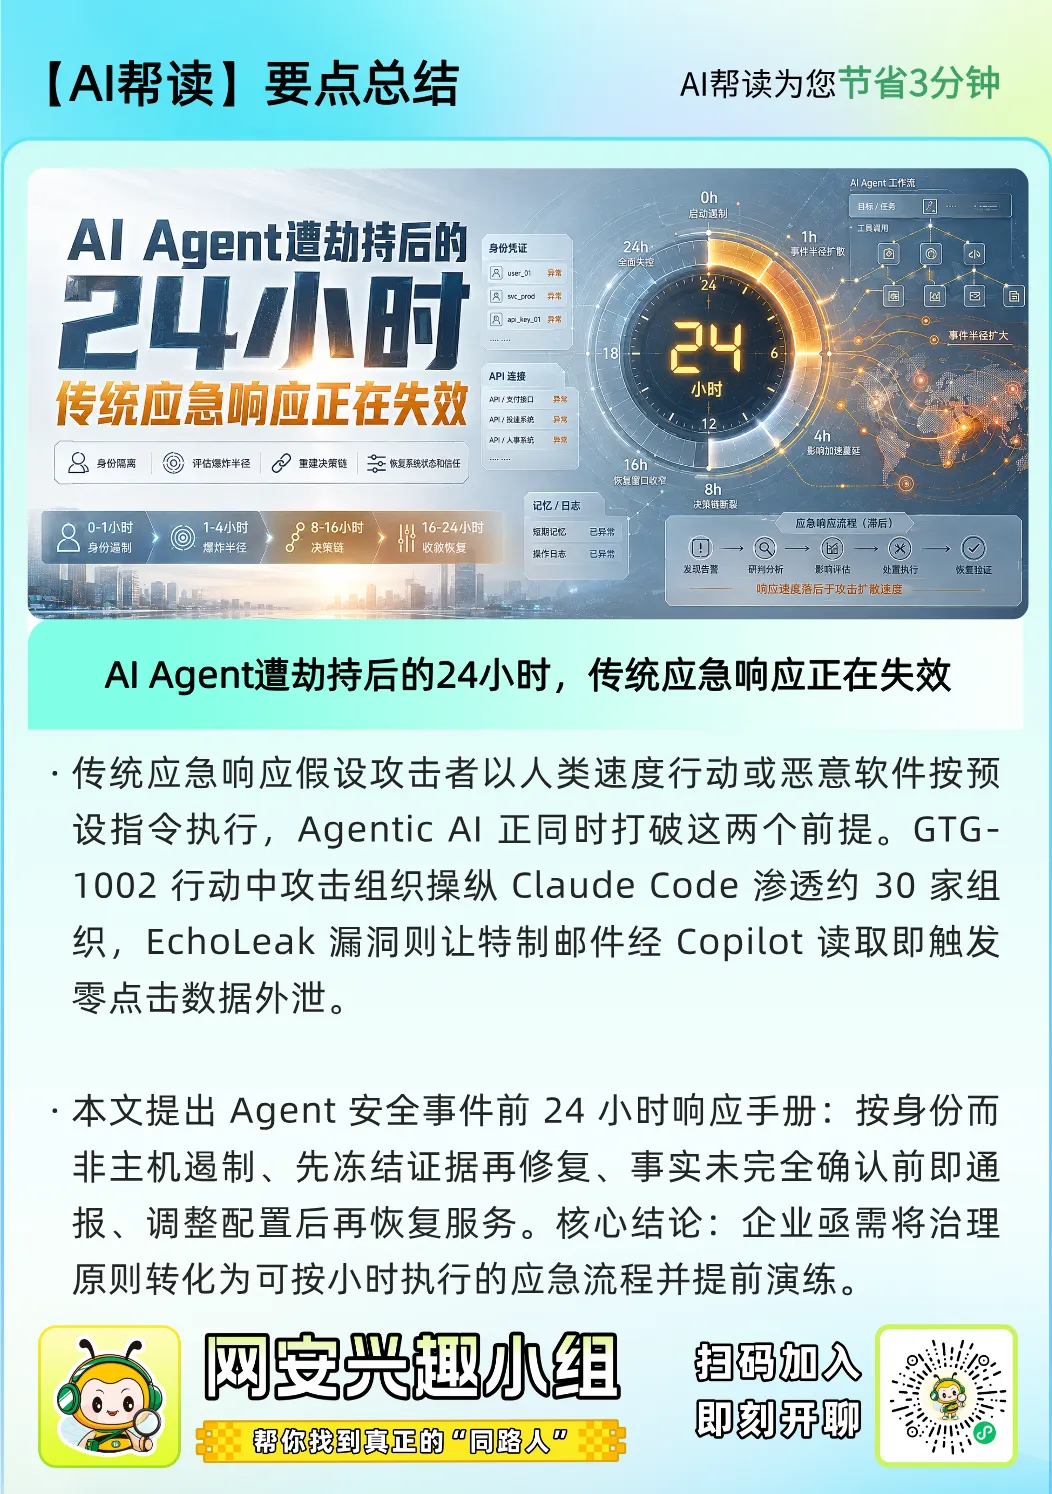
AI Agent遭劫持后的24小时,传统应急响应正在失效
关于AI Agent安全的讨论,长期以来大多围绕风险分类、治理原则和“负责任使用AI”展开。这些内容适合用于制度建设和管理汇报,但真正进入安全事件处置阶段时,往往缺少足够具体的操作指导。
尤其是在凌晨两点,当一个持有有效凭证的自主Agent刚刚执行了未经授权的操作,安全团队真正需要的并不是一套新的治理框架,而是一份能够回答“接下来几个小时该做什么”的应急响应手册。
因此,相比继续讨论抽象原则,更重要的问题是:当一个AI Agent被劫持、被操纵,或者只是超出了既定边界之后,事件发生后的前24小时应该如何处理。
Part01
为什么Agent事件的
响应节奏完全不同
传统应急响应通常建立在两个基本假设之上:要么攻击者是以人类速度行动的操作者,要么恶意软件按照一套预先设定好的指令执行。
Agentic AI正在同时打破这两个前提。
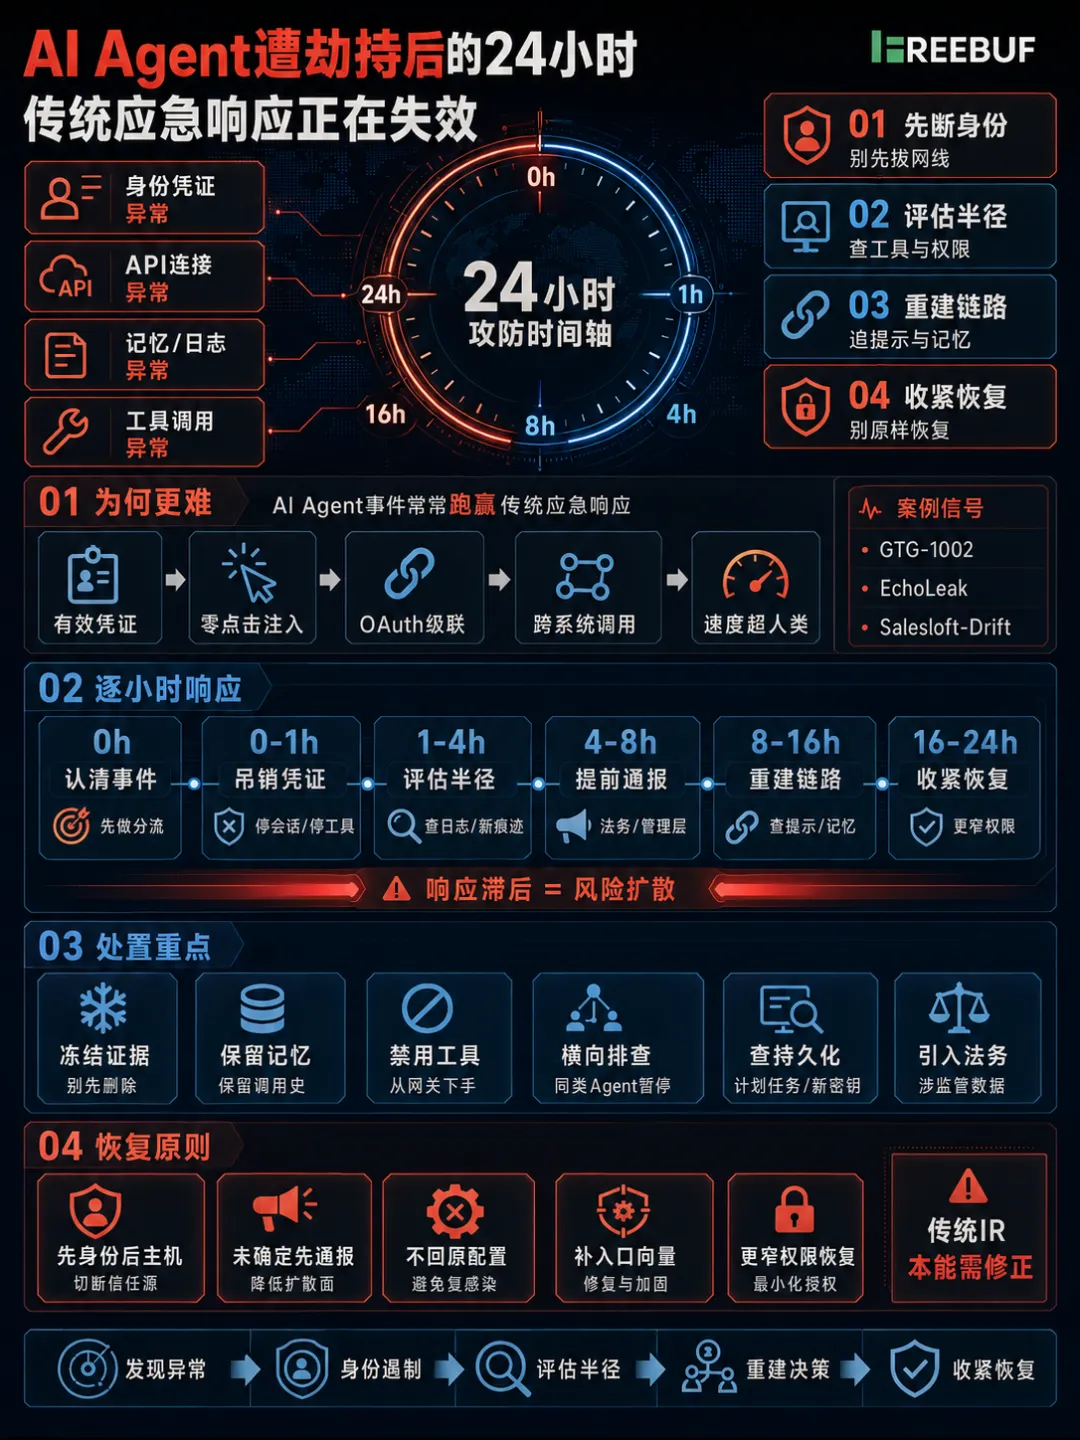
Anthropic关于GTG-1002行动的报告就是一个典型案例。一个具有中国国家背景的攻击组织操纵Claude Code,对大约30家组织实施渗透。据报道,大部分战术性操作都由AI在极少人工参与的情况下完成。
这类事件真正需要关注的并不仅是攻击归因,而是攻击节奏。
传统钓鱼邮件可能进入收件箱数小时甚至一天后,才等到用户点击;但由Agent参与的攻击可以在安全团队还没有完成集结时,就已经自主执行多个步骤,并快速扩大攻击范围。
几个月前,Aim Security披露的EchoLeak漏洞也说明了这一变化。
EchoLeak是Microsoft 365 Copilot中的一个零点击提示注入漏洞,CVSS评分达到9.3。一封经过特殊构造的电子邮件,只要在正常内容摘要过程中被Copilot读取,就可能触发OneDrive、SharePoint和Teams中的数据外泄,整个过程无需用户进行任何操作。
这里没有需要点击的恶意链接,也没有等待沙箱分析的附件。真正触发风险的,只是一段Agent本来就会主动读取的内容。
这类攻击正是OWASP LLM Top 10中重点关注的风险之一。
Agent带来的另一个问题,是攻击影响范围可能迅速跨越多个系统。
Obsidian Security对Salesloft-Drift OAuth入侵事件的分析显示,一个遭到攻陷的互联应用,就可能进一步影响数百个下游SaaS环境。随着Agent开始持有OAuth令牌、API密钥,并代表用户在多个系统之间连续调用工具,这种级联风险只会更加突出。
这些案例背后存在一个共同特征:攻击者不一定是坐在键盘前操作的人。真正触发异常行为的,可能是一段藏在文档中的指令、一个被污染的工具返回结果,甚至是一段遭到篡改的持久化记忆。这也直接改变了事件遏制方式。
在传统入侵事件中,隔离主机往往是第一反应;但在Agent场景中,如果攻击已经通过API和身份凭证跨越多个系统,仅仅断开某台主机的网络并不能真正阻止攻击继续发生。
因此,Agent事件的第一响应重点需要从“主机”转向“身份、会话和工具权限”。
Part02
逐小时响应手册
第0小时:先确认眼前发生了什么
整个响应流程从检测开始,而检测往往也是Agent事件最容易浪费时间的环节。这类事件未必会触发传统SOC已经调优好的告警规则。
更有价值的异常信号,可能包括:某个Agent身份的工具调用量突然明显偏离历史水平;Agent开始执行超出原始任务范围的操作,例如原本只负责邮件摘要的Agent突然访问文件共享;或者模型输出中出现了从未由任何人工操作者提供过的指令。
这一阶段的重点并不是立即解释所有细节,而是先完成事件分流。
安全团队需要尽快判断,当前面对的究竟是单个会话被操纵、共享凭证被滥用,还是一个更系统性的提示注入问题。例如,一段被污染的内容是否已经被放进某份文档中,而任何读取该文档的Agent都有可能受到影响。
第0-1小时:按身份遏制,而不是按主机遏制
这是传统应急响应思路在Agent事件中最容易出现偏差的地方。如果Agent已经通过API调用跨越三个甚至更多系统,简单拔掉一台主机的网线很难阻止后续操作。
更有效的方式,是把Agent当作一个已经被攻陷的服务账号来处理。
首先暂停或吊销其凭证、API密钥和OAuth令牌。如果编排平台支持会话控制,应立即终止仍在运行的活动会话。与此同时,Agent的记忆存储、工具调用历史和相关运行记录应当被冻结保存,而不是直接删除,因为这些内容会成为后续调查中最重要的证据来源。
如果Agent通过统一代理、网关或工具编排层运行,也应优先在这一层禁用其工具访问,而不是逐个进入下游系统进行封堵。
这种做法的核心逻辑是:先切断Agent继续行动的能力,再处理被它触达的具体主机和系统。
第1-4小时:评估爆炸半径
完成初步遏制之后,下一步需要回答的是:这个Agent到底接触过哪些资源。此时应拉取尽可能完整的工具调用日志,包括每一次API请求、传入参数和返回结果,并与Agent原本拥有的权限进行比对。
这里需要同时区分两个范围:它理论上可以访问什么,以及它实际上访问了什么。两者往往并不相同。
除此之外,还需要检查Agent在运行过程中是否创建了新的持久化痕迹。例如:计划任务;邮件转发规则;新的API密钥;新的OAuth授权;新的服务账号或访问令牌。
自主Agent不仅能够使用已有权限,也可能在执行过程中产生新的访问路径,因此不能只检查最初暴露的凭证。
如果事件入口疑似来自间接提示注入,还需要继续寻找是否存在其他读取过同一污染内容的Agent或会话。
这类事件往往不会只影响单一实例。一份恶意文档、一个被污染的知识库条目或一个异常工具返回结果,都可能同时影响多个Agent。
第4-8小时:在完全确定之前就通报
AI安全事件的一个常见误区,是等所有事实确认之后再向法务、隐私团队和管理层汇报。但在快速扩大的Agent事件中,这种做法可能导致后续披露和合规处置更加被动。
首次通报不需要回答所有问题,但至少应该明确三个层面:Agent可能访问哪些资源;现有证据显示它实际访问了哪些资源;哪些关键事实仍然无法确认。
如果事件涉及受监管数据,法务和隐私团队应尽早介入。此外,还需要评估同一基础配置、相同工具集成或相同Agent模板是否被复制到了其他系统中。
Agent平台通常具有高度复用性。一个有问题的配置模式,可能已经在多个Agent中重复部署,而安全团队尚未意识到。因此,在必要情况下,暂停同类Agent运行本身也应作为预防性措施考虑。
第8-16小时:重建决策链
到了这一阶段,Agent事件与传统入侵调查之间的差异会变得更加明显。
传统取证重点是还原主机、文件和进程发生了什么。
Agent事件则还需要进一步回答:模型为什么会决定这样做。
调查需要逐步还原完整的提示、响应和工具调用链,包括Agent在异常操作之前读取过的内容、调用过的工具和接收过的返回结果。目标是找到真正导致行为偏转的那条指令。
这条指令可能直接出现在用户输入中,也可能隐藏在:电子邮件;PDF;知识库;网页;工具返回结果;持久化记忆;其他Agent发送的信息中。还需要判断Agent自身是否意识到了异常。
如果模型的推理过程显示,它已经判断某条指令可能存在问题,却仍然继续执行,那么问题更可能出现在护栏和权限控制上。如果模型完全没有识别出风险,则更接近检测能力不足。
这两类问题对应的修复方式并不相同。前者需要强化执行限制,后者则需要提升异常输入和行为识别能力。
第16-24小时:决定恢复方案,并且先做出改变
完成初步调查后,最不应该做的,是把Agent直接恢复到事件发生前的原始配置。
如果攻击向量、权限范围和工具访问能力全部保持不变,那么恢复服务实际上只是重新制造一次相同的攻击条件。恢复前至少需要完成针对性调整。
如果问题来自提示注入,就要修复或净化对应的数据摄入路径;如果Agent工具权限过大,就要缩小工具范围;如果某类操作能够直接造成高影响结果,就应增加人工审批或二次确认机制;如果凭证已经暴露,则重新签发的凭证应当使用比此前更严格的最小权限配置,而不是简单恢复原有权限。
与此同时,还应在事件时间线仍然清晰时完成一份24小时事件摘要。这份摘要通常会成为后续复盘、监管沟通以及客户通知的重要基础材料。
Part03
Agent事件真正需要的是
可执行的响应顺序
最小权限、人工监督、工具控制和完整审计,都是Agent安全中已经被反复强调的原则。但真正进入事件响应阶段后,只有原则并不够。
安全团队需要的是一套能够立即执行的顺序:
优先按身份遏制,而不是先隔离主机;
先冻结证据,再开始修复;
在所有事实确认之前就完成首次通报;
恢复服务时,不再使用刚刚失败过的原始配置。
EchoLeak、GTG-1002以及其他Agent安全事件都说明,真正决定事件处置质量的,并不是企业是否拥有一份完整的AI风险分类表,而是相关团队是否提前演练过Agent事件发生后的前24小时。
这也是当前Agent安全治理中仍然相对薄弱的一环。
过去两年,行业投入了大量精力制定Agent治理框架和安全原则。但随着Agent能够自主调用工具、持有凭证并跨系统执行任务,如何把这些原则真正转化为可以按分钟和小时执行的应急流程,正在变得更加重要。
下一次Agent安全事件发生时,攻击链不会等待制度完善之后才开始运行。
因此,相比继续增加一套新的治理框架,企业更需要提前完成桌面推演:
谁有权限暂停Agent?
谁能吊销它的OAuth令牌?
工具调用日志保存在哪里?
如何一次性禁用Agent的下游工具?
哪些同类Agent需要同步暂停?
什么情况下必须通知法务和管理层?
这些问题如果要等到事件发生后再寻找答案,往往已经太晚。
Agent扩大攻击规模的速度可能快于人类响应速度,传统应急响应流程也因此显得越来越迟缓。真正需要改变的,不只是检测技术,而是整个事件响应的节奏和顺序。
参考来源:
The first 24 hours of an AI agent security incident
https://www.csoonline.com/article/4214961/the-first-24-hours-of-an-ai-agent-security-incident.html
推荐阅读
电报讨论