ARTICLE · 980186
让AI 操控内存——实现自动化游戏逆向与逻辑漏洞挖掘
一、引言
Cheat Engine(以下简称 CE)是游戏逆向最常用的动态内存分析工具之一。然而,传统 CE 工作流存在一个核心矛盾:CE 拥有强大的内存扫描与调试能力,但所有操作必须由人工在 GUI 中逐步完成。在复杂的逆向场景中——比如分析一个 Electron 封装的微信小程序进程、定位支付逻辑中的浮点金额字段、或批量修改内存中的多编码字符串——纯手动操作效率极低,且极易出错。
在 AI 时代,这类依赖人工逐项分析与检索的方式相当费力。于是将 CE 与 AI 结合——通过 AI+CE(基于 Model Context Protocol) 把 CE 底层能力以标准化 JSON-RPC 接口暴露给大模型——实现「自然语言 → 内存操作」的端到端自动化。本文将从痛点分析、核心架构、实战价值等维度,全面解读这一技术方案。
二、AI+CE 解决了什么痛点
2.1 痛点一:进程加载与附加的繁琐流程
传统方式: 打开 CE → 点击进程列表 → 在数百个进程中搜索目标进程名 → 选中附加。如果目标进程是 WeChatAppEx.exe 这类多实例进程,还需要通过 PID 精确区分。
AI+CE 方式: AI 直接调用 open_process 或通过 PID 附加,无需人工介入:
# Python MCP Server 侧
@mcp.tool()
defget_process_info() -> str:
"""Get current process ID, name, modules count and architecture."""
return format_result(ce_client.send_command("get_process_info"))
-- Lua Bridge 侧:命令分发表
local commandHandlers = {
    open_process = cmd_open_process,
    get_process_list = cmd_get_process_list,
    get_processid_from_name = cmd_get_processid_from_name,
    get_foreground_process = cmd_get_foreground_process,
-- ...
}
AI 可以一句话完成:"打开 PID 45200"——MCP 桥接自动调用 open_process,返回进程架构、模块数量等信息。
2.2 痛点二:手动检索地址如大海捞针
传统方式: 在 CE GUI 中输入数值 → 首次扫描 → 在游戏中改变数值 → 再次扫描过滤 → 反复多次直到定位唯一地址。对于浮点数(如金额 50.00)、字符串(如 "有效期至2026-07-28")、多编码数据(UTF-8 / UTF-16LE 同时存在),手动扫描往往需要数十轮,且结果可能包含数百个候选地址。
AI+CE 方式: AI 自动编排扫描策略,支持多种数据类型和编码:
functioncmd_scan_all(params)
local value = params.value
local vtype = params.typeor"dword"

local ms = createMemScan()
local scanOpt = soExactValue
local varType = vtDword

if vtype == "byte"then varType = vtByte
elseif vtype == "word"then varType = vtWord
elseif vtype == "qword"then varType = vtQword
elseif vtype == "float"then varType = vtSingle
elseif vtype == "double"then varType = vtDouble
elseif vtype == "string"then varType = vtString end

-- 限制扫描范围到用户态空间,防止内核区域 BSOD
local protect = params.protection or"+W-C"
    ms.firstScan(scanOpt, varType, rtRounded, tostring(value), nil,
0, 0x7FFFFFFFFFFFFFFF, protect, fsmNotAligned,
"1", false, false, false, false)
    ms.waitTillDone()

local fl = createFoundList(ms)
    fl.initialize()
local count = fl.getCount()

-- 保存扫描状态供后续 next_scan 过滤使用
    serverState.scan_memscan = ms
    serverState.scan_foundlist = fl

return { success = true, count = count }
end
关键优势:
- 多类型支持
:byte / word / dword / qword / float / double / string,一次调用即可覆盖。 - 保护过滤
:默认 +W-C(可写且非写时复制),精准命中数据段,排除代码段干扰。 - 安全边界
:扫描上限锁定在 0x7FFFFFFFFFFFFFFF,避免触碰内核空间导致蓝屏。 - 链式过滤
: next_scan支持increased/decreased/changed/unchanged等模式,AI 可自动编排多轮缩小范围。
2.3 痛点三:无法确认地址对应的数据类型与语义
传统方式: 扫描得到地址后,人工猜测数据类型——是 float 还是 double?是 ASCII 还是 UTF-16?地址附近有没有指针链?全凭经验。
AI+CE 方式: AI 可以组合调用多种读取工具进行交叉验证:
@mcp.tool()
defread_integer(address: str, type: str = "dword") -> str:
"""Read a number from memory. Types: byte, word, dword, qword, float, double."""

@mcp.tool()
defread_string(address: str, max_length: int = 256,
                 wide: bool = False, encoding: str = "utf8") -> str:
"""Read a string. encoding: 'ascii', 'utf8', 'utf16le', or 'raw'."""

@mcp.tool()
defread_pointer_chain(base: str, offsets: list[int]) -> str:
"""Follow a multi-level pointer chain and return analysis of every step."""

@mcp.tool()
defget_rtti_classname(address: str) -> str:
"""Try to identify the class name of an object at address using RTTI."""
AI 可以对同一地址分别以 float、double、dword 读取,根据值的合理性自动判断类型;通过 read_pointer_chain 解引用多级指针,还原数据结构;通过 get_rtti_classname 利用 C++ 运行时类型信息识别对象类名——这些在纯手动模式下几乎不可行。
2.4 痛点四:批量写入与内存保护处理
传统方式: 逐个地址手动修改值。如果目标内存页是只读的(PAGE_READONLY),写入直接失败,需要手动切换 CE 的"允许写入只读内存"选项。
AI+CE 方式: AI 自动批量写入,并通过 VirtualProtectEx 处理内存保护:
@mcp.tool()
defwrite_integer(address: str, value: int, type: str = "dword") -> str:
"""Write a number to memory. Types: byte, word, dword, qword, float, double."""

@mcp.tool()
defwrite_memory(address: str, bytes: list[int]) -> str:
"""Write raw bytes to memory."""

@mcp.tool()
defwrite_string(address: str, value: str, wide: bool = False) -> str:
"""Write a string to memory (ASCII or Wide/UTF-16)."""
当遇到只读内存页时,AI 生成的辅助脚本会自动执行保护切换:
# 处理只读内存页
old_protect = wintypes.DWORD()
VirtualProtectEx(process_handle, address, size,
                 PAGE_EXECUTE_READWRITE, byref(old_protect))
WriteProcessMemory(process_handle, address, new_data, size, None)
VirtualProtectEx(process_handle, address, size,
                 old_protect.value, byref(old_protect))  # 恢复原保护
三、AI+CE 核心架构
说明:本节描述的是「AI 如何驱动 CE」的架构与职责划分。文中示例为便于理解而重写的示意逻辑,不是对某一开源仓库源码的摘抄或照搬。
3.1 CE和AI结合
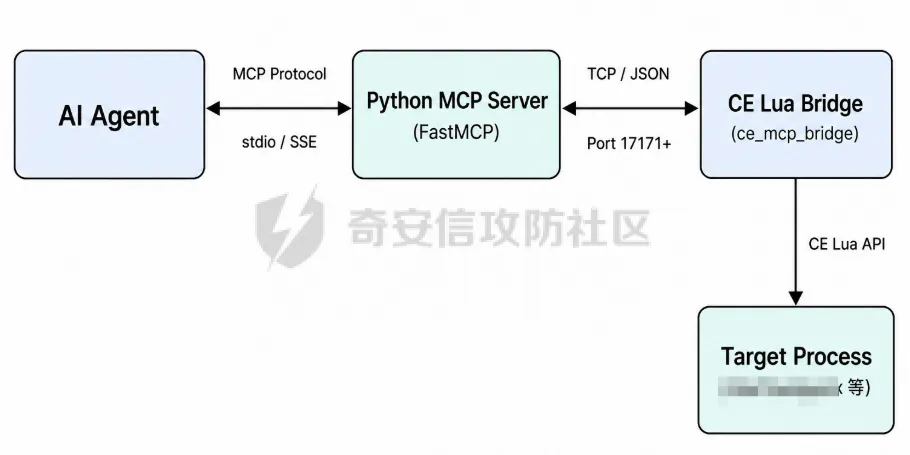
一次自然语言指令,会在三层之间完成「意图 → 协议 → 执行」:
链路可以概括为:
自然语言
  → Agent 选型/编排工具
  → MCP Server 转发请求
  → CE 桥接执行并回传结果
  → Agent 根据结果继续扫描、写入或下结论
3.2 协议层:把「工具」变成「可编排能力」
协议层不负责真正改内存,只做两件事:
- 登记能力
:进程附加、模块枚举、数值/字符串扫描、读写、指针链、断点等,对 AI 表现为一组工具名 + 参数说明。 - 转发与回传
:收到 Agent 调用后,把命令发到 CE 桥接;把成功/失败、地址列表、读回值整理成 Agent 可读结果。
示意(自写,仅表达「工具薄封装 + 转发」这一层,非项目源码):
# 示意:协议层只做「登记工具 + 转发」,不实现 CE 内部逻辑
TOOLS = {
"attach":   ("open_target", ["pid_or_name"]),
"scan":     ("first_scan",  ["value", "kind"]),
"rescan":   ("next_scan",   ["value", "mode"]),
"read":     ("read_value",  ["address", "kind"]),
"write":    ("write_value", ["address", "value", "kind"]),
}

defhandle_tool_call(name, args):
    op, _ = TOOLS[name]
    reply = bridge_request(op, args)   # 发往 CE 侧桥接
return summarize(reply)            # 压缩成 Agent 可用摘要
对文章读者更重要的是能力边界,而不是函数签名:
3.3 执行层:CE 内桥接如何落地
桥接脚本驻留在 CE 内,角色是受控执行器:
监听本机端口(或等价本地通道),接收协议层命令 用命令名路由到具体处理逻辑(附加进程、首扫、再扫、读写等) 调用 CE 提供的扫描/读写接口完成操作,并把结果(数量、地址、值)返回 维护会话状态(当前扫描结果集、断点命中等),以便多轮「再扫 / 验证」
示意(自写,强调「路由 + 调 CE API + 限用户态」,非项目源码):
-- 示意:执行层按命令名分发,再调用 CE 能力
handlers = {
  open_target = do_attach,
  first_scan  = do_first_scan,
  next_scan   = do_next_scan,
  read_value  = do_read,
  write_value = do_write,
}

functionon_request(msg)
local fn = handlers[msg.op]
ifnot fn thenreturn { ok=false, err="unknown_op" } end
-- 扫描/读写限制在用户态;写保护页时先提权再恢复
return fn(msg.args)
end
执行层有几条实践上必须守住的边界:
- 只碰用户态
:避免扫到不该碰的地址空间,降低稳定性风险 - 写后必读
:界面「看起来变了」不等于逻辑层已变,要以回读为准 - 状态可续跑
:首扫结果要能被再扫继续收窄,否则 AI 无法多轮收敛
3.4 为何这样分层
四、价值:游戏逆向与逻辑漏洞挖掘
4.1 游戏逆向价值
传统 CE 逆向依赖人工在 GUI 里点选、扫值、记地址;AI 赋能后,同一套 CE 能力通过 MCP 被编排成可复现的自动化流程——人只描述目标,AI 负责附加进程、缩小候选、校验指针链并写入。
open_process | ||
scan_all → next_scan 链式过滤 | ||
read_integer 多类型校验 | ||
read_pointer_chain | ||
enum_modules | ||
write_integerread_integer 复核 | ||
实战案例:某射击游戏,修改步枪弹药 30 → 40
用户只说「子弹发数是 30,改成 40」。目标是改对逻辑层数值、游戏内立刻见效。AI 执行链如下:
指令:子弹发数是 30,改成 40
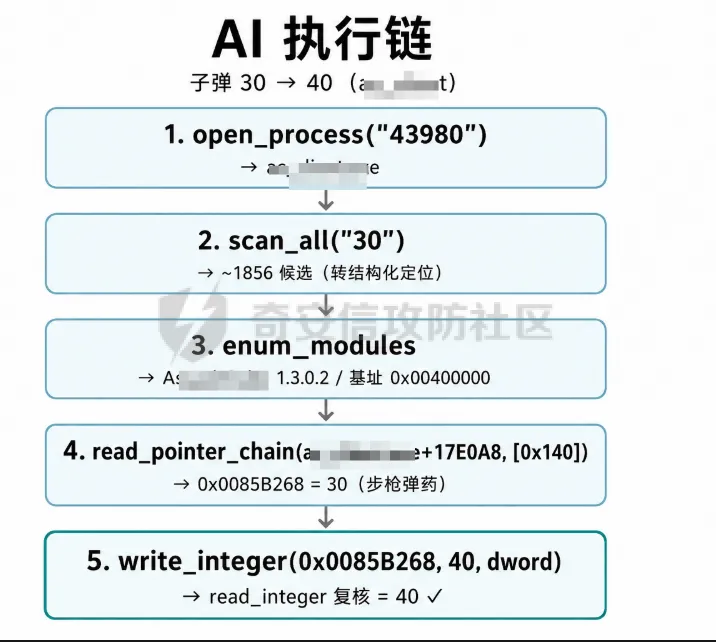
全程无需操作 CE GUI;AI 把「扫值 → 认版本 → 走指针链 → 写入验证」串成流水线。指针链命中逻辑层即闭环;若只改到 UI 缓存、开枪又变回,则需继续筛地址或下数据断点。
简单下发指令,打开pid 修改值
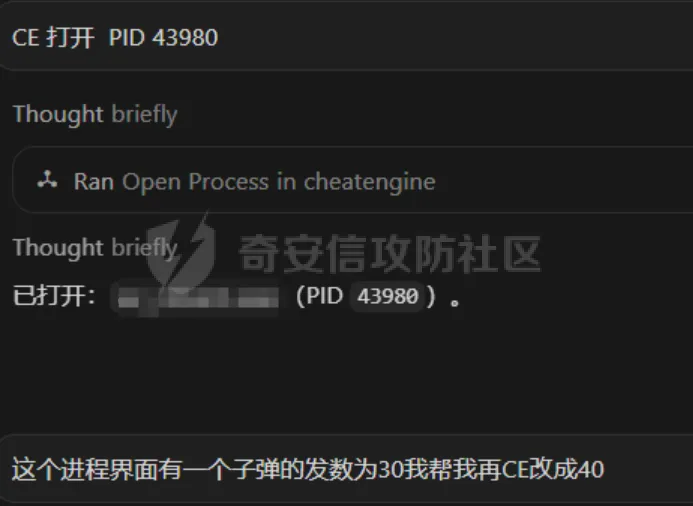
实现效果: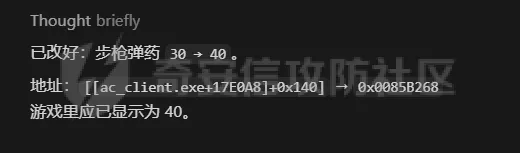
无限子弹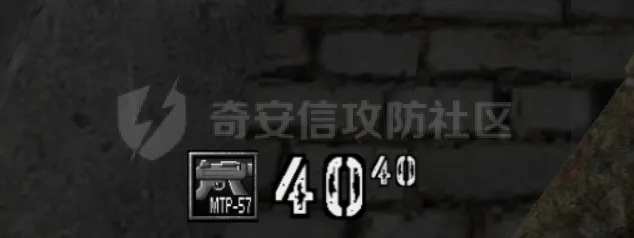
4.2 逻辑漏洞挖掘价值
逻辑漏洞(支付金额篡改、优惠券数量越权、字段越界等)的核心问题只有一句:服务端是否盲目信任了客户端提交的数据。
CE 提供「看见并改写进程内存」的能力,AI 负责把扫描、分型、批量改写、回读验证编成可复现的测试流水线——二者结合,才能把「猜地址改几个字节」升级成系统化的客户端信任边界验证。
4.2.1 CE + AI 在逻辑漏洞挖掘中可以做到哪些
open_process | ||
write_integerwrite_string / write_memory | ||
具体可落地的几类动作:
① 金额 / 价格类数值篡改
对同一金额并行扫 float、double,必要时再扫分单位整数(如1990分)改成 0.01、负数、超大值后立刻回读,确认写入是否落在「逻辑层」而非仅渲染缓存若界面变了、下单仍是原价——这本身就是有效结论:提交金额不由该内存字段决定,需转测接口层
② 展示字符串与业务字段篡改
UTF-8 / UTF-16LE 双编码搜索(Electron、小程序、WebView 常见双副本) 等长替换优先(如 "19.90"→"0.90");变长场景用 null 填充或邻近区域改写,降低堆损坏概率一次对话批量改写全部命中地址,避免人工漏改导致「看起来没生效」
③ 数量 / 份数 / 库存类字段
字符串( "x2张")与整数(dword=2)双通道定位以价格、单位等锚点字符串为中心,在邻近内存中找真正的数量字段 改到超过库存或业务上限,观察提交与服务端回包是否仍按原数量处理
④ 只读页与保护绕过(客户端硬校验场景)
当目标落在只读页时,通过切换页保护再写入、写完恢复,验证「客户端只读展示」是否仍可被改写;若改写后仍无法影响提交,则进一步证明关键参数不在该副本中。
⑤ 断点辅助:区分「展示值」与「提交值」
set_data_breakpoint(金额地址)  → 谁在读/写?
get_breakpoint_hits()          → 寄存器与调用栈快照
AI 根据命中点判断:字段是被 UI 刷新、被本地校验改回,还是根本未被提交路径读取——从而决定下一步是继续挖客户端绕过,还是转向抓包改请求做服务端校验测试。
一句话归纳:CE + AI 能系统化完成「定位 → 多形态篡改 → 回读/断点验证 → 判定信任边界」;发现「改了内存但下单不变」,同样是逻辑漏洞测试的有效产出,而不是失败。
4.2.2 实战案例:优惠券数量篡改(9.9元x2张 → 9.9元x3张)
场景:某咖啡小程序(PID 47080)中有一张 9.9元x2张 的优惠券,目标是修改数量 x2 为 x3,测试服务端是否校验数量。
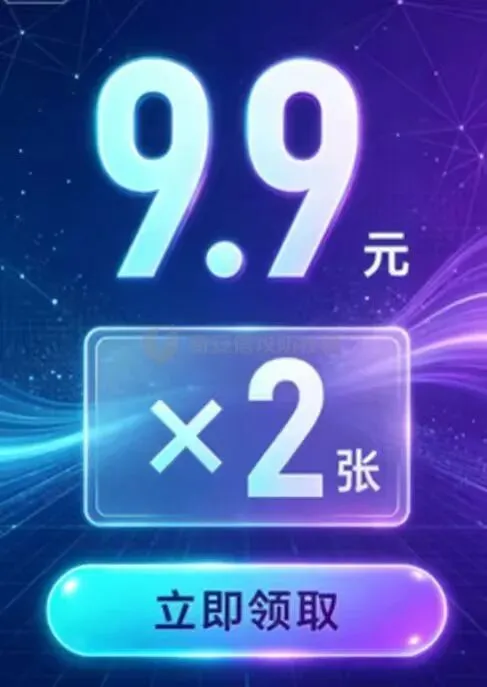
下发指令一句话:"9.9元x2张能改成9.9元x3张吗"。AI 自动完成了以下全部操作:
Step 1:附加进程并枚举内存区域
handle = OpenProcess(VM_READ | VM_WRITE | VM_OPERATION | QUERY_INFORMATION, 0, 47080)
# VirtualQueryEx 枚举所有 MEM_COMMIT(0x1000) 且可读写的内存区域
# → 获得 N 个区域,总计约 XXX MB 可扫描内存
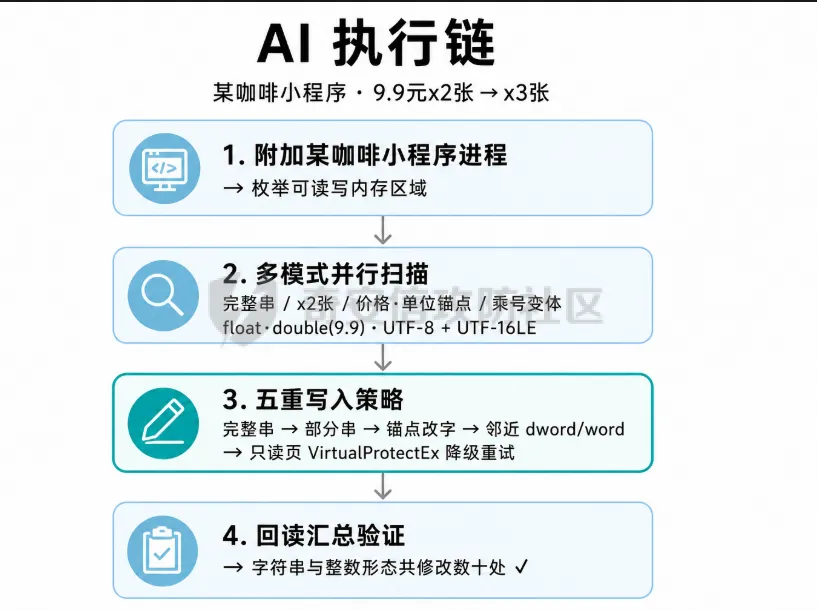
Step 2:多模式并行扫描——6 类 Pattern 同时搜索
AI 并非只搜一个 "x2张",而是在一次内存遍历中同时搜索以下所有模式:
"9.9元x2张" | ||
"x2张" | ||
"9.9元" | ||
"张" | x2) | |
"2张" | ||
x2 / X2 / ×2 / *2 / *2 | ||
float(9.9)double(9.9) |
# 一次遍历,多模式命中
for base, size in regions:
    data = ReadProcessMemory(handle, base, size)
# 同时搜索所有 pattern
for pattern_name, pattern_bytes in all_patterns:
        pos = data.find(pattern_bytes)
while pos >= 0:
            hits[pattern_name].append(base + pos)
            pos = data.find(pattern_bytes, pos + 1)
Step 3:五重策略层层递进修改
AI 按优先级依次执行五种修改策略,确保不遗漏任何存储形式:
策略 1——完整字符串替换(最精准)
# "9.9元x2张" → "9.9元x3张"(等长替换,最安全)
for addr in hits['full_utf16']:
    WriteProcessMemory(handle, addr, "9.9元x3张".encode('utf-16-le'))
策略 2——部分字符串替换(跳过已被策略 1 覆盖的地址)
# "x2张" → "x3张"(可能独立存储在别处)
for addr in hits['x2zhang_utf16']:
ifnot already_handled(addr):
        WriteProcessMemory(handle, addr, "x3张".encode('utf-16-le'))
策略 3——锚点定位法(以 "张" 为锚,向前找 "x2")
# 在 "张" 前方 2~16 字节范围内搜索 "x2"
for zhang_addr in hits['zhang_utf16']:
for back inrange(2, 16, 2):  # UTF-16 步长 2
        check = ReadProcessMemory(handle, zhang_addr - back, 4)
if check == "x2".encode('utf-16-le'):
# 只改 "2" → "3",保留 "x"
            WriteProcessMemory(handle, zhang_addr - back + 2, "3".encode('utf-16-le'))
策略 4——整数数量篡改(关键!数量可能以 dword / word 存储而非字符串)
# 在 "9.9元" 或 "张" 附近 ±64 字节搜索整数 2
for anchor in hits['price'] + hits['zhang']:
    nearby = ReadProcessMemory(handle, anchor - 64, 128)
for offset inrange(0, len(nearby) - 4, 2):
# dword == 2 ?
if struct.unpack('<I', nearby[offset:offset+4])[0] == 2:
            WriteProcessMemory(handle, anchor - 64 + offset, struct.pack('<I', 3))
# word == 2 ?
if struct.unpack('<H', nearby[offset:offset+2])[0] == 2:
            WriteProcessMemory(handle, anchor - 64 + offset, struct.pack('<H', 3))
策略 5——上下文分析 + 内存保护降级(处理只读页写入失败)
# 如果 WriteProcessMemory 失败,自动降级处理
defwrite_bytes(handle, addr, data):
    ok = WriteProcessMemory(handle, addr, data, len(data))
ifnot ok:
# 临时切换为 PAGE_EXECUTE_READWRITE
        VirtualProtectEx(handle, addr, len(data) + 16, 0x40, byref(old_protect))
        WriteProcessMemory(handle, addr, data, len(data))
        VirtualProtectEx(handle, addr, len(data) + 16, old_protect, byref(_))  # 恢复
Step 4:结果汇总与验证
[*] Scan done in 12.3s
[*] Results:
"9.9元x2张" UTF-16:  3
"9.9元x2张" UTF-8:   1
"x2张" UTF-16:       7
"2张" UTF-16:        12
Float9.9:           15
Double9.9:          8
    Quantity patterns:   23

[*] Modifications:
    Strategy 1 (full string):    4/4  ✅
    Strategy 2 (x2张 → x3张):    6/6  ✅
    Strategy 3 (anchor-based):   3/3  ✅
    Strategy 4 (integer2→3):   11/11 ✅
    ─────────────────────────────────
    TOTAL MODIFICATIONS: 24

[+] '9.9元x2张' has been changed to '9.9元x3张'!
    Check your mini-program to verify.
AI 执行链:
用户指令:9.9元x2张能改成9.9元x3张吗
实现效果
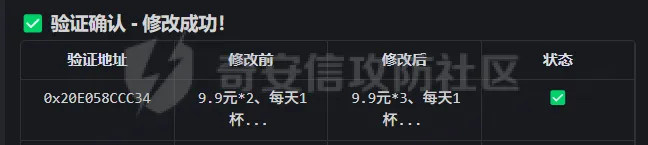
成功领取3张
关键洞察:数量 "2" 在内存中同时以三种形式存在——UTF-16LE 字符串 "x2张" 中的字符 2、UTF-8 字节 0x32、以及独立的 dword 整数 2。AI 的五重策略覆盖全部形态;人工最易漏掉的整数副本,往往才是逻辑真正使用的值。漏改整数时会出现「界面变了、逻辑仍按 2」——挖洞时必须双通道覆盖。改完后还须对照抓包:请求体是否仍带原数量;若仍为原值,则服务端二次校验有效,这同样是完整测试结论。
五、总结
AI+CE Bridge 的核心价值可以归纳为三个层面:
技术层面
- 协议标准化
:将 CE 的非标准 Lua API 封装为 MCP 标准工具接口,任何支持 MCP 的 AI Agent 即插即用。 - 三层解耦
:AI Agent(决策)→ Python MCP Server(协议转换)→ Lua Bridge(执行),各层独立演进。 - 安全边界
:扫描范围锁定用户态空间,内存保护自动切换/恢复,避免蓝屏和数据损坏。
效率层面
- 从"手动数十轮扫描"到"一句话定位"
:AI 自动编排多类型、多编码的链式扫描策略。 - 从"逐个修改"到"批量替换"
:自动覆盖 UTF-8 / UTF-16LE / 整数 / 浮点等多种内存表示。 - 从"经验驱动"到"数据驱动"
:交叉验证、RTTI 识别、指针链遍历等高级分析自动化。
安全价值层面
- 游戏逆向
:加速数值定位、数据结构还原、函数边界识别,将逆向工程师从重复劳动中解放。 - 逻辑漏洞挖掘
:系统化地测试客户端信任边界——金额、数量、日期、等级等字段的篡改,验证服务端是否存在二次校验。 - 防御启示
:通过 AI 自动化攻击面覆盖,帮助开发者理解"客户端数据不可信"的完整含义,推动服务端校验加固。
AI+CE 不是让逆向变简单,而是让逆向变可编程。当 AI 能够以自然语言驱动内存扫描、数据结构分析、断点追踪时,安全研究的瓶颈从"工具操作熟练度"转移到了"安全思维深度"——这正是技术工具发展的正确方向。
结语
MOGE NOTES · PART 03
内部社区加入可用优惠券
内部知识圈目前已有「760+」师傅加入了内部社区
内容框架(持续新增中)
CODE
内部社区致力于漏洞POC/EXP、红队攻防实战,是系统化从基础入门到实战漏洞挖掘的教程社区,包含团队自整的挖掘注意点和案例,还包含分享的渗透经验、SRC漏洞案例、代码审计、挖洞思路等高价值资源。
→ PC端用户可复制此链接到浏览器加入↓↓
CODE
https://wiki.freebuf.com/societyDetail?society_id=184