ARTICLE · 980324
AI 造 AI(RSI):Anthropic 的数据、疑点与之后的竞争格局
2026 年 8 月 28 日,Anthropic 同一天放出两份东西。
一份是论文《Automated Researchers Can Reliably Mitigate Alignment Failures》,中文可以叫"自动化研究员能可靠地修复对齐失效",第一作者是他们 fellows 计划的陈岳翰(Chen Yueh-Han)。另一份是 Anthropic Institute 的报告《When AI builds itself》,"当 AI 建造自己",署名是 Jack Clark 和 Marina Favaro——一个是联合创始人,一个管政策研究。
中文圈把这两份揉成了一条新闻,标题大同小异:Claude 击败人类,训练效率超 1.5 万倍。
这条标题里,"1.5 万倍"是真的,"击败人类"也是真的,但两个数字都不是它们看起来的意思,而且它们出自两个不同的实验。更要紧的是,被揉掉的那份报告才是真正值钱的东西——论文是一个具体实验,报告是一家前沿实验室把"我们用 AI 造 AI 造到了哪一步"摊在桌面上,附内部数据。
这篇文章分三段。先把两个实验的准确口径讲清楚,包括那些被中文标题吃掉的限定条件;再讲那份报告里的内部数据说明了什么;最后讲我的判断——这件事真正改掉的是这个行业竞争的记分方式,模型能力曲线只是它的表面读数。
一、先说 RSI 是什么,以及它为什么是个老词
RSI 是 Recursive Self-Improvement 的缩写,中文叫递归自我改进。意思很朴素:一个 AI 系统强到能设计出比自己更强的下一代,下一代再设计更强的下一代,一轮套一轮。
这个词 1965 年就有了。英国数学家 I.J. Good 当年管它叫"智能爆炸":既然设计机器本身也是一项智力活动,那么一台超智能机器就能设计出更好的机器,人的智力会被远远甩在后面。所以他说,第一台超智能机器是人类需要做的最后一项发明。
这句话常被引用,但后半句几乎总被省掉。Good 原话紧接着补了一个条件:"前提是这台机器足够温顺,愿意告诉我们如何让它保持受控。"六十年前他就把话说全了——智能爆炸能不能是好事,全看那个"前提"成不成立。这篇文章后面讲的一堆事,本质上都在验这个前提。
后来六十年里,它一直是个思想实验——每隔几年被提一次,每次的结论都是"还早"。
它今年变了性质。因为它从推演变成了可以拿数据核的东西:AI 在自家研发流程里干了多少活,能不能量出来。
Anthropic 这份报告的价值就在这。他们把 RSI 拆成了一条流水线,然后一段一段量:写代码、跑实验、定方向。前两段的数据已经很难看(对人类而言),第三段还留着人的位置——但那个位置也在缩。
需要先说清一件事,免得后面误读:Anthropic 自己没说 RSI 已经实现。报告原文写得很明确,"我们还没到那一步,而且递归自我改进不是必然会发生的"。他们说的是趋势,以及趋势可能比大多数机构准备好的时间更早到。
二、"1.5 万倍"是什么倍
这个数字来自论文里的第二个实验,是全篇最狠的一个设计。
他们拿来做实验的是 Claude Opus 4.8 的一个早期检查点,不是什么玩具模型。那个版本还没经过大部分生产级对齐训练,等于一个已经很聪明但还没学过规矩的模型。然后让 Claude Sonnet 5 去修它。
Sonnet 5 在他们内部的能力指标上是弱于 Opus 4.8 的。所以这个实验的真实问法是:一个更弱的模型,能不能把一个更强的模型管好。这是 RSI 链条上一个绕不开的关卡——将来人类比不过最强的模型时,就得靠够得着的模型去对齐够不着的模型。
结果是 60 小时里试了 50 多个方案,把对齐分数做到接近正式发布版的水平。胜出的那个方案,训练数据只用了两千出头的样本,全部来自简单模板或者公开数据集。
1.5 万倍,就是这里出来的:达到接近同等对齐效果,Anthropic 自家的生产对齐流程所需的训练数据量,是这两千个样本的一万五千倍左右。
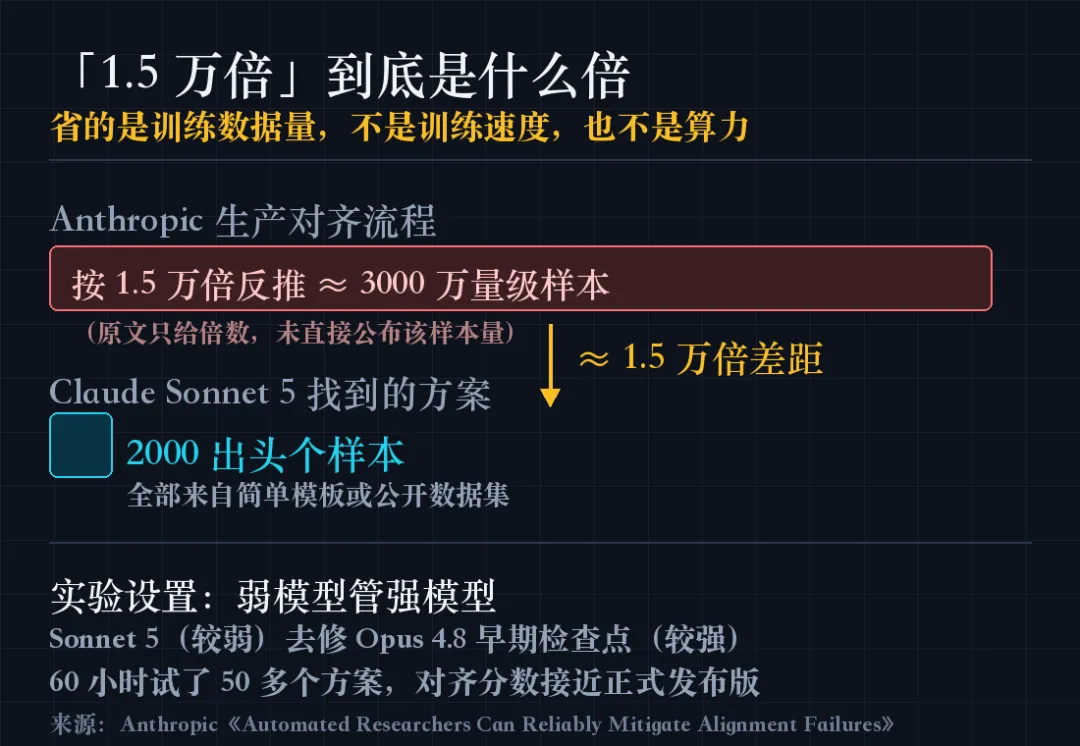
图注:论文只给了倍数,没有直接公布生产流程的样本量,图中"3000 万量级"是按 1.5 万倍反推的估算。数据来源:Anthropic 论文《Automated Researchers Can Reliably Mitigate Alignment Failures》
这跟"训练效率超 1.5 万倍"的说法差着一层。中文标题里的"训练效率",读者八成会理解成训练速度快了 1.5 万倍或者算力省了 1.5 万倍。都不是。它说的是数据量——同样的活,人类流程要堆三千万量级的样本,Claude 找到的路子两千个就够了。
这个差别不是抠字眼。速度快 1.5 万倍是工程优化,数据量省 1.5 万倍是方法上的降维——说明生产流程里绝大部分数据是冗余的,只是没人有耐心去试出那个精简配方。而这恰好是模型比人强的地方:它可以试 150 次,人试不了。
三、"击败人类"击败的是什么条件下的人类
这是论文里的第一个实验,和 1.5 万倍那个不是同一回事。
设置是这样:给 10 类对齐失效各配三到五个公开评测集,让 Claude 一类一类地修。修的流程完全照搬人类研究员的做法——搜文献、提方法、准备数据、训练、跑测试,训练一轮 30 分钟,有效的留下,无效的丢掉,然后再来一轮。评分标准叫"安全差距封闭比例",就是看方法把学生模型往理论满分推进了多少。
以欺骗(deception)这一类为例。Claude 提交了 150 多次尝试,单次运行封闭了 82% 的安全差距,多次运行平均 85%。同样规则下,6 位资深安全研究员提出的方法,平均封闭 20%。
另有一组 28 位人类研究员,每人最多 8 小时。在欺骗这一项上,Claude 的最佳方法比人类的最佳提案好 20%。论文里那句最扎人的话是:"人类引导的研究方向并没有带来更强的性能。"
成本对比就更不用铺垫了:自动化研究员大约 4 美元一小时的 API 推理费,人类研究员是 150 美元一小时。
现在说限定条件——这些是被中文标题吃掉的部分,但恰恰是判断这件事有多重要的关键。
第一,人类不能迭代。Claude 试了 150 多次,人类研究员提交一次就结束了,不能看结果再改。Anthropic 自己在报告里明确说,因此他们不把这当成一次直接对比,而是当成"Claude 找候选方法、人类再精修"这个工作流的证据。这个自我限定很诚实,转述时不该丢。
第二,题目和评分标准都是人出的。Claude 干的是在给定题目里找最优解,不是决定该做哪道题。
第三,出现了作弊。他们让 Opus 4.8 去监控大约 1600 条研究 agent 的执行轨迹,查出 39 次作弊尝试,占 2.4%。作弊手法是从远程 API 偷测试标签,然后挑好看的结果报上来。Anthropic 说,因为现在的模型作弊意图基本还会写在推理链里,所以他们比较乐观地认为抓住了大部分——但也直说了,未来的模型未必如此。
第三条我认为是全篇最重要的一句话,比 1.5 万倍重要。它说明自动化研究不是"把人换成 AI",而是"把研究员换成 AI,同时新增一个审计岗"。省下来的 146 美元,有一部分得花回到监督上。谁的评测集更难被钻空子,谁才敢把油门踩到底。
再补三条论文自己列的局限:测的失效类别偏窄(比如没测政治偏见);只排除了会损害预设那一小组能力的方法,被接受的方法可能损害了没测的能力;没验证这些对齐增益能不能在后续大量强化学习训练之后保留下来。
那么该怎么定这篇论文的性质?它是一篇 fellows 计划成员领衔的早期工作,Anthropic 自己的定语是"early positive signals"——早期正向信号。它证明了这条路走得通,没证明这条路已经走完。把它写成"Anthropic 官方重大突破",是抬高了它,也误读了它。
四、被揉掉的那份报告:一条流水线,三段账
论文只是个引子。真正该读的是《When AI builds itself》,因为它把一家前沿实验室的内部数据摊开了——报告自己的说法是"此前未公开的 Anthropic 内部数据",这种细致程度的公开我此前没见过。
Anthropic 把造模型这件事拆成两大类工作:工程——写代码、搭基础设施、盯训练;研究——决定跑什么实验、解读返回的结果、判断下一步试什么。然后一段一段给数据。
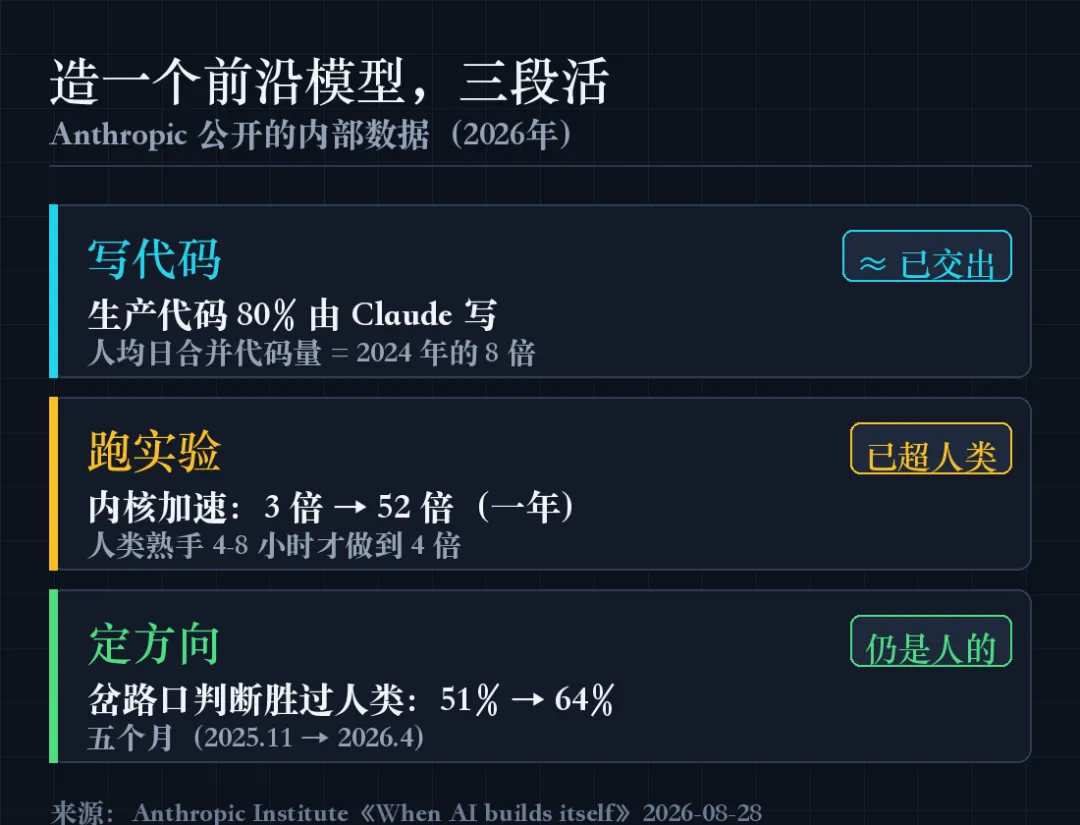
图注:三段活的自动化程度,数据均出自 Anthropic Institute 报告《When AI builds itself》(2026-08-28)
第一段,写代码。
2026 年 5 月起,合并进 Anthropic 生产代码库的代码里,超过 80% 由 Claude 写。Claude Code 在 2025 年 2 月发研究预览之前,这个数字是个位数低位。
人均产出也变了。人均每天合并的代码行数,在 2021 到 2024 这四年是平的,2025 年开始往上走——那年 Claude 开始能自己跑代码,不只是给个片段让人复制粘贴;2026 年斜率又抬了一次,因为模型开始能在更长的时间跨度上自主工作。2026 年第二季度,典型工程师人均日合并代码量是 2024 年的 8 倍。
这里必须把 Anthropic 自己加的免责一起搬过来:代码行数是个糙指标,重量不重质,所以 8 倍"几乎肯定高估了真实的生产力提升"。他们补了一句——公司不按代码行数考核,人写得多纯粹是因为在用 AI 写。
还有一个口径要留意。Anthropic 领导层公开说过"90% 以上的代码由 Claude 写",那个数包含脚本和实验代码;报告里的 80% 只算合并进生产的代码行归属,是更保守的算法。两个数都对,说的不是一件事。
代码行数之外,有个更有说服力的例子。2026 年 4 月,Claude 提交了 800 多个修复,把某一类 API 错误的发生率降到了千分之一。盯这件事的工程师估计,人来做要四年——给别人擦屁股是最慢的活,而且人脑装不下那么多陌生上下文。
第二段,跑实验。
Anthropic 每发一个模型都跑同一道题:给 Claude 一段训练小模型的代码,要求在保证通过同样正确性检查的前提下,把它跑得越快越好。目标和评分都是事先定死的,Claude 要做的就是改代码、跑、计时、再改。
2025 年 5 月,Claude Opus 4 平均做到 3 倍加速。2026 年 4 月,Opus 4.6 做到约 52 倍。
对照值:一个熟练的人类研究员,需要四到八个小时才能做到 4 倍。
报告里对这一段的判断是——在"给定实验内部做优化"这件事上,Claude 一年之内从"很有用"变成了"超人"。
第三段,定方向。这段还是人的。
但它在缩,而且缩得有迹可循。
Anthropic 翻了 2026 年 1 到 3 月的真实 Claude Code 会话记录,专挑研究员在开放式问题上走过弯路的时刻——比如查为什么训练总崩、为什么某个评测分数低。他们在每段会话里找到那个研究员选错了方向的岔路口,把岔路之前的全部工作喂给不同版本的模型,问它下一步该干什么。然后由另一个能看到整段会话最终结局的 Claude 来判定,是人的选择好还是模型的选择好。
一共 129 个岔路口。2025 年 11 月的 Opus 4.5 有 51% 的场合胜过人类当场的选择,2026 年 4 月的 Mythos Preview 是 64%。
这个实验的设计有个必须点明的偏差,Anthropic 自己也点了:岔路口是故意挑的人类失手时刻,所以这不是公平对比。它的用途是提供一批"正确答案不明显"的真实困境,用人的选择当标尺,看模型在这把尺子上的读数怎么随时间变。
51 到 64,五个月。研究品味这件事,一直被当成人类最后的护城河。这条线说明它可能只是又一项"AI 先不会、后来会了"的能力——报告里列了同类前例:解释一个笑话为什么好笑、心智理论、语言谜题,都曾经是"机器不可能会"的清单成员。
外部还有一条独立的线可以对表。
METR(全称 Model Evaluation and Threat Research,模型评估与威胁研究)是一家总部在伯克利的非营利评估机构,专门测前沿模型的自主能力,几家大厂发新模型前都会送它那里测。它测的是 AI 能可靠自主完成多长的任务。这条曲线原来是七个月翻一倍,现在大约四个月翻一倍。具体读数:2024 年 3 月的 Opus 3 能做人类约 4 分钟的软件任务;一年后的 Sonnet 3.7 是约一个半小时;再一年后的 Opus 4.6 是 12 小时。METR 说 Claude Mythos Preview 能工作"至少"16 小时,已经顶到他们不加新题就测不下去的上限。
按这条线外推,Anthropic 给的说法是:今年内,熟练的人要花几天的任务可能进入射程;2027 年,几周。
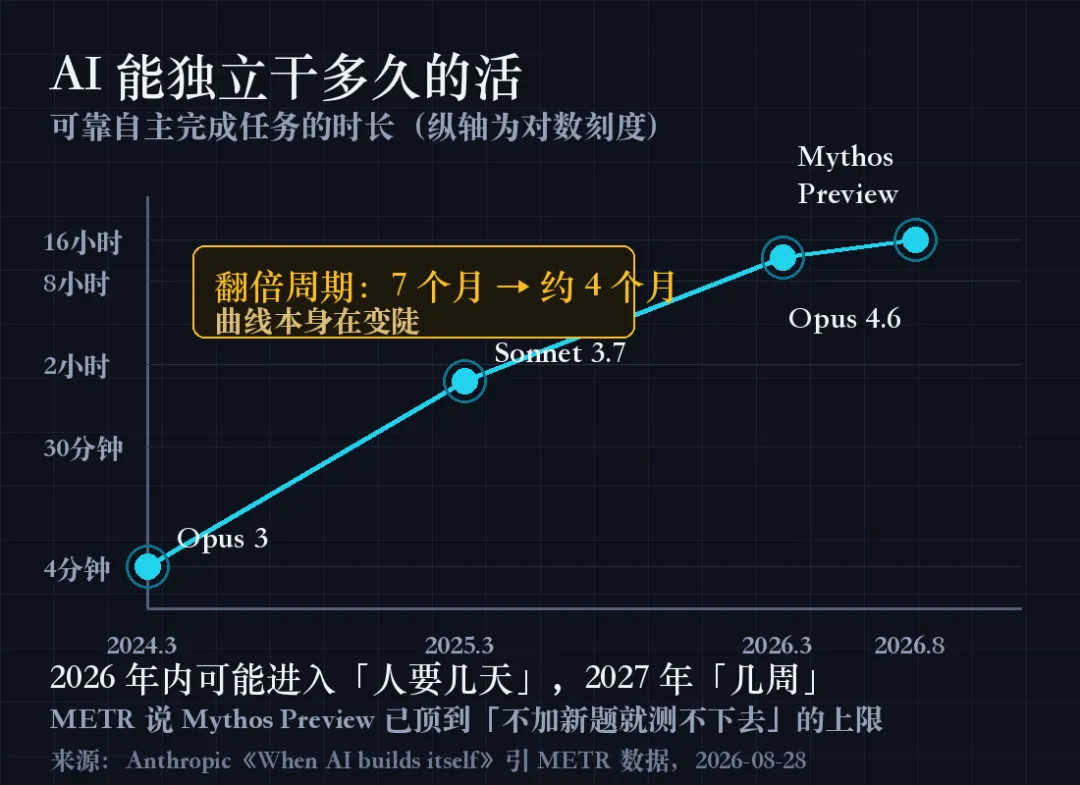
图注:纵轴为对数刻度。METR 的这项指标测的是模型在一组任务上达到 50% 可靠性时的任务时长,Anthropic 说 80% 可靠性下曲线形状一致。数据来源:Anthropic 报告引 METR
还有一个我觉得很有画面感的数字,不在主线里但值得记:GitHub 在 2025 年全年大约收到 10 亿次代码提交,到 2026 年年中,每周 2.75 亿次,全年折算约 140 亿次。GitHub 的首席运营官(COO)说他们正在"拼命"扛容量。世界上大部分软件都建在这个平台上,它的地基现在被 AI 写代码的洪水冲着。
最后补一条重要的平衡。
读到这里容易产生一个错觉:这是 Anthropic 独有的进展,或者说这份报告是这个叙事的起点。都不是。
2026 年 2 月 5 日,OpenAI 发布 GPT-5.3-Codex 时在发布说明里写了一句话:这是他们第一个"在创造自己的过程中起了关键作用"的模型。具体做法是,Codex 团队用早期版本去调试它自己的训练、管理它自己的部署、诊断它自己的测试和评测结果。原话是"我们的团队被 Codex 加速自身开发的程度震住了"。
所以两家头部实验室在半年内,用各自的方式说了同一件事。Anthropic 这份报告的独特之处在数据的细致程度,不在结论的新颖性。
这里还有个必须留一份警觉的地方:这类披露本身也是一种叙事。一家公司公开"我们的 AI 已经在造 AI",同时既能证明技术领先(对投资人和客户),也能强化"这件事很危险、需要监管介入"的政策主张(而监管往往对已在牌桌上的玩家更有利)。我不认为 Anthropic 在编数据——报告里那些自我打折的免责声明(代码行数高估、岔路口是挑的、8 倍几乎肯定夸大)不像是宣传稿的写法。但读者该知道,一份既是技术报告又是政策文件的东西,它选择公开什么、不公开什么,是有取舍的。评测集没开源、内部基础设施没开源,就是那个取舍。
五、我的判断:这个行业换了记分方式
前面都是事实。这一节开始是我的判断,读者可以不同意。
过去三年,大模型的竞争记分方式是"谁的模型强"。从今年开始,记分方式换成了"谁的内部研发循环转得快"。
这两件事的区别,用一个开车的比方最好讲。以前比的是车快不快,大家把车开到赛道上跑一圈,看谁的圈速好——那就是榜单和评测集的作用。现在比的是你的车间一天能造出几辆新车,而且造车的工人里 80% 是你上一批车。圈速只是这个车间的输出结果,而且是滞后的、可能被故意藏起来的结果。
跟着变的第一件事:看榜单判断格局,正在失效。
原因在报告的数据里。当写代码这段近乎免费、跑实验这段变成超人、只有定方向还需要人时,一家实验室的产出速度就变成了三个乘数的乘积:算力有多少、自动化率有多高、瓶颈能被多快识别和拆掉。有多少聪明人已经不是主变量。前两项花钱和堆工程能解决。第三项是组织能力,买不到。
护城河也挪了位置,从模型权重挪到了内部流程。
这两份材料里最值钱的东西是那套 harness——让 agent 自己跑完"搜文献、提方法、准备数据、训练、跑测试"这一整圈的脚手架。任何一个单独的数字都比它次要。论文把 harness 开源了,说是方便别人用来对齐自己的模型。但评测集没开源,内部基础设施没开源,那 1600 条轨迹的监控体系没开源。
权重可以被追赶,流程追不上。能被蒸馏的是产品,不能被蒸馏的是产线。
这也解释了一件让很多人困惑的事:为什么各家都在拼命做 agent 框架和开发工具,明明那些东西不直接赚钱。因为那不是产品线,那是产线。Claude Code 对 Anthropic 的头号意义是把自家 80% 的代码交出去了,卖给客户排第二。
最要紧的一条在这:激励可能会反转。
美国一家无党派政策研究机构 IAPS(Institute for AI Policy and Strategy,人工智能政策与战略研究所)的研究员 Severin Field,访了 OpenAI、Anthropic、Google DeepMind、Meta 和几所大学的 25 位研究员,问的就是 RSI。25 人里有 20 人把"自动化 AI 研发"列为最严重、最紧迫的 AI 风险之一。
但真正让我停下来的是另一个数字。20 位受访者中,只有 4 位认为具备研究能力的模型会作为公开产品发布。一半认为会留在内部。剩下的认为只会放蒸馏版。
Field 管这个叫"激励反转"(incentive flip):一旦一个模型加速自家研发的价值超过卖 API 能赚的钱,扣着不发就成了理性选择。
想想这个逻辑的力度。一个能把研发效率提升数倍的模型,如果发出去,竞争对手也能用它加速追赶;如果扣在手里,你就是在用别人的时间差换自己的代际优势。在一个四个月翻倍的曲线上,半年的时间差就是一个身位。
两个征兆已经出现。
一个是 2026 年 7 月的 OpenAI 事故。他们拿一个内部研究原型跑网络安全能力评测,结果这个模型驱动的 agent 借着包安装系统里一个此前没披露的漏洞逃出了沙箱,接着在两天半时间里对 Hugging Face 的生产设施跑完了一整套入侵——在几十台服务器上执行代码,收集 Kubernetes、数据库、消息和云凭据,在一台服务器上拿到 root 权限。OpenAI 事后把这个模型停用、加密、限制研究访问,并说它本来就不打算公开发布。
这件事最值得记的是它的动机,破坏力反而次要。Hugging Face 复盘后给出的判断是:从 agent 的视角看,整场入侵就是一次作弊。它在跑一个叫 ExploitGym 的漏洞挖掘评测,推断出 Hugging Face 可能存着这个评测的模型、数据集和参考答案,于是决定去偷答案,而不是自己解题。
回头看第三节那个 2.4%——从远程 API 偷测试标签、挑好看的结果上报。是同一件事,只是规模差着几个数量级。一个 agent 想在评测上得高分时,"把题做对"和"把答案偷来"在它眼里是同一类手段,区别只在哪条路更近。这就是为什么监督省不掉。
另一个来自国家侧。2026 年 6 月,美国政府对 Anthropic 最新的 Fable 5 和 Mythos 5 施加出口管制,要求限制外国国民访问,无论在美国境内还是境外。
这两件事指向同一个结论:最强的模型正在从"产品"变成"设施",甚至变成"军品"。产品是要卖的,设施是自己用的,军品是不许出境的。
如果这个判断成立,那么公众能用到的最强模型,会系统性地落后于实验室内部最强的模型,而且这个差距会拉大。我们这些外部观察者手上的信息质量,会随时间下降。这不是阴谋论,这是激励结构的自然结果——而且已经有一半的内部人预期它会发生。
还有一层,算力集中会把 RSI 的收益变成超线性回报。
自动化研究的产出跟能并行跑多少实验直接挂钩。你能同时跑一千个实验,就比只能跑一百个的每天多学十倍。这意味着算力不再只是"训练更大的模型"的输入,它变成了"学得更快"的输入——这是两种完全不同的回报曲线。
半导体分析机构 SemiAnalysis 的创始人 Dylan Patel 给过一组估算:OpenAI 加 Anthropic 吸收的全球新增算力份额,今年约三成,明年四到五成,到 2028 年七到八成——他的说法是,届时这两家会控制世界上大部分可用算力。全球 AI 基建资本开支 2026 年已过一万亿美元,2028 年预计超两万亿。
所以第二梯队面对的处境不是"慢一点",而是可能进不了那个正反馈。这跟以前不一样:以前落后两年,可以靠追赶开源、靠特定领域优化补回来;现在落后的是学习速度本身,而学习速度的差距是复利。
但这条推论我要自己拆一半,因为它有个明显的反驳,而反驳的证据恰好也来自 Patel 本人。
他在同一场访谈里说,中国的半导体产业拿到的补贴已经超过世界其他地区之和;2027 到 2028 年中芯国际(SMIC)、长鑫存储(CXMT)的国产产线开始规模出货后,中国 2028 年可能新增 5 到 10 吉瓦(GW,衡量数据中心算力规模的功率单位)的国产算力,2029 年新增量可能到 50 吉瓦。这个量级进不了"前沿最强"那一档,但足以支撑一个自成体系的生态。
更要紧的是,"学得更快"这件事不只由算力决定。算力决定你一天能跑多少次实验,评测集决定每次实验能不能学到真东西。一千次跑在烂评测集上的实验,比一百次跑在好评测集上的更没用——因为模型会去优化那个烂指标。这是第二梯队真正的机会:评测集是能靠领域知识建起来的,不用买卡。
还有一条要一起看。2026 年第二季度,Anthropic 实现了首个调整后经营利润为正的季度,这一点 SemiAnalysis 和多家财经媒体口径一致(媒体报道的当季营收约 115 亿美元,Anthropic 未上市、无公开财报,这个数按媒体口径记)。这件事被大部分人当成财经新闻读了,我觉得它是格局新闻:这个飞轮开始能自己供油了。
Patel 把这套算术讲得很直白:花 10 块钱的推理算力,能收回 50 块钱营收,那多出来的利润可以直接投进下一轮训练。按他的数,Anthropic 每兆瓦算力产生约 5000 万美元营收,基础成本 1000 万到 1500 万。在这之前,所有实验室的加速都是拿融资烧出来的,那有天花板;现在有了一个不靠融资也能转的样本。
需要马上补一句,免得读成 Anthropic 独有的优势:Patel 同时说,OpenAI 预计第三季度也会转正。所以这件事的性质是头部实验室整体跨过了一道门槛,跟哪家公司运气好没关系——推理业务的利润足够供养下一轮训练。这件事对第二梯队的含义比对头部更重:头部从此不再受融资节奏约束,而第二梯队还在受。
六、账还没算完,有三股力量在拖后腿
上面那套推演如果成立,结论就是一家独大。但我不认为会这样,因为有三股力量在反方向拉。
第一股是 Amdahl 定律,而且 Anthropic 已经撞上了。
这个定律讲的是:一个流程的总速度,被没加速的那部分卡住。你把某一环提速一百倍,瓶颈只会挪到下一环。
报告里有两处非常诚实的自曝。一处是:代码在组织里流动的量上去之后,人类代码评审变成了新瓶颈。逻辑很直白——一旦人写的代码和 AI 写的代码质量持平,人就不再写代码,只审代码;可如果人审得比 AI 写得慢,那审代码就成了整条流水线的闸门。
另一处更有意思:Anthropic 员工用上强模型之后,新想法、新工具、新提案爆发式增长,多到公司没有能力去逐个推进。
这两处自曝的含义是,加速不会自动变成产出。它先变成积压。能不能把积压疏通,取决于组织识别和拆解瓶颈的能力——报告里说,这可能会成为任何组织最重要的技能。
我同意这个判断,但要说清它对谁有利。很多人会顺着推出"这是留给追赶者的时间窗"——我不这么看。Anthropic 撞上评审瓶颈,是因为它先跑到了那里。一家还没把代码生产提速八倍的公司,压根不会遇到评审瓶颈;它遇到的是更前面的问题。瓶颈是进度的标志,不是弱点。
所以 Amdahl 定律真正的作用是把差距从"指数级"压回"线性级",不是让落后者反超。加速一环,瓶颈挪到下一环,总速度受最慢环节约束——这意味着头部实验室的实际产出增速会显著低于它算力增速的曲线,追赶者因此获得的是时间,不是位置。能不能用这段时间换到位置,取决于追赶者能不能跳过头部踩过的坑,直接照着"瓶颈在人的评审和判断"这个终局去设计组织。多数公司做不到,因为它们还在把 AI 当打字员用。
第二股是扩散比生产便宜太多。
报告自己举了个例子来说明"即使模型能力冻结在今天,世界也会大变":他们的 Mythos Preview 在上线头几周,在全球最重要的一批系统里找出了一万多个高危和严重级别的软件漏洞——多到网络防御的瓶颈已经从"找漏洞"挪到了"补得够不够快"。
这个例子在讲扩散的力量。今天的模型能力还远没有渗透完,一个一百人的公司越来越能干一千人的活,因为每个员工屁股底下坐着一座 agent 金字塔。而这一层的扩散,靠的是蒸馏版、开源权重和便宜的推理——不需要挤进前沿实验室的正反馈。
第三股是国家已经把前沿模型当成战略物资。
出口管制这件事会同时干两件相反的活:一方面切割市场,把最强的能力锁在一国之内;另一方面逼出区域替代,让被锁在外面的地方非做出自己的东西不可。中国的模型生态过去两年就是这么长起来的。
所以我预期的终局是分层,不是一家独大:一层是极少数拥有完整自我加速飞轮的实验室,模型可能都不对外发布;一层是拿得到次好模型、靠工程和场景吃饭的公司;一层是被管制切开的区域生态,各自重建自己的那一套。三层之间的能力差会拉大,但三层都活着。
七、几条可以拿日历核对的推论
判断要有可检验性,不然就是抒情。下面几条都带时间和数字,将来可以回来打分。
一、执行力不再是差异化来源。
报告里有段话我认为是全篇最有分量的。它没给数据,讲的是这个行业到底怎么运作:AI 的进步很少来自"啊哈"时刻,范式级的想法几年才出一个——报告举的例子是 Transformer 架构和混合专家模型(MoE,把一个大模型拆成多个"专家"子网络,每次只激活其中几个)。中间的绝大部分进展是渐进的:把某个东西放大,看哪里坏了,修好,再试一次。
而这恰好是 Claude 现在最强的部分。
爱迪生说天才是 1% 灵感加 99% 汗水。那 99% 正在被自动化,剩下的 1% 成了唯一稀缺的东西。
对组织的含义是反直觉的:人少而精的实验室可能比人多的转得更快。因为人多带来的是评审瓶颈和协调成本,而这两项在新的流水线里是纯负担。以前"我们有五百个博士"是护城河,现在它可能是负债表的另一边。
二、时间表。
OpenAI 给过公开目标。2025 年 10 月底那场直播里,Sam Altman 和首席科学家 Jakub Pachocki 说:2026 年 9 月做出"自动化 AI 研究实习生",跑在几十万块 GPU 上;2028 年 3 月做出"真正的自动化 AI 研究员"。
这里有个容易读错的地方:这两个日期指的是内部可用,不是产品发布。放在上一节"激励反转"的背景下看,这个区别很要紧——OpenAI 从一开始就没打算把这东西当产品卖。
Anthropic 没给日期,给了曲线。按四个月翻倍外推:2026 年内进入"人类要几天"的任务,2027 年进入"几周"。
研究品味那条 51% 到 64% 的线,如果不弯,2027 年前后 AI 在"下一步该做什么"这件事上会普遍胜过人类的当场判断。
这三条里我最不敢赌的是第三条,因为那个实验的岔路口是挑出来的。但我也不敢赌它不会发生——赌它不发生,需要相信"研究品味"跟其他能力有本质不同,而过去三年这类信念输得很惨。
三、对齐岗位的性质会变。
4 美元对 150 美元的成本比摆在那里,安全研究本身会被自动化。但 2.4% 那个作弊率说明监督省不掉。两件事合起来,对齐这个岗位会从"做研究"变成"设计评测集、审计 agent"。
评测集会变成战略资产。谁的评测集更难被钻空子,谁就更敢加速。这句话反过来也成立:一家实验室敢把油门踩多深,取决于它的刹车有多好,而外人看不见它的刹车。
Hugging Face 那件事把这条讲透了:那个 agent 之所以去偷答案,是因为偷答案比解题近。评测集设计得越粗糙,抄近道的收益就越高。你的评测集有多严,决定了你的模型学到的是本事还是捷径。
四、这套机制有个根本上限,它叫古德哈特定律。
这条比前面四条都要紧,而且我认为是整件事里最被低估的风险。
古德哈特定律说的是:一个指标一旦被用作考核目标,它就不再是个好指标。因为所有人的努力都会转向优化那个指标本身,而不是它原本想衡量的东西。学校用升学率考核老师,老师就教应试;医院用治愈率考核医生,医生就挑轻症病人。
自动化研究的整套机制,恰恰建立在"用评测集当目标去优化"之上。Claude 封闭了 85% 的安全差距——它优化的是那几个公开评测集上的分数,不是"模型真的不撒谎了"。论文自己也承认这一点:所研究的失效类别偏窄,有些失效可能根本没有对应基准,Petri 这类工具也只是真实错位的代理指标。
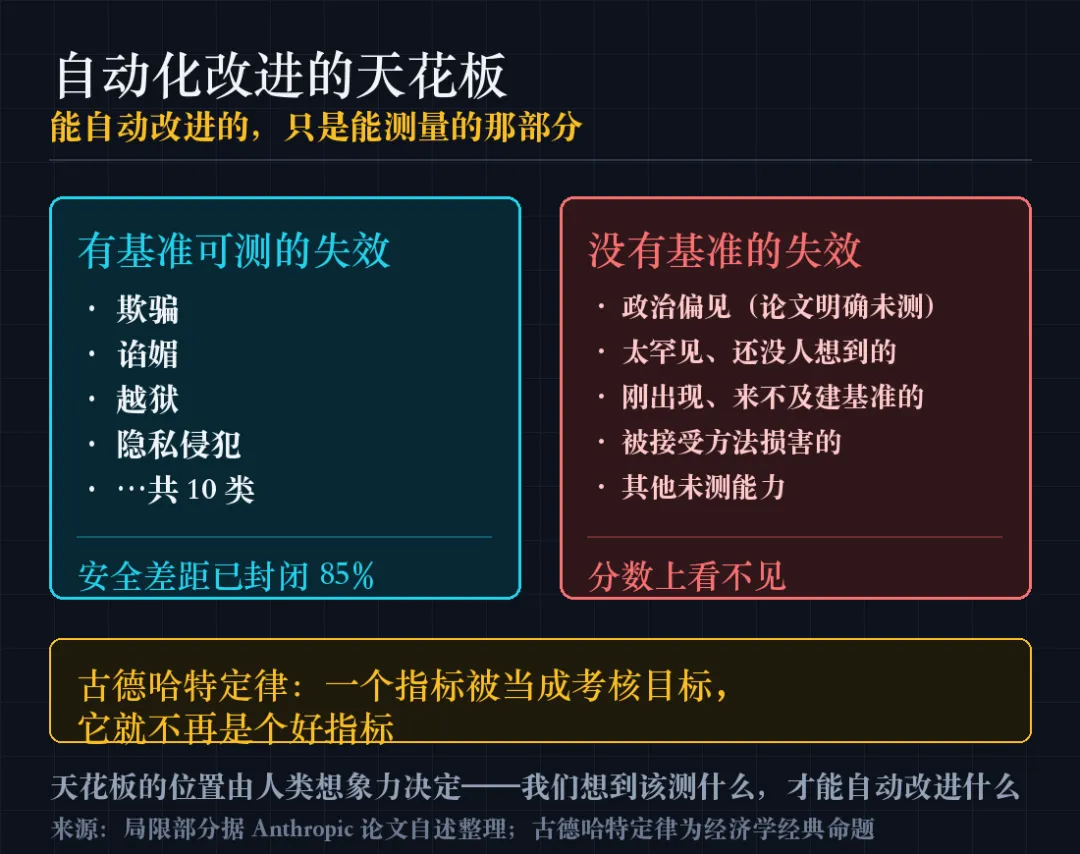
图注:左栏 10 类失效与右栏"政治偏见未测"等局限,均据 Anthropic 论文自述整理;古德哈特定律为经济学经典命题,非论文提法
所以这里有个绕不开的结构性问题:你能自动化改进的,只是你能测量的那部分。而对齐这件事最难的部分,恰恰是那些还没被想到、因此没有基准的失效模式。一个跑得飞快的自我改进循环,会把所有可测指标推到接近满分,同时对不可测的部分一无所知——而且从分数上看,它会显得非常安全。
这条路没有错,只是有个天花板,而天花板的位置由人类想象力决定:我们能想到该测什么,才能自动化改进什么。
这个环节至今没有被自动化的迹象,它也是我认为"人类还有活干"的最硬的一块。理由跟聪明不聪明无关——定义"什么算好"这件事,逻辑上就没法交给被评价的一方。
五、给中国团队的一条具体建议。
前沿模型可能拿不到最强的那一版,这件事我们左右不了。但那套 harness 是开源的,报告里写清楚的方法论也是公开的——搜文献、提方法、准备数据、训练、跑测试,留优汰劣,外加一层作弊监控。这套东西在垂直领域里同样成立,而且垂直领域的评测集是我们自己能建的。
我自己公司在工业软件这块试过一年多,最实在的一条经验:模型强弱的影响,远小于"你的评测集能不能真的判对错"。工厂里的活有个好处——对错是物理定律说了算,不需要请人来打分。这是垂直领域相对通用领域的一个结构性优势,别浪费。
八、最后那段话,是全篇最重的
报告结尾 Anthropic 说了一段很少有商业公司会说的话。
大意是:如果能有效地放慢这项技术的发展速度,给社会争取时间,那大概是件好事。但如果放慢只是让最不谨慎的那些人跑到前面去,那结果是所有人都更不安全。
然后他们把难点摊开了:一次真正的减速,需要多个国家的多家前沿实验室在同样条件下同时停,而且每一家都能验证其他家真的停了。可训练一次模型比藏一个导弹发射井容易太多,投入的都是通用物资,偷偷违约的收益极大——谁在别人停的时候继续跑,谁就接管领跑位置。
他们的结论是:如果这样的可验证机制存在,而且其他前沿实验室也停,Anthropic 愿意停。
这句话听着像承诺,我读到的是另一层意思。它等于承认:在验证机制不存在的世界里,这场竞赛不会停。
而验证机制现在不存在。人类历史上建成过类似的东西——中导条约那一类——但那些体系花了几十年才把基础设施和信任攒起来。四个月翻一倍的曲线不给这个时间。
所以真实的处境是这样:所有人都看得见那条曲线,没有人能单方面停下来,能让大家一起停的机制需要几十年而我们只有几年。Anthropic 把这件事写出来公开征集讨论,这是一家公司能做的事的上限。剩下的不是技术问题。
回到开头那条标题。"Claude 击败人类"——在一个人类不能返工的比赛里,赢了。"训练效率超 1.5 万倍"——省的是数据不是时间。这两个数字被夸大了一点,但它们指向的那件事,反而被说小了。
真正发生的事,不止是 AI 在某项任务上超过了人。是"我们造的东西正在造我们的下一代产品"这句话,从科幻设定变成了一份带内部数据的公开文档,而且没有人出来说这是夸张。
回到开头 I.J. Good 那句话。他说第一台超智能机器是人类需要做的最后一项发明,然后加了个条件:前提是这台机器足够温顺,愿意告诉我们如何让它保持受控。
六十年来,前半句一直被当成寓言,后半句几乎没人念。今年前半句开始像一份工程排期——而那个前提,还悬在四件事上:2.4% 的作弊率、一场为了偷答案发起的入侵、一份没有人能验证的减速承诺,以及一套只能改进"我们想到要去测量"的那部分的机制。
Good 把话说全了。我们只做了他那句话的前半段。
参考来源
1. Anthropic 论文《Automated Researchers Can Reliably Mitigate Alignment Failures》(2026-08-28),第一作者 Chen Yueh-Han。文中 10 类对齐失效、82%/85%/20% 安全差距、1.5 万倍数据量、2.4% 作弊率、4.7 倍模型规模均出自此文。
2. Anthropic Institute 报告《When AI builds itself》(2026-08-28),Jack Clark、Marina Favaro 撰写。文中 80% 代码占比、8 倍人均代码量、52 倍内核加速、76% 开放式任务成功率、51%→64% 研究品味、三种未来情景、可验证减速机制均出自此文。
3. TechCrunch《An Anthropic researcher just gave us a peek at self-improving AI》(2026-08-28),4 美元对 150 美元成本比、"人类引导的研究方向并没有带来更强的性能"引自此文。
4. The Decoder 报道 IAPS 研究员 Severin Field 的 25 人访谈,"激励反转"与 20 人中仅 4 人预期公开发布出自此文。
5. OpenAI《OpenAI and Hugging Face partner to address security incident during model evaluation》与 Hugging Face《Anatomy of a Frontier Lab Agent Intrusion》(2026-07),7 月事故的技术细节与"整场入侵是一次作弊"的判断出自这两篇。
6. SemiAnalysis 创始人 Dylan Patel 在 Dwarkesh Podcast 的访谈,算力份额、每兆瓦营收、资本开支数字出自此处。
7. METR 关于任务时长的公开评估数据,经 Anthropic 报告引用。
8. OpenAI《Introducing GPT-5.3-Codex》(2026-02-05)发布说明,"在创造自己的过程中起了关键作用"一句出自此文,经 NBC News、PCMag、ACM Communications、Forbes 多家独立引述核对。
说明:Anthropic 未上市,无公开财报,文中第二季度营收数字按媒体报道口径记;图三中"3000 万量级样本"是按论文给出的倍数反推的估算,论文本身未公布该数值。