ARTICLE · 982359
太强了!腾讯开源AI搜索工具,能帮你搜索文本、图片、视频内的指定内容
不用再给文本、图片、视频各配一套检索逻辑,这个腾讯微信团队开源的AI模型能把它们放进同一个向量空间里搜到任何你想了解的内容。
#多模态检索#Embedding模型#腾讯开源#AI工具#知识库
你的素材库,是不是已经乱成一座迷宫?
做内容的人,手机相册里大概躺着几千张截图,网盘里堆着数十个没看完的PDF,聊天记录里还散落着大量随手存的参考图。平时要找一个东西,脑子里明明知道“好像见过一张类似的图”,但就是翻不出来。
这不是你的问题。文本、图片、视频、文档,本来就是四种不同形态的信息,传统搜索工具只能分开处理。搜文字用关键词匹配,找图片靠标签或文件名,视频更是基本靠人肉记忆。素材一多,找东西的耐心就全耗在翻文件夹上。
如果你做过知识库或者检索增强生成(RAG)类的应用,对这种割裂感会更深。文本要过文本模型,图片要过视觉模型,视频得先抽帧再处理,每个步骤都需要单独的管道和向量空间,最后还得想办法把结果对齐。工程上又繁又重,做着做着就像在玩积木,各零件都能跑,但拼不到一起。
这种麻烦,技术圈早就知道,只是一直没有一个特别顺手的统一解决方案。最近看到腾讯微信视觉团队开源的一个项目,让我觉得这事有点要变简单的意思。
举个例子,你想在某个视频内搜索所有美女打开车门的片段。
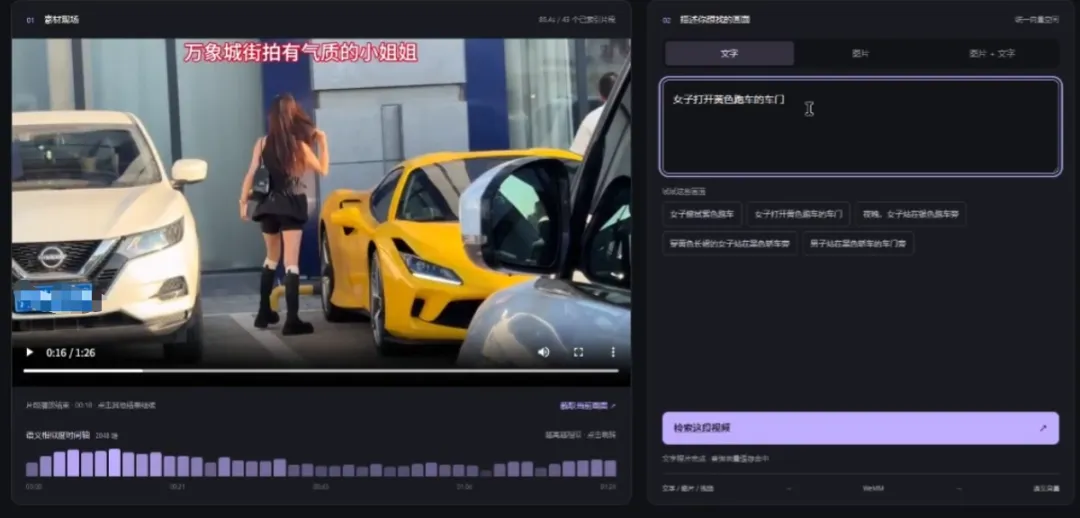
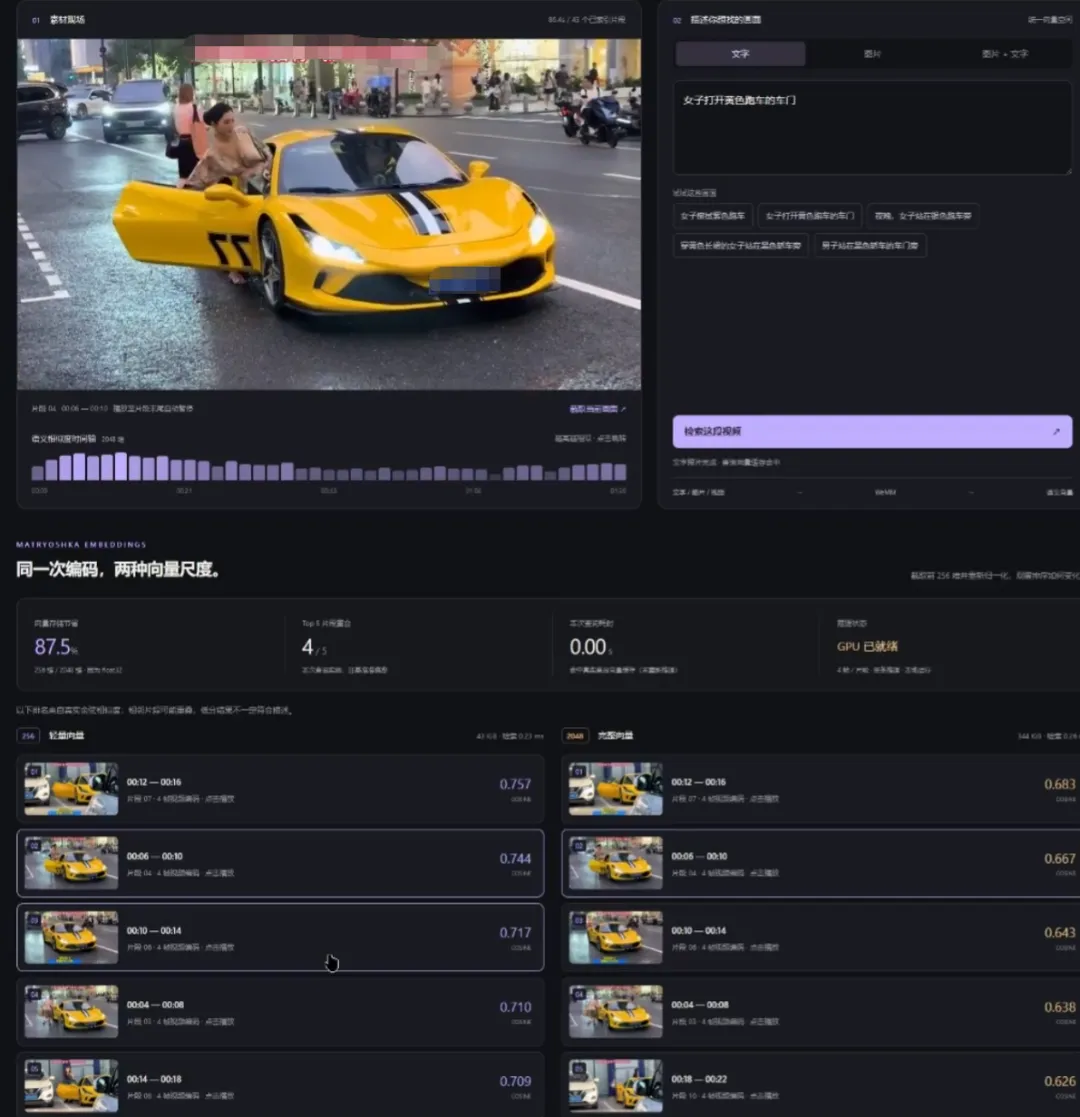
输入文本之后,AI会把所有相关信息给你展示出来。
一个模型,把多模态素材统一成同一种“语言”
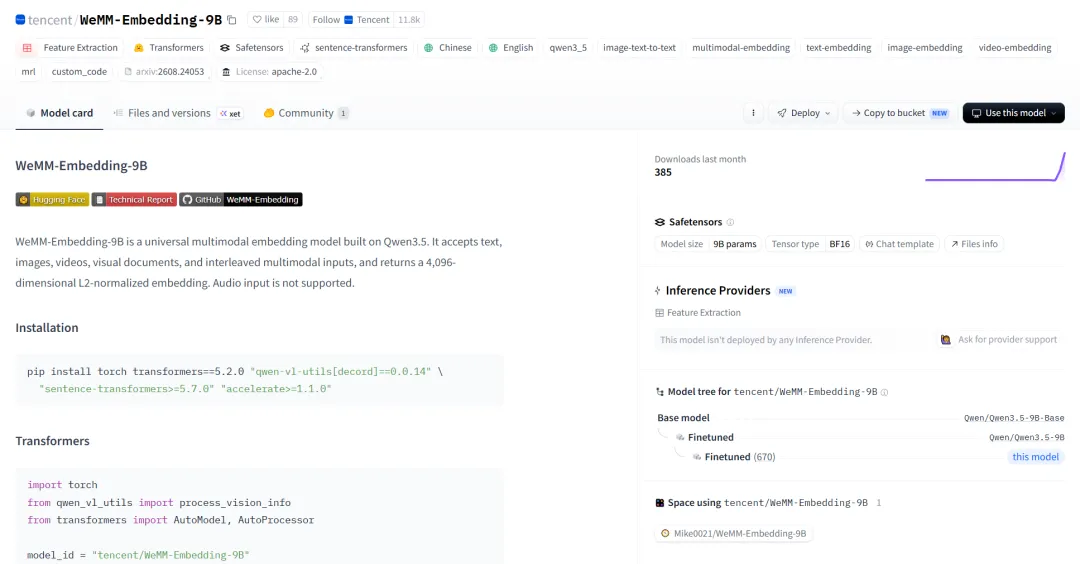
项目名字叫 WeMM-Embedding,说起来是“微信多模态嵌入模型”,本质上是一套能把文本、图片、视频、视觉文档(比如PDF和PPT)全部转成统一向量的开源模型。
先问一个很多非技术读者会关心的问题:什么叫“转成向量”?你可以粗浅地把它理解成,给每段文字、每张图片、每段视频内容生成一串“数字指纹”。以前的问题是,文本有文本的指纹系统,图片有图片的,视频有视频的,你要比一张图跟一段文字像不像,相当于拿一把英制尺子和一把公制尺子互比长度。
WeMM-Embedding 做的,就是让所有素材都生成“同一单位”的指纹。经过它处理后,一篇产品说明、一张街拍照片、一段教学视频和一份PPT,都被放进同一个向量空间里。在这个空间里,你拿图片去找视频、拿文字去找图片、拿一段视频去找最相近的图文文档,相似度都能直接计算、直接排序,不需要任何转换层。
预算有限也能玩,多个版本供你测试
多模态模型容易给人“只有大厂跑得动”的印象。但 WeMM-Embedding 在这一点上做了一个很务实的处理,叫 Matryoshka 弹性维度。
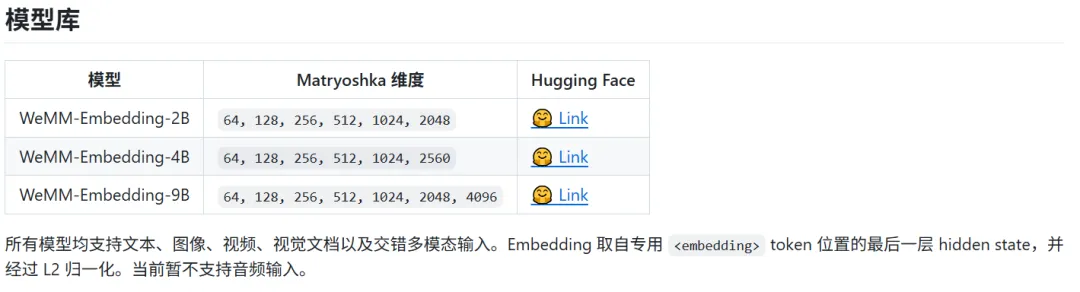
按模型参数规模,它分为 2B、4B、9B 三个版本,不同版本都支持把向量从完整的较高维度,按需截断到 64、128、256、512 等低维度。仓库里展示了一个数字:2B 模型在只保留 256 维的情况下,仍能保住约 98.7% 的图像和视频检索性能。
这个数字对你意味着什么?维度越低,存储和检索成本越省。做过多模态搜索的人都知道,高维向量在千万级数据量下,存储和计算开销极其吓人。过去如果你想省成本,只能自己重新训练一个低维模型,还得承担效果下降的风险。WeMM-Embedding 的做法是,把“不同维度”这件事直接内建在训练过程里,你测试时想要多细就截多细,等于让不同预算的团队都能找到一个可接受的精度和成本平衡点。
从这个设计能看出,微信视觉团队大概很理解中小团队的现实。不是所有人都能像大厂一样堆显卡,给一个可裁剪的模型,至少让更多人在起步阶段先跑起来。
可以尝试玩玩
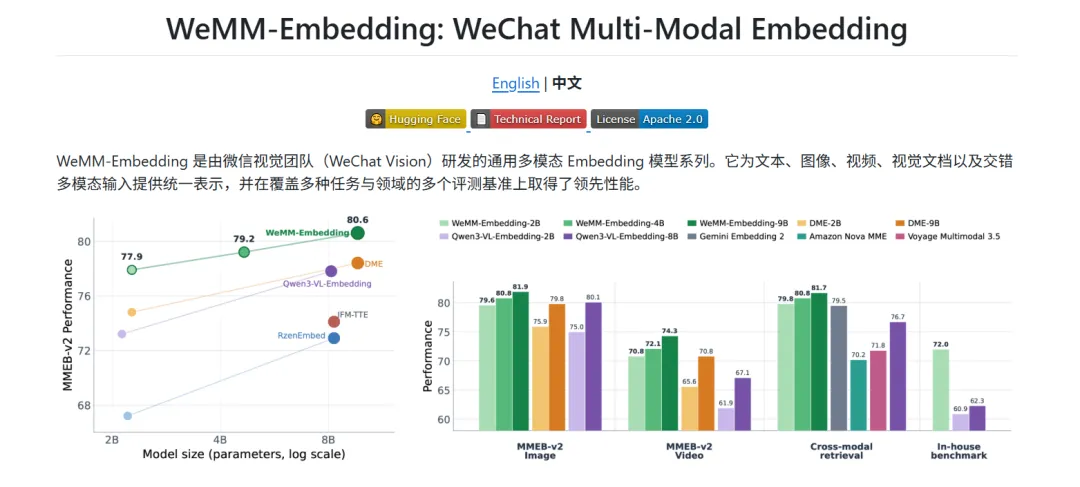
仓库里贴了不少评测数据,在 MMEB-v2 的 78 个任务上,2B、4B、9B 三个规模的模型都超过了同规模的一些开源模型。在覆盖更广的 MMEB-v3 评测上,数字看起来也排在前面。
需要注意的是,这些数据来自项目方自己的评测流程。文档确实也开源了评测代码,但人家自报的 SOTA,毕竟不能等同于第三方替你背书。它代表的是“微信视觉团队用统一评测体系验证过自己的模型”,而不是“交给任何业务场景都一定更好”。
技术圈的老规矩,新模型出来先看基准分,再跑自己的数据,最后才谈得上信任。这个项目至少给了你一个很不错的起点:既然评测代码、模型权重、推理脚本都公开了,你完全可以空出一个周末,拿自己业务里的图文或视频数据试一遍,看看它的表现。我看了仓库的使用流程之后,第一反应是这项目不像某些开源项目那样只丢个权重就完事,它把安装、推理、评测和服务化部署都整理得比较完整,真正想用在生产环境里的团队会觉得省心不少。
什么场景最值得用它,以及你该怎么开始
如果你现在正在做这几类事情,WeMM-Embedding 会是值得放进观察清单的项目:
第一类是内容平台、电商或素材库,需要“以图搜图”、“以图搜视频”、“相似素材去重”。以前为了这个功能可能要同时养着几个模型管道,现在用一套模型就能处理多种输入,后端逻辑会简化很多。
第二类是企业知识库应用,尤其是那种包含大量图文报告、产品手册、视频教程的混合知识库。用这个模型把内容统一向量化之后,用户可以用自然语言提问,甚至直接上传一张截图去检索相关章节。对,就是让 RAG 从“纯文字问答”升级成“图文视频都能关联”的形态。
第三类是多模态智能体。智能体在处理当前截图或视频片段时,需要从历史信息中检索类似问题的处理方式。一个统一的向量表示,恰好能让这种“查找历史类似场景”的记忆召回变得更顺滑。
从仓库展示的路径看,上手可以先挑最轻量的任务:用 transformers 或 sentence-transformers 加载 2B 模型,先拿几十张图片和几段文字跑一个小的相似度匹配脚本。如果只是试水,你甚至不需要一上来就考虑 GPU 部署,先把输出和检索效果感受一下,再决定要不要接入实际业务。
有一点需要提前说清楚:这个模型目前不支持音频输入。“多模态”这个词在它这里覆盖的是文本、图片、视频和视觉文档,想用语音去搜视频的话,还得继续等后续版本。另外,它当前更适合做服务端离线向量化任务,而不是像 GPT 那样跟人实时聊天。这些版本细节,直接影响你对它的期待值。
我自己的判断是,这个项目把握住了一个真需求的方向:过去大家默认“搜索”就是把文本和标签匹配起来,而真实世界的信息本来就是多形态混在一起的。WeMM-Embedding 的价值,不在于某个评测分数有多高,而在于它让“视频、图片、文字互相找得到”这件事,从多套系统拼装,变成了一套模型可以干完。
如果你也有一个堆满图片和视频的烂摊子资料库,或者正准备搭一个能处理图文混排内容的知识库,不妨花点时间看看这个仓库。
它不一定能立刻解决你所有问题,但至少会给你一个新的念头:原来这些东西,可以放在同一个地方找。
持续分享优质 AI 开源项目与源码实战,一个人摸索很容易踩坑。
对 Agent、智能体感兴趣的朋友,无论新手还是大佬,都欢迎一起交流。私信「时之」拉你进群。
想拿到仓库地址,直接动手试试?
GITHUB: https://github.com/Tencent/WeMM-Embedding