ARTICLE · 985591
OpenMAIC v1.0 源码拆解|课程构建 Agent 如何工作
做一节“浏览器如何执行 JavaScript”的在线课,没有那么容易。它比制作一份讲解型 PPT 复杂得多,不仅要把调用栈和事件循环讲清楚,还要让学习者亲手修改代码,观察运行状态怎样变化。
讲解之后需要安排测验和反馈。学习者答错时,可以回到刚才的运行过程,重新检查自己的判断。课程最后再用一个小项目收束,让学习者自己做出事件循环的可视化。Slides、交互实验、测验和项目还要前后衔接,围绕同一个学习目标展开。
此时,开发者面对的是一个小型学习应用,里面有内容模型、交互运行时、学习状态和反馈逻辑。每多一种学习活动,组合数量都会增加。
我把 OpenMAIC v1.0 的发布记录、v1.0.0 tag 和几条主要调用链对了一遍。OpenMAIC 仍然生成 Slides、Quiz、Interactive HTML 和 PBL。v1.0 在经典生成器之外增加了 Pro 工作台,把这个新入口的课程制作编排交给一个能持续工作的 Agent。它会读材料、选择教学方法、创建课程、逐页生成,还能回来修改某个元素。
官方把这套新入口称为 Agent workbench。按职责看,它是一个课程构建 Agent。它通过一组受约束的课程工具读取 Stage、调用生成器、修改 Scene,并验证保存后的结果。
v1.0 如何支持持续的课程构建
OpenMAIC 原来的经典模式很直接。用户输入主题或上传文档,系统先生成大纲,再根据大纲生成每个场景的内容,随后生成讲解动作并交给播放器。这个流程适合“一次提交,整课生成”。
固定流程也有很清楚的边界。用户想在生成到一半时改变方向,系统需要给这种变化单独留入口。用户想把第三页换成交互模拟、把第六页改成费曼练习、沿用某个 PPT 的视觉风格,每一种需求都会继续增加状态和分支。
v1.0 加入的 Pro 工作台把交互改成了对话。用户可以先说目标,随后补充材料,也可以在课程已经生成以后要求 Agent 重做一页。与这个入口一起出现的,还有几项支撑长任务的改动。
制作者可以在同一会话里先搭课程结构,等内容成形以后再逐页调整,不需要为每一种修改重新设计入口。
Agent session 保存到服务端。运行进程会从数据库领取任务,靠 lease 协调执行权。浏览器断开不会结束生成,服务重启后也能根据 transcript 判断从哪里继续。用户可以取消任务,等 Agent 提问以后补充选择,还能用下一条消息调整原来的要求。
材料也进入了会话。文档、音频和视频先进入素材系统,抽取后的内容带着来源关系保存。Agent 可以列出材料、搜索文字、读取片段,也能访问已经通过 URL 信任检查的网页。它不必把一整份长文塞进一次 prompt。
课程能力被整理成工具。创建课堂、生成页面、读取 Stage、打补丁、生成图片、导入 PPTX、设置课堂角色,Agent 看到的是一组带参数约束的操作。模型、媒体、搜索和存储后端则由服务端配置选择。工具返回结果时会尽量抹去具体供应商身份,Agent 依赖的是能力,不需要按某家模型写一套课程逻辑。
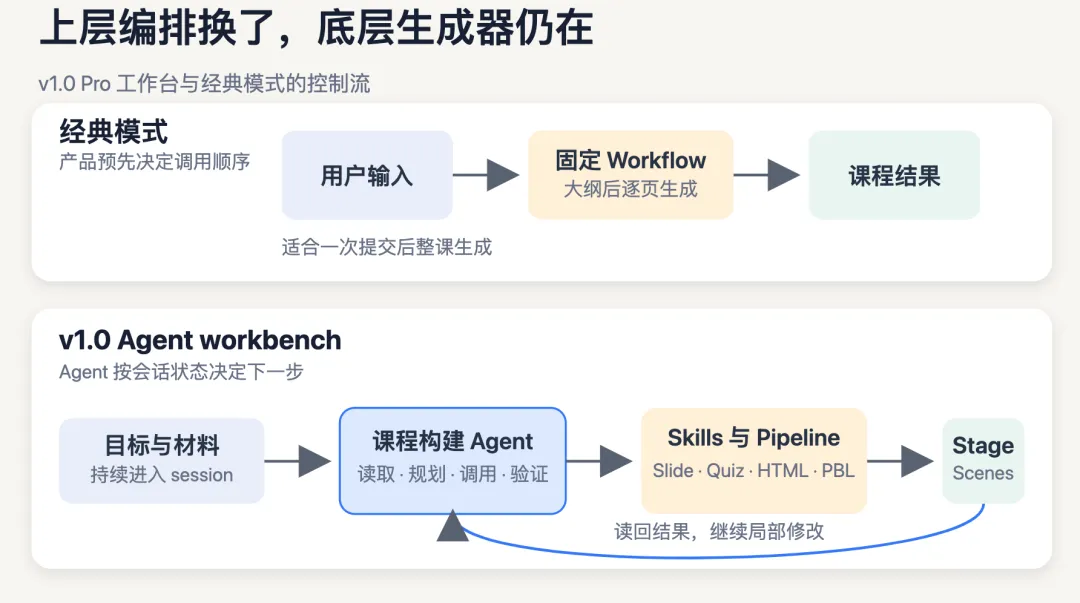
v1.0 保留了底层 workflow。@openmaic/generation 继续负责大纲、Scene 内容和 Actions 生成。Slide、Quiz、Interactive、PBL 也继续使用各自的 prompt 和后处理。
在 Pro 工作台里,上层编排换了执行者。经典模式仍由产品页面预先决定调用顺序,Pro 工作台则由课程构建 Agent 根据任务安排下一步。确定性强、边界清楚的工作留在 pipeline 和纯函数里,Agent loop 负责理解上下文、选择方法和处理修改。
OpenMAIC 用结构化文档、参数校验和生成器划定工作范围,Agent 在这些范围内安排下一步。
课程构建 Agent 怎样操作并恢复课程
OpenMAIC 把一整节课堂保存在 Stage 文档中,其中每个 Scene 对应一页内容。Agent 先用 read_stage 查看文档树和目标 Scene 的源码级数据,再调用 patch_stage,通过 JSON Pointer 修改指定字段。局部替换长 HTML 时还可以使用 str_replace,减少整页重写。
这套流程遵循先读取、局部修改、再读回验证的顺序,工作方式常见于 Coding Agent。OpenMAIC 将它限定在课程领域。原生 read 主要读取 skill 资源,课程工具白名单操作课堂、页面、素材与角色。它的工具范围不包括通用文件系统、终端和构建测试工具。
stage-dsl 和 slide-dsl 两个 skill 承担接口手册的作用,告诉 Agent 不同内容对应的文档路径和合法字段。
工具层还处理了一类很现实的问题。模型经常在同一轮里并行发出多个工具调用。若几个调用都执行“读整页、在内存修改、写回整页”,它们可能读到同一个旧版本,最后提交的调用会把前面的修改盖掉。OpenMAIC 把文档写工具标成顺序执行。一次混合了读写的调用批次会牺牲部分并行速度,换来提交顺序清楚的结果。
每个涉及 Stage 的工具也经过 owner scope 检查。owner ID 来自当前持久化会话,不出现在模型可填写的参数中。Agent 可以声明 stageId,无法伪造另一个 owner。生成式应用把工具开放给模型以后,这类边界比 prompt 里的“请勿访问别人的数据”可靠得多。
Agent 方案带来的好处很具体。
课程创建和后续修改共用一套文档接口。用户改变目标时,Agent 可以读取现有结果继续做,不必从大纲重新生成。导入、克隆和风格复用也变成工具组合,新能力加入以后,工作台无需再增加一条完整的产品流程。
长任务还有了恢复能力。对话、工具调用、工具结果和检查点都进入持久记录。进程异常退出后,runner 会修复缺失的 tool result,判断已完成、可继续或正在等待用户。客户端连接从执行生命周期里被拿掉,课程生成终于可以比一个 HTTP 请求活得更久。
代价也摆在代码里。Agent 的路径具有不确定性,延迟和 token 消耗更难预测。Skill 可能互相冲突,模型也可能挑错工具。OpenMAIC 通过工具白名单、超时、取消栅栏、顺序写和结构检查,把可变部分限制在系统能处理的范围内。
Agent 怎样连接模型、素材与存储
OpenMAIC v1.0 所说的统一方案,统一的是 Agent 面对的文档和工具协议。部署者仍可以选择不同的语言模型、图片模型、视频服务、搜索引擎和存储后端。服务端先检查当前环境具备哪些能力,再决定向 Agent 注册哪些工具。没有配置视频服务时,generate_video 不会出现在工具列表里。模型因而不会拿到一个注定报错的按钮。
这比在 prompt 里列一串可用供应商稳妥。Agent 只需要理解“生成一段视频”,适配器再把请求交给具体服务。供应商返回的任务 ID、轮询状态和媒体地址会被整理成中性的工具结果。以后替换模型时,课程 skill 和 Agent 的决策方式可以继续使用。
素材也采用引用传递。上传的文件先进入 asset pool,课程文档保存 asset reference,真正的字节由统一 resolver 读取。图片生成、文档抽取、课堂播放和离线导出围绕同一份引用工作。v1.0 还记录派生素材的来源关系和抽取缓存,同一份文档不必在每轮 Agent 对话里重新解析。
长任务中的大文件和媒体由素材系统处理。Agent 读取材料 ID、可检索文字和经过授权的媒体引用,存储层负责字节、配额与访问范围。会话一旦由存储层删除,相应 URL 权限也会撤销。
Stage 文档和 Agent transcript 同样分开保存。Stage 是可以被课堂播放器和编辑器长期使用的作品,transcript 记录制作过程。播放器和编辑器读取 Stage 时无需重放整段对话。进程恢复时,runner 依靠 transcript 和检查点判断工具是否执行过,不需要从 Stage 的最终样子反推当时发生了什么。
对创业团队来说,这种统一会降低替换成本,也会增加早期工程量。先定义引用、权限和工具结果,速度一定比直接把模型输出写进数据库慢。等产品需要接第二家模型、处理第二种媒体,或者让一次生成跨越几十分钟,这笔投入才开始回报。
v1.0 的 Skills 如何参与课程构建
README 写的是 20 built-in skills。v1.0.0 tag 里的 skills/agent-runtime 实际包含 22 个目录。讨论 v1.0 时,用“20+”很合适。逐项核对源码时,则应当按 22 个计算,完整清单放在文末附录。
OpenMAIC 的 skill 同时影响 Agent 的计划、工具使用和生成后的结构检查。它有两类模型可见作用,外加一道程序检查。
第一步由外层 Agent 读取。每个 skill 的 SKILL.md 写明适用条件、课程方法和工具顺序。系统 prompt 只列出名称、描述和路径。匹配到任务以后,Agent 再用 read 加载正文,没用到的 skill 不占上下文。
第二步仍由外层 Agent 执行。v1.0 的 Agent workbench 没有单独的 outline tool。Agent 在对话里规划页面,再把标题、类型和 brief 交给 generate_scene。已经读取的教学方法会影响这份页面计划和工具选择。
页面保存以后,程序再做第三步。部分 skill 带有 outline-constraints.json,可以限制 Scene 数量、类型比例、第一种页面类型和必须出现的 widget。检查对象是当前已经持久化的 Scenes。违规项会进入工具结果,供 Agent 继续修正,原页面不会自动回滚。
这套结构把自然语言、工具和机器约束放在一起。自然语言承载难以枚举的教学方法,工具负责改变系统状态。机器约束再检查最低结构要求,让违规结果可以回到 Agent 继续修正。
四种 Scene 共用一份课堂文档
OpenMAIC 的四类内容看起来差别很大。Slides 是画布,Quiz 是表单,Interactive 是网页,PBL 已经接近一个任务应用。它们都被放进同一个 Scene 联合类型。
export type SceneType =| 'slide'| 'quiz'| 'interactive'| 'pbl';
每个 Scene 还带一组 Actions。Content 决定页面里有什么,Actions 决定课堂播放时发生什么。教师何时说话、聚光哪个元素、白板写什么、交互页面切换到什么状态,都能沿着时间线执行。
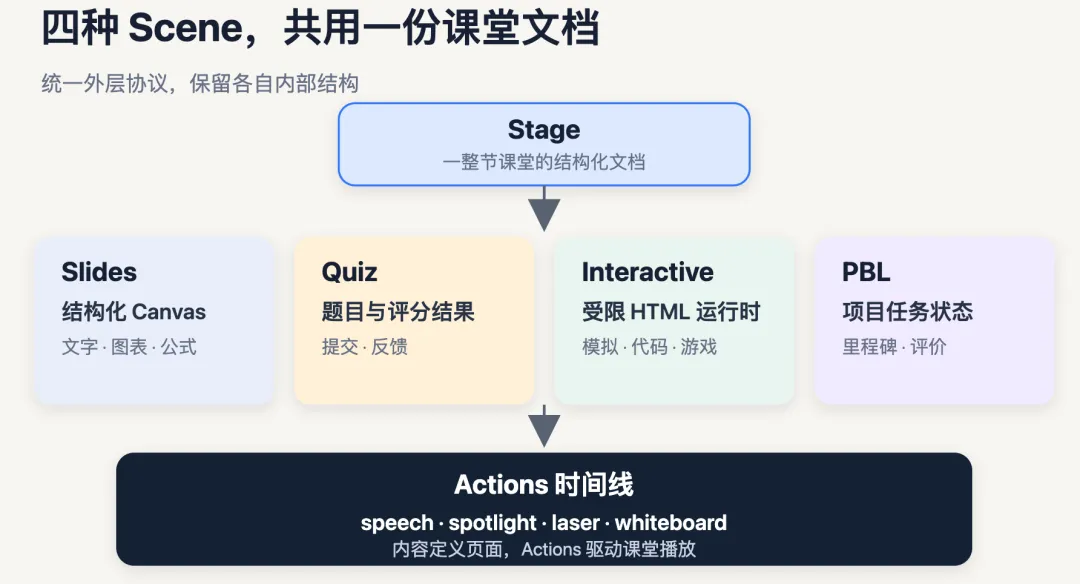
四类内容进入同一棵文档树,同时保留各自的数据结构。播放器可以按相同顺序切页,Agent 可以沿这棵树读取和修改,持久化与导出也有了共同入口。
Slides 保留可编辑结构
Slide Content 保存的是结构化 Canvas。文本、图片、形状、线条、图表、表格、公式和视频都有各自字段。生成器产出元素,renderer 把它们画出来,editor 继续操作同一份数据。导出 PPTX 时也能按元素转换,文字和图形仍可编辑。
结构化 Canvas 支持课程制作里最常见的后续动作。用户可以改标题、挪图片和替换图表数据,也可以要求 Agent 只修第三页的两行字。页面保留结构以后,每次修改都有可靠目标。
Actions 通过 element ID 连接讲解与页面。spotlight 会压暗其他内容,laser 指向元素,speech 播放讲解,白板动作则在独立画布上写字、画图和公式。同一份 Action 协议既供在线播放,也供离线回放和视频导出使用。
Quiz 把反馈接入学习过程
Quiz Content 保存题型、题干、选项、答案和分值。单选、多选这类客观题可以在客户端按标准答案评分。简答题没有稳定的字符串比较方式,前端会调用 /api/quiz-grade,让 LLM 按题目、学生答案、满分和可选评分要点评分。
接口会把模型返回的分数限制在合法范围,再取整。若返回内容无法解析,当前实现会给出一半分数和通用评语。这个 fallback 能让流程继续,也会引入教育测量上的问题。一次无法解析的模型输出与学生真正获得一半分,在数据里会得到相同成绩。严肃测评需要把“无法评分”单独建模,避免把输出异常写进学习者能力。
评分结果会持久保存。学习者离开页面再回来,仍能看到已提交状态和反馈。课堂对话 Agent 读取当前 Scene 时也能拿到结果,PBL 在首次打开项目时还可以把此前 Quiz 的正确率加入 proficiency assessment。测验结果由此继续参与后续教学。
Interactive HTML 运行在受限 iframe 里
Interactive Content 的数据契约很小。
type InteractiveContent = {type: 'interactive';html?: string;url?: string;widgetType?: WidgetType;widgetConfig?: WidgetConfigBase;};
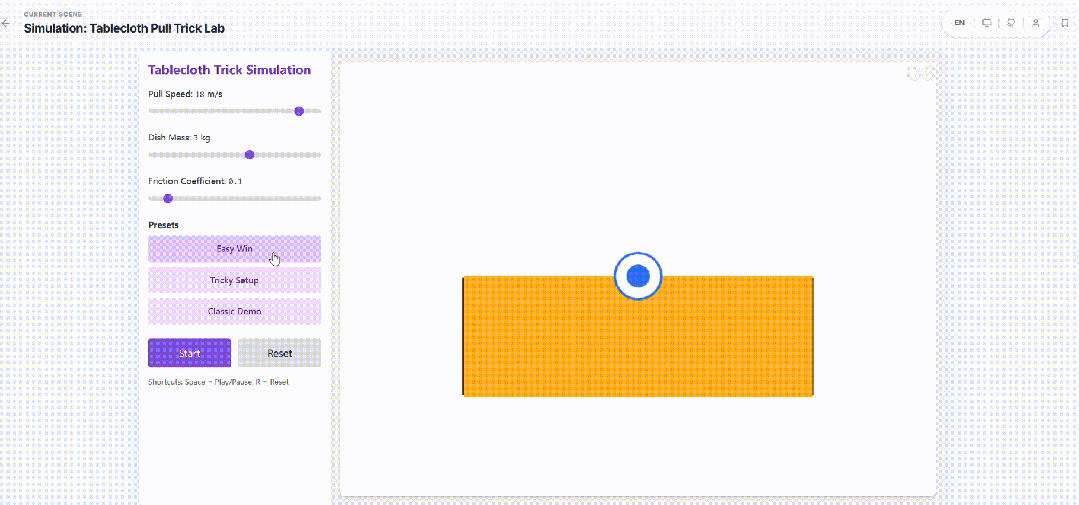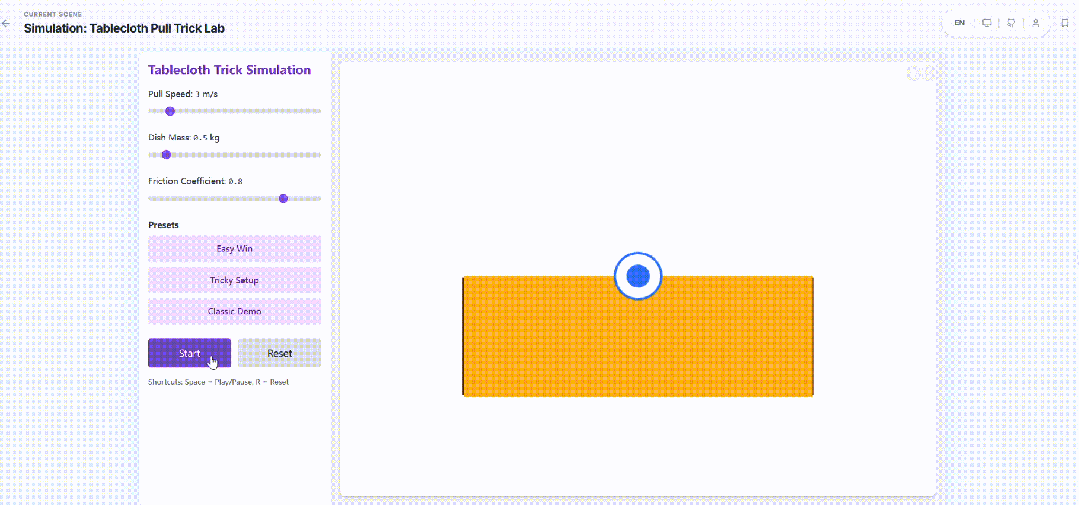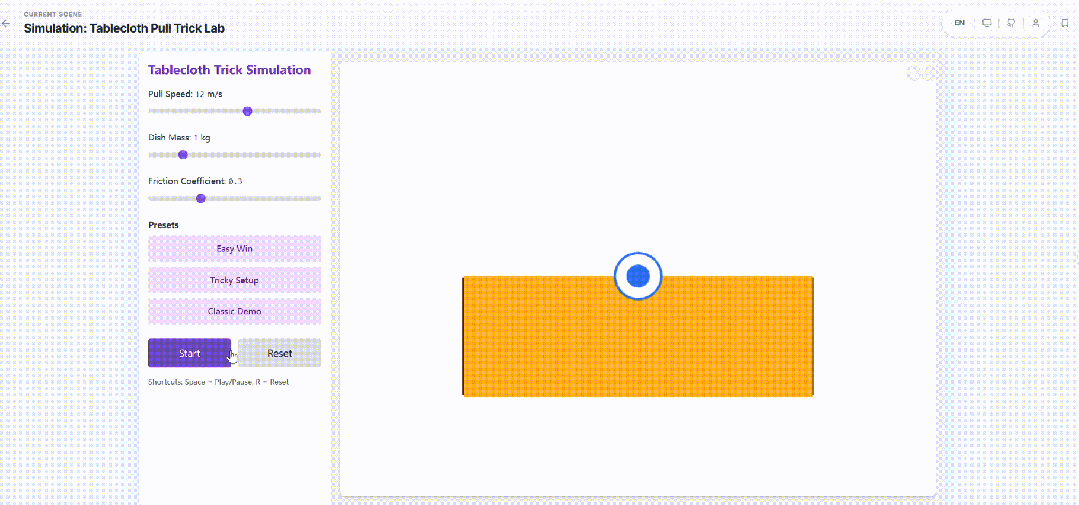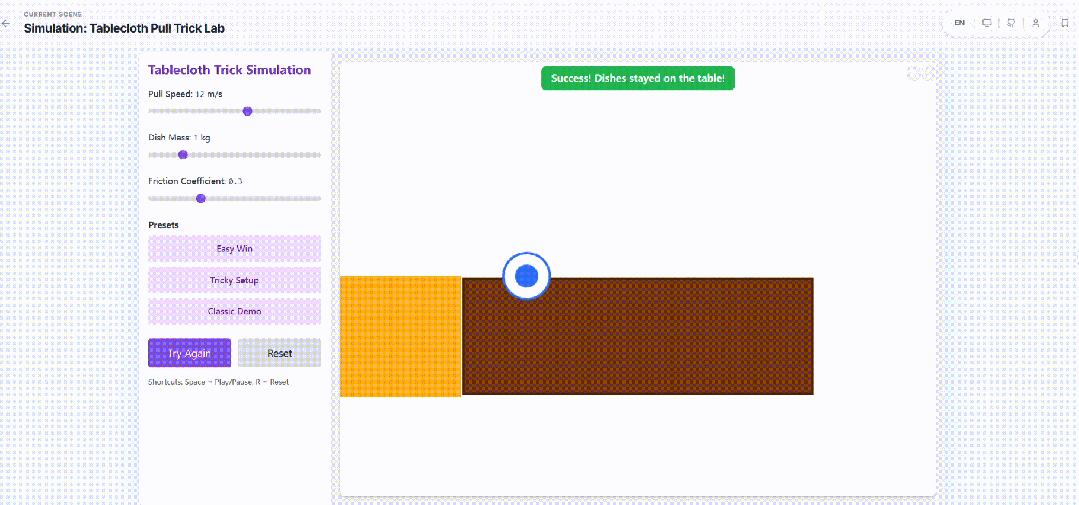
widgetType 目前包括 simulation、diagram、code、game、visualization3d 和 procedural-skill。模型根据类型生成一个完整 HTML 文档。simulation 可以是物理实验,code 可以带编辑器与运行结果,visualization3d 可以用 Three.js,procedural-skill 则更像带步骤和状态判断的操作训练。
模型响应先经过 extractHtml,从完整文档或 markdown 代码围栏里取出 HTML。生成阶段的 postProcessInteractiveHtml 负责转换 LaTeX 分隔符并注入 KaTeX 资源。真正渲染时,patchHtmlForIframe 才加入错误捕获、元素选择器、内存存储兼容层以及尺寸和滚动样式。处理后的文档随后进入 iframe.srcDoc。
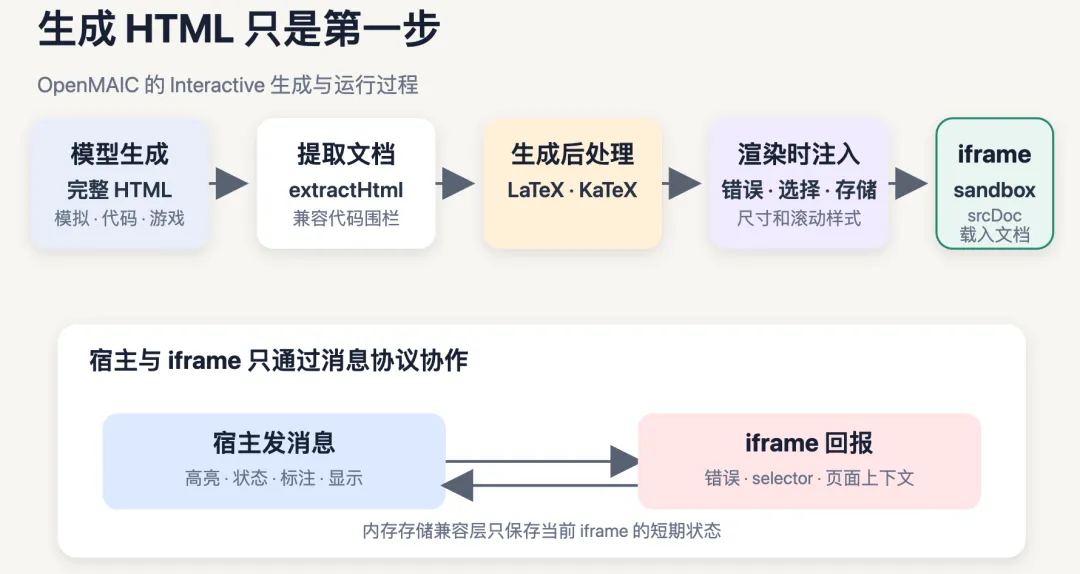
iframe 的 sandbox 允许脚本、表单和弹窗,没有开放 allow-same-origin。这使生成页面处在独立的 null origin,脚本无法读取宿主应用的 cookie、localStorage 和 DOM。代价是 iframe 也不能直接使用正常的持久化存储,storage shim 会在页面内部提供一份内存实现,避免访问存储时抛出 SecurityError。
这份 shim 只在当前 iframe 的生命周期里有效。HTML 内容更新、LRU 淘汰或切换课堂都可能让其中的数据消失。学习进度若要跨页面和跨设备保存,仍需由宿主协议和 RuntimeStore 承担。keep-alive 保存的是短期交互现场,不能替代持久化学习状态。
宿主和 iframe 通过 postMessage 通信。Action Engine 遇到 widget_highlight、widget_setState、widget_annotation 或 widget_reveal,会把消息送到当前 Scene 的 iframe。生成页面按约定监听消息,更新高亮、状态和可见内容。AI 教师便能一边讲解,一边操作学习者眼前的模拟器。
落到开头那节事件循环课,Interactive HTML 可以把调用栈、Web APIs 和任务队列画成几个独立区域。页面自己的脚本控制代码执行到哪一步,Action 时间线再用 widget_setState 切换示例,用 widget_highlight 指向当前栈帧。OpenMAIC 提供消息协议和运行边界,事件循环的状态机仍由这张 Interactive 页面实现。
选择页面元素也走同一条通道。编辑器开启选择模式以后,注入脚本为可交互元素计算尽量唯一的 CSS selector,把 selector、文本和截断后的 outerHTML 发给父页面。用户在聊天里引用这个元素,Agent 下一轮就能定位相应 HTML。对生成式 UI 来说,这比让用户描述“右边那个蓝色滑块”可靠许多。
运行错误也会发回父页面。注入脚本监听 window.onerror 和未处理的 Promise rejection,先缓存,再响应宿主的 replay 请求。这样可以抓到 React effect 注册监听器以前就发生的初始化错误。Agent 修完 HTML 后,内容变化会重载 iframe,并清掉上一版本的错误记录。
OpenMAIC 还维护了一个 iframe keep-alive pool。学习者切换 Scene 或进入编辑模式时,iframe 只改变显示状态,不马上销毁。模拟器里的临时状态和 DOM 得以保留。只有 HTML 内容改变时才重新加载。池子配合 LRU 控制数量,避免一节长课把所有页面永远留在内存里。
这套实现给 HTML Interactive 开发者提供了清楚的运行边界。模型生成的网页按不可信插件处理,宿主提供有限协议,页面在沙箱里运行。错误、元素引用和状态变化都通过协议回传。完整的生成式 HTML 产品还需要处理运行隔离、错误回传和精确修改。
PBL 用项目状态管理学习任务
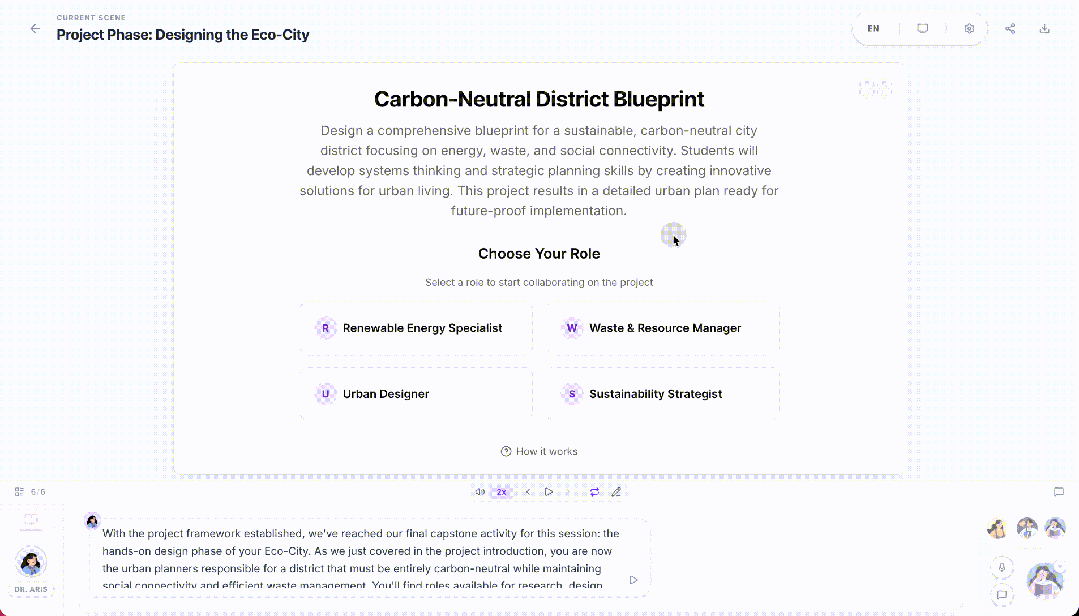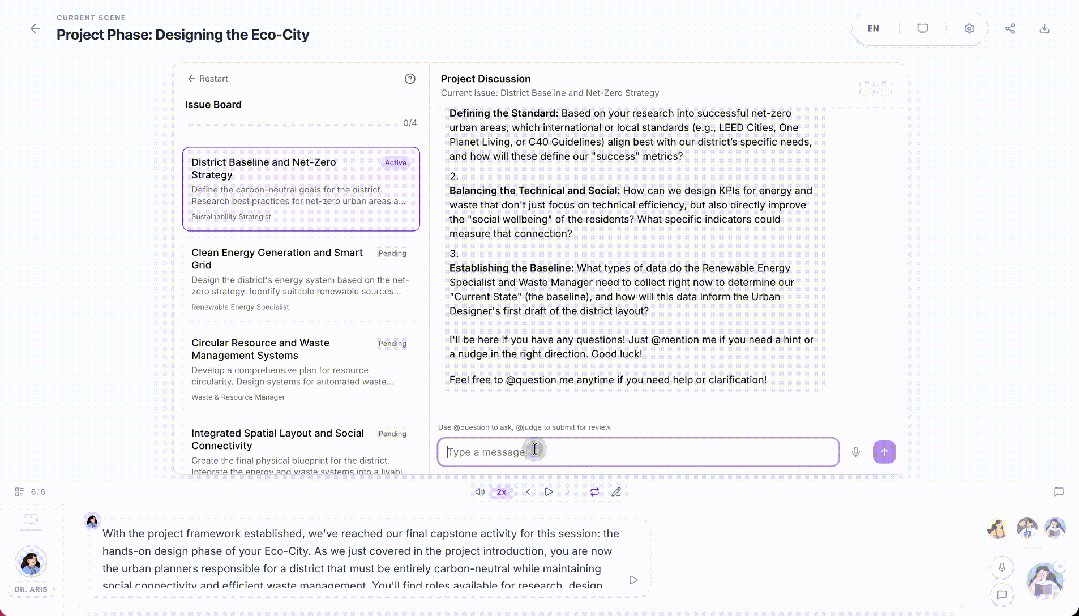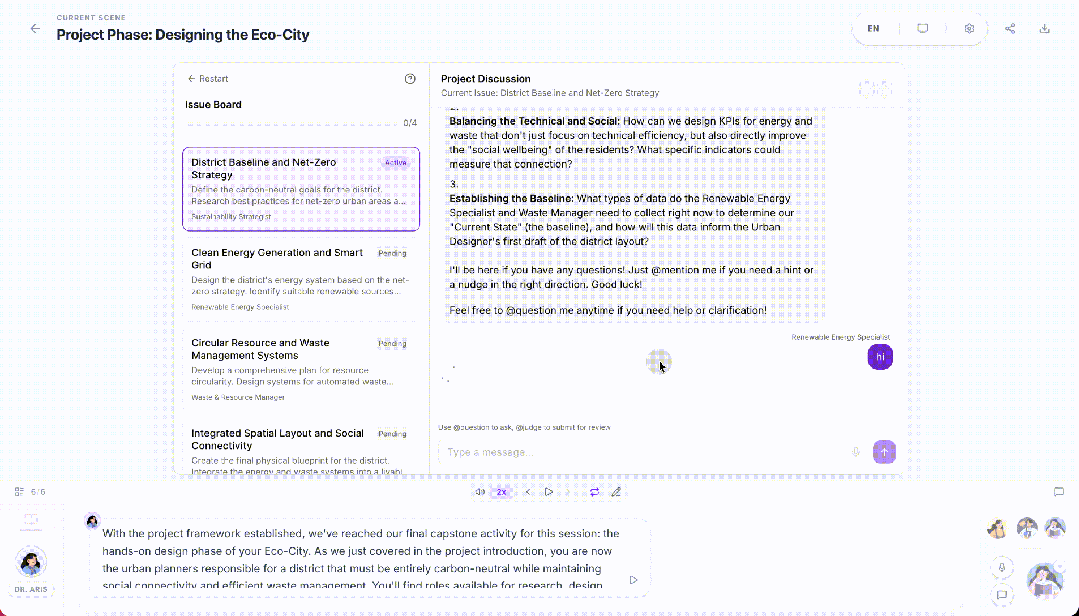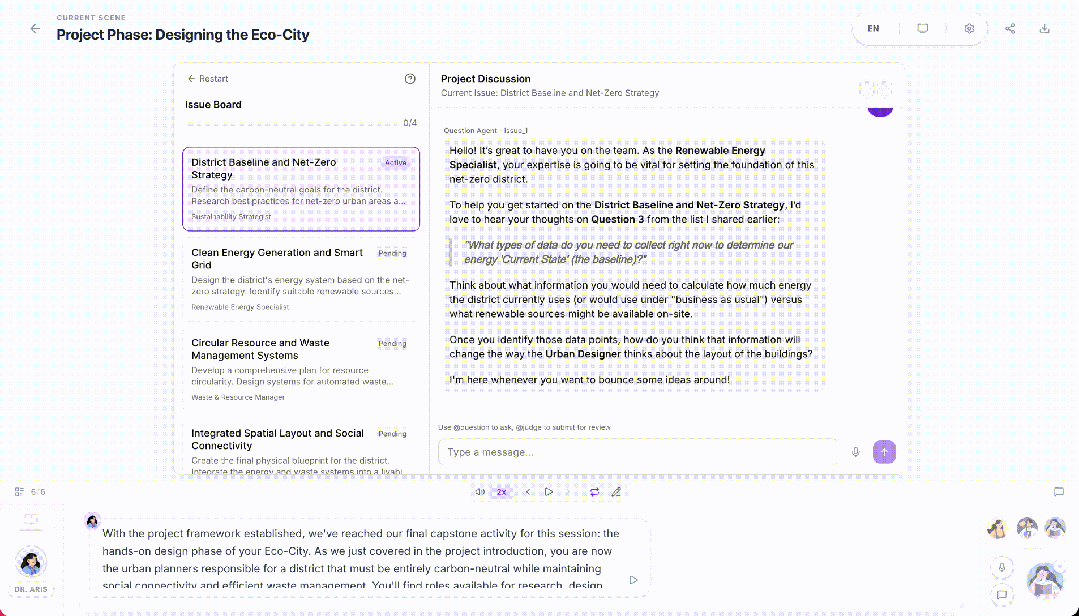
PBL v2 的数据量明显更大。一个 Project 包含角色、milestones、microtasks、documents、submissions、evaluations、threads 和 engagement events。每个 milestone 有完成条件,microtask 还能写 successWhen、能力目标和学习者任务说明。
Planner 先生成这棵项目结构。当前主路径采用一次 LLM 调用产出完整方案,程序随后检查标题、目标、角色、里程碑和微任务是否齐全。场景型项目还要满足准备、角色扮演和总结阶段的骨架。如果单次输出没有通过 JSON 解析或结构校验,调用方可以退回 tool-calling planner。供应商请求失败或用户取消时不会再走这条 fallback,避免用同一服务重复一次注定失败的请求。
运行阶段目前以 Instructor 为主要交互角色,负责开场、任务引导和动态调节。Evaluator 在提交、里程碑和项目结束时独立生成评价,不作为普通聊天角色持续陪伴。场景型项目还会调用 Simulator 扮演情境人物。
DSL 类型定义里仍能看到 Mentor 与 Collaborator,当前 Planner 不会把它们加入新项目。接口用 SSE 流式返回事件,客户端把消息、评价和状态补丁应用到当前 Project。
PBL 对“完成”管得很严。一项任务有 completion criteria,milestone 还可能要求 synthesis check。程序根据提交与评价事件决定能否推进,模型给出的正面评价不会直接改变完成状态。角色扮演项目在阶段交接时还会出现 handover,等学习者确认以后才打开下一阶段。
proficiency.ts 用纯代码计算学习者水平,输入包括自报水平、此前 Quiz 正确率、提交得分和概念困惑,每种信号都有权重上限。单次满分测验通常只能把水平推到 intermediate,进入 advanced 需要多种强信号相互支持。LLM 负责观察和生成反馈,等级换算留给可测试的规则。
Project 定义与学习者运行状态也逐步分开。课程文档保存项目设计,RuntimeStore 用 session 和 append-only record 保存个人进度。多人学习、跨设备恢复和学习分析都需要这个分离。把所有状态继续写回课程 JSON,一名学生的操作就可能污染其他人的原始课程。
这些功能怎样影响学习过程
OpenMAIC 目前的源码能证明它支持多种学习活动,无法单独证明学习效率提高了多少。这个界线应当保留。功能丰富和学习有效是两件需要分别验证的事。
它提供的机制有清楚的教学用途。Slides 适合建立解释路径,学习者先拿到必要概念。Interactive HTML 可以让学习者操纵参数、做出判断并看见系统响应。一项纳入 225 项 STEM 研究的元分析发现,主动学习整体上提高了考试和概念测验表现,也降低了课程不及格率。这个结果支持的是要求学习者行动、判断并获得反馈的教学设计,不能用来证明任意一个可点击网页都会有效。
Quiz 对应的是提取练习。学习者需要从记忆中找回答案,系统再给出反馈。Roediger 和 Karpicke 对 testing effect 的综述指出,与重复阅读相比,测试通常能改善延迟保持。OpenMAIC 已经具备提交、评分和反馈流程,真正的效果仍取决于题目质量、反馈时机和后续教学是否使用这些结果。
PBL 把知识放进有完成条件的任务,学习者需要提交作品、接受评价并继续修订。2026 年一篇汇总 15 项元分析的综述认为,项目式学习的结果整体呈正向,效应大小仍有不确定性,纳入的元分析按 AMSTAR 2 评价均为极低质量。这提醒开发者保留里程碑、评价标准和过程数据,同时把成效当作需要持续验证的假设。
四类 Scene 放在同一节课里,最大的价值来自衔接。课程制作者可以在 Stage 里安排活动顺序,学习者状态则由 RuntimeStore 保存并显式传递。Quiz 正确率进入 PBL 时,客户端先读取此前的答题记录,再把 snapshot 随打开项目的请求交给服务端。教师 Action 操作模拟器时也要经过消息协议。课程能否真正衔接,取决于共享的内容结构和明确的运行时协议。
Skills 则把教学方法放到课程生成以前。feynman-learning 要求学习者先解释,spiral-curriculum 让核心概念多次返回,understanding-by-design 从最终表现倒推学习证据。它们决定页面为何出现、何时出现,作用落在课程结构和学习活动安排上。
若要严肃验证效率,可以比较延迟测验、迁移任务表现和完成时间。互动过程还可以记录错误修正次数、提示使用和中途退出位置。OpenMAIC 已经有 RuntimeStore 与事件模型,具备收集这类数据的技术条件。公开材料里还没有一组足以支撑效果结论的实验数据,文章写到这里应当停住。
OpenMAIC 对 HTML Interactive 创业者的启发
Quiz 的半分 fallback 给出了一个很具体的产品决策。模型返回无法解析时,系统会给出一半分数和通用评语,让课堂可以继续。这项处理提高了流程可用性,也会把模型输出异常写进学习数据。创业团队设计 fallback 时,需要明确它保护的对象,并把无法评分作为独立状态保存。
先区分稳定身份和临时定位。OpenMAIC 的 Slide 用 element ID 指向画布元素,PBL 用 milestone ID 和 microtask ID 标识任务。Interactive 的 CSS selector 由元素选择器在运行时计算,HTML 重新生成以后可能失效。需要长期局部编辑的产品,应当给关键节点增加稳定 ID,并记录它对应的内容版本。
接着给生成 HTML 划清运行边界。sandbox、postMessage、错误回传和存储 shim 共同决定模型生成的页面如何安全运行。产品还需要配合 URL、网络与内容策略审查,允许弹窗和表单时尤其如此。第三方脚本也会影响离线导出和长期可复现性。
运行边界建立以后,还要让 Agent 看见结果。工具返回持久化后的 Scene,iframe 报告运行错误,元素选择器在当前 HTML 版本里提供可操作目标。这些反馈让 Agent 能够根据页面结构和运行状态继续修复。
Skill 也要能约束行动。一个可复用 skill 应当告诉 Agent 何时使用和怎样调用工具,关键结构再由程序检查。这样的 skill 更容易跟随工具接口和版本变化持续维护。
课程制作本身是一段反复修改的工作。用户会带着旧 PPT、教师录像和一堆材料进来,也会在生成以后改内容。v1.0 把导入、生成、编辑和复用放进同一 Agent session,让课程制作者可以在同一个入口里持续工作。
OpenMAIC v1.0 仍有不少难题。自由编排会增加成本,生成 HTML 的质量会随模型波动,PBL 的体验依赖评价 prompt 和状态规则,22 个 skills 也需要处理组合冲突。这些问题还需要产品数据和持续的工程改进来回答。
最后,欢迎大家下载使用 v1.0,它算的上是一个很大的里程碑。
附录 v1.0 内置的 22 个 Skills
课程规划和教学方法
curriculum-planner把多节课堂组织成系列课 stage-design规划一节完整课堂的页面顺序与生成步骤 understanding-by-design从可迁移理解和学习证据倒推课程 spiral-curriculum让核心概念在多阶段中反复出现并逐步加深 feynman-learning让学习者先解释,再暴露缺口并重建解释 learning-to-learn把元认知和学习策略加入课程 social-emotional-learning把社会情感学习目标并入课程 k12-core-literacy-planning按中国中小学核心素养设计课程 vocational围绕真实工作任务、工具状态和安全判断组织实训
课程形态
lecture-style生成连续讲授、低频检查的大师课 workshop-style生成练习密集、边做边学的工作坊 deep-interactive让多数页面都包含可操作的机制或任务
编辑和数据结构
pro-editing修改已经存在的课程 slide-craft提供版式、字号、间距和元素选择规则 slide-dsl说明 Slide Canvas 的字段和合法值 stage-dsl说明 Stage、Scene、Action 和各类内容路径
导入和复用
page-clone复制一页现有布局并逐项改写 style-clone把导入的 deck 当作版式样本制作新课 teacher-style-clone从教师录像或讲义提取讲授方式 pptx-import保留版式导入 PPTX 并修复页面
调研和经验整理
deep-research对依赖外部事实的课程先检索和核验 build-personal-skill从用户过去的课程和聊天记录中生成个人 skill