ARTICLE · 989021
美团8月29日机考笔试题与解析
写在前面
本次给大家带来2026年8月29日美团笔试题的3道题,本场机考题目可在咱们平台上在线刷题。
第一题:电商搜索排序优化(AI Coding)
第二题:核心是利用 ,当 时枚举 的所有约数 ,再用恒等式 ,把原问题转化为“ 区间内 的倍数个数”求和;当 时直接计算等差数列和即可。
第三题:选择题
大厂笔试AI Coding练习:CodeFun2000.com/aicoder-gym
第1题-电商搜索排序优化
题目内容
给定搜索词与候选商品,为每个 query 下的商品输出排序分数,用于提升 NDCG@10。输入为不含 relevance 的 CSV,含查询、商品特征及 row_id;输出至少包含 row_id 和 rank_score,必须逐行对齐。训练数据约 43 万行,验证约 8 千行,relevance 为 0-3 有序类别。可使用 xgboost、lightgbm、catboost 等库,需在 30 秒内完成训练与预测,固定随机种子,禁止联网。分数越大同一 query 内排序越靠前。
做题步骤安排
先读题,看清 schema。 别急着建模。读
data/SCHEMA.md,把字段分为 query 侧、商品侧、统计侧,确认query_id分组和relevance标签。用 pandas 在本地统计缺失和分布,把摘要发给 AI,避免大文件进入上下文。搭基线,跑通链路。 先写最简单的 rank_score,比如商品历史平均 relevance 或 query 内热度,确保
main.py输入输出格式、row_id对齐正确。运行样例脚本,自己实现或调用sklearn.metrics.ndcg_score在 valid 上算分,记录 baseline。做特征,抓匹配信号。 排序核心是 query 与商品的匹配度。构造:文本特征(query 与 title 的长度差、公共词数、关键词命中)、数值归一化、商品类目编码。再基于 train 统计商品历史点击率、平均 relevance、出现次数作为先验,缺失值用全局均值填充。注意:统计只能来自训练集,避免未来信息。
选模型,用 LambdaRank。 优先用 LightGBM 的
objective='lambdarank',传入 query 分组,直接优化排序。若效果不稳,可退化为回归(拟合 relevance)或分类(预测 0-3 概率)取分数。固定随机种子,迭代 200-400 轮,树深度 5-6,控制训练时间。也可用 XGBoost 的 rank 目标做对比。验证与自测。 在 valid.csv 上按 query 计算 NDCG@10,与 baseline 对比。若提升不大,检查排序 group 是否正确(
lambdarank需要 group 边界),或改用回归 score。主动测试缺失值、重复row_id、NaN、全分数相等、大 query 多候选等边界,确保程序稳健。交卷前 AI 自审。 给 AI 指令:“检查特征是否仅来自输入与训练集、group 是否按 query 划分、输出列名是否准确、随机种子是否固定、有无硬编码路径或联网调用、30 秒内能否运行。列出所有疑点。”发现问题定点修复;卡住时新开对话换思路,保留最高分版本。
第2题-区间最大公约数和
题目内容
运维侧做容量水位分析时,两条整型指标序列在偏移 处的读数分别为 与 。定义对齐公约
其中 表示最大公因数。例如 与 的正公约数有 ,故 。现要对连续偏移窗口做汇总:求
即 。结果可能很大,对 取模后写出。
输入描述
第一行一个整型 (),表示随后有 行询问。
接下来 行,每行四个整型 (,)。
请对每个询问逐一计算上述和模 。
输出描述
共写出 行。对每一个询问,写出一个非负整型,即该窗口公约和模 的结果。
样例1
输入
38 14 0 25 5 1 33 9 0 4输出
72113说明
三个询问依次为:;两路读数相同,和为 ;
。
样例2
输入
22 10 0 07 11 2 5输出
28说明
第一问窗口只有 ,。第二问 到 :。
题解
解题思路
本题考查数论恒等式 + 欧拉函数。直接枚举 不可行,因为 可达 。
利用 ,得到。记 。 若 ,则每一项都是 ,窗口和为等差数列,再取模。 若 ,令 、,问题变成求 。 再用 ,得到。 区间和用前缀相减。 ,可线性筛预处理 ,每次询问枚举 的约数即可。
常见假解:
循环累加每一项,在 很大时超时; 漏掉 ()时 ; 把求和区间写成 而不是 ; 前缀公式少算 或 位溢出; 忘记对 取模。
复杂度分析
设 ,询问条数为 ,单次约数个数为 。
时间复杂度:。 空间复杂度:,存放欧拉函数。
代码实现
python代码(C++和JAVA代码见在线OJ网址)
MOD = 1000000007MAXA = 100000phi = list(range(MAXA + 1))vis = [False] * (MAXA + 1)for i in range(2, MAXA + 1):ifnot vis[i]:for j in range(i, MAXA + 1, i): vis[j] = True phi[j] = phi[j] // i * (i - 1)defdivisors(d): out = [] t = 1while t * t <= d:if d % t == 0: out.append(t)if t * t != d: out.append(d // t) t += 1return outdefprefix(n, d):# 1 到 n 的 gcd(i, d) 之和if n <= 0:return0 s = 0for x in divisors(d): s = (s + phi[x] * (n // x)) % MODreturn sdefsolve(x, y, left, right): d = abs(y - x)if d == 0: cnt = right - left + 1return cnt % MOD * ((2 * x + left + right) % MOD) % MOD * pow(2, MOD - 2, MOD) % MOD lo = x + left hi = x + rightreturn (prefix(hi, d) - prefix(lo - 1, d)) % MODk = int(input())for _ in range(k): x, y, left, right = map(int, input().split()) print(solve(x, y, left, right))第3题-选择题
1、库房抽检一组标称重量为 的包装件,最近 个班次的班均重量是否与标称值有显著差异。单样本 检验的原假设为 ,备择假设为 。软件输出:,,, 置信区间 ,样本均值 。质检组可以得到什么结论?{{ select(1) }}
值大于 ,应拒绝原假设并认为班均重量与标称值不同 值小于 ,该批班均重量与标称值无显著差异 值大于 ,该批班均重量与标称值无显著差异 置信区间包含 ,因此应判定存在显著差异
2、把键序列 散列进一张下标从 开始的一维表。散列函数为 ,冲突用线性探测再散列,装填因子为 。等概率条件下,查找成功的平均查找长度是?{{ select(2) }}
3、关于大模型预训练目标,下列说法错误的是?{{ select(3) }}
T5 把多种任务统一成文本到文本,并用编码器-解码器结构来做 GPT 采用自回归目标,用当前 token 去预测它前面的那一个 token 多模态预训练里常用对比学习来拉近跨模态表示 BERT 的掩码语言模型会把一部分 token 随机替换成 MASK
4、分拣口抽了 件样品,真实档位依次为 ,模型预测为 。这次预测的 macro-F1 约为?{{ select(4) }}
5、一棵镜像对称二叉树的根结点为 。左子树先序遍历(不含根)为 ,右子树中序遍历(不含根)为 。该树的后序遍历序列是?{{ select(5) }}
6、巡检时序用 LSTM 单元处理传感器读数,单元结构如下图。该结构用了两种激活函数,它们的作用分别是?
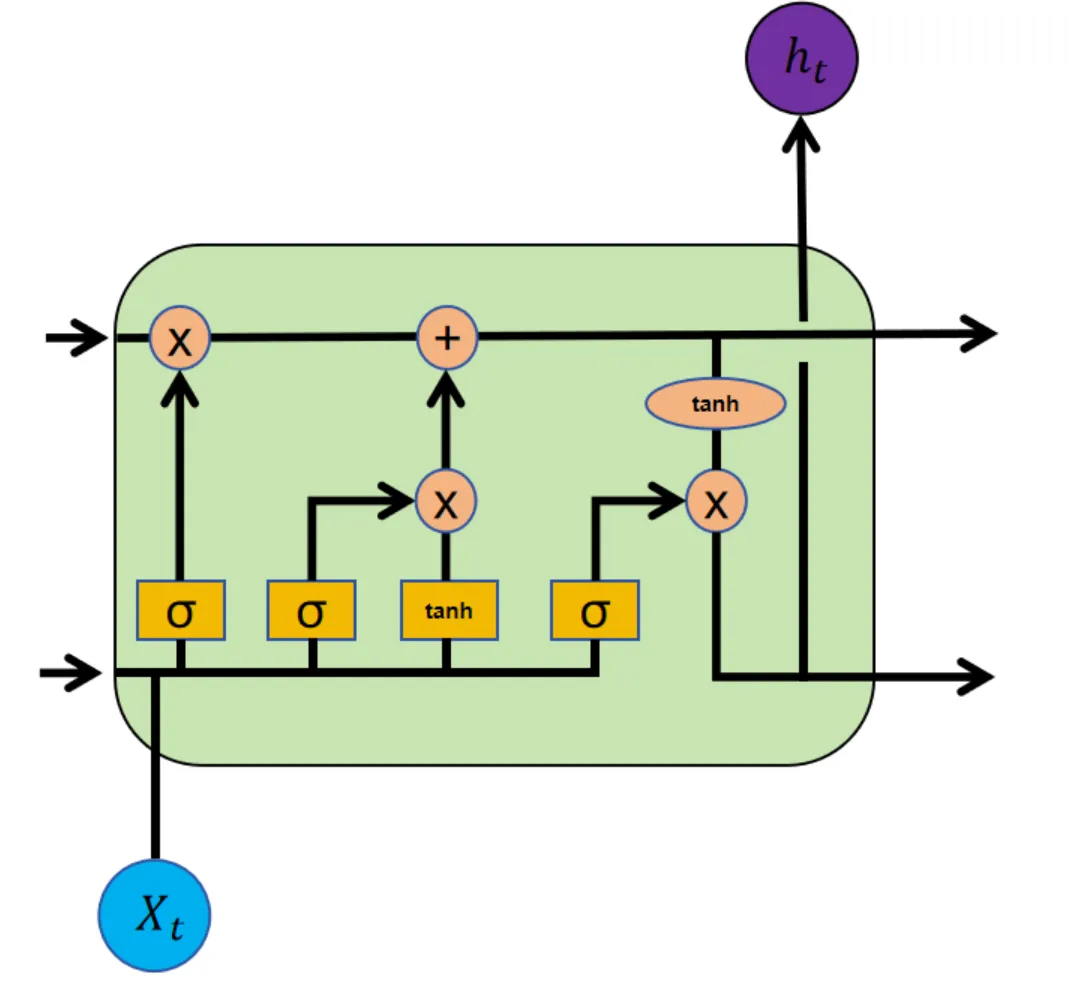
{{ select(6) }}
两种激活函数都只把隐状态裁到 ,与门控无关 Sigmoid 控制信息流的方向,tanh 用来缓解饱和带来的梯度消失 Sigmoid 产生 的值作为门控,tanh 在输出和状态上变换数据 Sigmoid 用来缓解饱和带来的梯度消失,tanh 控制信息流的方向
7、货架巡检要做视觉预训练,希望模型学到货位图像的语义而不是只记像素纹理。下列哪项预训练任务更有助于语义抽象?{{ select(7) }}
旋转预测 拼图重组 像素重建自编码器 对比学习
题解
答案+解析
1
答案:C
,不能拒绝 ,应认为班均重量与标称值无显著差异。置信区间也包含 ,同样不支持“有差异”。把 与 比反、或看到区间包含标称值却判成显著差异,都是错的。
2
答案:C
装填因子 、共 个键,表长为 。,,,,,。线性探测后探查次数为 ,成功查找平均长度为 。 相当于几乎无冲突; 与 都对不上这组探查次数。
3
答案:B
GPT 的自回归目标是预测下一个 token,不是当前 token 的前一个。T5 的文本到文本编码器-解码器、多模态对比学习、BERT 把部分 token 换成 MASK,都是对的,不能当“错误说法”。
4
答案:B
按类算 F1 再平均。:精确率 、召回 ,F1 为 ;:精确率 、召回 ,F1 为 ;:精确率 、召回 ,F1 为 。macro-F1 为 。其余小数是中间量没除对或用了微平均。
5
答案:C
镜像对称时,右子树中序 反转得到左子树中序 ,再配合左先序 可还原左子树,并镜像得到右子树。左子树后序为 ,右子树后序为 ,整树后序为 。把左先序直接拼到后序、左右后序写重或左右对调,都会得到另外三条序列。
6
答案:C
LSTM 里 Sigmoid 输出 ,用作遗忘门、输入门和输出门;tanh 用在候选状态和隐状态输出上,对数值做压缩。说成“只管方向”“只缓解梯度消失”、或把两种函数职责对调,都不符合该单元的用法。
7
答案:D
对比学习用同图不同视图拉近、不同图推远,更直接逼语义表示。旋转预测、拼图重组偏空间姿态;像素自编码器主要重建低层纹理,对语义抽象都弱于对比学习。