ARTICLE · 989025
Skill Seekers:把任何文档变成 AI 技能的开源神器
一个命令,把 Django 文档、GitHub 仓库、PDF 甚至是 B 站视频,变成 Claude 和 Cursor 能直接用的技能包。
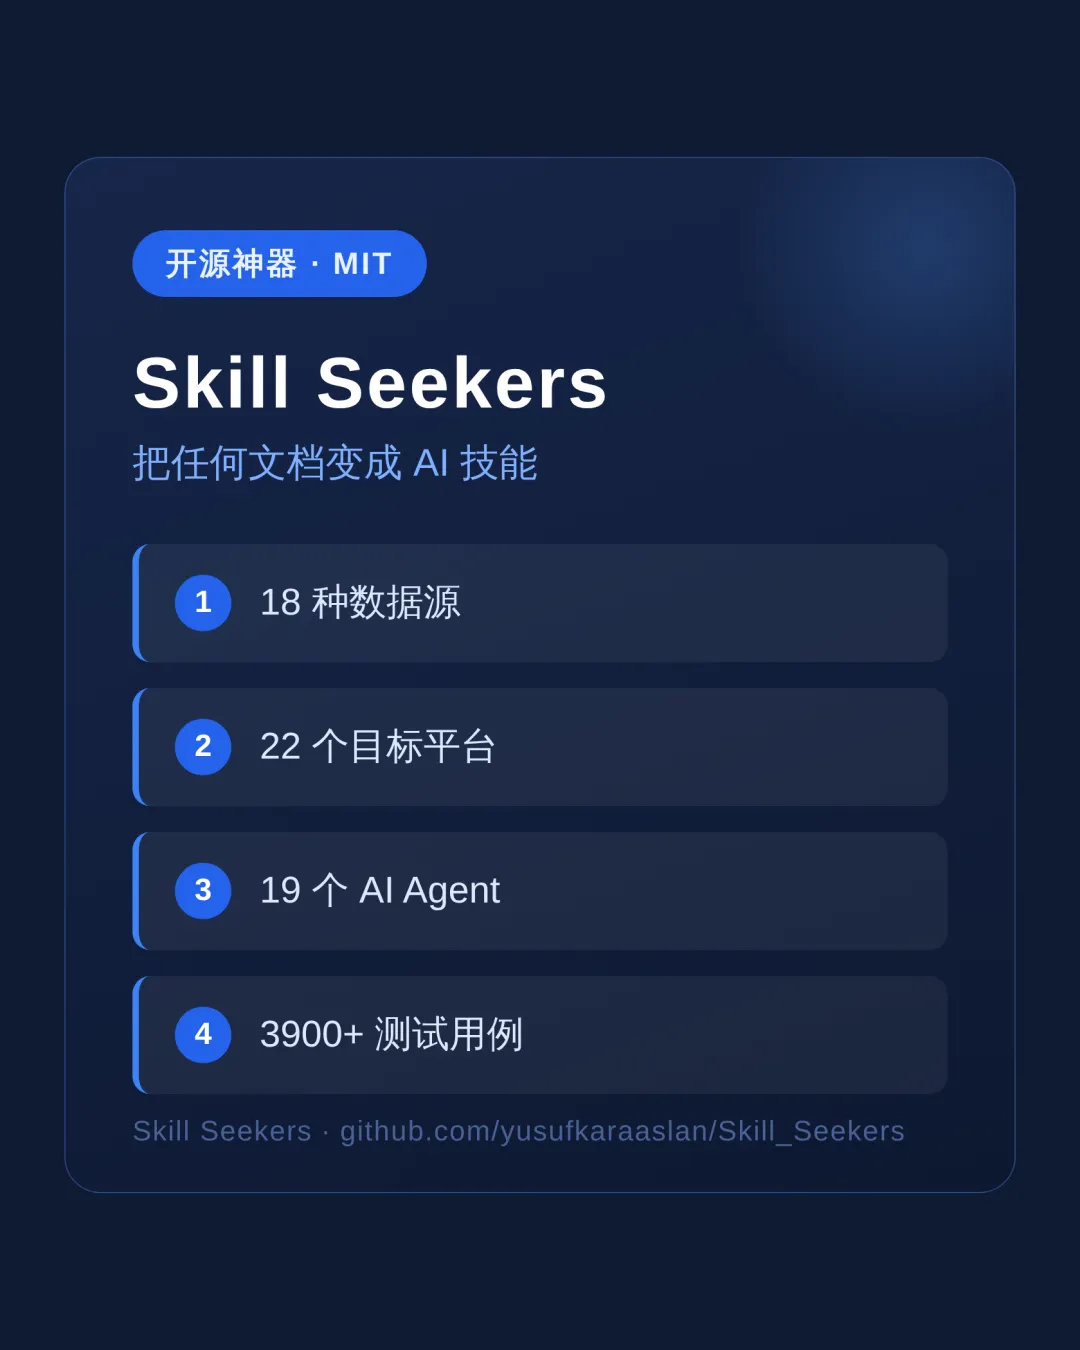
开篇配图:Skill Seekers 核心概念
上周想给 Claude Code 补一份 Django REST Framework 的领域知识,翻了一圈官方文档,四百多页。手动整理?起码两天。后来在 GitHub Trending 上刷到一个项目,十五分钟搞定,质量还挺高——这就是今天要讲的 Skill Seekers。
这是个什么东西
Skill Seekers 是土耳其开发者 Yusuf Karaaslan 的开源项目(MIT 协议),定位很直接:面向 AI 系统的数据层。说白了,它负责把散落各处的知识——文档站、代码仓库、PDF、视频、Wiki——抓下来、整理好、打包成 AI 能直接消费的技能资产。
几个数字先放在这:
支持 18 种数据源:文档网站、GitHub 仓库、本地代码、PDF、Word、EPUB、Jupyter Notebook、OpenAPI、PPT、YouTube/Vimeo 视频、Confluence、Notion、Slack/Discord 聊天记录…… 可导出到 22 个目标平台:Claude、Gemini、OpenAI、Kimi、DeepSeek、Qwen 等 12 个 LLM 平台,加 LangChain、LlamaIndex、Pinecone、Chroma 等 RAG 和向量库 技能可直接装进 19 个 AI 编程 Agent:Claude Code、Cursor、Windsurf、Cline、Copilot 一个不落 3900+ 测试用例,PyPI 可直接安装,当前版本 v3.9.0
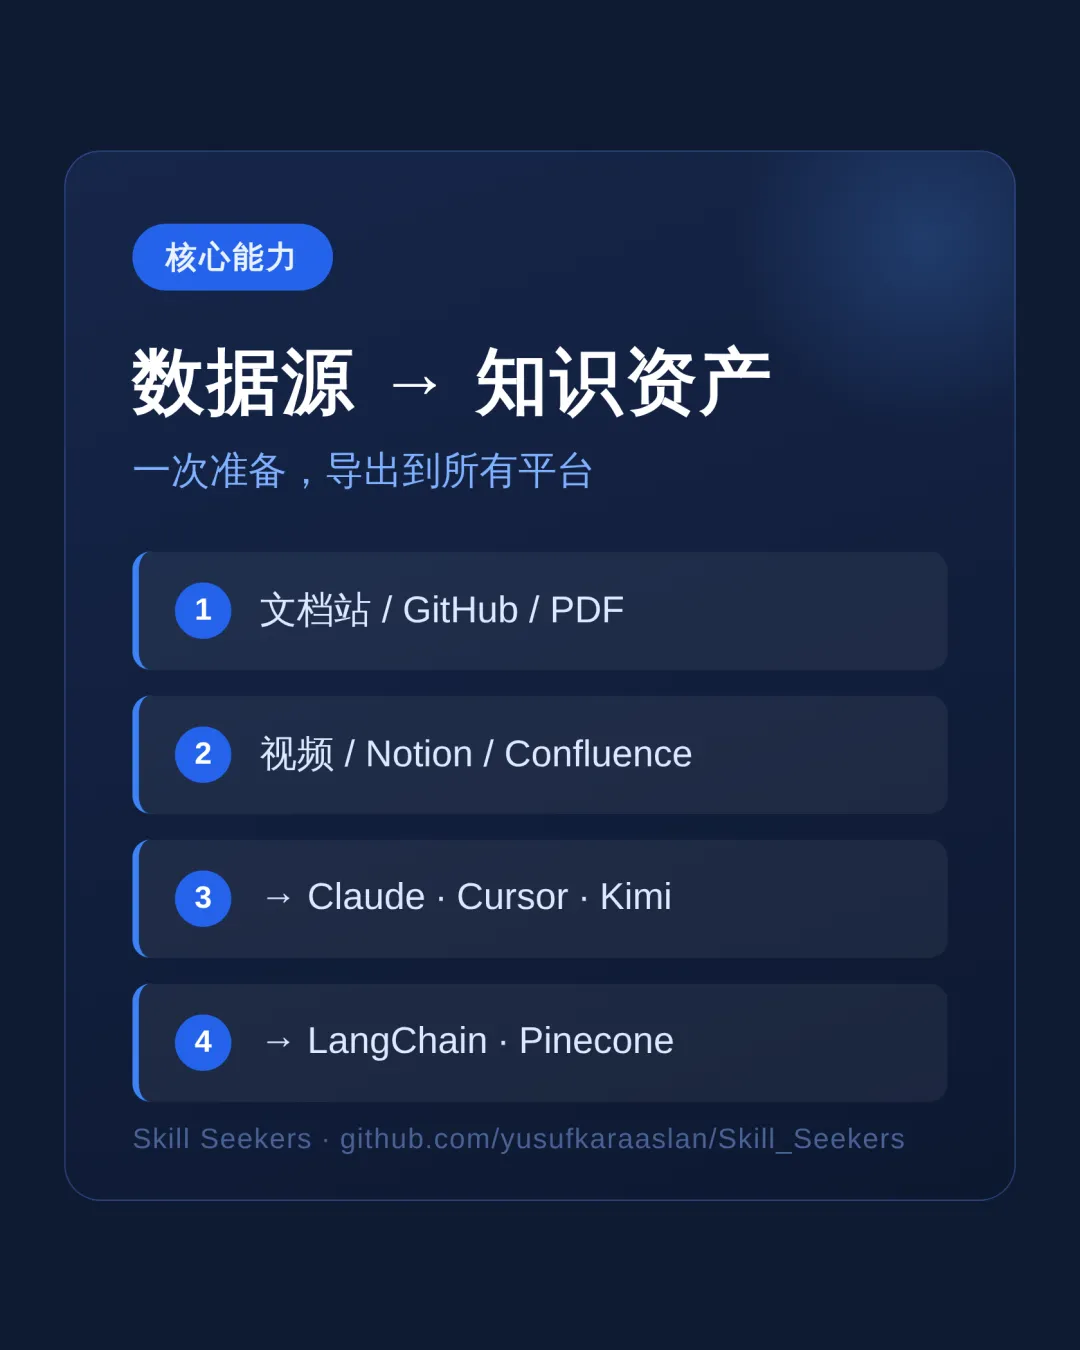
数据源与目标平台概览
它解决的是 AI 编程助手的一个老问题:模型通用知识不够新、不够专。Cursor 再聪明,也不了解你们公司那个祖传内部框架。把框架文档喂给它?以前要自己写爬虫、自己切分、自己写 SKILL.md。Skill Seekers 把这整条流水线自动化了——官方给的对比数据是,原本数天的人工准备压缩到 15-45 分钟。
安装:一行命令的事
前提只有两个:Python 3.10+ 和 Git。
pip install skill-seekers核心包就带了抓取、GitHub 分析、打包能力。要扩展的话按需加装:
pip install "skill-seekers[all-llms]" # 所有 LLM 平台支持 pip install "skill-seekers[mcp]" # MCP 服务器 pip install "skill-seekers[notion]" # Notion 页面支持 pip install "skill-seekers[video]" # YouTube/Vimeo 视频支持 pip install "skill-seekers[all]" # 全家桶拿不准装哪个,跑一下安装向导 skill-seekers-setup,它会问你几个问题然后给出建议。装完随手执行一次 skill-seekers doctor,环境有没有问题一目了然。
实战一:把 Django 文档变成 Claude 技能
三条命令,最经典的用法。
# 1. 从文档站创建技能 skill-seekers create https://docs.djangoproject.com/ # 2. 打包成 Claude 可用的格式 skill-seekers package output/django --target claude # 3. 装进 Claude Code skill-seekers install-agent output/django/ --agent claude跑完第一步,output/django/ 下会出现一份组织好的参考文档目录,以及一份 500+ 行的 SKILL.md——这不是简单拼接的文本,而是 AI 增强生成的技能说明,带示例、带使用模式、带最佳实践。第二步打包出 django-claude.zip,没有 API key 的话,去 claude.ai/skills 手动上传这个 zip 就行。
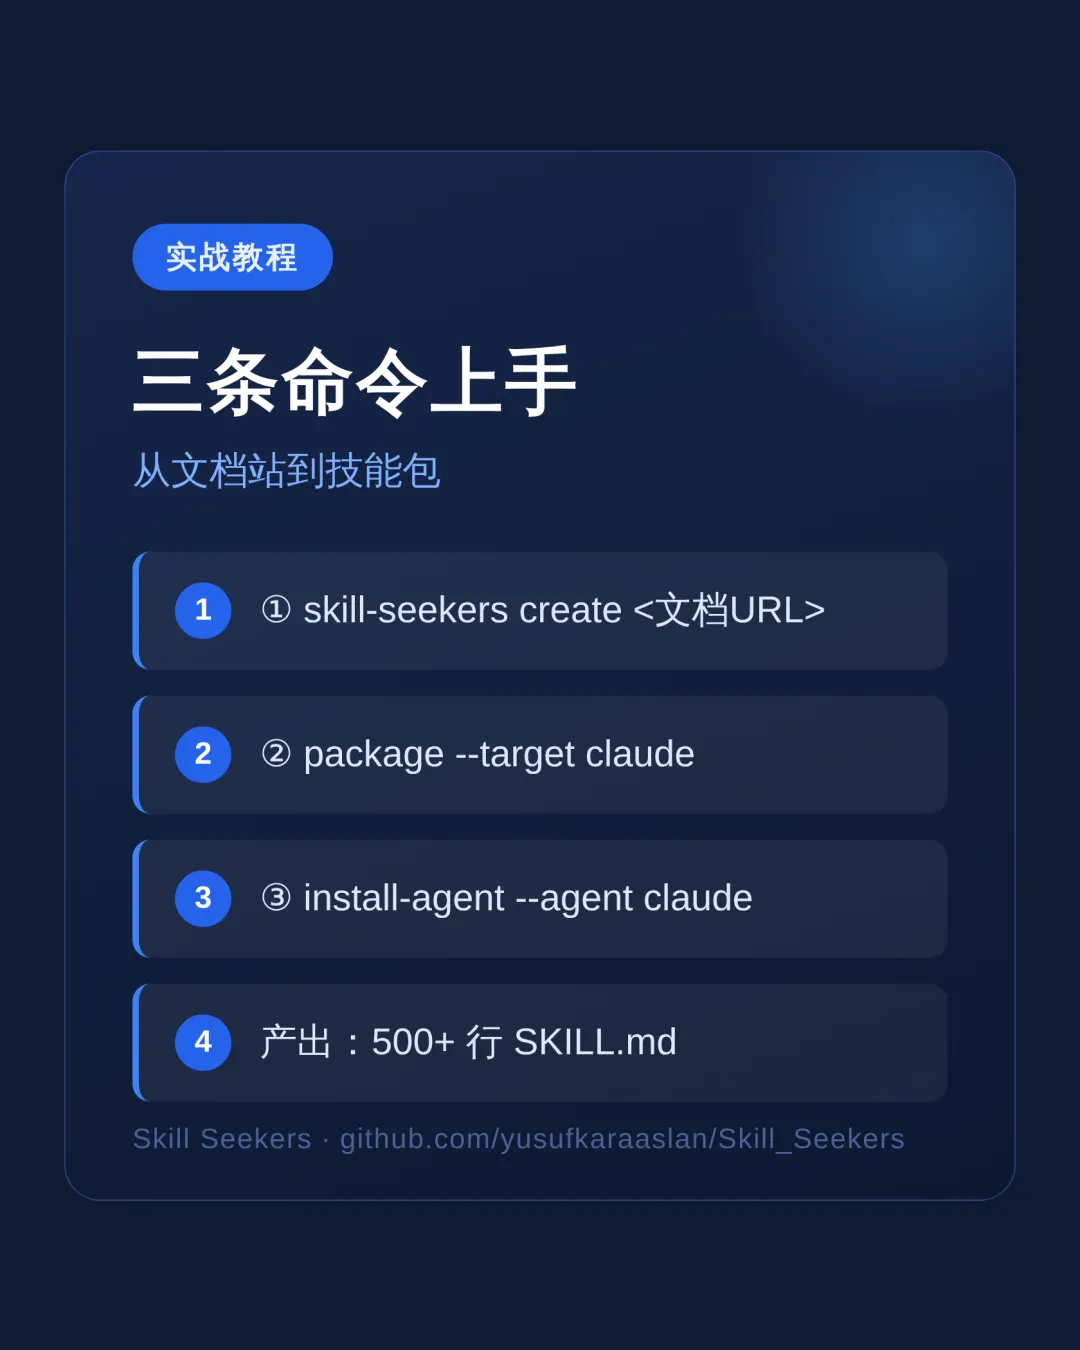
实战流程:从文档到技能包
整个抓取过程有点讲究。它会先探测站点有没有 llms.txt,有的话速度能快十倍;没有就走 sitemap 到无头浏览器渲染的三层发现,SPA 单页应用也能抓全。抓完的页面还会做智能分类,API 文档、教程、指南各自归档。
实战二:GitHub 仓库直接变 Cursor 技能
第二个场景更常见:想深挖一个开源项目。
skill-seekers create facebook/react skill-seekers package output/react --target cursor skill-seekers install-agent output/react/ --agent cursor对代码仓库,它跑的是一套叫 C3.x 的分析流水线,三路并行:AST 代码分析(能识别 9 种语言里的 10 种 GoF 设计模式)、文档提取(README、docs、wiki)、社区信号(issues 和 PR 的讨论)。最后产物里连 AI 撰写的操作指南和从测试代码里提取的真实用法示例都有。
有个功能我个人很喜欢——scan。把任意项目目录丢给它:
skill-seekers scan ./my-react-app --out ./configs/scanned/ # 产出: react.json vite.json tailwind.json jest.json my-react-app-codebase.json它会读项目的清单文件、Dockerfile、CI 配置和源码 import,检测出用了哪些框架,每个框架给一份配置,再额外生成一份针对你自己代码的分析。接下来 skill-seekers create ./configs/scanned/react.json,项目知识也变成技能了。
进阶:MCP 集成与视频转技能
MCP 服务器是隐藏的大杀器。Skill Seekers 自带 40 个 MCP 工具,配到 Claude Code 或 Cursor 里之后,直接对话就能干活:
# Claude Code / Cline 用 stdio 模式 python -m skill_seekers.mcp.server_fastmcp # Cursor / Windsurf 用 HTTP 模式 python -m skill_seekers.mcp.server_fastmcp --transport http --port 8765配好以后对助手说一句"打包并上传 React 技能",它自己就能调工具完成全流程。
视频也能转技能,这个用法比较出人意料:
pip install "skill-seekers[video]" skill-seekers create --video-url https://www.youtube.com/watch?v=xxx --name mytutorial三级兜底拿字幕:内嵌字幕 → YouTube 字幕 API → 本地 Whisper 转写。装 video-full 还能对视频帧做 OCR,把讲师敲在屏幕上的代码也提取出来。教程视频变图文技能,这思路确实妙。
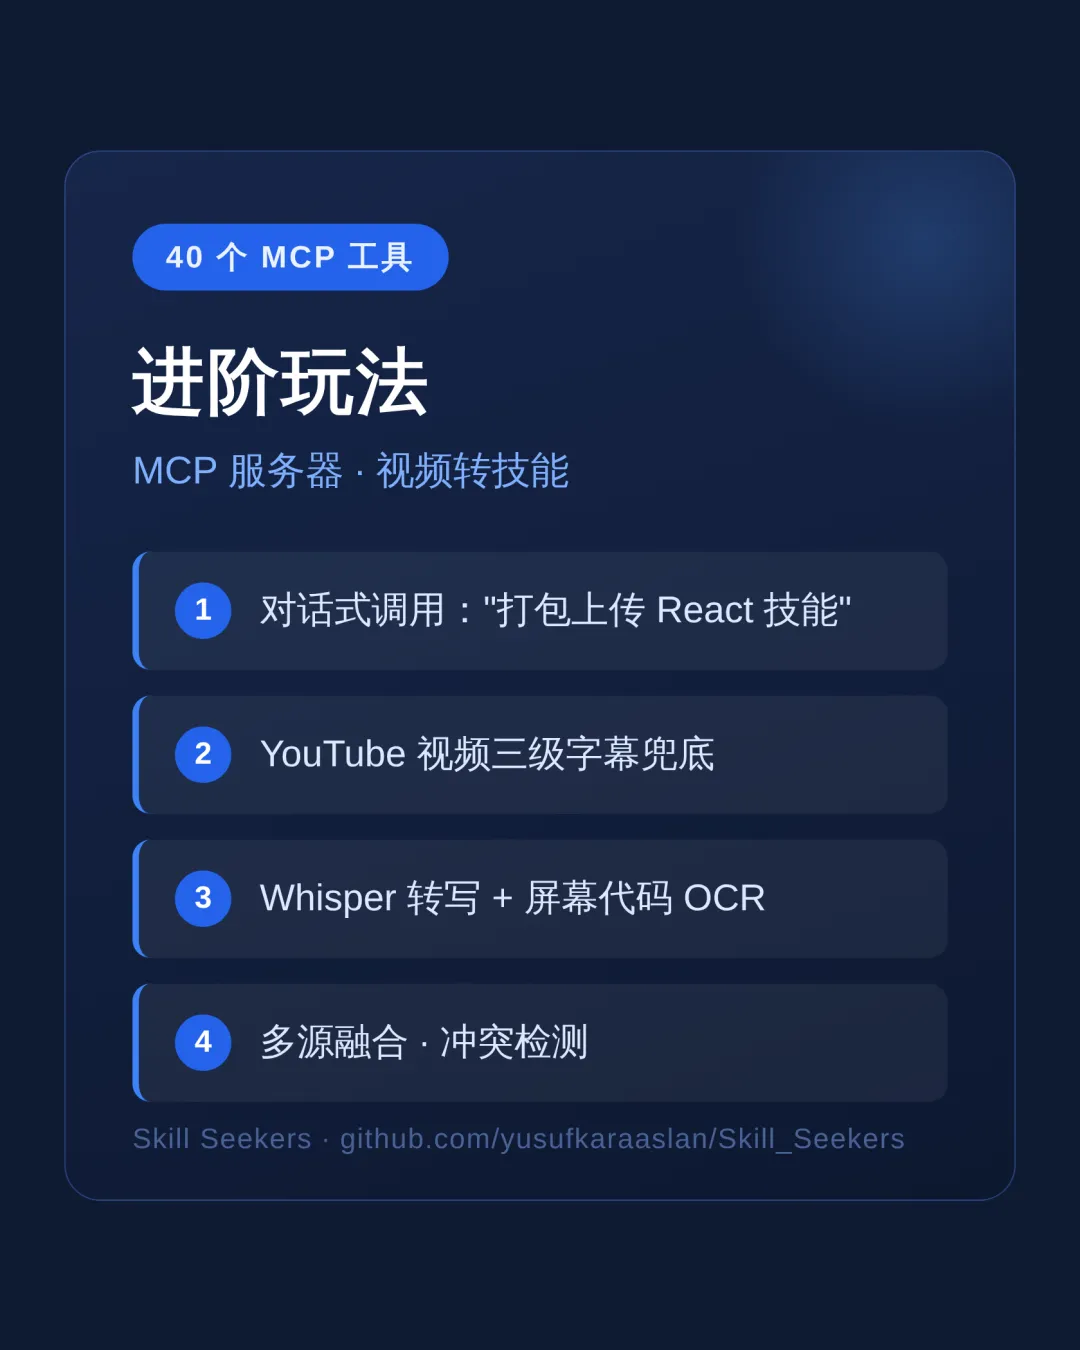
进阶玩法:MCP 与多源融合
还有个能力值得提:多源融合。一份配置里同时写文档站、GitHub 仓库、PDF 和视频链接,Skill Seekers 会把它们合并成一份知识资产,做跨源冲突检测——比如官方文档和 GitHub README 说法打架时能标出来。
什么样的产出质量
质量担心的话,有内置的质量评分命令:skill-seekers quality output/react/ --threshold 7,低于阈值直接报警。文档更新了还能配 sync 做变更检测,定时重抓。
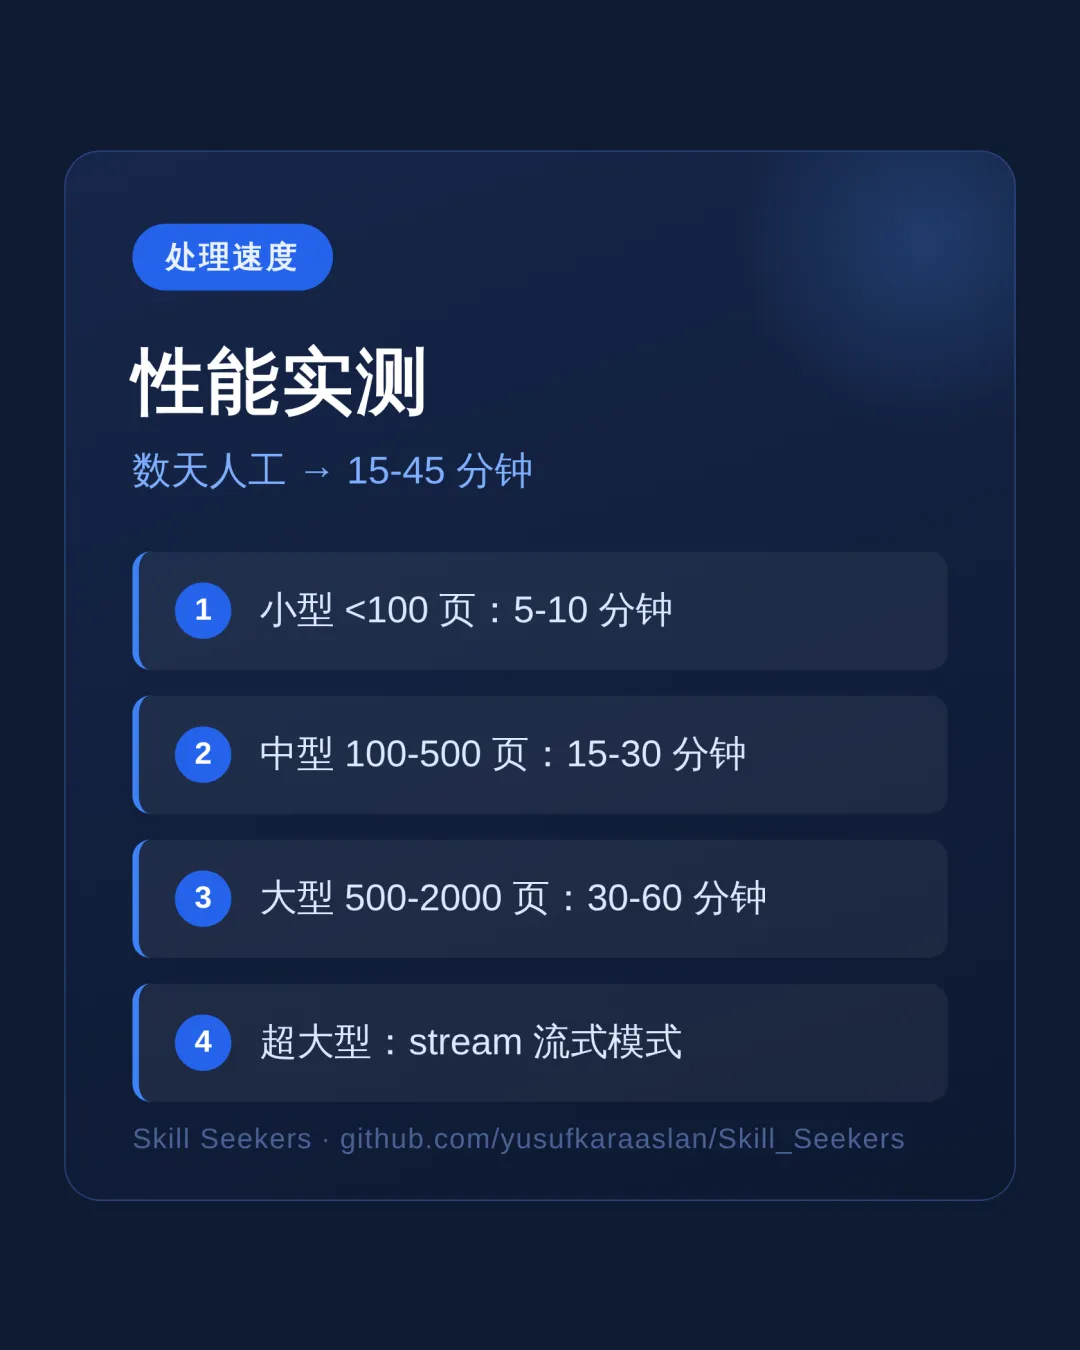
性能与质量数据
写在最后
给个直接的判断:如果你在用 Claude Code、Cursor 或者任何一个 AI 编程助手,&&并且需要它精通某个具体框架、内部项目或者垂直领域知识==,Skill Seekers 值得一试。它是目前这个方向上覆盖面最全的开源方案,18 种源、22 个目标、19 个 Agent 的支持矩阵,短期内很难有对手。
两点提醒。一是 AI 增强环节默认走 Anthropic 等 API,会产生 token 费用,不想花钱可以切 --agent claude 这类 LOCAL 模式,用本地 agent 干活;二是大文档站抓取耗时客观存在,超大规模记得用 stream 流式模式。
项目地址:
https://github.com/yusufkaraaslan/Skill_Seekers