ARTICLE · 989613
选 AI 编程工具,是在选你交出多少行动权
一、你粘了一个函数进去,然后它开始猜
线上一个接口偶发超时。你打开对话框,把那段函数整体粘进去,问:为什么这里会偶发超时?
回答很漂亮,列了六条:连接池不够、锁竞争、下游没设超时、GC 停顿、线程池排队、网络抖动。
每一条都成立,每一条都可能不是。
你挨个去试。两小时后发现真正的原因在另一个文件里 —— 一段被三层封装包住的重试逻辑,最大重试次数写死成 5,而下游超时是 3 秒。5 次重试撞上一次慢响应,那个接口就超时了。
这两小时不是模型的问题。你交给它的全部信息就是那三十行函数体,剩下的它只能猜。而它猜得非常流畅,所以你信了。
换一个入口再问同一句话。这次它能读整个仓库、能 grep、能翻 Git 历史、能跑测试。它先追出调用链,再翻出那段重试逻辑,写了个测试复现超时,最后给你一份 12 行的 Diff。
模型可能完全是同一个。变的是它能看到多少,以及它被允许动手做什么。
所以「哪个 AI 编程工具最强」这个问题,从提出的那一刻就问错了。该问的是:
这次任务,我打算让 AI 看到多少,允许它做到哪一步?
二、五件武器,不是一张强弱排行榜
先把武器库摊开来看。今天的 AI 编程工具大致是五类:
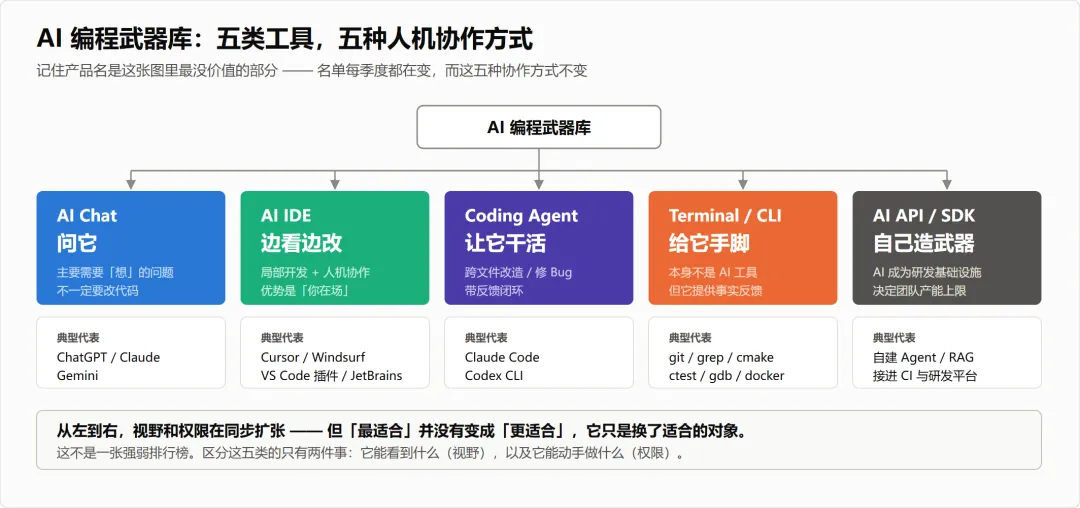
记住产品名是这张图里最没价值的部分 —— 名单每季度都在变。有价值的是:这五类代表五种不同的人机协作方式。
而区分它们的,只有两件事:视野(它能看到什么)和权限(它能动手做什么)。
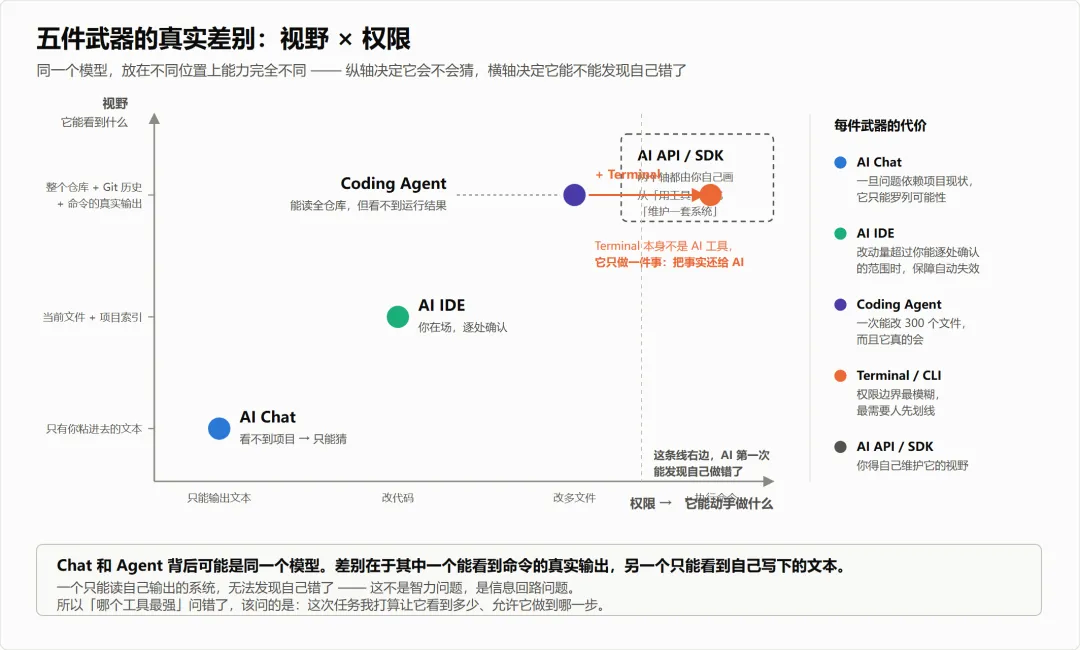
看这张表的时候注意一件事:从上往下,视野和权限是同步扩张的,但「最适合」并没有变成「更适合」。 它只是换了适合的对象。
三、AI Chat:唯一一件不该给它权限的武器
典型代表是 ChatGPT、Claude、Gemini 这类纯对话入口。它最适合的是一件事:
主要需要「想」、不一定需要改代码的问题。
比如:什么是 RAII?这段 CMake 在做什么?这个 RPC 架构有什么问题?帮我设计一个 SDK 的分层。为什么这里需要 mutex?
这里有个反直觉的地方值得说清:Chat 之所以适合做设计讨论,恰恰因为它看不到你的项目。
它不会被现状绑住。你问「这个模块应该怎么分层」,它给的是一个不受历史包袱影响的答案 —— 这在做架构讨论时是优点,因为你要的就是一个跳出现状的参照系。
但同一个特性,换个问题就变成致命缺陷。当问题从「应该怎么设计」变成「我们这个项目里为什么会阻塞」,Chat 立刻退化成开头那六条猜测。
判断标准很简单:这个问题的答案,取决于你项目里的具体代码吗? 如果取决于,Chat 不是合适的入口。
四、AI IDE:真正的上下文是你的光标
Cursor、Windsurf、VS Code 加插件、JetBrains 系的 AI 能力,都属于这一类。它和纯 Chat 的区别只有一句话:AI 进入了你的开发环境。
具体变化是,AI 从「回答问题」扩展到了看代码、理解代码、修改代码、生成代码、局部重构、辅助 Debug。而这些动作发生的位置,是你正打开的那个文件。
它最适合的是局部代码开发 + 人机协作,三类活干得最好:
小范围修改 —— 「给这个函数加参数校验」「把这个 switch 重构成策略模式」
代码补全 —— 你刚写下一个控制器类的骨架,它就能推出
connect() / disconnect() / move() / stop() / getStatus()这一串局部重构 —— 「把这个类拆成 Client、Session、Transport 三个」,它可以同时改几个文件
注意 AI IDE 的视野边界:它主要看你打开和选中的东西。 这既是它的强项也是它的天花板。
强项是你在场。每一次修改都在你眼前发生,你能立刻按 Ctrl+Z。天花板也在这里 —— 一旦改动量超过你逐处确认的能力,「你在场」这个保障就自动失效了,而工具不会提醒你这件事已经发生。
五、Coding Agent:第一次出现「它自己回头看结果」
这是 AI 编程工具演进里最重要的一次变化,值得慢一点讲。
传统 AI 协作里的循环是这样的:你给指令 → AI 给答案 → 你改代码 → 你编译 → 你测试 → 你修 Bug → 你再去问 AI。
看出问题了吗?这个循环里所有的搬运都由人做,AI 从来没有见过自己那段代码的运行结果。 它写完就交卷了,对错与它无关。
Agent 模式把这个循环闭上了:
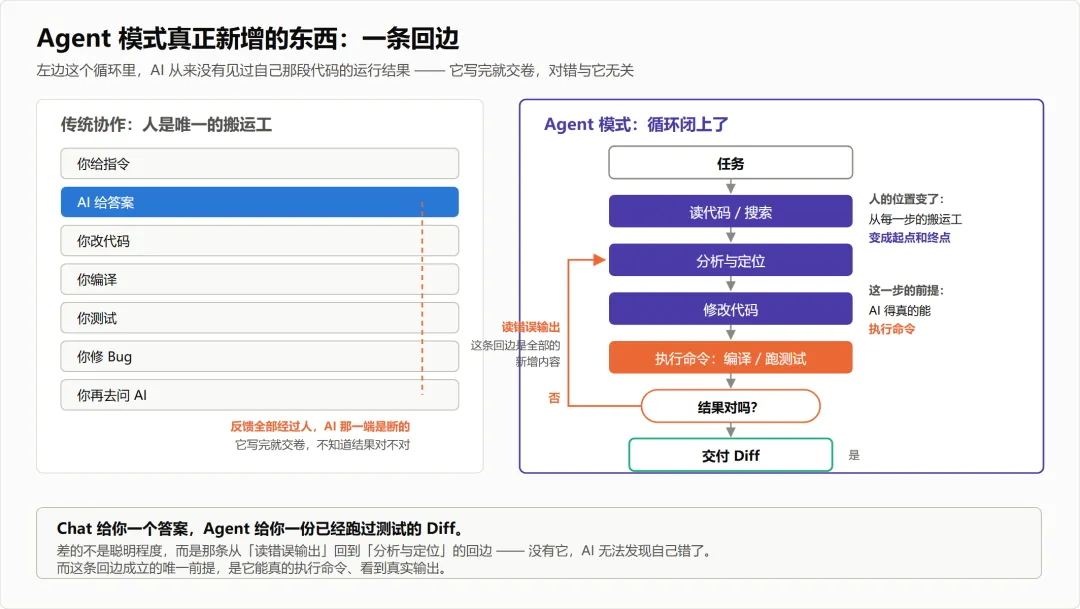
关键就是那条从「读错误输出」回到「分析与定位」的回边。有了它,人的位置从每一步的搬运工变成了起点和终点。
举个具体的。你告诉它:分析这个项目的协议模块,找出 32 位无符号整数读写为什么不正确,给出方案并实现。
它会依次做:理解项目结构 → 定位那个模块 → 查相关类 → 追调用链 → 找现有测试 → 分析字节序和数据结构 → 修改代码 → 编译 → 跑测试 → 根据失败信息再修。
这和「帮我写一个函数」已经不是同一个层次的事。所以:
Chat 给你一个答案,Agent 给你一份已经跑过测试的 Diff。
六、Terminal 不是 AI 工具,但它是 Agent 的手脚
上面那个闭环有个前提,很多人会跳过:AI 得真的能执行命令。
如果 AI 只能看代码、写代码,它永远不知道自己写的对不对 —— 它没有任何获取事实的渠道。而一旦它能调用这些:
git statusgitdiffgrepfindcmakemakectestgdbdocker
它就拥有了一套完整的软件工程执行工具链。于是「修复这个 Bug,并确保测试通过」这句话才第一次变得可执行:
搜索代码 → 修改代码 → cmake → make → ctest → 读失败输出 → 再改 → git diff 自查
这里是本篇最想让你记住的一句:
Chat 和 Agent 背后可能是同一个模型。差别在于其中一个能看到命令的真实输出,另一个只能看到自己写下的文本。
一个只能读自己输出的系统,无法发现自己错了。这不是智力问题,是信息回路问题。
视野那一侧同理。同样问「这个 move() 为什么会阻塞」,只拿到函数体的 AI 只能罗列可能性;而能顺着 MotionManager → RPCClient → Transport 一路读下去的 AI,可以指着其中一段说「阻塞在这里,这里是同步等待」。
所以企业里 AI Coding 的第一大问题从来不是「模型够不够聪明」,而是「它有没有拿到正确的上下文和真实的反馈」。
七、AI API / SDK:当 AI 不再是一个软件
第五件武器面向的是另一个阶段:不只是使用 AI 工具,而是把 AI 能力集成进自己的系统。
形态大概是这样:内部知识库 → RAG → 模型 → Agent → 接进公司的研发平台。或者更直接的一条:GitLab Issue → Agent 读需求 → 分析代码 → 自动修改 → 触发 CI → 跑测试 → 提交 Code Review。
这时候 AI 已经不是你打开的某个软件,而变成了研发基础设施的一部分。
对大多数人这还不是今天要动手的事。但它决定了前面四件武器的天花板在哪 —— 个人用得再熟,也只是个人产能;这一层做成了,才是团队产能。
八、把五件武器排成一条授权阶梯
现在可以给出本篇的核心模型了。把「AI 被允许做什么」单独抽出来,它是一条有七级的阶梯:
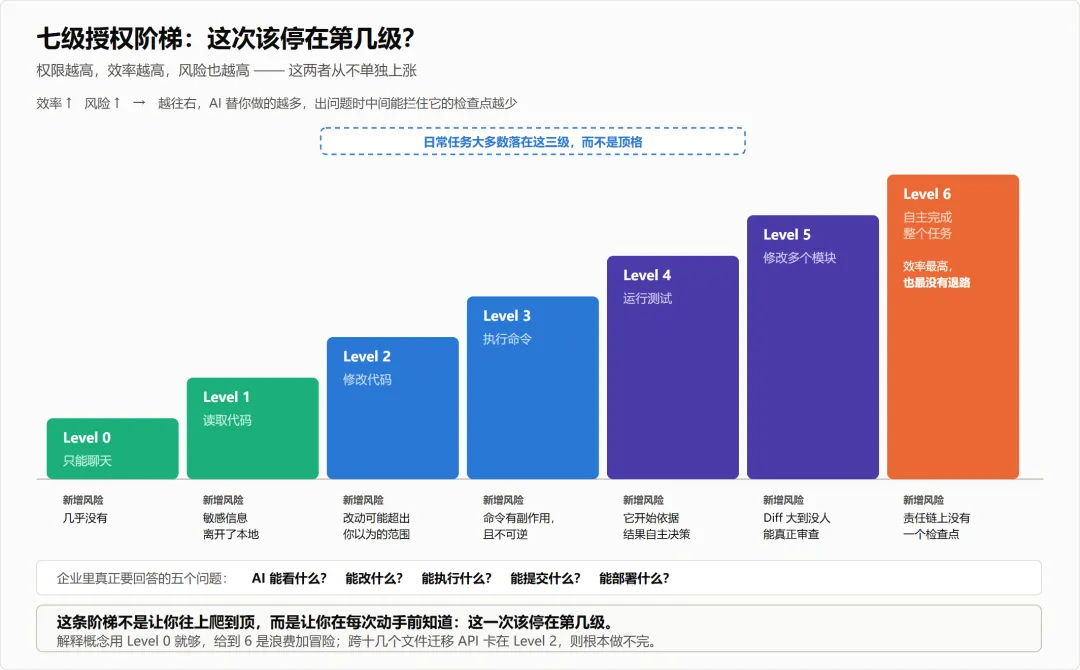
这张表的走向很清楚:
权限越高,效率越高,风险也越高。这两者从不单独上涨。
所以企业里真正要回答的不是「用哪个工具」,而是五个权限问题:AI 能看什么?能改什么?能执行什么?能提交什么?能部署什么?
而最容易被误读的一点是:这条阶梯不是让你往上爬到顶,而是让你在每次动手前知道,这一次该停在第几级。
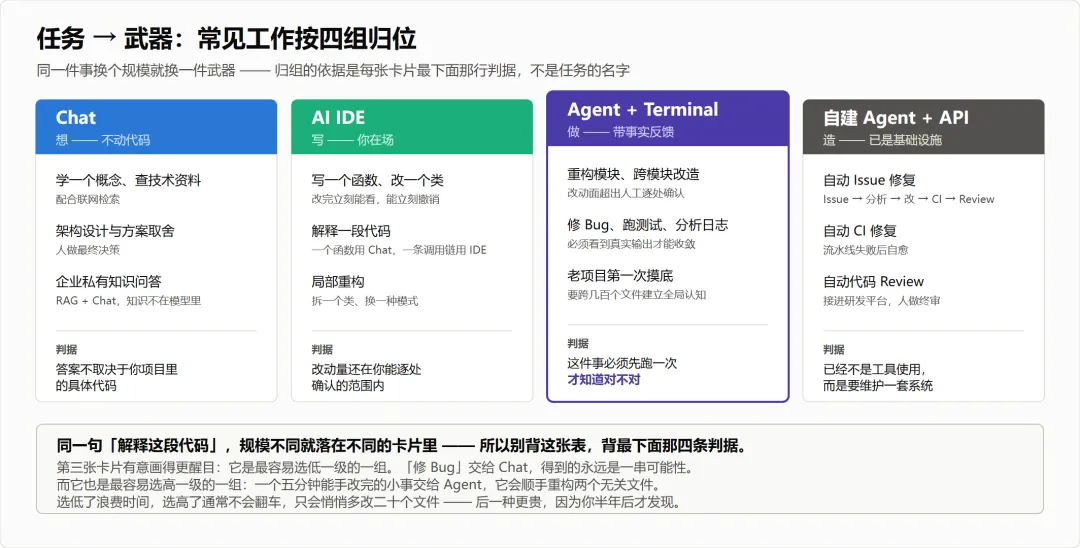
一个只需要解释概念的问题,用 Level 0 就够了,给到 Level 6 纯属浪费加冒险。一个需要跨十几个文件迁移 API 的任务,卡在 Level 2 则根本做不完 —— 它改完了,但谁来编译、谁来跑测试、谁来读那一屏错误?
至于爬到高层级之后怎么保证不出事,那是另一套东西:先让 AI 真的理解,再明确约束它能碰什么,最后想好怎么验证。这条阶梯是那套控制体系的前提 —— 你得先知道自己交出了几级权限,才谈得上控制。
九、四问法:从任务反推武器
上面全部内容,可以压成四个动手前的问题。
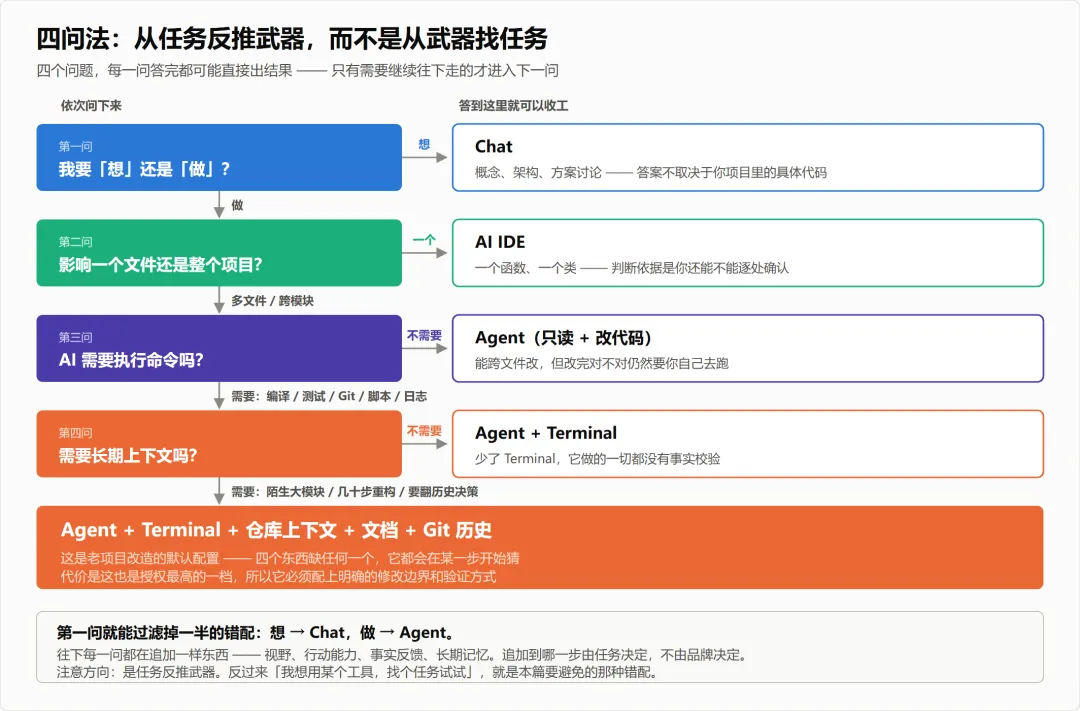
第一问:我要「想」还是「做」? 想 → Chat;做 → Agent。这一问过滤掉一半的错配。
第二问:影响一个文件还是整个项目? 一个函数 → AI IDE;多个文件 → Agent。判断依据是你还能不能逐处确认。
第三问:AI 需要执行命令吗? 只要涉及编译、测试、Git、脚本、日志分析,就必须是 Agent + Terminal —— 少了 Terminal,它做的一切都没有事实校验。
第四问:这个任务需要长期上下文吗? 理解一个陌生的大模块、持续几十步的重构、要翻历史决策的改造,都需要仓库上下文 + 文档 + Git 历史一起给到。
落到具体任务上,这套判断的结果是这样一张表:
十、不要养成工具崇拜
这一点值得单独说,因为它是上面所有内容的保质期问题。
「Claude Code 最强」「Cursor 最强」「某个模型最强」—— 这类结论今天成立,下个季度就翻转。你花在记按钮位置上的时间,会随版本一起过期。
不会过期的是五种能力:任务分析、上下文组织、工具选择、约束、验证。
它们的共同点是:都不属于任何一个具体产品。 换掉工具,这五项一条都不用重学。
所以有个自检问题挺好用:你最近学的是「这个工具的哪个功能在哪」,还是「哪类任务该交给谁做」?前者是使用说明书,后者才是能力。
十一、这篇唯一需要背下来的东西
最简模型,七个词:
Chat 想 · IDE 写 · Agent 做 · Terminal 执行 · Git/Build/Test 验证 · RAG 供给上下文 · 人决策
拼成完整的样子:
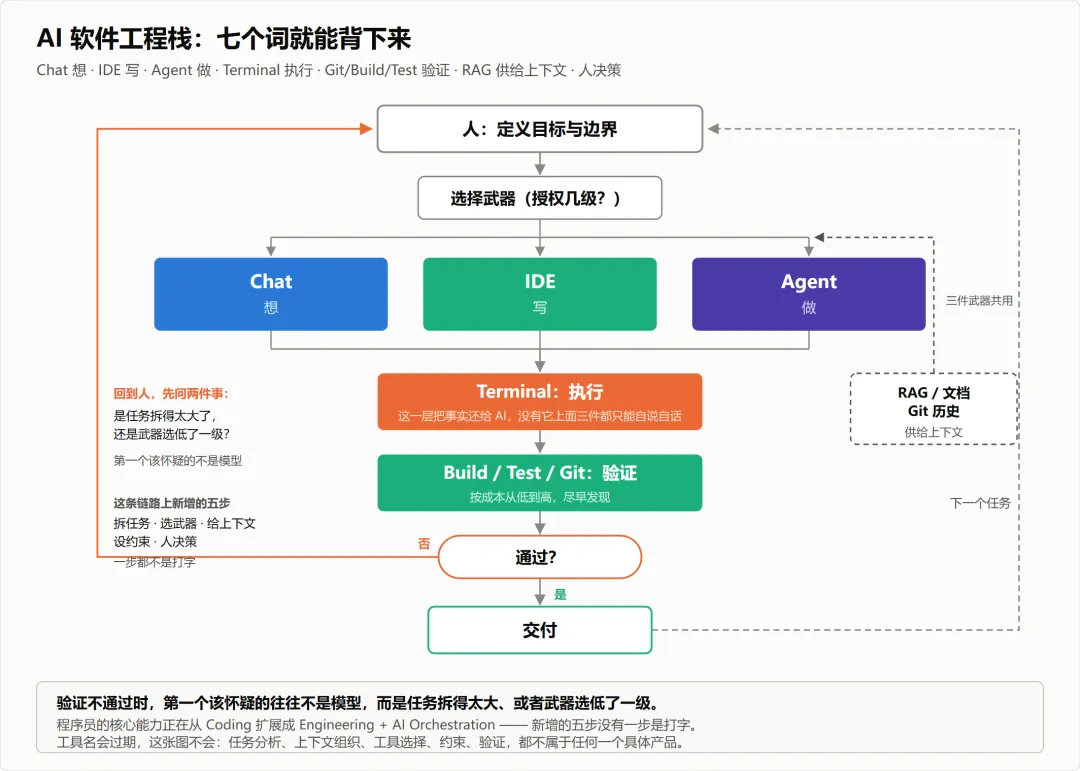
注意最后那条虚线和那个「否」分支。验证不通过时,第一个该怀疑的往往不是模型,而是任务拆得太大、或者武器选低了一级。
这也解释了这几年程序员这个角色正在发生的变化。过去的链路是:需求 → 程序员 → 写代码 → 编译 → 测试 → 交付。现在多出了几步:需求 → 程序员拆任务 → 选武器 → 给上下文 → 设约束 → AI 执行 → 验证 → 人决策 → 交付。
新增的五步,一步都不是打字。核心能力正在从 Coding 扩展成 Engineering + AI Orchestration。
十二、今晚就能做的一件事
不用改工作流,只做一次复盘。
把你最近一周和 AI 的对话记录翻出来,逐条标两个数字:这次我实际给了它第几级权限?这个任务本该是第几级?
会看到两类错配,而且通常都不少:
给低了 —— 你在对话框里粘了第三段代码,还在猜。这件事本该交给能读整个仓库、能跑测试的入口,两小时的猜测能压成一次定位。
给高了 —— 一个只需要问「这个设计合不合理」的问题,你让 Agent 直接动手改了。它当然改了,还顺手重构了两个无关文件。
标完之后加一条到你自己的清单里:每次动手前,先说出这次的级别。 一句话的成本,换的是一次不会失控的授权。
你最近一次「工具选错了」是哪一次? 是拿 Chat 硬啃一个需要全仓库视野的问题,还是让 Agent 干了一件本该五分钟手改完的小事?后一种更值得聊 —— 因为它通常不会翻车,只会悄悄多改二十个文件,然后你在半年后才发现。