ARTICLE · 992665
从WB条带到Excel小数:科研造假进入“数字取证时代”
过去,科研不端调查最醒目的证物是一张图:重复的Western blot条带、被旋转的荧光视野、被涂掉的细胞。现在,越来越多争议从一张Excel表开始——两组独立实验共享同一串数字,35行数据整齐相差0.3,占位值穿过版本管理进入正式论文,甚至一段上千小时的曲线像复印件一样再次出现。
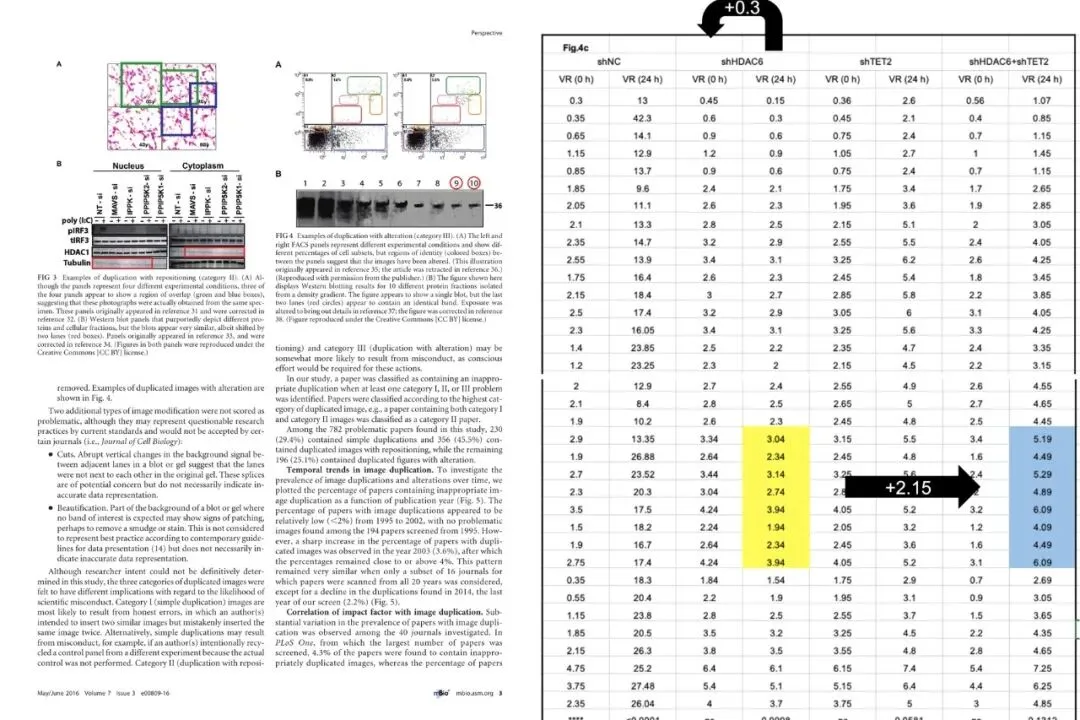
先把结论放在前面:不是图像造假退场、数字造假接班,而是科研审查多了一套机器可读的证据。 图像问题仍然大量存在;变化在于,Source Data、开放仓库和可下载的Excel让数字第一次能够像图片一样被批量比对。
这也带来一个必须反复强调的边界:数字异常可能来自蓄意操纵,也可能来自复制粘贴、公式错行、归一化、舍入、仪器分辨率或版本混乱。发现指纹,是调查的起点;认定造假,需要原始记录、作者解释、期刊处理和机构调查继续往前走。
第一幕:图像为什么曾经是最容易露馅的地方
生命科学论文长期依赖Western blot、凝胶、电镜、组织切片和荧光显微图。图片既是数据,也是叙事:一条更深的条带、一片更亮的荧光,往往就是“机制成立”的直观证据。
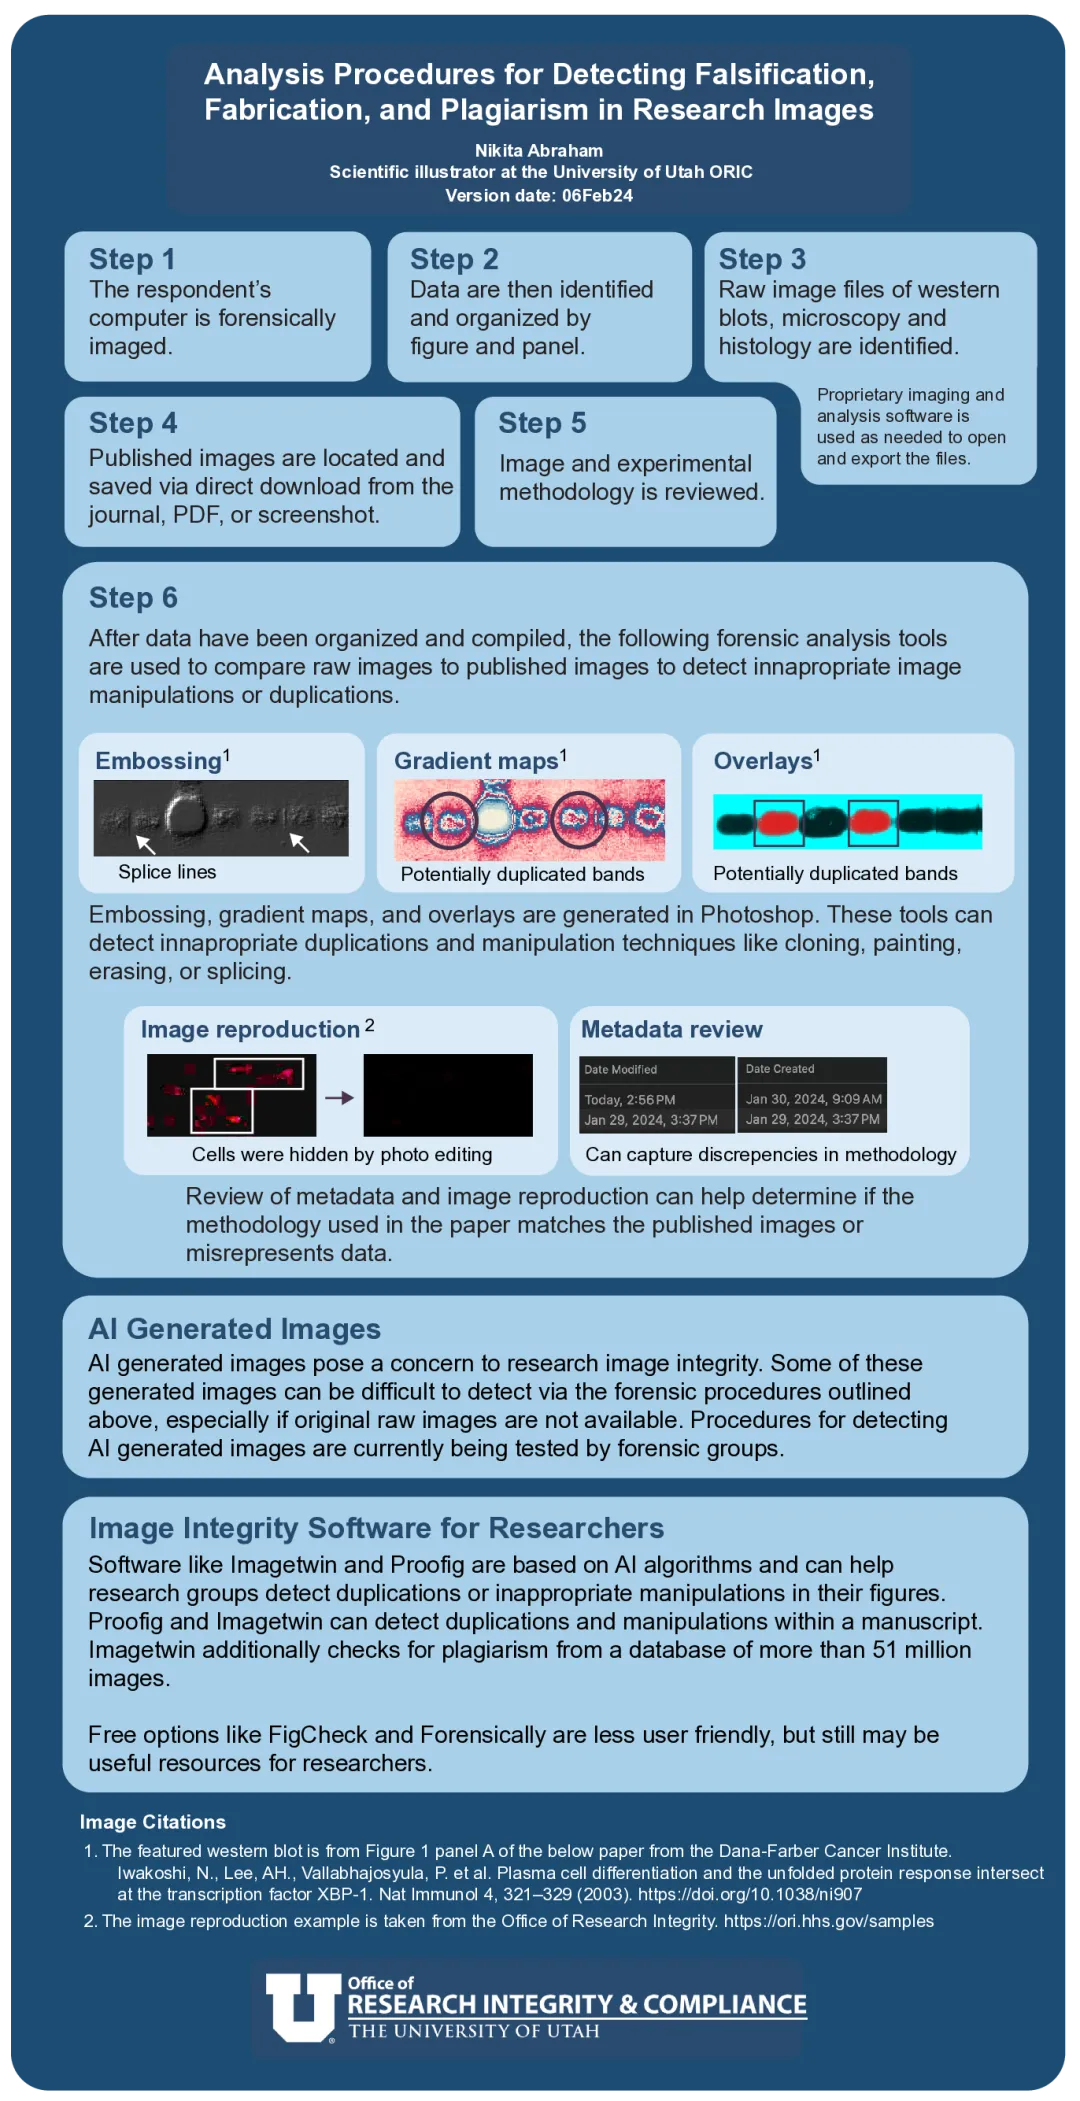
这类材料也天然适合被肉眼审查。常见指纹包括:
• 同一条WB条带被复制到不同蛋白或不同处理组;• 若干泳道被切下、翻转、拉伸,再拼成一张“完整”胶图;• 同一显微视野被裁剪、旋转、镜像或重新着色,冒充不同实验;• 用邻近背景覆盖不需要的细胞、斑点或条带;• 调整局部亮度、对比度或曝光,使某一信号选择性消失或增强。
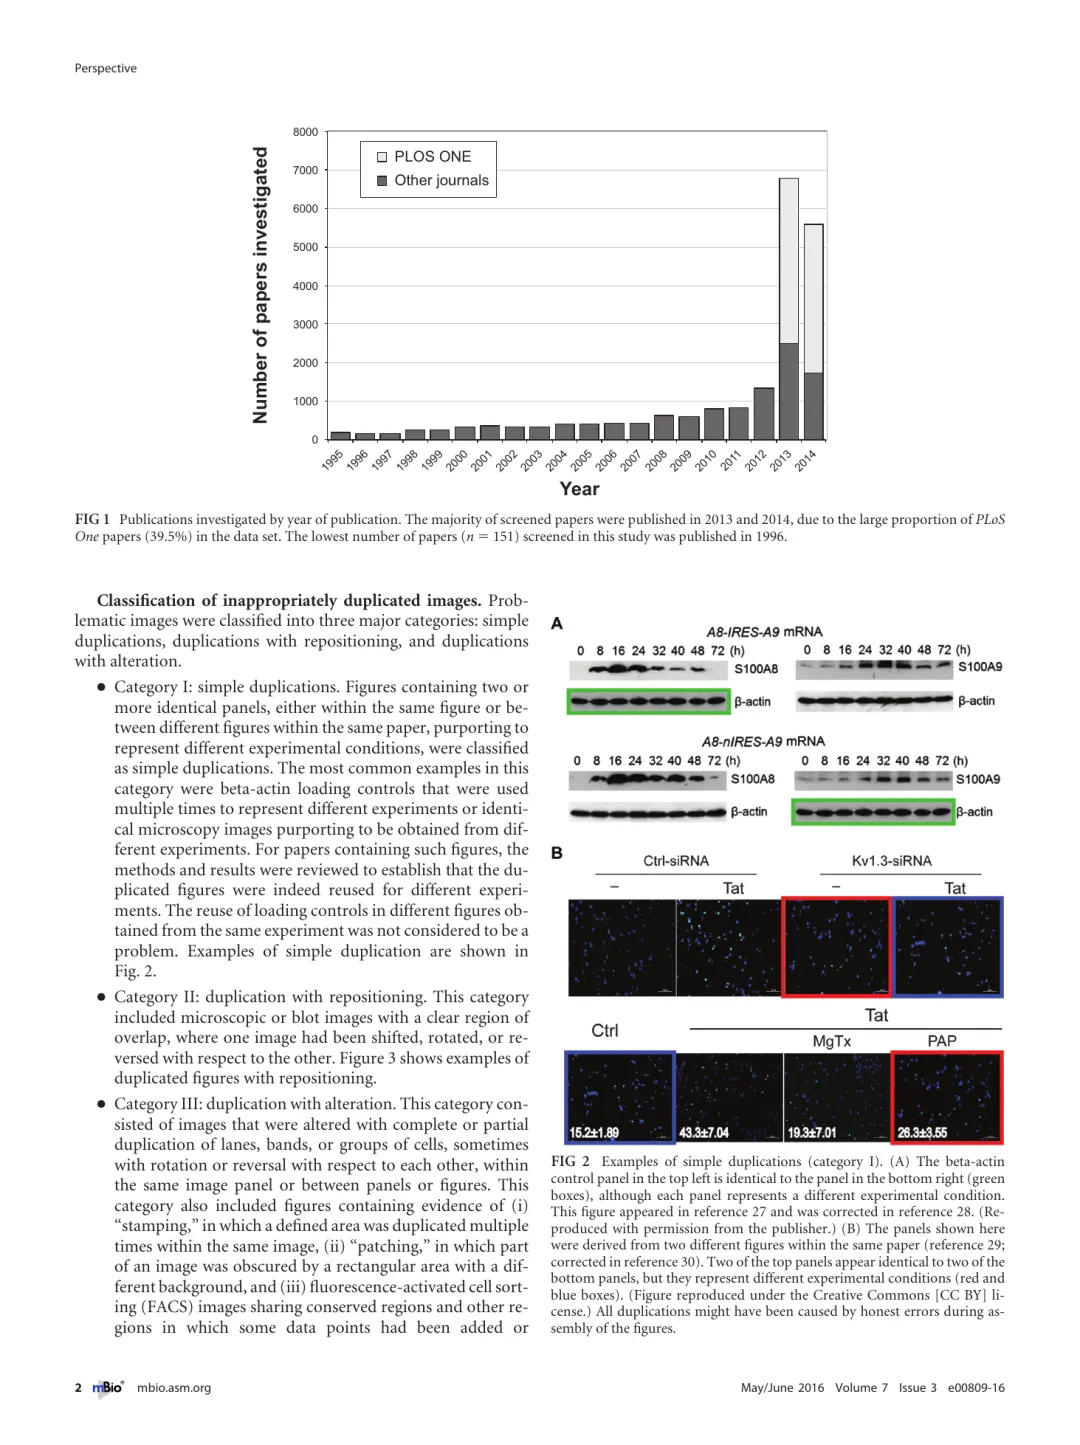
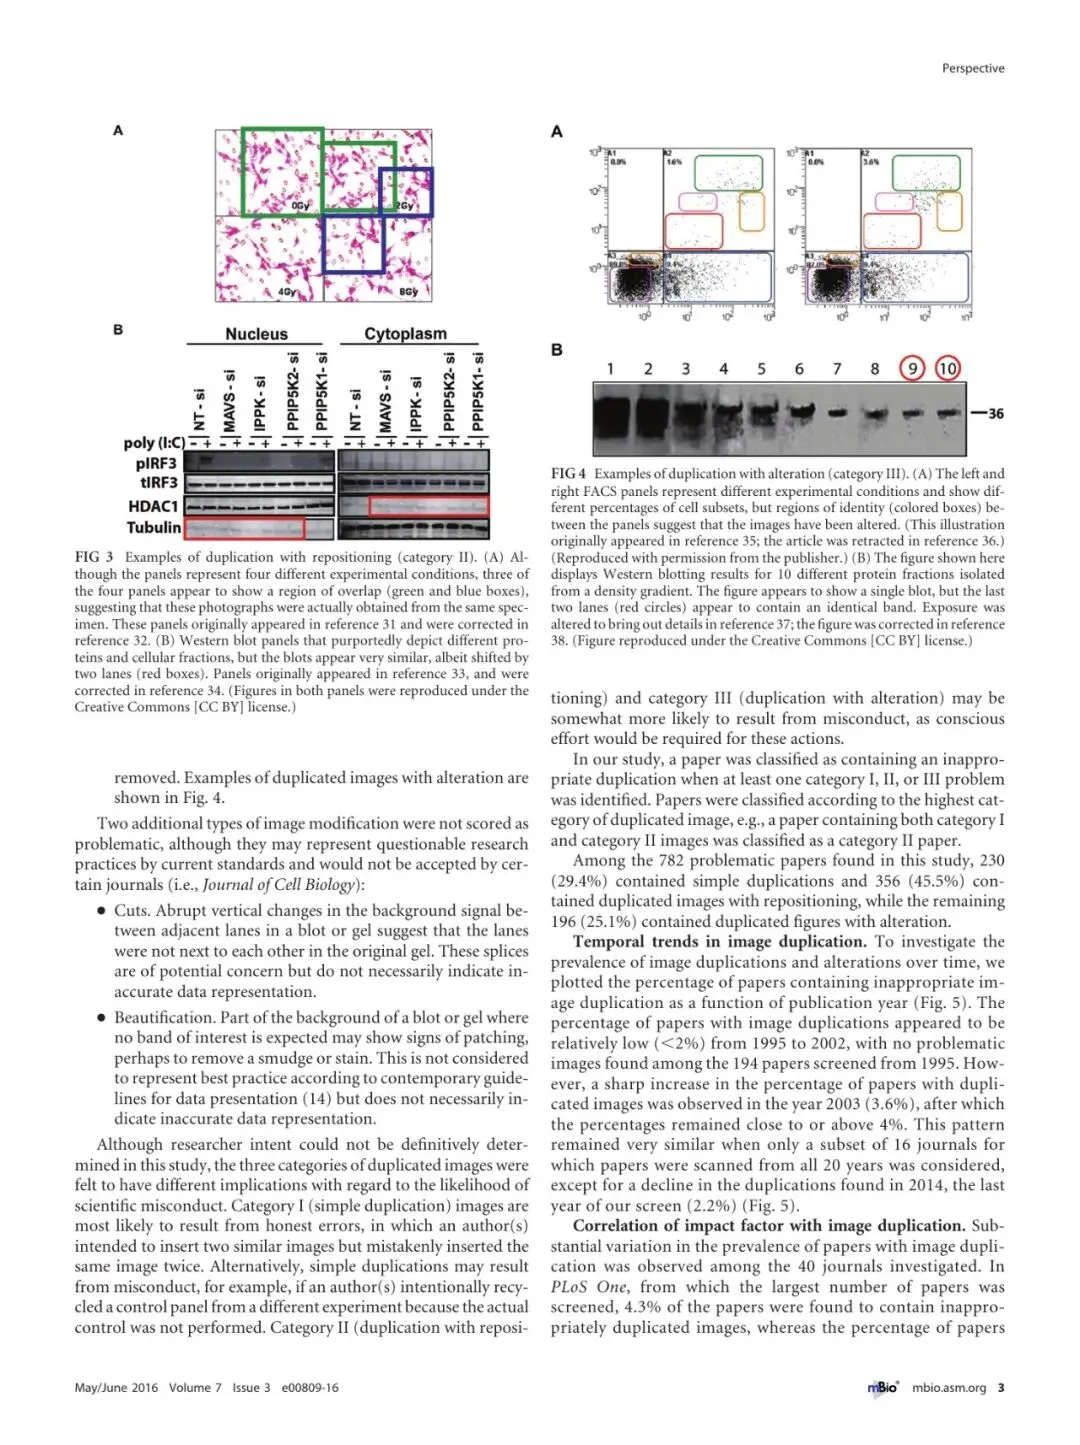
2016年,Elisabeth Bik等人逐篇检查了40种期刊、1995—2014年发表的20,621篇生物医学论文。782篇、即3.8%,含有不恰当的图像重复。研究者把问题分为三类:简单重复、经过移动或旋转的重复、以及伴随局部修改的重复。后两类需要更多主动操作,因此比单纯的排版误贴更令人担忧。
这项工作最重要的贡献,不是证明每一张重复图片都出于故意,而是把“看着不对”变成了可复核的分类。
绿色框、红色框、透明叠图和背景噪声,都让两个本来相隔数页的panel重新对齐。
美国科研诚信办公室近年的调查也说明,图像问题并没有成为历史。公开结论中仍能看到Western blot被重复、重标、拼接,免疫荧光区域被修改,或无关实验图像被拿来代表新的蛋白和条件。所谓“从图像转向数字”,不是替代关系,而是审计范围的扩张。
第二幕:为什么现在轮到数字说话
图片时代的审查有一个限制:你只能检查论文展示出来的那部分。原始表格长期锁在实验室电脑里,读者看到的是柱状图、均值、误差线和一两个代表性视野。
近年来,越来越多期刊要求上传Source Data;Dryad、Zenodo等仓库保存原始或半原始数据;PubPeer评论者也开始直接检查Excel、CSV和GraphPad文件。于是,数字获得了三个图像不具备的新属性:
第一,可以逐格精确比较。 两张图片“相似”还需要判断;两段浮点数是否逐项相同,可以给出确定答案。
第二,可以跨整篇论文搜索。 同一段数字藏在不同工作表、不同图和不同补充材料里,也能被算法找到。
第三,可以检查生成规律。 差值、比值、小数尾、残差、分布和公式引用,都可能暴露数字怎样被加工。
2026年,一个名为Science Detective的项目把这种思路做成了扫描工具。开发者从Dryad中含Excel文件的数据集开始,先找重复,再用模型和人工排除正常的固定参数、重复编码等假阳性。Retraction Watch报道,在已完整分析的约600篇论文中,最终约3%的数据集被认为存在需要进一步核查的问题;当时已有18个数据集被列为可能严重到需要更正。项目方同时强调,多数问题未必是蓄意篡改。
这句话很重要:批量扫描提高的是发现率,不是定罪率。
数字操纵或失控,至少留下十二类指纹
这些“方法”不值得学习,但它们的失败痕迹值得记住。按数据从采集到发表的路径,至少可以归为十二类。
1. 整段复制:不同样本共享同一串生命史
在一篇2016年的Cell帕金森病肠脑轴论文中,公开工作簿显示,两组不同菌群条件的小鼠行为数据各有5个读数按同一顺序精确重复,合计10个跨条件重复值。第一作者随后在PubPeer承认存在错误,并表示正与期刊讨论更正;Dryad也给数据集加上了关注提示。
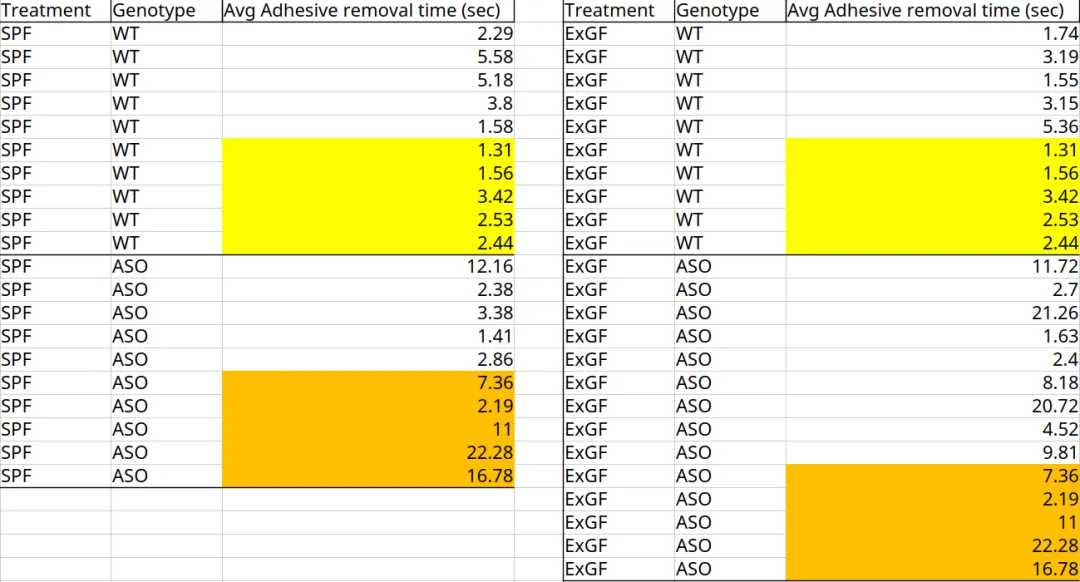
这类证据比“两个数字碰巧相同”强得多。独立实验中,连续五个值连顺序都一样,首先应检查复制粘贴、样本标签和合并脚本。但在期刊或机构作出结论前,仍不能仅凭重复推断作者意图。
Jonathan Pruitt的蜘蛛行为研究则展示了更大尺度的后果。合作作者在数据中发现疑似复制的数值区段,问题随后扩展到多篇论文。2023年,Nature撤回其中一篇论文,理由是出版后审查认为数据不可靠,编辑不再信任结果和结论;Pruitt不同意撤稿。
2. 固定平移:不复制原数,只统一加一个常数
一篇Nature论文的Source Data中,评论者发现两列本应独立的测量在35行里全部相差0.3个百分点;另有数据区段出现固定差值或固定关系。固定平移会保留曲线形状,同时改变绝对水平,肉眼看两列并不相同,逐行相减却只剩一个常数。
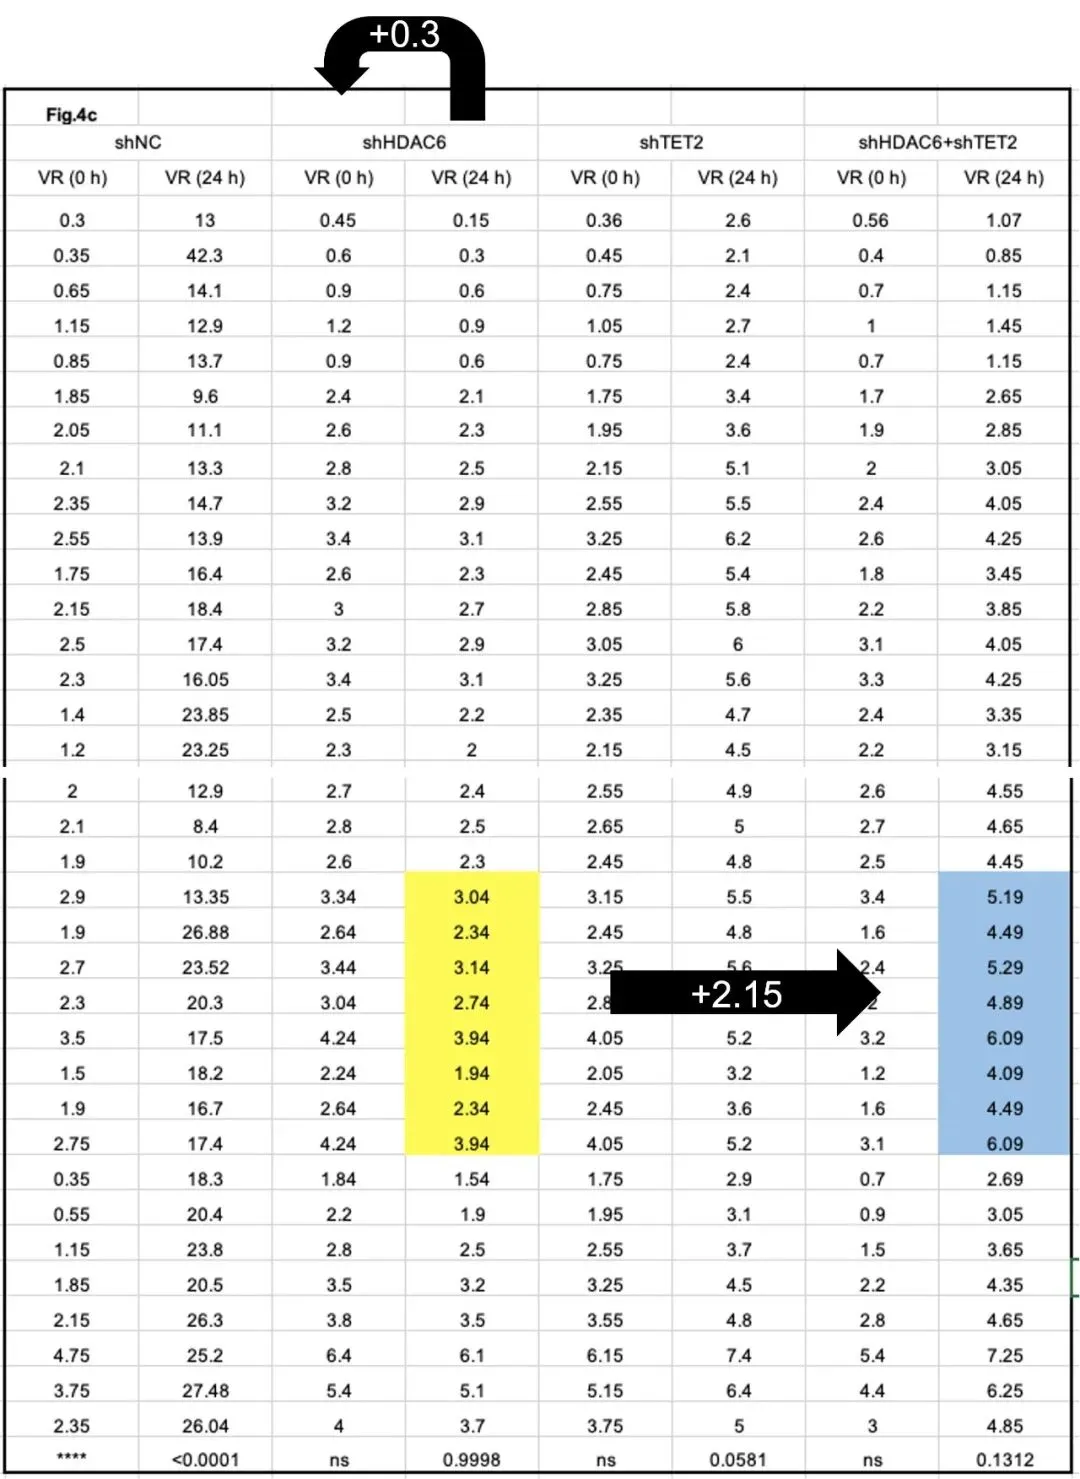
这个案例的证据级别后来发生了变化:同济大学调查认定多张图未作客观统计,构成学术不端;Nature于2026年撤稿。这里可以使用“学术不端”,因为它来自机构结论与撤稿记录,而不只是评论者的推测。
3. 固定倍数与仿射变换:让两组数看起来“相关但不相同”
把一列统一乘以某个系数,或先乘再加,会制造看似合理的组间差异,同时保留每个波峰和波谷。检测并不复杂:计算逐行比值,或拟合B=aA+b。如果残差几乎为零,就需要解释两组数据为何服从机械关系。
4. 重复小数尾:整数变了,水印还在
多个独立样本共享.157、.8889或更长的小数尾,可能来自占位符、批量填充,也可能来自共同分母和整数计数。危险在于把“罕见”直接写成“不可能”。正确检查顺序是:先确认仪器精度和计算公式,再看重复是否跨越了本应独立的样本、时间和条件。
5. 占位符越过版本边界
Nature Cancer一篇结直肠癌论文的作者解释,早期GraphPad工作稿为了排版使用已有时间点作为占位;多个Excel文件汇总时,工作稿被误当作最终数据。论文后来出现编辑提示。
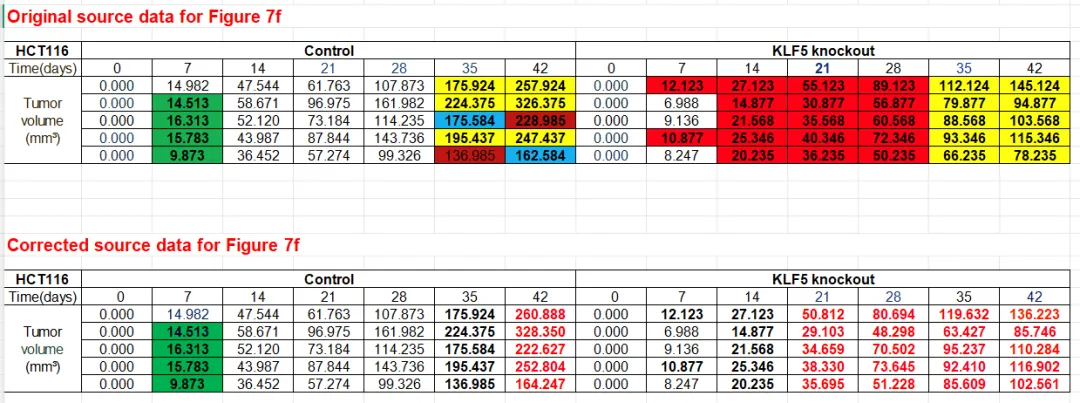
占位符本身是正常工具。问题出在文件没有明确标记“模拟”“草稿”“禁止发表”,也没有自动核对最终图是否仍引用临时数据。数字失控,往往不是发生在实验台,而是发生在版本管理。
6. 公式错行、错列和错误合并
Excel最危险的错误通常不会显示#VALUE!。公式引用上一行,照样能算出一个格式漂亮的均值;按错误键合并两张表,照样能让每条记录都找到一个“对应样本”。
一篇Nature水稻论文的作者在PubPeer回应中承认,Source Data存在复制到相邻单元格、引用错误行以及粘贴错误ΔCq值等问题。重新分析后,一些P值阈值随之变化。这样的案例说明,电子表格错误可能是无意的,却仍然会改变正式结论。
7. 选择性删点:噪声只在不方便时才叫“离群值”
删除离群值并不等于造假;预先规定、对所有组一致适用并完整报告,是正常分析。风险来自另一种模式:只有削弱结论的点被删除,规则在看到结果后才出现,且原始数据和排除日志不可见。
数字取证在这里看的不是“有没有删点”,而是规则能否在不知道组别的情况下复现,所有被删样本是否保留身份、原因和时间戳。
8. 过度完美的回归:R²不是荣誉勋章
真实仪器有噪声,真实生物样本有变异。多条校准曲线全部显示R²=1.00不自动证明异常,因为Excel可能只显示两位小数;但它应触发对未舍入R²、残差、强制过原点设置和批次曲线的检查。
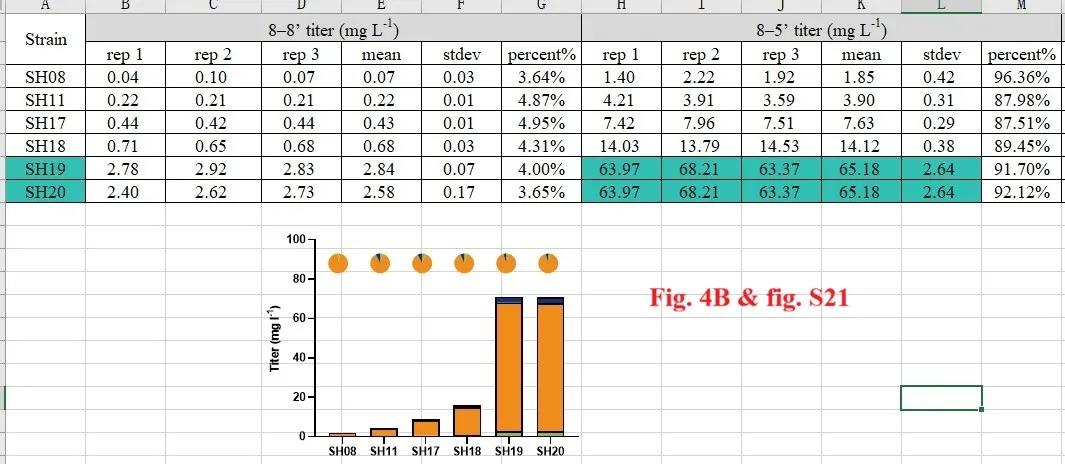
在一篇Science论文的PubPeer回应中,作者用显示位数解释R²=1.00,同时承认SH19与SH20出现完全相同数据属于复制粘贴或录入错误。一个合理解释可以解决一个问题,不会自动消除同一文件里的另一个问题。
9. 时间序列复制:在长曲线里复用一段“备份数据”
时间序列尤其容易制造视觉安全感:几千个点挤成一条粗线,人眼很难记住局部噪声纹理。对曲线做滑窗相关、差分比较或局部叠加,却可能发现相隔很远的两段波动逐点重合。
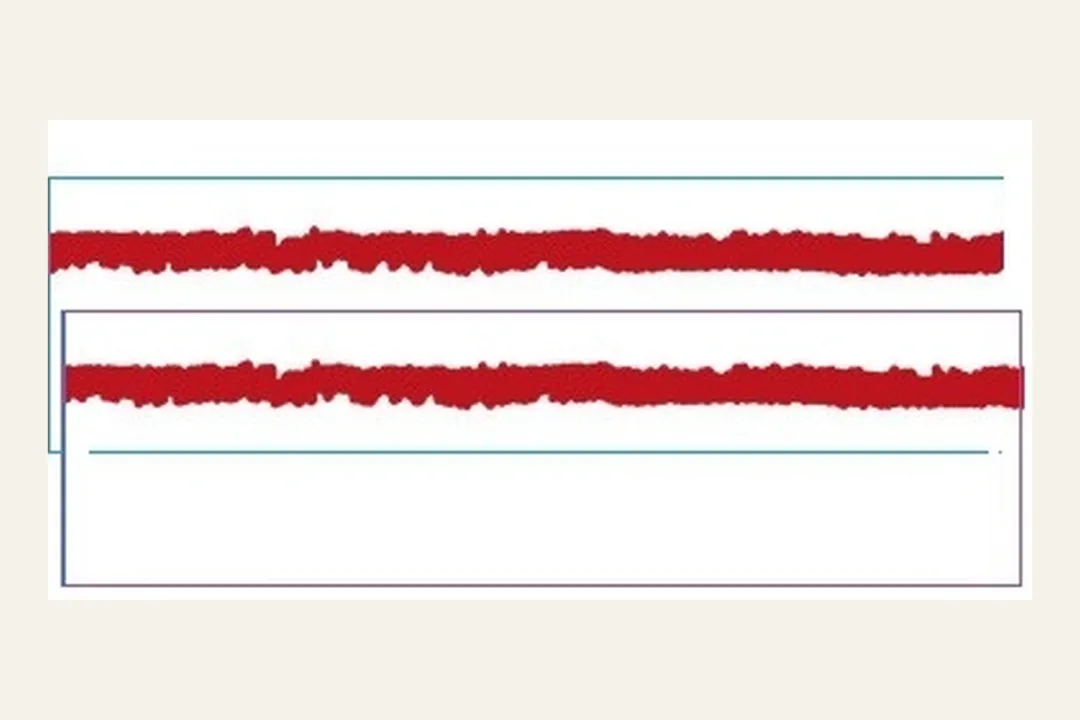
一篇Science钙钛矿论文的作者承认,绘图时误用了此前已经绘制过的备份数据段;Science随后发布关注声明并索取信息。
这里最重要的不是猜测动机,而是追问:原始仪器日志是否连续,绘图脚本能否从头重建整条曲线。
10. 伪精度:把计算位数冒充测量精度
三位小数的原始读数除以一个共同分母,可以生成七位小数。七位不是七位测量精度。伪精度会制造两种错觉:普通的整数重复显得异常神秘;真正的跨图复制又被“数字太长”掩盖。
审计时必须分开记录原始精度、计算精度和显示精度。
11. 不可能的汇总统计:均值根本算不出来
GRIM检验利用一个朴素事实:若原始数据是整数评分,样本量为N,均值只能落在有限的格点上。Brown与Heathers检查可适用的71篇心理学论文,36篇至少有一个报告均值与样本量、量表结构不一致。
GRIM发现的是报告不一致,不是自动发现造假。原始数据、样本量或四舍五入任一处写错,都可能触发报警。但一个公开均值若在数学上无法由所述数据产生,至少说明论文记录链条有一处断裂。
12. 分布整体“太像随机”或“太不像随机”
单个数字可以伪装,数千项数据的分布更难伪装。麻醉科医生John Carlisle分析5,087项随机对照试验、72,261个基线均值,发现一些随机组之间近乎不可思议地相似,另一些又过度不同。少数论文的概率极端到不能用正常随机抽样解释。
但Carlisle同样列出了多种可能来源:欺诈、无意错误、变量相关、分层分配和方法缺陷。统计异常能把海量论文缩小成调查清单,不能代替调查本身。
真正的变化:造假对象没有变,证据的“颗粒度”变了
图像操纵通常改动的是展示层:复制一个panel、隐藏一个细胞、重排几条泳道。数字操纵则可以发生在整个数据生命周期:
1. 采集层:虚构样本、替换记录、重复使用同一测量;2. 整理层:复制粘贴、错配标签、错误合并、占位符遗留;3. 变换层:固定平移、倍数缩放、选择性归一化;4. 统计层:删点、换检验、伪造均值或方差;5. 展示层:截断坐标、隐藏时间段、只保留有利曲线;6. 更正层:只修改已经被圈出的数,却不给原始依据和完整差异记录。
因此,“数字时代”更危险,也更容易审计。危险在于,一次公式或合并错误能同时污染数百个单元格;容易审计在于,只要源文件公开,任何人都能重复同一组检查。
如何区分错误、异常与造假
一篇负责任的报道至少要区分四层证据:
• 第一层:公开异常。 评论者发现重复、固定差值或统计不可能;此时只能说“需要解释”。• 第二层:作者确认错误。 可以确认数据或文件有错,但仍不能自动推断故意。• 第三层:期刊动作。 更正、编辑提示、关注声明或撤稿,说明出版记录已正式变化。• 第四层:机构认定。 调查依据原始文件、设备、人员和时间线,对是否构成学术不端作出结论。
把第一层写成第四层,是科研新闻最常见也最不公平的跳跃。反过来,把作者一句“复制粘贴错误”当作所有问题的终点,同样不严谨。解释需要与原始记录相匹配。
下一代科研审查,应该检查什么
最有效的防线并不神秘:
• 原始仪器文件只读保存,保留校验值与采集元数据;• 样本ID、板号、批次、操作者和日期贯穿原始记录、分析表与论文图;• 工作稿、占位数据和正式数据使用不同目录与醒目标记;• 尽量用脚本从原始数据生成统计表和图,减少手工复制粘贴;• 任何排除值都保留,不覆盖,只增加原因和决定时间;• 投稿前同时运行图像重复检查、数值块重复检查、公式引用检查和汇总统计一致性检查;• 更正时公开逐项差异,而不是只上传一份“新表”。
期刊过去学会了在接受论文前扫描图片。下一步应该同样扫描Source Data:连续重复、固定差值、固定倍数、异常小数尾、公式越界和无法复算的均值,都可以在编辑部点击“接受”前自动报警。
尾声:未来最有力的证据,不是一张更漂亮的图
从WB条带到Excel小数,科研不端没有突然换了一副面孔。改变的是读者终于能越过柱状图,追到单元格;越过单元格,追到样本;再越过样本,追到仪器和时间戳。
图片会留下像素指纹,数字会留下结构指纹。真正经得住审查的数据,应该能回答同一个问题:这个结果从哪里来,经过了什么处理,谁在什么时候改过它?
当每个数字都能沿着记录链回到一次真实实验,“如何操纵数据不被发现”就不再是一门技巧,只会变成一份越来越短的失败清单。
资料核验截至2026年8月29日。主要依据包括:Bik等人的图像重复研究;美国ORI与犹他大学科研诚信办公室公开材料;Science Detective与Retraction Watch的数字扫描报道;相关PubPeer讨论、作者回应、期刊更正/关注/撤稿页面;Carlisle随机试验取证研究与GRIM方法论文。本文只对公开证据分级,不判断未被机构认定个案中的主观意图。