ARTICLE · 992872
试验数据处理的“Excel 时代”,该翻篇了
一个每天都在发生的场景
试验做完了,数据到手了。
工况室的上位机导出一个 CSV:一千多列、十几万行,时间戳、温度、压力、频率、功率密密麻麻躺在里面。接下来的两三个小时,你将做着一件与"分析"关系不大的事——
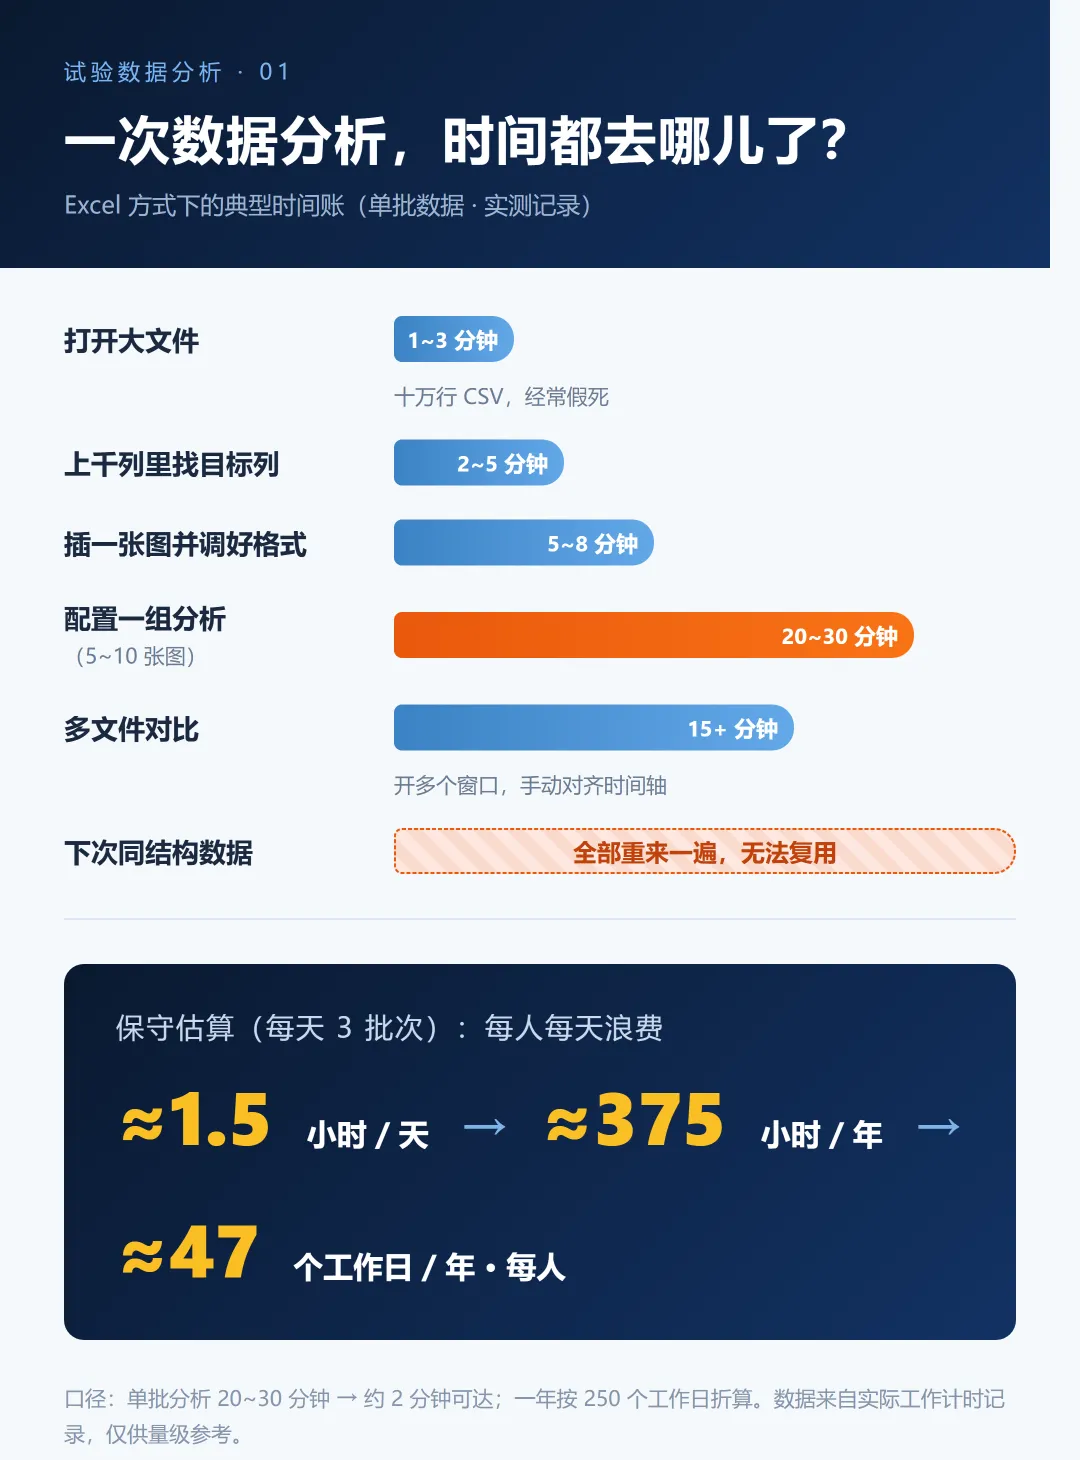
打开文件(先去倒杯水,十万行的 Excel 打开要一到三分钟);在上千列里肉眼翻找目标列;插入图表,调颜色、线型、坐标轴;这时候领导说"再看看上周那台机的对比",于是再开一个窗口,手动对齐两条时间轴,来回切换。
这是暖通空调研发团队里几乎每个人的日常。数据明明是机器一秒一秒记下来的,看数据这件事却全靠人肉。
五个痛点,每一个都在消耗你
把日常数据处理里反复出现的麻烦拆开看,问题其实非常具体:
1. 每次都从零开始。 打开新文件、找列、插图表、调格式,一套流程 20~30 分钟起步;而下个月做同结构的试验时,这一切还要原样重来一遍。Excel 里你的分析过程没有"记忆",它不记得你上次调了什么。
2. 大文件卡顿。 十万行数据打开就卡,加上图表后缩放、平移都不流畅。工具的迟钝会一点点磨掉你看数据的耐心——而"耐心"恰恰是分析质量的一部分。
3. 多文件对比极其繁琐。 要对比不同日期、不同机组的数据,得开多个窗口、手动对齐时间轴。对齐这一步不仅慢,还特别容易错:差一个起始时刻,两条曲线的"对比"就是错的。
4. 格式不统一。 不同上位机导出的文件,列结构各不相同。每换一种数据源,前面那套找列、配图的活儿就要重新适配一遍。
5. 无法沉淀。 说到底,时间都花在了"搬运和排版"上,而"这个工况为什么飘了"的思考被挤到最后——甚至没有。这可能是五条里代价最高的一条。
把上面的过程记录成时间账,大概是这样:
算一笔账:隐性成本比想象中大
以这张时间账为基准做一次保守估算:每批数据从约 30 分钟压缩到 2 分钟是可以做到的;按每天分析 3 批次计,每人每天能省下约 1.5 小时。
一年 250 个工作日,就是 375 小时,折合约 47 个工作日——接近两个月的全职工时。注意,这不是一个人的账,是团队里每个做试验的工程师、每一年都在重复支付的账。
但钱还只是表层,更深层的成本有两个:
- 出错风险
。手动对齐时间轴、手工复制公式,每一步都是引入错误的开口。试验报告里的一个错数,代价远远超过省下的那半小时。
- 分析深度被压缩
。当"把数据看一遍"本身就要半小时,人就会下意识少看几组参数、少问几个为什么。工具的摩擦力,最终会变成分析深度的天花板。
所以,我做了一个工具
抱怨到此为止——因为这个痛点,最终是我自己动手解决的。
我是做制冷性能开发的工程师,不是职业程序员。但在 AI 辅助编程的帮助下,我用 12 天的零散时间做出了一个给自己和同事用的单机分析工具("领域专家 + AI 造工具"这段经历本身很有意思,值得单独写一篇番外,这里不展开)。
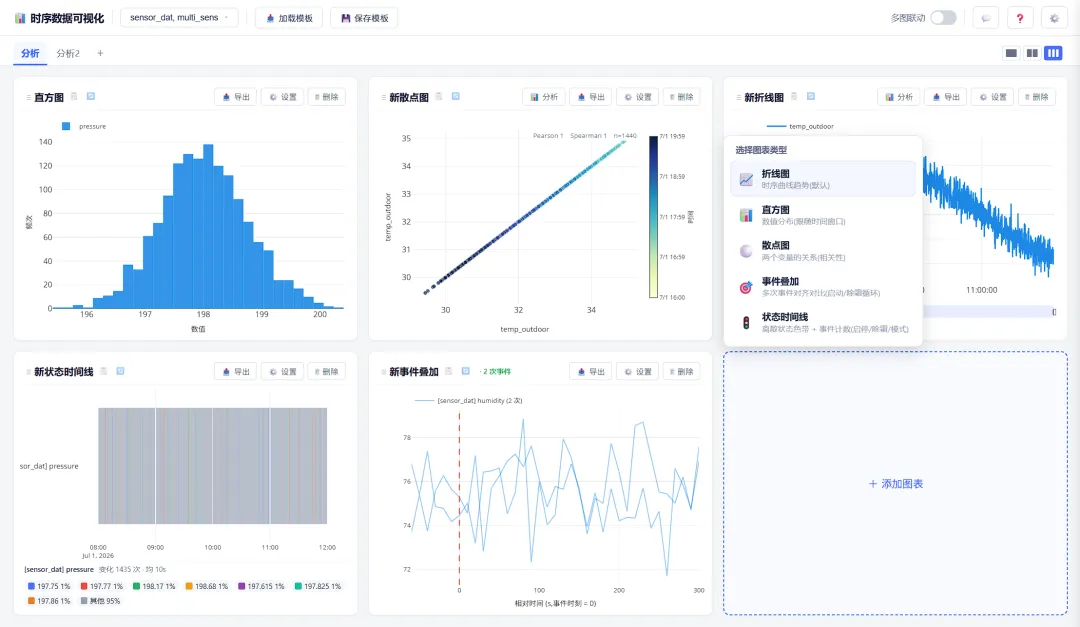
它的定位一句话能说完:免安装、双击即跑——CSV/Excel 添加进去,图表、统计、对比直接出来。
能力清单本系列后面几篇会逐一展开,这里只报名字:五种图表类型(折线、直方图、散点、事件对齐叠加、状态时间线)、全局时间联动、派生曲线公式引擎、稳态判定、FOPDT 阶跃辨识 + PI 整定、YAML 模板复用。
效率的对比是实测的:
| 6~18 倍 | |||
| 10~15 倍 | |||
| 30 倍 | |||
| 20 分钟 → 30 秒 |
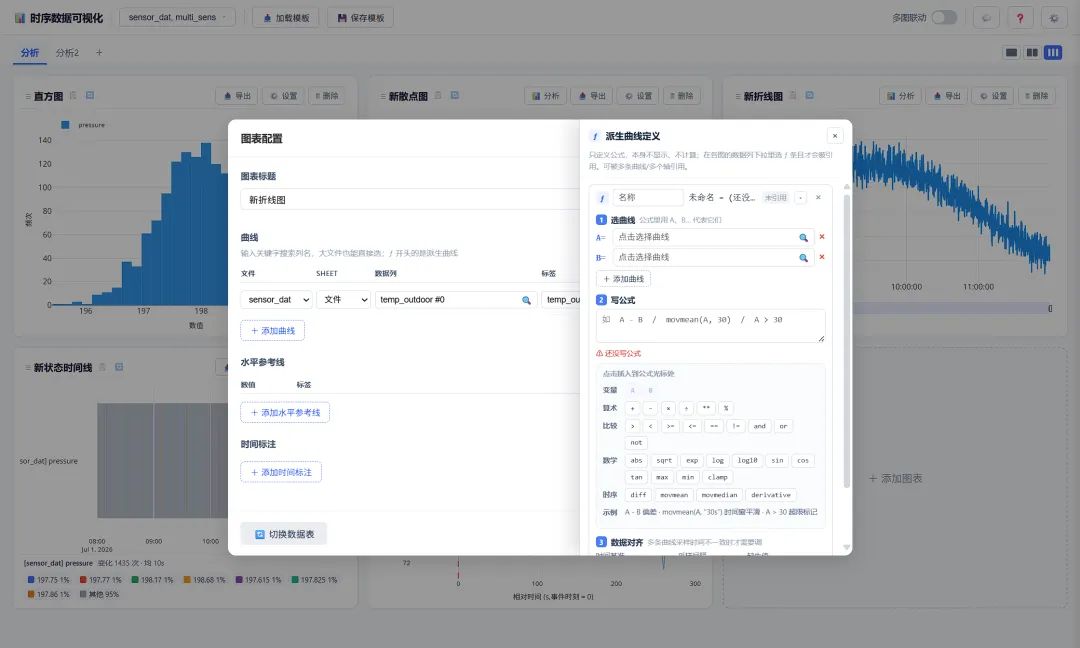
所有配置都在弹窗里完成——选曲线、写公式、加参考线,不写一行代码。比如想要"两个传感器的温差"或"滑动平均滤波",在派生曲线面板里一条表达式就出来:
边界:它不打算取代谁
把边界说清楚,你才能判断这类工具适不适合自己:
- 论文级、发表级绘图
——Origin、MATLAB 更专业;
- 云端协作、实时在线监控
——Grafana、PI Vision 那类系统是另一个物种;
- 业务报表与 BI
——Power BI、Tableau 的领地。
它卡位的是另一个每天发生、却没人优化的场景:试验做完、数据落地后的"快速看图—对比—判定"。这个场景单次不长、但频率极高、消耗惊人,上面那些专业工具恰好都不为它而生。
写在最后
Excel 没有错,它只是没有为"工程师看试验数据"这件事做优化。真正的浪费也从来不是每天那 1.5 小时本身,而是工程师的判断力被数据搬运占用——工具应该把时间还给思考。
下一篇,我们聊一个更本质的问题:拿到一段试验曲线,工程师到底应该问它哪五个问题?
思考与讨论
你的日常工作中,数据搬运和分析思考的时间比例大概是多少?
团队里有没有那种"人人都嫌、人人都忍"的工具债?
欢迎在评论区聊聊你的经历。
免责声明:本文基于个人工作实践整理,仅供技术交流。