ARTICLE · 993394
AI为什么需要持续学习
前段时间,一不小心看到网上流传关于梁圣(DeepSeek创始人)的投资者交流会实录。
其中提到AI的发展路径:大模型(LLM)-> 思维链(CoT) -> 智能体(Agent) -> 持续学习 -> AI自我迭代 -> 具身智能。
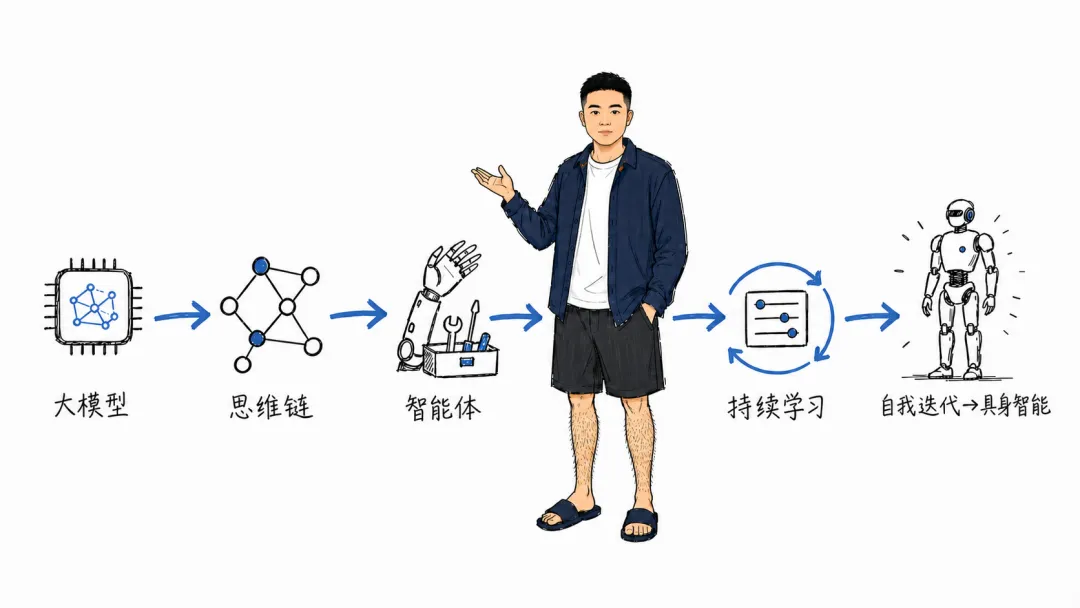
从2022年ChatGPT发布至今,AI的发展已经来到了第3个阶段。今年的智能体有多火就不用多说了,漂亮国有CodeX、Claude Code、Grok Build,华夏国有WorkBuddy、豆姐工作、千问办公,它们卷的飞起。
比起智能体的热闹景象,AI研发人员已经在默默卷持续学习了。
众所周知,训练AI大模型,就像培养一个大学生,一般要经过二个阶段。
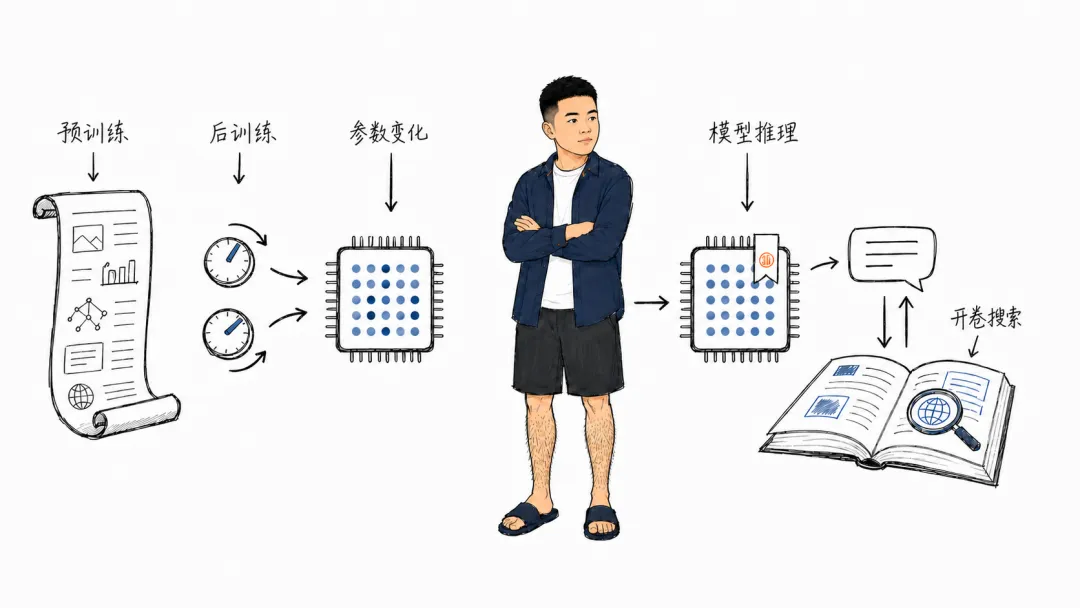
第一个阶段是学习(预训练)。训练系统把大量文字交给模型,让它反复预测下一个词。模型猜错一次,内部参数就调整一点。 这样模型就能慢慢学会语言规律,记住大量知识。
第二个阶段是实习(后训练)。预训练结束后,模型还要接受后训练。让它做问答、编程和工具操作等任务,再根据答案和执行结果调整参数。 模型由此学会遵循指令,复杂任务也能一步步处理得好。
这两个阶段,模型内部的参数都发生了变化。也就是说模型只有参数发生变化,它才会一点一点的变聪明(当然也可能是变笨)。
训练完成后,模型就可以发布让用户使用了。用户发送一句话,模型就读取当前对话,经过一通计算,给出回答,这个过程叫模型推理。
但是模型发布以后,模型参数就固定了,不会再发生任何变化。比如Kimi K3模型在2026年7月16日发布后,它的知识就截止于2026年7月16日前,之后的知识它是不知道的。工程上的解决办法是让它调用网络搜索工具,实时搜索信息,相当于模型会做开卷考试,但它并没有真得学会新知识。
既然AI可以调用搜索工具查询实时信息,为什么需要在使用中持续学习?
模型训练用的是已经整理好的数据,现实环境却一直在变。软件会更新,企业也会调整流程。模型公司可以定期重新训练,但每家公司的内部变化不可能都进入下一轮公共训练。
知识及时更新只是其中一部分,许多工作能力来自反复执行任务得到的经验积累。
一名新员工可以读完公司的产品手册,接触客户以后,他才会知道哪些问题经常出现,某种解释为什么总让客户误会。经理指出一次问题,他下次会调整说法。这样的变化很小,半年后却会让新员工和老员工表现得很不一样。
现在把新员工换成 AI。它第一次写错报价单,用户指出了错误。系统只把这句话放进当前对话,经验会随着对话结束而失效。
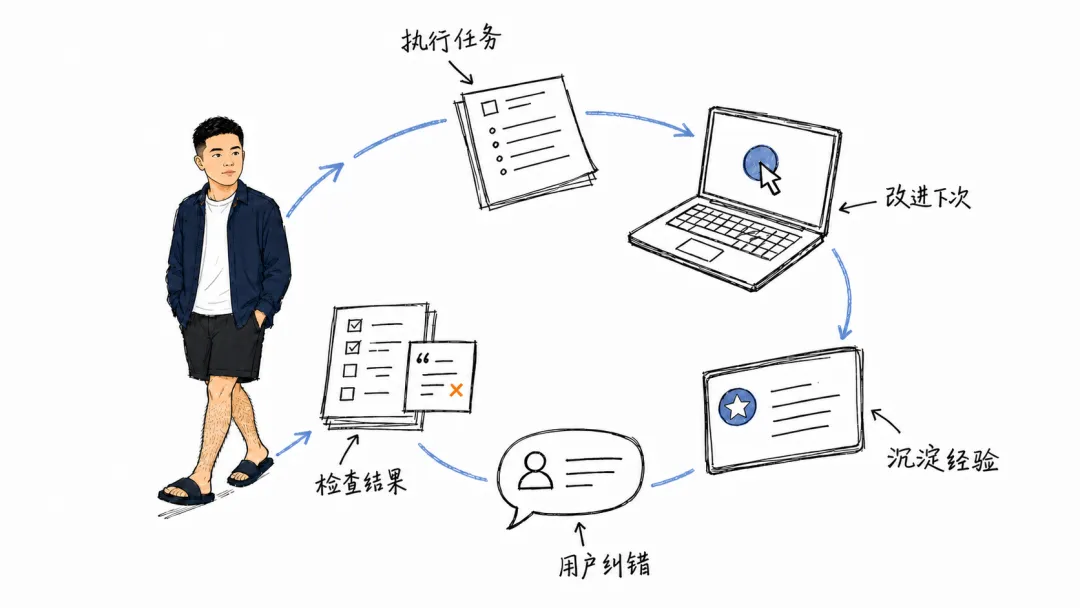
智能体让这个问题更加突出。聊天模型回答完就可以停下,智能体不仅要阅读文件、操作软件,还要检查结果。一次任务里会出现很多选择。哪条路成功了,哪个按钮已经改名,什么情况下应该先向用户确认,这些信息都来自行动过程。
如果智能体每次都从零开始,错误也会一次次重来。它可以承担任务,却很难随着工作时间增加而变得可靠。
持续学习提供的价值就在这里,让行动产生经验,再让经验影响行动。
但记住和学会之间还有一段很长的路要走。
今天很多AI产品已经提供记忆功能,也就是各种.md格式的文件。用户告诉它自己喜欢简短回答,系统把偏好保存起来,下次生成答案时再读出来。这个功能有用,也很容易让人觉得AI已经会持续学习。
但这雀食不是持续学习,我们要分清几个层次。
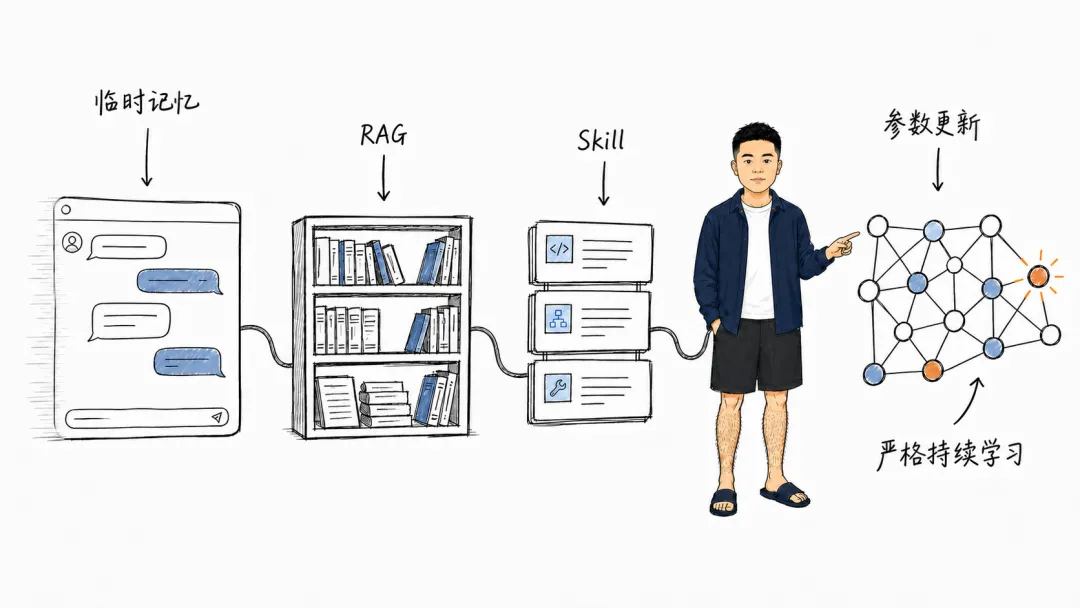
第一层是临时记忆,模型上下文保存当前对话里的信息。能用多久取决于上下文窗口的限制,随着对话轮数变长,超出限制模型就可能会忘记早期的对话内容。
第二层是持久化的记忆,研究人员开发了检索增强生成(RAG)技术。说白了就是给AI外挂一个知识库,回答用户问题前先查查知识库。资料库虽然可以随时更新,模型参数并不会跟着改变。
第三层是技能(Skill),它可以存下一段经过验证的操作步骤。AI下次遇到相似任务,先取出这套步骤,再根据眼前情况使用。
这些办法都能让AI去利用信息,也可以成为广义持续学习系统的一部分。但严格的持续学习是模型更新参数,让模型本身不断更新知识,而不是借助外部工具。区分这些很有必要,两种进步都值得做,解决的问题不同。
持续学习为什么这么难搞,以至于只能先通过资料库+技能库的方式解决。
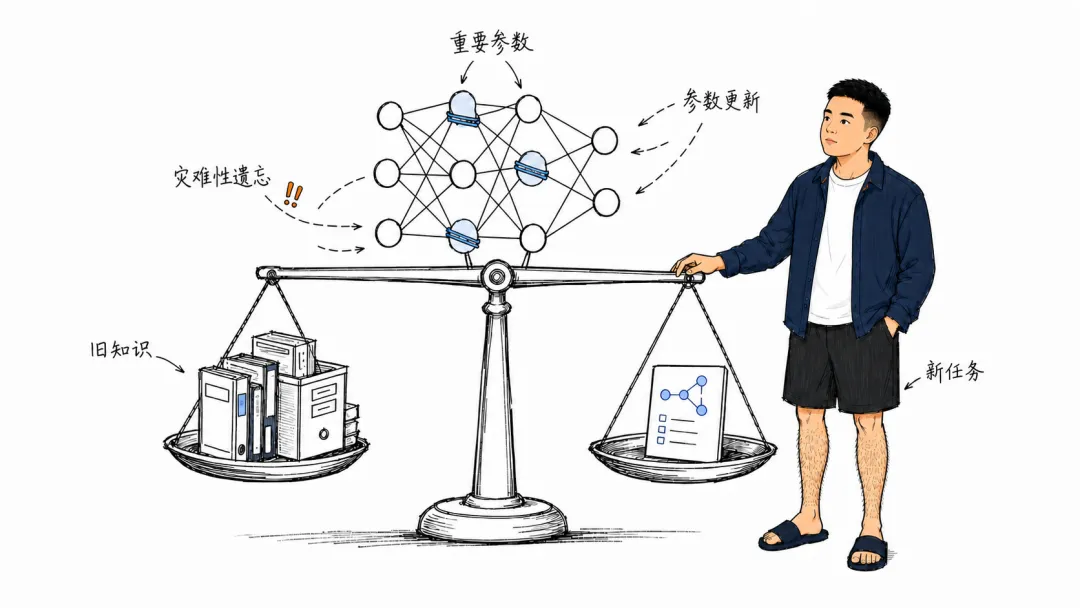
最早暴露出来的难题叫灾难性遗忘。模型训练学习新任务时会调整参数,这些参数同时保存着旧任务的知识。模型参数更新,新内容学会了,旧知识可能就给忘玩了。
2017 年,DeepMind等机构的研究人员提出弹性权重巩固方法。它先判断哪些参数对旧任务比较重要,学习新任务时尽量少改这些参数。研究者让模型依次学习手写数字分类和多款Atari游戏,证明旧能力可以得到一定保护。
论文地址:https://arxiv.org/abs/1612.00796
保护得太多也有代价,参数都不愿意动,模型就很难吸收新知识。持续学习一直要处理这些拉扯,旧经验要保住,新经验也要学习。
我调研了一波,目前关于持续学习的最新研究进展。
AI已经能够保存经历、提取工作流,也能通过小规模参数更新吸收部分新知识。系统仍要判断什么值得学,以及它应该进入参数还是留在外部记忆。学会之后,它还要知道什么时候使用,并且能够撤回错误更新。持续学习已经有了不少可用的方法,但是安全、稳定的完整方案还没有出现。
梁圣的那份会议记录里也没有给出具体的突破日期,显而易见,哪家AI供应商先攻克这个难题,他就能当上AI圈的话事人。
感谢您看到这里!
作者:新一