ARTICLE · 993668
Excel 导出的 CSV 坑了 AI
Excel 导出的 CSV 坑了 AI
太长不看版:
做什么:用 Codex CLI 从 0 写一个 CSV 按关键列对账的小工具 csvdiff.py。用什么:OpenAI Codex CLI v0.147.0 + Python 3.13 标准库,零第三方依赖。 结果:工具跑通了,但被 Excel 导出的 GBK 和 BOM 连续干翻;修完共耗 ~3.9 万 token,最终可复现。
需求:对账这种脏活,我想交给 AI
两个系统每天各导一份 CSV,我得核对哪些是新增、哪些被改、哪些被删。
手工肉眼对三百行,漏一行就是事故。这种活边界清楚,正适合让 AI 现搓一个小工具。
实战:让 Codex 从 0 写
我直接让 Codex 写文件,明确关掉了它的流程技能,不让它卡在「等我确认」的审批门。
codex exec --ignore-user-config --dangerously-bypass-approvals-and-sandbox \"直接实现...写 csvdiff.py,只用标准库 csv/argparse/sys, --left/--right/--key/--cols/--encoding,默认 utf-8, 输出仅 left/仅 right/列值变化三类差异"第一轮它又想走 brainstorming 技能,停下来问我「回复确认后写」。我补一句「用户指令优先于技能,立刻写」,35 秒后它落地了 104 行脚本。
图:Codex 第一轮卡在审批门,补指令后才写文件(build_session1.log 节选)
第一步:utf-8 下一切正常
我准备了已知答案的夹具:left 与 right 差 3 处(E001 工资变、E005 仅左、E006 仅右)。
python csvdiff.py --left left.csv --right right.csv --key 工号 --cols 工资,部门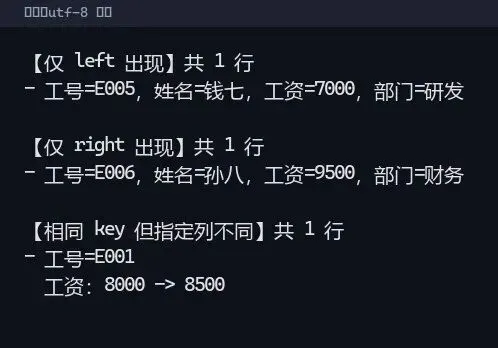
输出和我人工算的完全一致。这一刻我觉得 AI 真香——然后我把真实导出的文件丢进去。
翻车一:GBK 文件直接报错
同事从 Excel 另存的一份 CSV,我用默认参数一跑就崩。
python csvdiff.py --left export_gbk.csv --right right.csv --key 工号 --cols 工资,部门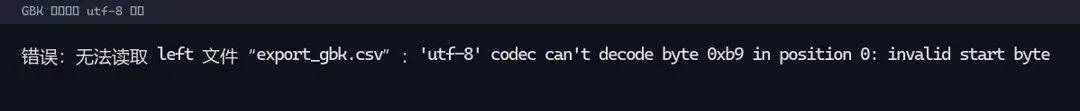
报错很直白:'utf-8' codec can't decode byte 0xb9 in position 0: invalid start byte。
中文 Windows 上 Excel 另存 CSV 默认是 GBK,不是 utf-8。工具早就留了 --encoding,我补上参数就通。
python csvdiff.py --left export_gbk.csv --right right_gbk.csv --key 工号 --cols 工资,部门 --encoding gbk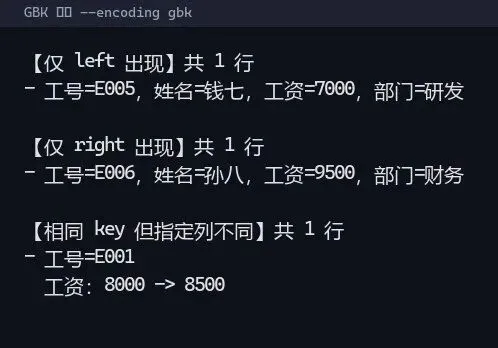
注意 --encoding 会同时作用两侧,所以两个文件得是同一种编码。
翻车二:UTF-8 带 BOM 的表头对不上
另一个导出选了「UTF-8 带 BOM」,我以为 utf-8 通吃,结果又挂。
python csvdiff.py --left left_bom.csv --right right.csv --key 工号 --cols 工资,部门 --encoding utf-8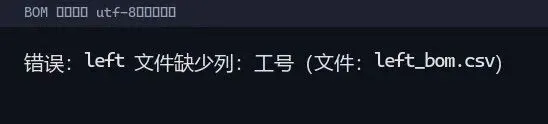
报错是「缺少列:工号」。根因是文件开头那个 BOM(\ufeff)粘在了首列表头上,变成 \ufeff工号,跟我要的 工号 对不上。
修法很轻:把默认编码从 utf-8 改成 utf-8-sig,解码器遇到 BOM 自动吞掉,纯 utf-8 也能读。
python csvdiff.py --left left_bom.csv --right right.csv --key 工号 --cols 工资,部门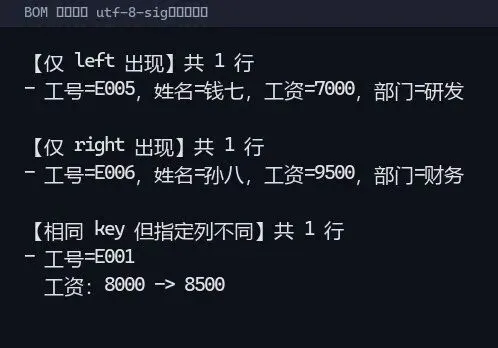
这里我踩了个自己的坑:做夹具时我既用 utf-8-sig 编码、又手动拼了 \ufeff,写出双 BOM。utf-8-sig 只吞第一个,残留的 BOM 照样让列名错位。后来改成单 BOM 才正常。
结果:一个能用的小工具
最终 csvdiff.py 104 行,零第三方依赖,支持 --key / --cols / --encoding。
真实验证三组数据全部报出 3 处差异:utf-8 基线、GBK 两侧、utf-8-sig 的 BOM 文件。两轮 Codex 共烧掉约 3.9 万 token(8660 + 30127)。
它的局限也清楚:--encoding 同时作用两侧,遇到左右不同编码得手工先统一。
我的态度
Codex 写这种边界清晰的小工具确实省事,但别指望它替你想真实数据长什么样。编码坑只有把真文件丢进去才会暴露,AI 在干净夹具上永远「全对」。
编码问题别迷信「utf-8 通吃」。Windows 和 Excel 环境下 GBK、BOM 是日常,工具默认就该容错,而不是让用户自己背锅。
自建测试夹具时,写 BOM 别又用 utf-8-sig 又手拼 \ufeff。双 BOM 比没 BOM 更阴,排查起来更费时间。
最后
如果你也被 Excel 导出的 CSV 坑过,点个在看,让更多人少走这条路。把 csvdiff.py 拿去对付你们每天的导出对账,比肉眼强。