ARTICLE · 994386
15道题实测全对,Table RAG让Excel变知识库
15道题实测全对,Table RAG让Excel变知识库有位读者在上一篇文章下面留言:“能解决通用的 Excel 入知识库吗?” 说实话,我卡了一下才敢答。  想直接回“能”——反正代码都在,换个文件路径就能问。可我心里清楚,示例里那张销售表是我自己生成的,干净得像样板间:单 sheet、一行表头、合并只出现在首列。你手里那张表,多半没这么乖。
所以不耍嘴。“通用”两个字掰开揉碎:哪些真能用,哪些还差着,一条条对。 为了把这个问题讲清楚,我把代码翻了一遍,有个地方比我记忆里更通用,也有三个地方确实做不到——都摆在下面,你上手之前先看“边界”那一节。 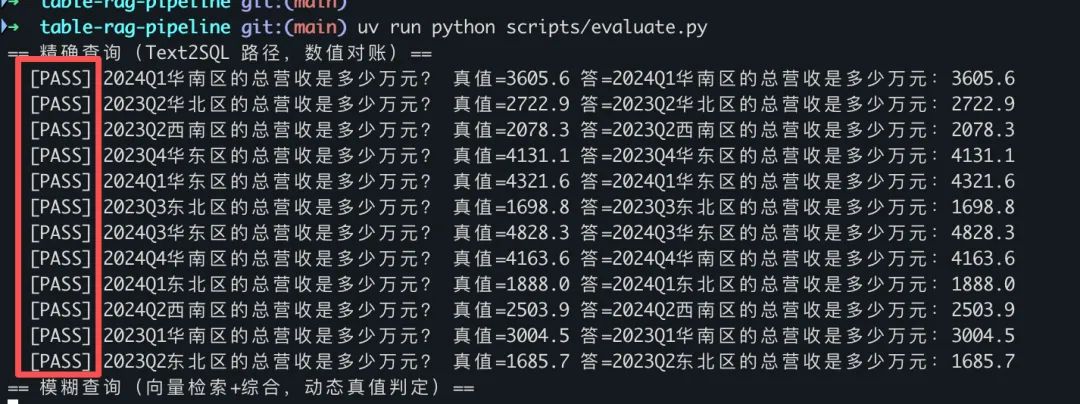
代码在 GitHub 上,15 道题实测全对。先说好消息。 你可能已经试过用标准 RAG 处理 Excel。 把表格当纯文本导入,按 token 切块。一个 500 token 的 chunk,常常卡在第 15 行半。第 16 行的“华东区”被切到下一个块,而它的列名“Q3 销售额”还留在上一个块里。检索时向量相似度命中“华东区”,递给 LLM 的却是一截没有表头的数据。LLM 只能猜。我上一篇文章给过一组实测:200 个查询,标准 RAG 准确率 38%,幻觉率 22%。38%,等于每 10 个问题错 6 个。这不是模型不行,是分块把表格的骨头拆了。 把表格当文本切,等于把账本撕成纸条再拼起来。 你以为加个 Text2SQL 就稳了?没这么简单。精确查询确实能答对,但模糊分析呢?“哪个区域增长最快”要跨行比较,SQL 写不出来。还有那个中文匹配的坑——库里存的是“华东”,用户问的是“华东区”,差一个字,SQL 就查空。查空不是模型笨,是它根本不知道列里到底存了哪些值。 从 clone 到问出第一句话,四条命令: 表格解析、多粒度索引、混合检索,这套思路不新。新的是把工程细节走通了。 导入你自己表格的那一刻,四个自动闭环已经就位:列类型和取值参考自动推断,表名取文件名,合并单元格在内存里回填不改源文件,终端持续问答。你不需要手写 schema,不需要管合并单元格。pandas 读到一堆 NaN 时,openpyxl 已经在内存里把该填的值填好了。 思路到代码之间隔着坑。有两个坑文章里没写,因为当时还没踩到。 暗防线一:别让 SentenceSplitter 把你刚修好的结构再切碎。 行级分块之后,如果你走 LlamaIndex 默认的 from_documents,SentenceSplitter 会二次切断行块,overlap 还会重复行。等于前脚解决结构丢失,后脚又把它引进来。解法很简单:行块直接以 TextNode 入索引,绕开默认切分。结构安全了,别再用默认切分把它毁掉。 暗防线二:让模型看见列里到底存了什么值。 中文提问“华东区”和库里存的“华东”差一个字,Text2SQL 就查空。解法是把文本列的去重值、数值列的范围做成取值参考,注入 prompt。模型见过准确取值,才写得对 WHERE 条件。这一步不复杂,但少了它,精确查询就是纸面 100%,实际到处碰壁。 附一个平台坑:百炼的 OpenAI 兼容端点,OpenAIEmbedding 必须设 check_embedding_ctx_length=False,否则默认 tiktoken 分块会被 400 拒收。单 key 覆盖全部调用是百炼模式最舒服的地方,这个参数是最容易栽的坑。 上篇文章的分流方案在纸面上是 87%。仓库里放了一套评测脚本,15 道题真值全部由 DataFrame 现算、不硬编码:精确对账 12 题全对,模糊分析 3 题全对。15/15。 关键在 execution-guided retry。SQL 执行报错或空结果时,把报错回喂重试一次。这个机制对齐 NeurIPS 2024 TableRAG 论文的 execution feedback。再看论文里的三个机制:schema 检索、行块保表头、执行反馈重试,仓库里都有对应实现——不是重新发明,是把论文的工程化路径走通了一遍。 先说已经通用的:任意位置的合并单元格都会在内存里回填,不只是首列,无合并的文件也兼容;列类型自动推断 TEXT/REAL/INTEGER;表名取文件名,多文件互不覆盖。 还没通用、你上手前要知道的: 通用化的路线图:多 sheet 逐表入索引、多级表头拍平、高基数列改采样+范围描述。这三件事都在计划里。另外两条老边界不变:纯向量没上 BM25 混合、查询扩展没做,数据量放大前先补这两个。单 key 单模型(qwen-plus + text-embedding-v3),换模型改两个环境变量的事。 仓库地址在文末参考文献。clone、换 Excel、开始问。如果你手里的表不满足上面某条边界——比如多 sheet、多级表头——别走,评论区把表的形态描述一下:哪些形态最多,通用化改造就从哪里开工,下一篇就是它。 月薪7万招FDE,AI公司到底在抢什么? RAG实战——我的Wiki系统准确率从60%提升到95% “从Prompt到Skills,RAG到底还行不行?!”
想直接回“能”——反正代码都在,换个文件路径就能问。可我心里清楚,示例里那张销售表是我自己生成的,干净得像样板间:单 sheet、一行表头、合并只出现在首列。你手里那张表,多半没这么乖。通用两个字,掰开揉碎
五分钟跑起来
git clone https://github.com/helloworldtang/table-rag-pipeline cd table-rag-pipeline uv sync export DASHSCOPE_API_KEY=你的key uv run make_dataset uv run chat.py 两道前作没讲的暗防线
15/15:从思路的 87% 到实测的 100%
边界说清楚:回答“通用吗”这个问题
只读激活的单个 sheet,多 sheet 工作簿要先拆文件。 表头必须是规范的第一行单行表头,多级表头或说明行会打乱列推断。 高基数文本列(几千个去重值)的取值参考会撑爆 prompt,宽表要先挑重点列。
参考文献
table-rag-pipeline 仓库 https://github.com/helloworldtang/table-rag-pipeline 前作:RAG处理表格数据——Table RAG让我把Excel变成了知识库 RAG处理表格数据——Table RAG让我把Excel变成了知识库 TableRAG: Retrieval-Augmented Generation with Table Retrieval and Formatting (NeurIPS 2024) https://arxiv.org/abs/2410.04739
参考文献
RAG处理表格数据——Table RAG让我把Excel变成了知识库 https://www.53ai.com/news/RAG/2026082498064.html HTML表格 - 菜鸟教程 https://www.runoob.com/html/html-tables.html table是什么意思_table的翻译_音标_读音_用法_例句_爱词霸 ... https://www.iciba.com/word?w=table Table表格 | Element Plus https://element-plus.org/zh-CN/component/table